店舗の来客数や売上を日ごとに並べると、「週末は多く、月曜は少ない」といった曜日のパターンが見えてきます。では、土曜日は月曜日より何人多いのでしょうか。
この記事では、日次の時系列データから曜日効果(曜日ごとの水準の差)を数字として取り出す方法を、Pythonで一歩ずつ確かめます。
結論を先に3行で書きます。
- 「曜日別の平均を出す」だけでは、曜日効果を間違えることがあります。祝日は月曜に多いので、月曜の平均が祝日分だけ膨らんでしまうからです。
- 曜日ダミー変数を使った回帰なら、祝日やトレンドの影響を取り除いたうえで曜日効果を推定できます。正解を仕込んだデータで試すと、単純な平均が外した正解を、回帰は言い当てました。
- 推定した曜日効果は、「取り出す」だけでなく「取り除く」こともできます。曜日の波を取り除いた時系列を見ると、祝日や特売日といった「曜日以外のできごと」が浮かび上がります。
この記事を読み終えると、次のことができるようになります。
- 日次の時系列データが「トレンド・曜日の周期・祝日・ゆらぎ」でできている、という見方で眺められる
- 曜日別の平均が祝日やトレンドで歪む理由を説明できる
- statsmodelsの
C()を使って曜日ダミー変数の回帰を実行し、係数を読める - 曜日効果を取り除いた「曜日調整済み」の時系列を作れる
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。本文で出てきたときに、ここへ戻って確かめてください。
| 用語 | この記事での意味 |
|---|---|
| 時系列データ | 時間の順に並んだデータ。今回は「日ごとの来客数」 |
| 日次データ | 1日1つの値をもつ時系列データ |
| トレンド | 長い期間でゆっくり上がる(下がる)動き |
| 季節性 | 決まった周期で繰り返す動き。曜日のパターンは「周期7日の季節性」 |
| 曜日効果 | 曜日ごとの水準の差。「土曜は月曜より30人多い」のような量 |
| ゆらぎ(不規則変動) | トレンドや季節性では説明できない、日ごとのでたらめな上下 |
| 回帰分析 | 知りたい値(目的変数)を、手がかりになる値(説明変数)の式で表す方法 |
| カテゴリ変数 | 「月・火・水…」のように、数の大小ではなく種類を表す変数 |
| ダミー変数 | カテゴリ変数を、回帰で使えるように「当てはまれば1、そうでなければ0」に直した変数 |
| 基準カテゴリ | ダミー変数を作るときに1つだけ外すカテゴリ。ほかの係数は、この基準との差になる |
| 係数 | 回帰で推定される「説明変数が1増えたとき、目的変数がいくつ変わるか」 |
| 定数項(切片) | 説明変数が全部0のときの目的変数の値。今回は「基準カテゴリ(月曜)の水準」 |
| ダミー変数の罠 | 全カテゴリにダミー変数を作ると、定数項と重複して係数が決められなくなること |
| 残差 | 実際の値と、回帰の式で予測した値との差。「モデルで説明できなかった残り」 |
| 自己相関 | 時系列データで、ある日の値と数日前の値がどれだけ似ているか |
時系列データには「周期」がある:曜日効果とは
日次の時系列データは、おおまかに3つの部品でできていると考えると見通しがよくなります。
- トレンド:1年かけてゆっくり増える、のような長い動き
- 季節性:決まった周期で繰り返す動き。日次データなら「1週間(7日)」の周期がまず目につきます
- ゆらぎ(不規則変動):どちらでも説明できない、日ごとのでたらめな上下
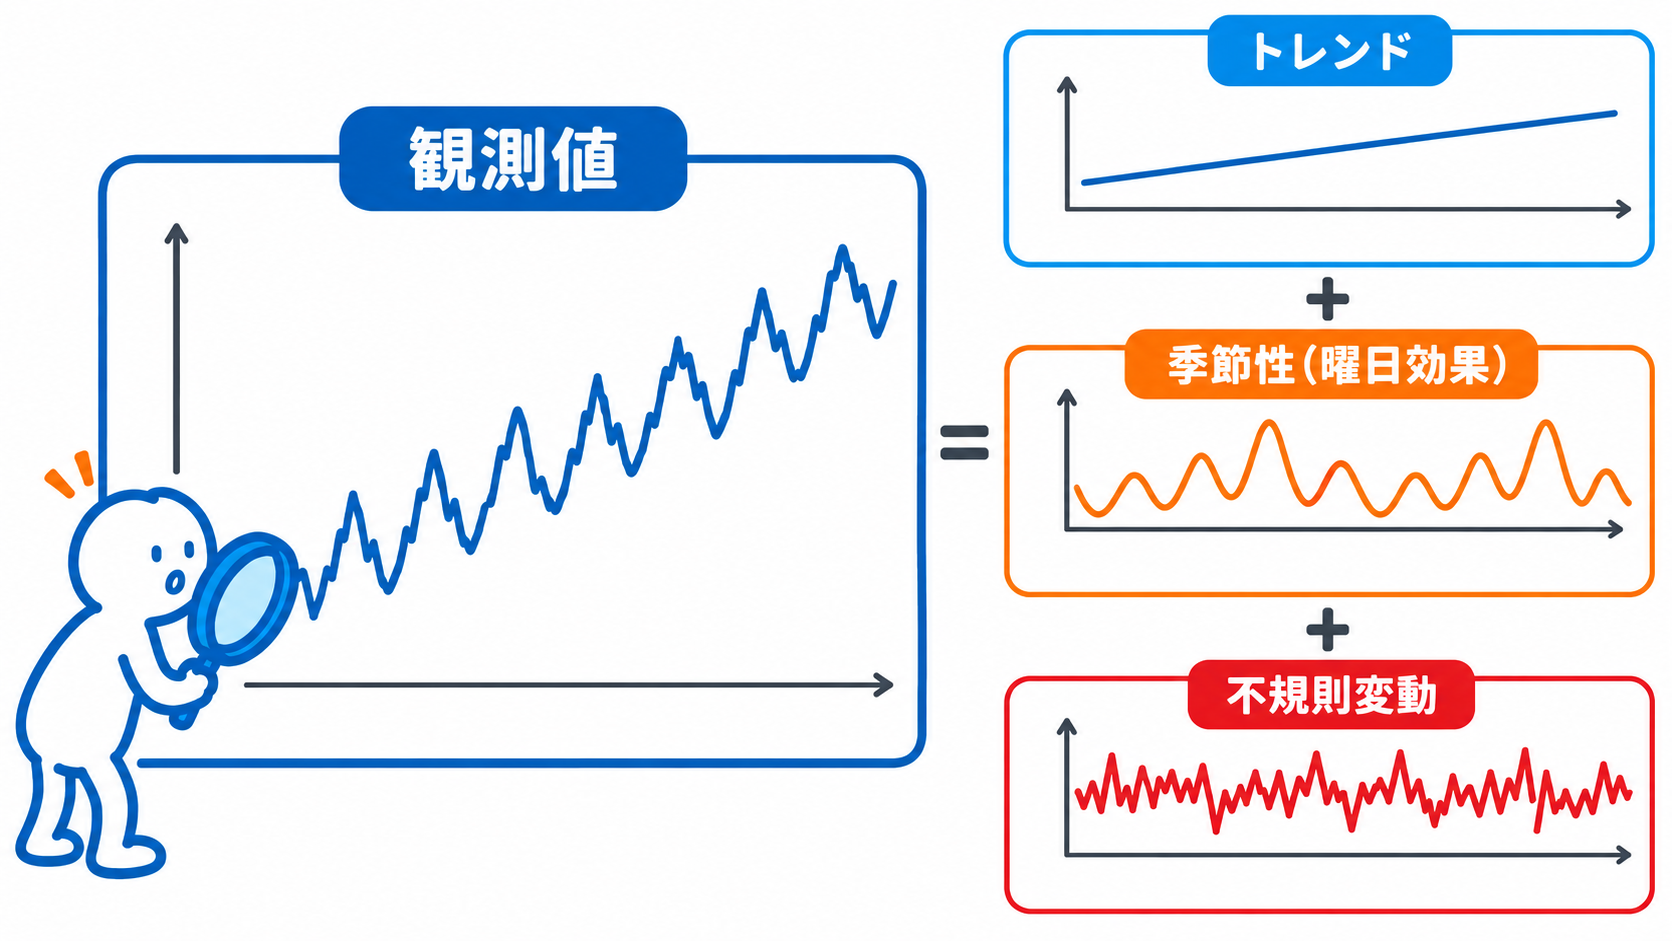
このうち「7日周期の季節性」を曜日ごとの数字にしたものが曜日効果です。たとえば「土曜は月曜より30人多い」「日曜は月曜より20人多い」のような量です。
曜日効果が分かると、2つのことができます。ひとつは曜日効果そのものを取り出すこと(人員配置や仕入れの計画に使えます)。もうひとつは、曜日効果を時系列から取り除くこと(曜日の波に隠れた、ほかのできごとを見つけやすくなります)。この2つを、記事の後半で実際にやります。
答えの分かる練習用データを作る
実際のデータでは、本当の曜日効果は誰にも分かりません。そこで、曜日効果の正解を自分で決めて仕込んだデータを作ります。推定した値が正解に近いかどうかで、やり方の良し悪しを確かめられます。
データは、2025年1月1日から12月31日までの365日分の「来客数」です。次の6つの部品を足し合わせて作ります。
| 部品 | 中身 |
|---|---|
| 水準 | 100人 |
| 曜日効果(正解) | 月曜を0として、火+3、水+5、木+4、金+10、土+30、日+20 |
| トレンド | 1日あたり+0.05人(1年で約+18人) |
| 祝日効果 | 祝日は+35人(2025年の祝日19日、振替休日を含む) |
| 特売日 | 6月18日(水曜日)だけ+50人 |
| ゆらぎ | 平均0、標準偏差5の乱数 |
日付と曜日を作る
まず、時系列データの「時間軸」になる日付を作り、日付から曜日を取り出します。
以下、コードです。
import numpy as np
import pandas as pd

# 2025年の1年分の日付を作る(時系列データの「時間軸」)
dates = pd.date_range("2025-01-01", "2025-12-31", freq="D")
n = len(dates)         # 日数
t = np.arange(n)       # 0, 1, 2, … と数える通し番号(トレンドに使う)
dow = dates.dayofweek  # 曜日を数字で取り出す(月曜=0、火曜=1、…、日曜=6)

print("日数:", n)
print("最初の7日の曜日:", dow[:7].tolist())
以下、実行結果です。
日数: 365
最初の7日の曜日: [2, 3, 4, 5, 6, 0, 1]
pd.date_range は、始まりと終わりを指定して日付を並べる命令です。freq="D" が「1日刻み」の意味です。dates.dayofweek は各日付の曜日を数字で返します。2025年1月1日は水曜日なので、最初の値が2になっています。
祝日のフラグを作る
次に、各日が祝日かどうかを表す列を作ります。祝日なら1、そうでなければ0です。
以下、コードです。
# 2025年の祝日(振替休日を含む19日)
holidays = pd.to_datetime([
    "2025-01-01", "2025-01-13", "2025-02-11", "2025-02-23", "2025-02-24",
    "2025-03-20", "2025-04-29", "2025-05-03", "2025-05-04", "2025-05-05",
    "2025-05-06", "2025-07-21", "2025-08-11", "2025-09-15", "2025-09-23",
    "2025-10-13", "2025-11-03", "2025-11-23", "2025-11-24",
])
holiday = dates.isin(holidays).astype(int)  # 祝日なら1、それ以外は0

print("祝日の日数:", holiday.sum())
以下、実行結果です。
祝日の日数: 19
dates.isin(holidays) は、各日付が祝日のリストに含まれるかを True / False で返し、astype(int) で1 / 0に直しています。
祝日の日付は、ここでは手で書いています。
jpholidayというライブラリ(pip install jpholiday)を使うと、jpholiday.is_holiday(日付)で自動判定できます。
部品を足し合わせて来客数を作る
正解の曜日効果・特売日・ゆらぎを用意して、水準100に足し合わせます。
以下、コードです。
rng = np.random.default_rng(42)  # 乱数のシードを42に固定する

dow_effect_true = np.array([0, 3, 5, 4, 10, 30, 20])  # 正解の曜日効果(月〜日)
campaign = (dates == "2025-06-18").astype(int)        # 特売日(6月18日の水曜)だけ1
noise = rng.normal(0, 5, n)                            # ゆらぎ(平均0、標準偏差5)

# 来客数 = 水準100 + 曜日効果 + トレンド + 祝日効果 + 特売 + ゆらぎ
y = 100 + dow_effect_true[dow] + 0.05 * t + 35 * holiday + 50 * campaign + noise

df = pd.DataFrame({"y": y, "dow": dow, "holiday": holiday, "t": t}, index=dates)
df.index.name = "date"
print(df.head(8).round(1))
以下、実行結果です。
                y  dow  holiday  t
date
2025-01-01  141.5    2        1  0
2025-01-02   98.9    3        0  1
2025-01-03  113.9    4        0  2
2025-01-04  134.9    5        0  3
2025-01-05  110.4    6        0  4
2025-01-06   93.7    0        0  5
2025-01-07  103.9    1        0  6
2025-01-08  103.8    2        0  7
コードの要点を説明します。
| コード | 意味 |
|---|---|
np.random.default_rng(42) |
乱数を作る道具。42をシード(乱数の種)といい、固定すると誰が実行しても同じ乱数になる |
dow_effect_true[dow] |
曜日の数字を添字にして、その曜日の正解の効果を取り出す |
dates == "2025-06-18" |
6月18日だけ True になる。astype(int) で1 / 0に直す |
rng.normal(0, 5, n) |
平均0、標準偏差5のゆらぎをn日分作る |
出力の1行目、2025年1月1日は水曜日(dowが2)で、祝日(元日)なので holiday が1です。来客数は141.5人で、水準100+曜日効果5+祝日35にゆらぎが乗った値です。
グラフで見る:1年分と、最初の4週間
作ったデータを、まず時系列プロット(横軸が日付の折れ線グラフ)で眺めます。最初の4行は、グラフに日本語を表示するための設定です(以降のグラフにも効きます)。
以下、コードです。
import matplotlib.pyplot as plt
import matplotlib_fontja

# 日本語を表示するためのフォント
plt.rcParams["font.sans-serif"] = [
    "Meiryo", "Hiragino Sans", "Noto Sans CJK JP", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False  # マイナス記号の文字化けを防ぐ

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(df.index, df["y"], color="#1f77b4", linewidth=0.8, label="来客数")
h = df["holiday"] == 1
ax.scatter(df.index[h], df["y"][h], color="#d62728", s=20, zorder=3, label="祝日")
ax.set_title("日次の来客数(2025年、架空の例)", loc="left")
ax.set_ylabel("来客数(人)")
ax.legend(loc="upper left")
plt.show()
以下、実行結果です。
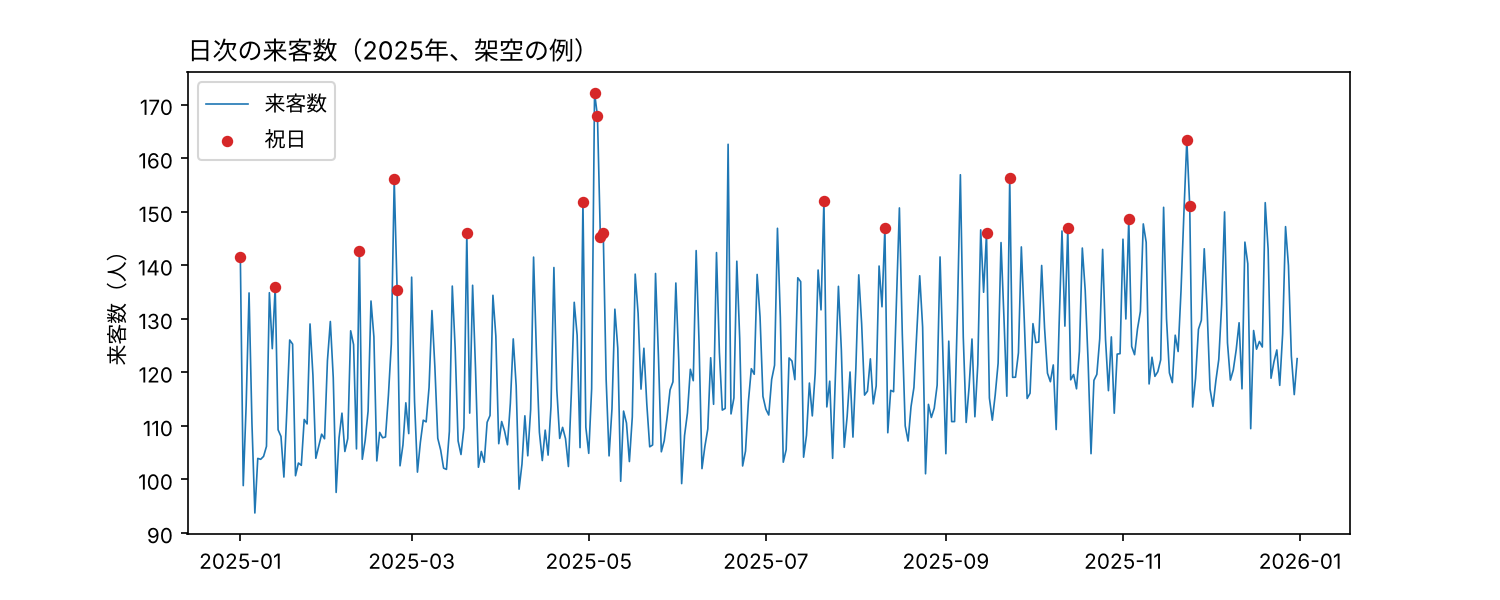
1年を通して細かい波が続き、ところどころに赤い点(祝日)の山があります。6月の中ごろに、祝日ではないのに飛び出している日が1つあります。これが仕込んだ特売日です。
細かい波の正体を見るために、最初の4週間だけを拡大します。先に、表示する範囲と、横軸のラベル・帯の色を用意します。
以下、コードです。
sub = df["2025-01-06":"2025-02-02"]  # 月曜始まりの4週間を抜き出す

# 横軸のラベル(日付と曜日)と、帯の色(土曜=オレンジ、日曜・祝日=赤、平日=白で見えない)
labels = [f"{d.month}/{d.day}\n{'月火水木金土日'[d.dayofweek]}" for d in sub.index]
color = np.where(sub["dow"] == 5, "#ff7f0e",
                 np.where((sub["dow"] == 6) | (sub["holiday"] == 1), "#d62728", "white"))

print(sub.head(7).round(1))
print("帯の色:", color[:7].tolist())
以下、実行結果です。
                y  dow  holiday   t
date
2025-01-06   93.7    0        0   5
2025-01-07  103.9    1        0   6
2025-01-08  103.8    2        0   7
2025-01-09  104.3    3        0   8
2025-01-10  106.2    4        0   9
2025-01-11  134.9    5        0  10
2025-01-12  124.4    6        0  11
帯の色: ['white', 'white', 'white', 'white', 'white', '#ff7f0e', '#d62728']
df["2025-01-06":"2025-02-02"] のように日付の範囲で切り出せるのは、日付が行の名前(インデックス)になっているからです。np.where(条件, Aの値, Bの値) は「条件が True なら A、False なら B」を返します。2段重ねにして、土曜はオレンジ、日曜と祝日は赤、それ以外は白にしています。
以下、コードです。
fig, ax = plt.subplots(figsize=(10, 4))
ax.bar(sub.index, 200, width=1, color=color, alpha=0.2)       # 曜日の帯
ax.plot(sub.index, sub["y"], color="#1f77b4", marker="o")      # 来客数
ax.set_ylim(90, 140)
ax.set_xticks(sub.index, labels, fontsize=8)
ax.set_title("最初の4週間を拡大(オレンジ=土曜、赤=日曜・祝日)", loc="left")
ax.set_ylabel("来客数(人)")
plt.show()
以下、実行結果です。
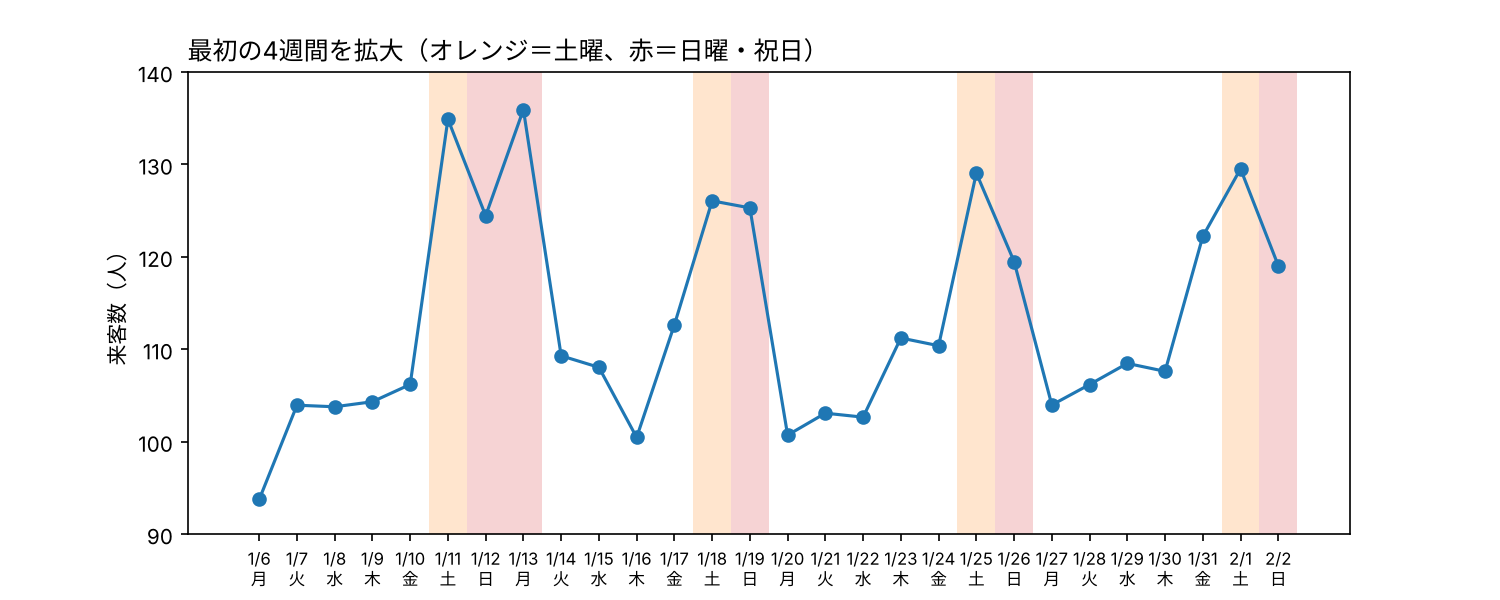
オレンジの帯(土曜)で山になり、赤の帯(日曜)でやや下がり、月曜に底になる。この7日周期の繰り返しが曜日の季節性です。1月13日(月曜・成人の日)は、月曜なのに土曜並みに高くなっています。
部品ごとに分解して見る
正解を知っているデータなので、部品ごとにばらして眺められます。1〜3月分を、部品ごとの列を持つ表にまとめます。
以下、コードです。
q = df.index <= "2025-03-31"  # 1〜3月だけを使う
parts = pd.DataFrame({
    "曜日効果": dow_effect_true[dow][q],
    "トレンド": (0.05 * t)[q],
    "祝日効果": (35 * holiday)[q],
    "ゆらぎ": noise[q],
    "合計(来客数)": y[q],
}, index=df.index[q])

print(parts.head(7).round(1))
以下、実行結果です。
            曜日効果  トレンド  祝日効果  ゆらぎ  合計(来客数)
date
2025-01-01     5   0.0    35  1.5    141.5
2025-01-02     4   0.0     0 -5.2     98.9
2025-01-03    10   0.1     0  3.8    113.9
2025-01-04    30   0.2     0  4.7    134.9
2025-01-05    20   0.2     0 -9.8    110.4
2025-01-06     0   0.2     0 -6.5     93.7
2025-01-07     3   0.3     0  0.6    103.9
1月1日の行を横に読むと、曜日効果5+トレンド0+祝日効果35+ゆらぎ1.5=41.5で、水準100を足すと合計の141.5人になります。実際のデータでは、この「合計」の列しか手に入りません。
各列を縦に並べて描きます。
以下、コードです。
fig, axes = plt.subplots(5, 1, figsize=(10, 10), sharex=True)
for ax, col in zip(axes, parts.columns):
    ax.plot(parts.index, parts[col], color="#1f77b4")
    ax.set_title(col, loc="left", fontsize=10)
axes[-1].set_ylabel("来客数(人)")
plt.tight_layout()
plt.show()
以下、実行結果です。
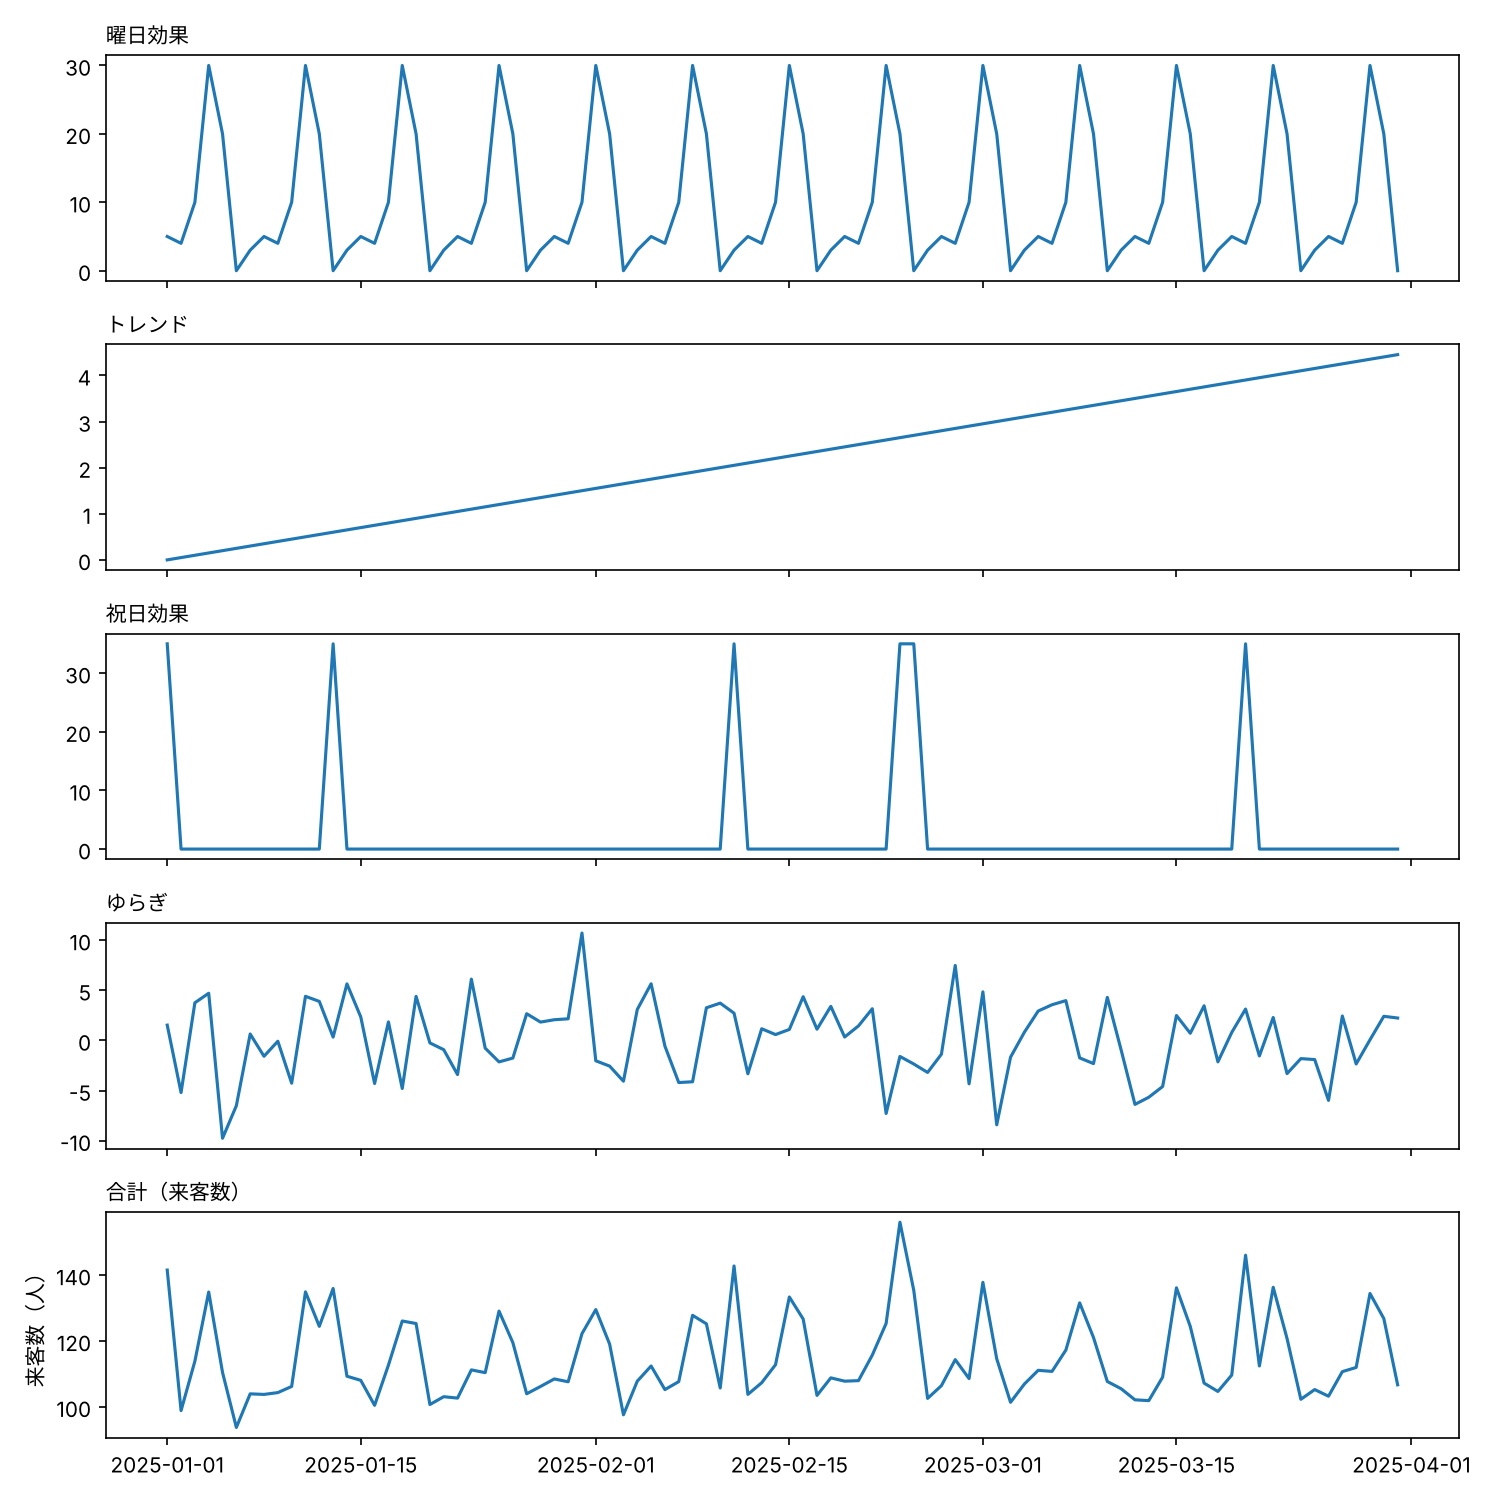
1番上の「曜日効果」は毎週同じ形を繰り返す波、2番目の「トレンド」はなだらかな右肩上がり、3番目の「祝日効果」は祝日だけ立つ棒、4番目の「ゆらぎ」はでたらめな上下です。これらを足したものが、いちばん下の「合計」です。そこから曜日効果を取り出すのが、今回の課題です。
まず、曜日別の平均を出してみる
いちばん素朴な方法は、曜日ごとに平均を出して並べることです。
以下、コードです。
names = ["月", "火", "水", "木", "金", "土", "日"]
mean_by_dow = df.groupby("dow")["y"].mean()  # 曜日ごとの平均

summary = pd.DataFrame({
    "曜日": names,
    "日数": df.groupby("dow").size().values,
    "平均": mean_by_dow.round(1).values,
    "月曜との差": (mean_by_dow - mean_by_dow[0]).round(1).values,
    "正解の曜日効果": dow_effect_true,
})
print(summary.to_string(index=False))
以下、実行結果です。
曜日  日数    平均  月曜との差  正解の曜日効果
 月  52 115.1    0.0        0
 火  52 115.1    0.1        3
 水  53 116.0    1.0        5
 木  52 114.0   -1.0        4
 金  52 119.1    4.1       10
 土  52 140.4   25.4       30
 日  52 129.3   14.3       20
groupby("dow") は「曜日ごとにグループ分けする」命令で、["y"].mean() で各グループの来客数の平均を出しています。
以下、コードです。
colors = ["#1f77b4"] * 5 + ["#ff7f0e", "#d62728"]  # 平日=青、土=オレンジ、日=赤

fig, ax = plt.subplots(figsize=(8, 4))
bars = ax.bar(names, mean_by_dow.values, color=colors)
ax.bar_label(bars, fmt="%.1f")
ax.set_ylim(100, 150)
ax.set_title("曜日別の平均来客数(単純な平均)", loc="left")
ax.set_ylabel("来客数(人)")
plt.show()
以下、実行結果です。
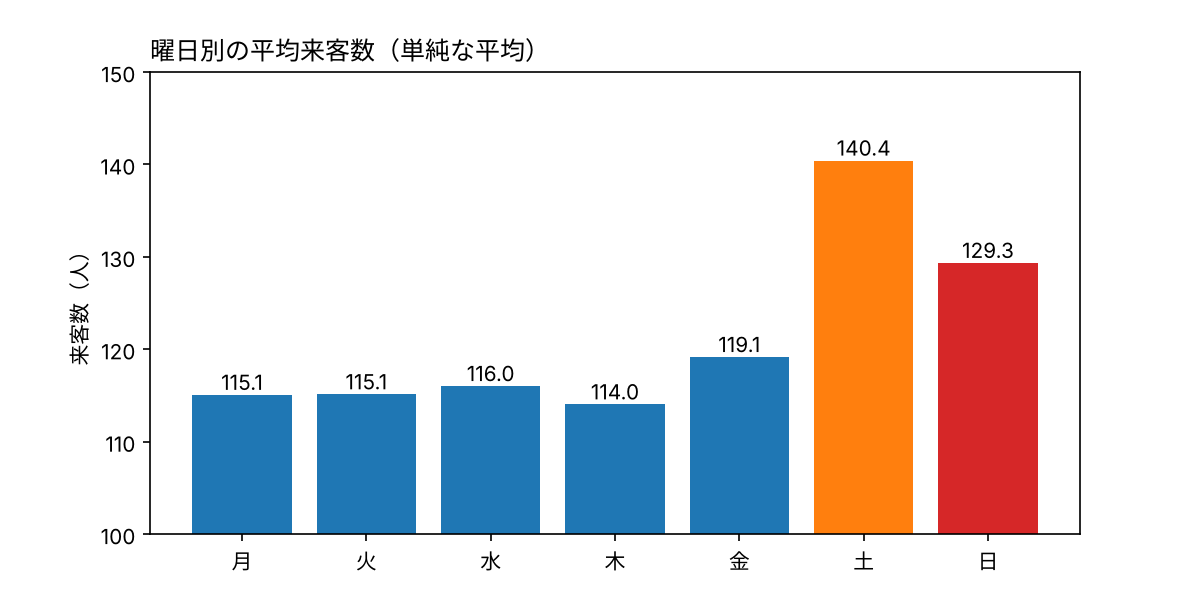
土曜が高く、日曜がその次、という形は正解どおりです。ところが細かく見ると、おかしな点があります。
- 正解では月曜がいちばん低い(火曜より3人少ない)はずなのに、月曜と火曜の平均がほぼ同じ(115.1人)
- 金曜と月曜の差は4.1人。正解は10人なので、半分以下に見える
- 土曜と月曜の差は25.4人。正解の30人より約5人小さい
「月曜との差」が、どの曜日も正解より小さく出ています。月曜の平均が、本来より高くなっているのです。
なぜ月曜が高く見えるのか:祝日が混ざっている
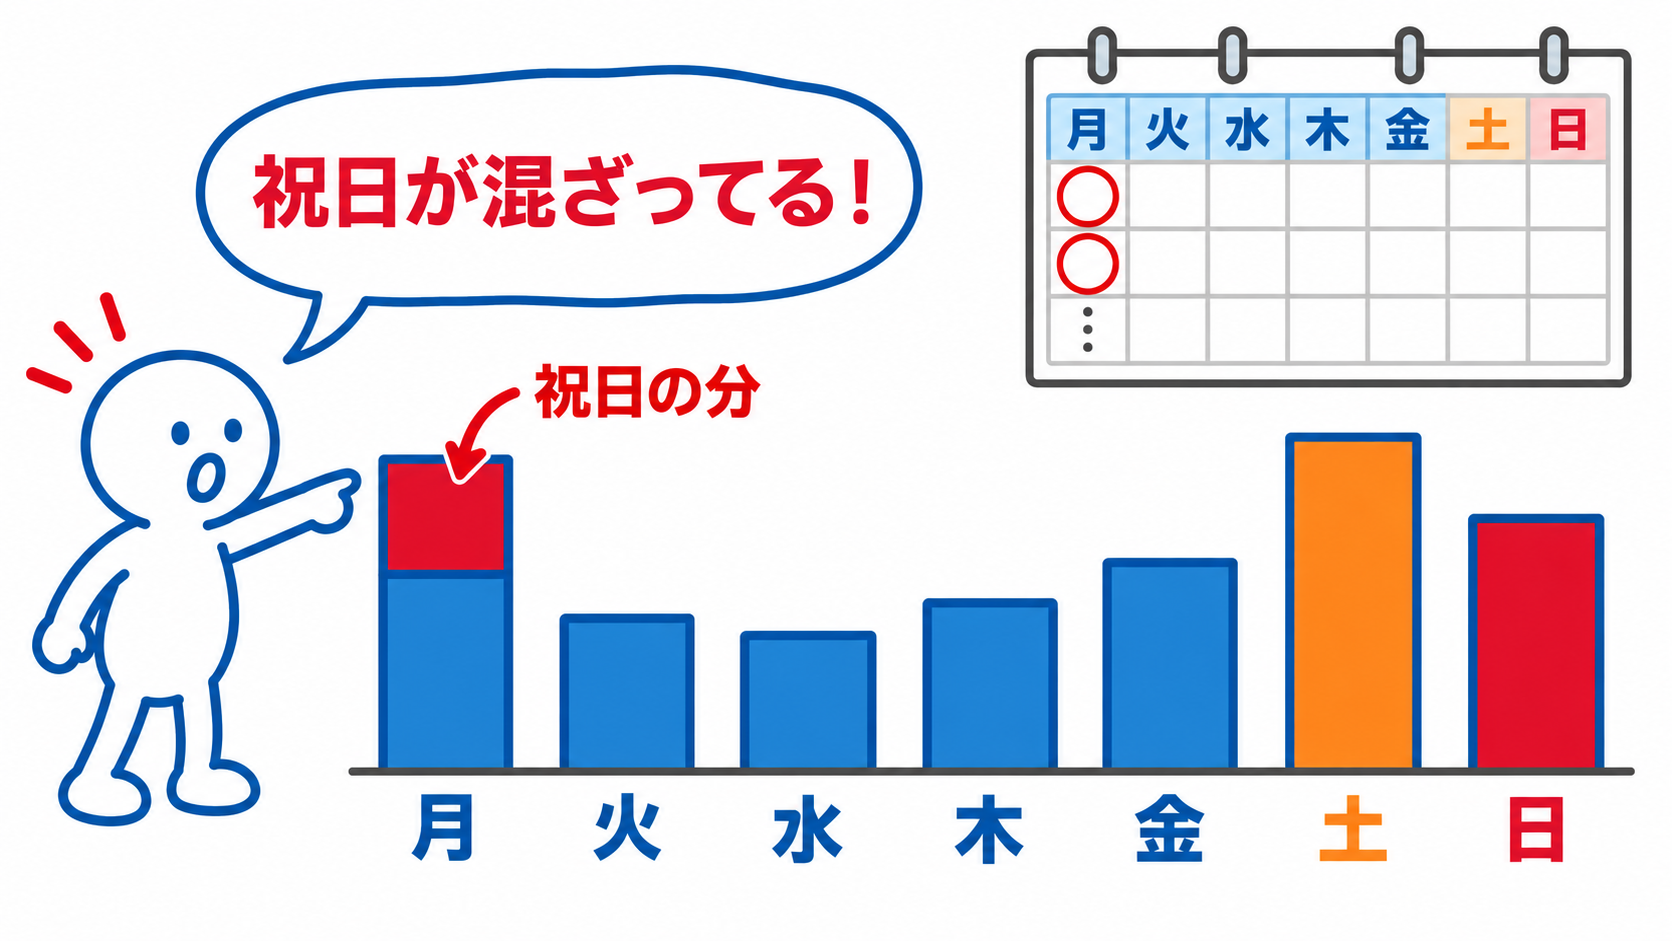
原因は祝日です。曜日別の祝日の日数と、月曜の平均の内訳を調べます。
以下、コードです。
# 曜日別の祝日の日数
holiday_count = df[df["holiday"] == 1].groupby("dow").size().reindex(range(7), fill_value=0)
print("曜日別の祝日の日数:", dict(zip(names, holiday_count.tolist())))

# 月曜の平均を、祝日なし・祝日あり・全部まとめて、の3通りで出す
mon = df[df["dow"] == 0]
mon_mean = mon.groupby("holiday")["y"].mean()
print(f"月曜の平均(祝日なし):{mon_mean[0]:.1f}人({(mon['holiday'] == 0).sum()}日)")
print(f"月曜の平均(祝日あり):{mon_mean[1]:.1f}人({(mon['holiday'] == 1).sum()}日)")
print(f"月曜の平均(全部まとめて):{mon['y'].mean():.1f}人({len(mon)}日)")
以下、実行結果です。
曜日別の祝日の日数: {'月': 9, '火': 4, '水': 1, '木': 1, '金': 0, '土': 1, '日': 3}
月曜の平均(祝日なし):108.7人(43日)
月曜の平均(祝日あり):145.4人(9日)
月曜の平均(全部まとめて):115.1人(52日)
曜日別の祝日の日数を棒グラフにします。
以下、コードです。
fig, ax = plt.subplots(figsize=(8, 4))
bars = ax.bar(names, holiday_count.values, color="#d62728")
ax.bar_label(bars)
ax.set_title("曜日別の祝日の日数(2025年)", loc="left")
ax.set_ylabel("日数")
plt.show()
以下、実行結果です。
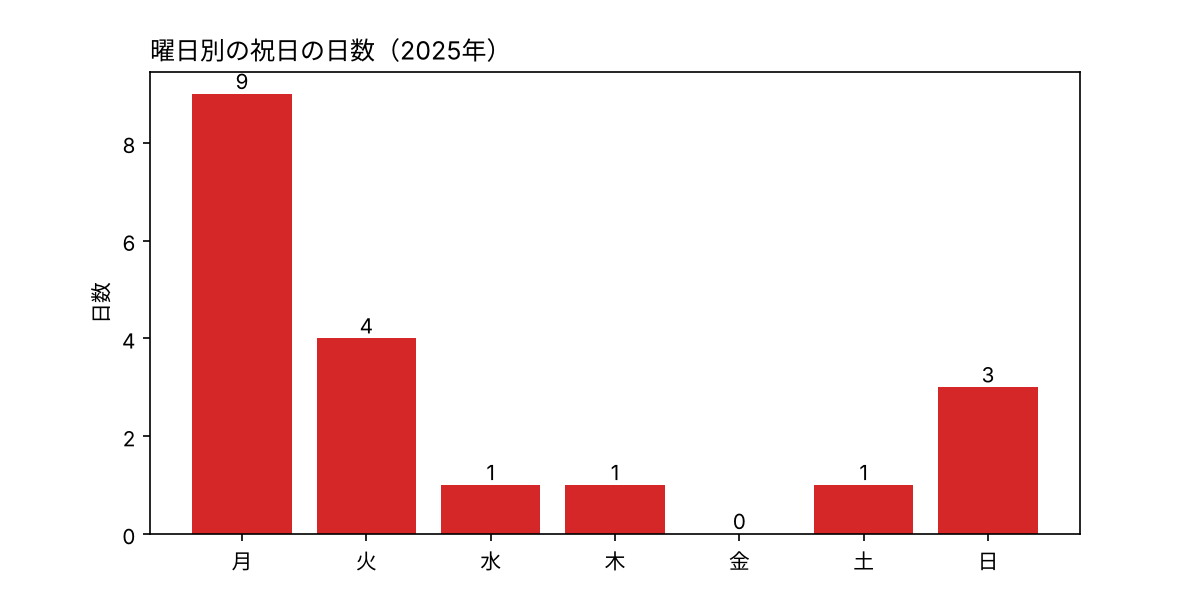
2025年の祝日19日のうち、9日が月曜日です。日本の祝日には「○月の第2月曜日」と決められているものや、日曜と重なったときの振替休日があるため、月曜に集中します。
月曜の平均の内訳も棒グラフにします。
以下、コードです。
fig, ax = plt.subplots(figsize=(8, 4))
bars = ax.bar(["祝日なし", "祝日あり", "全部まとめて"],
              [mon_mean[0], mon_mean[1], mon["y"].mean()],
              color=["#1f77b4", "#d62728", "#7f7f7f"])
ax.bar_label(bars, fmt="%.1f")
ax.set_ylim(90, 160)
ax.set_title("月曜の平均来客数の内訳", loc="left")
ax.set_ylabel("来客数(人)")
plt.show()
以下、実行結果です。
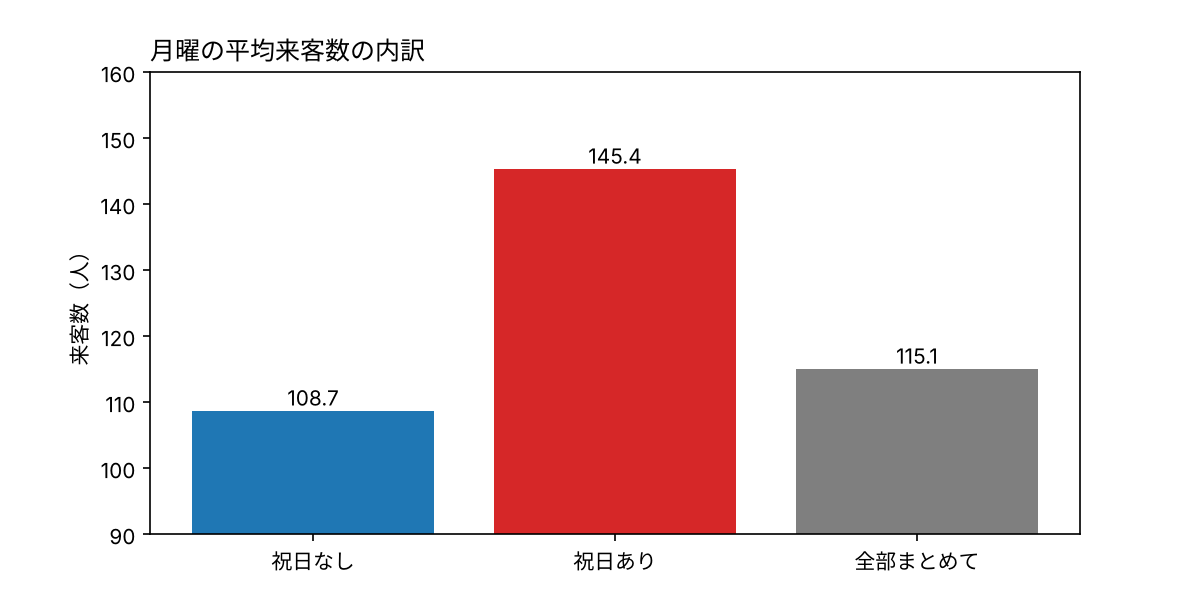
祝日を除いた月曜の平均は108.7人、祝日の月曜は145.4人。これをまとめて平均すると115.1人になり、月曜が約6人分かさ上げされています。これが「月曜との差」を小さく見せていた正体です。
月曜に多い祝日のほかにも、曜日別の平均を歪めるものがあります。たとえばデータの期間が週の倍数でないとき、曜日ごとの日数が1日ずれます。トレンドがあると、日数の多い曜日の平均がわずかに高く出ます。今回も水曜だけ53日で、ほかは52日です。
祝日の月曜を除外して平均すれば、月曜の問題は直ります。しかし祝日は火曜や日曜にもあり、トレンドの影響はすべての曜日に入っています。「気になる要因をひとつずつ手作業で除く」のには限界があります。そこで回帰分析の出番です。
曜日ダミー変数で回帰する(まず曜日だけ)
回帰分析は、目的変数(来客数)を説明変数の式で表す方法です。ただし「曜日」は月・火・水…というカテゴリ変数なので、そのままでは式に入れられません。そこで、曜日をダミー変数に直します。
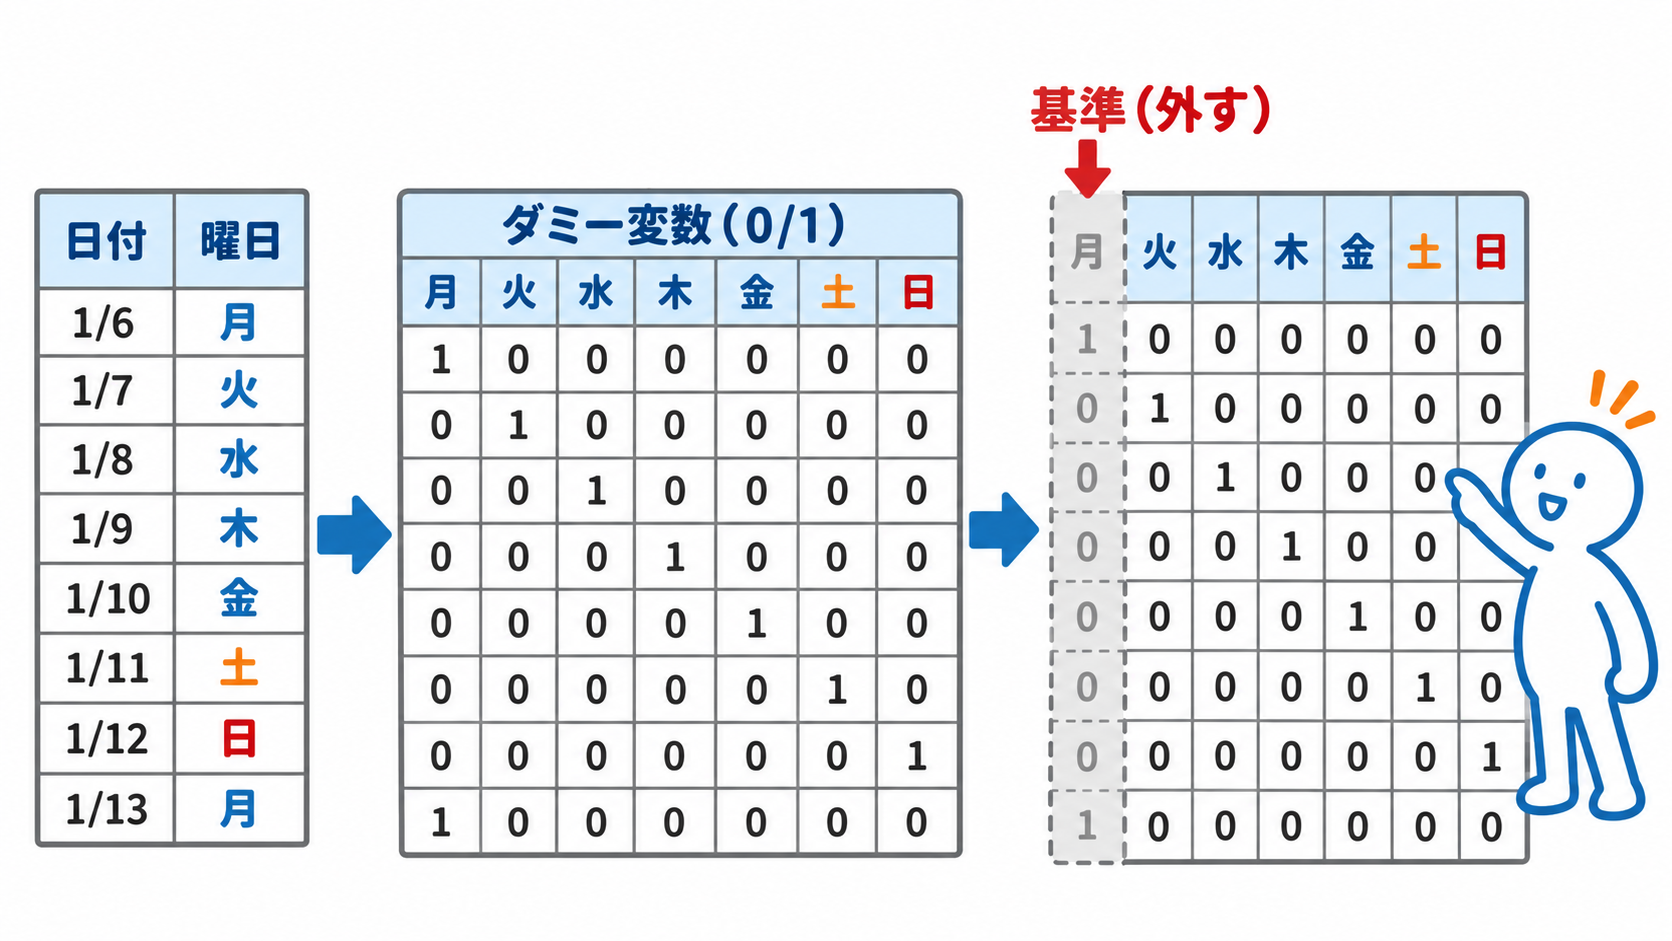
ダミー変数は、「その曜日なら1、違えば0」という列です。曜日は7種類なので、7列できます。pandasの get_dummies で作れます。
以下、コードです。
dummies = pd.get_dummies(df["dow"]).astype(int)  # 曜日を0/1の7列に変換する
dummies.columns = names
print(dummies.head(8))
print("7列を横に足した値:", dummies.sum(axis=1).unique())
以下、実行結果です。
            月  火  水  木  金  土  日
date
2025-01-01  0  0  1  0  0  0  0
2025-01-02  0  0  0  1  0  0  0
2025-01-03  0  0  0  0  1  0  0
2025-01-04  0  0  0  0  0  1  0
2025-01-05  0  0  0  0  0  0  1
2025-01-06  1  0  0  0  0  0  0
2025-01-07  0  1  0  0  0  0  0
2025-01-08  0  0  1  0  0  0  0
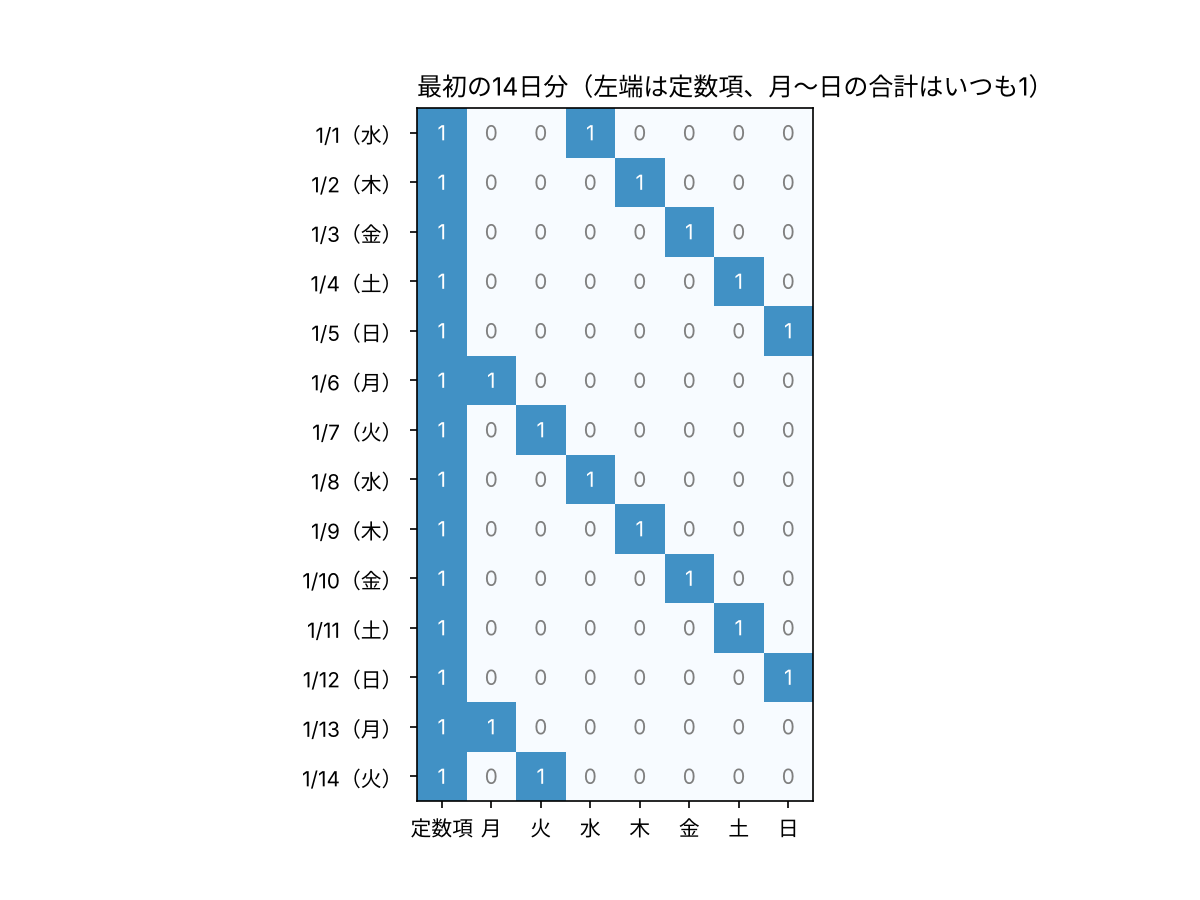
7列を横に足した値: [1]
どの日も、7列のうちちょうど1列だけが1になります。だから7列を横に足すと、必ず1です。この「必ず1」が、次の話につながります。左端に「全部が1の列」(定数項)を足して、最初の14日分を色分けして描きます。
以下、コードです。
mat = pd.concat([pd.Series(1, index=df.index, name="定数項"), dummies], axis=1).head(14)

fig, ax = plt.subplots(figsize=(8, 6))
ax.imshow(mat.values, cmap="Blues", vmin=0, vmax=1.6)
for (i, j), v in np.ndenumerate(mat.values):
    ax.text(j, i, v, ha="center", va="center", color="white" if v else "#7f7f7f")
ax.set_xticks(range(8), mat.columns)
ax.set_yticks(range(14), [f"{d.month}/{d.day}({'月火水木金土日'[d.dayofweek]})" for d in mat.index])
ax.set_title("最初の14日分(左端は定数項、月〜日の合計はいつも1)", loc="left")
plt.show()
以下、実行結果です。
なぜ1つの曜日を外すのか:ダミー変数の罠
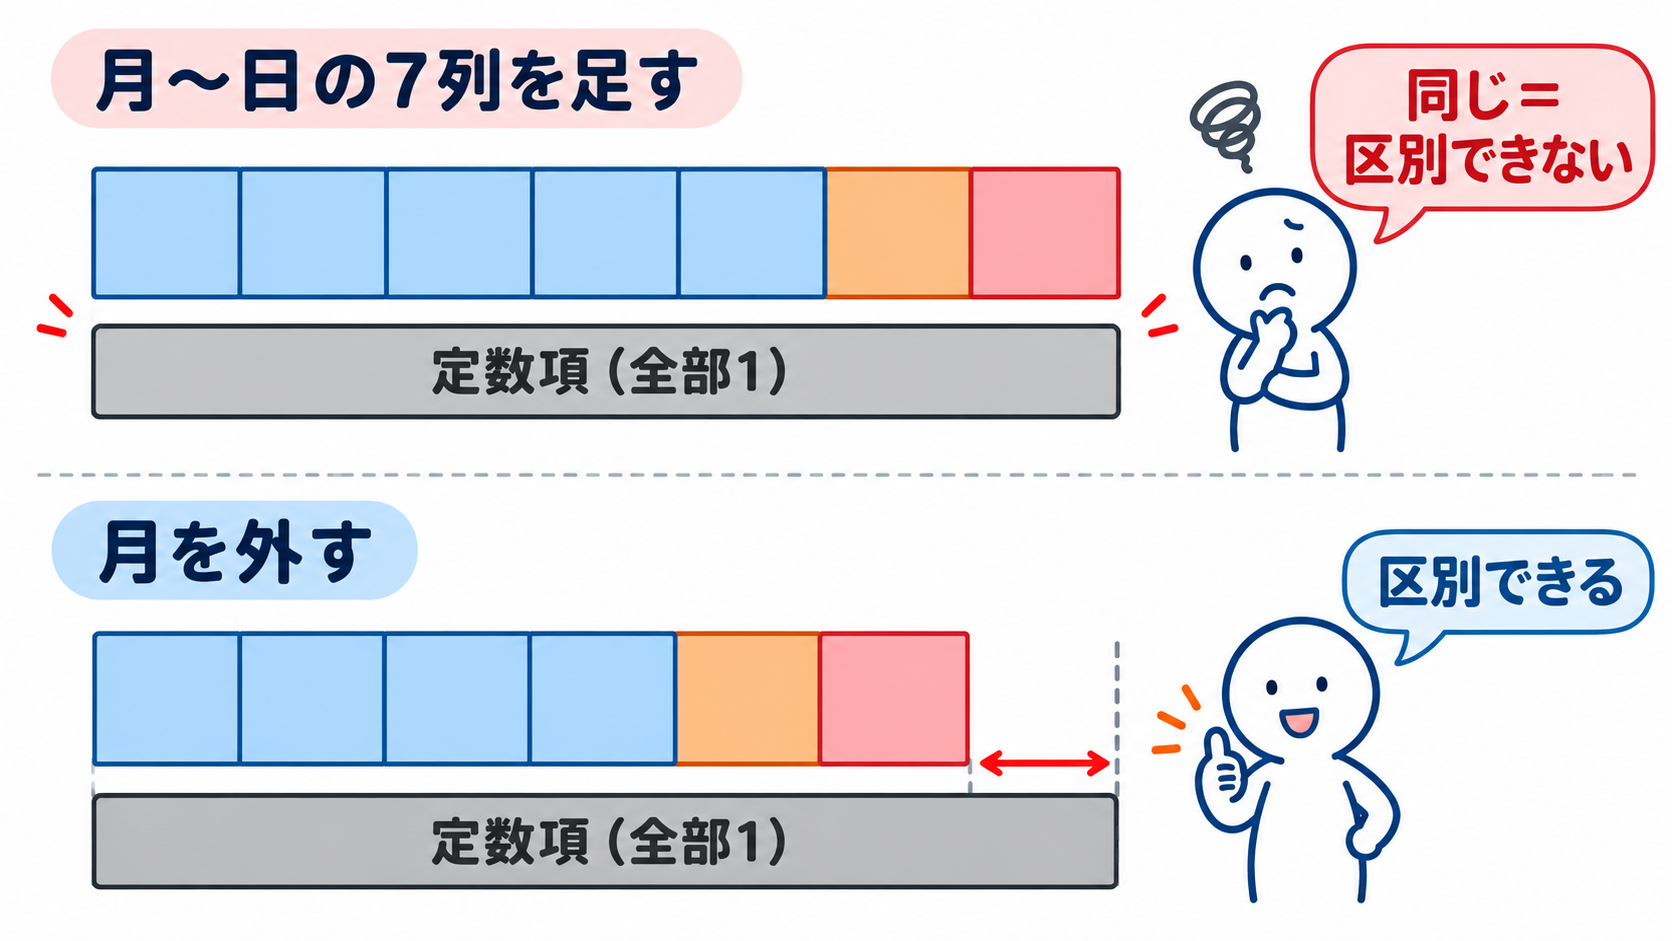
回帰の式には、ふつう定数項(すべての日に共通の水準)が入ります。定数項は「全部の行が1の列」と同じ働きをします。ところが、月〜日の7列を足しても「全部の行が1の列」になります。つまり、定数項と7つのダミー変数は、合わせると同じものを2回入れていることになります。
こうなると、回帰は「水準を定数項で表すか、7つのダミーで表すか」を決められず、係数が一意に求まりません。これをダミー変数の罠(完全な多重共線性)と呼びます。
解決は簡単で、1つの曜日を外すことです。外した曜日を基準カテゴリと呼びます。月曜を基準にすると、式は次の形になります。
来客数 = 定数項 + 係数_火 × D_火 + 係数_水 × D_水 + … + 係数_日 × D_日 + 残差

D_火 … その日が火曜なら1、そうでなければ0(水〜日も同じ)
月曜の日は、D_火〜D_日がすべて0なので「来客数 = 定数項 + 残差」です。つまり定数項は月曜の水準です。火曜の日は「来客数 = 定数項 + 係数_火 + 残差」なので、係数_火は月曜との差です。
statsmodelsで曜日だけの回帰を実行する
statsmodelsの smf.ols を使うと、「y ~ C(dow)」という式を書くだけで、ダミー変数の作成と基準カテゴリの除外を自動でやってくれます。
以下、コードです。
import statsmodels.formula.api as smf

res1 = smf.ols("y ~ C(dow)", data=df).fit()
print(res1.params.round(1))
以下、実行結果です。
Intercept      115.1
C(dow)[T.1]      0.1
C(dow)[T.2]      1.0
C(dow)[T.3]     -1.0
C(dow)[T.4]      4.1
C(dow)[T.5]     25.4
C(dow)[T.6]     14.3
dtype: float64
式の読み方です。
| 書き方・出力 | 意味 |
|---|---|
y ~ C(dow) |
目的変数は y、説明変数は dow。C() で囲むと「カテゴリ変数として扱い、ダミー変数に変換する」という指定になる |
Intercept |
定数項。基準カテゴリ(月曜)の平均来客数 115.1人 |
C(dow)[T.1] 〜 C(dow)[T.6] |
火曜〜日曜の係数。「月曜との差」。T. は Treatment(基準との差を表すダミー変数の作り方)の頭文字 |
C(dow)[T.0] がない |
月曜(最小の値0)が自動で基準カテゴリになり、外されたため |
係数を、さきほどの「単純平均の差」と並べた表にします。
以下、コードです。
coef1 = res1.params.values[1:]  # 火〜日の係数(月曜との差)

compare = pd.DataFrame({
    "単純平均の差": summary["月曜との差"].values[1:],
    "回帰の係数": coef1.round(1),
}, index=names[1:])
print(compare)
以下、実行結果です。
   単純平均の差  回帰の係数
火     0.1    0.1
水     1.0    1.0
木    -1.0   -1.0
金     4.1    4.1
土    25.4   25.4
日    14.3   14.3
ぴったり一致します。グラフにしても同じです。
以下、コードです。
ax = compare.plot.bar(color=["#ff7f0e", "#1f77b4"], figsize=(8, 4), rot=0)
ax.set_title("曜日だけで回帰すると、係数は「単純平均の差」と一致する", loc="left")
ax.set_ylabel("月曜との差(人)")
plt.show()
以下、実行結果です。
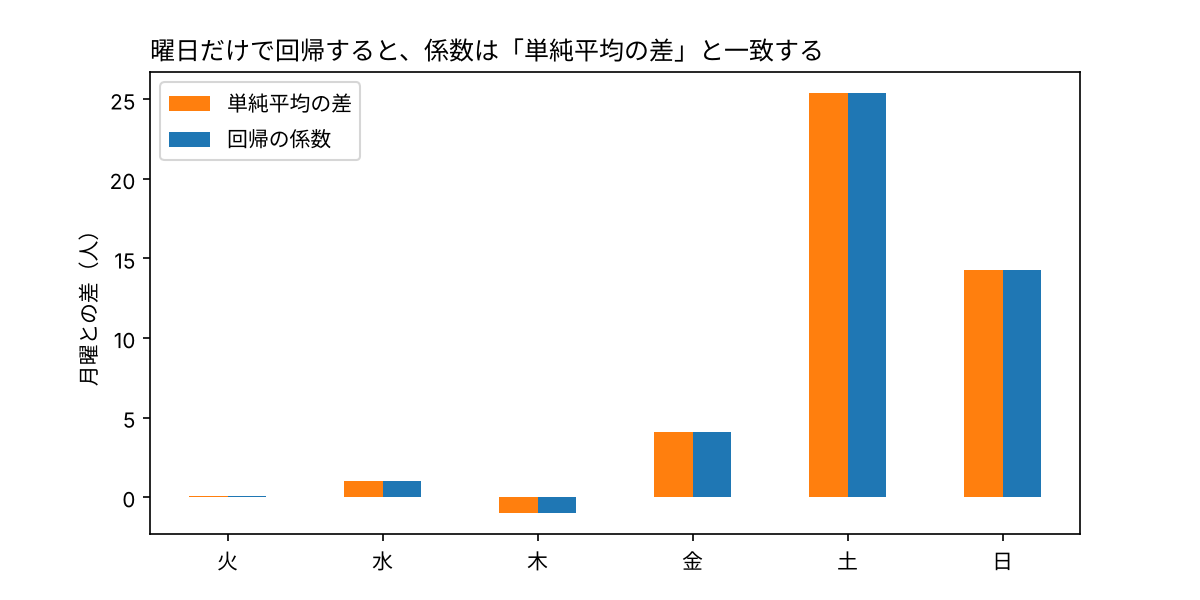
曜日だけで回帰すると、係数は「曜日別の平均の差」そのものです。だから、祝日で膨らんだ月曜の問題もそのまま引き継いでいます。回帰にしただけでは、まだ何も良くなっていません。
C()を付けずにy ~ dowと書くと、曜日を「0から6の数値」として扱い、1本の直線を引いてしまいます。「火曜は月曜より3人多く、水曜はさらに3人多く…」という、曜日では成り立たない仮定になるので注意してください。なおC(dow)は、pd.get_dummies(df["dow"], drop_first=True)で6列を作って回帰するのと同じことです。
祝日とトレンドを同時に入れる:ここが本題
回帰の本当の強みは、説明変数を足していけることです。曜日ダミーに、祝日フラグ(holiday)と通し番号(t)を加えます。
イメージとしては、月曜さんと土曜さんの背比べで、「祝日」と「トレンド」という下駄を外してから同じ床に立ってもらう、ということです。回帰は、ほかの説明変数の影響を差し引いたうえで、曜日の差だけを推定します。これを「ほかの条件をそろえて比べる」と言います。
以下、コードです。
res2 = smf.ols("y ~ C(dow) + holiday + t", data=df).fit()
print(res2.params.round(2))
以下、実行結果です。
Intercept      99.20
C(dow)[T.1]     3.54
C(dow)[T.2]     6.70
C(dow)[T.3]     4.83
C(dow)[T.4]    10.61
C(dow)[T.5]    31.11
C(dow)[T.6]    18.57
holiday        36.73
t               0.05
dtype: float64
新しく出てきた2つの係数を先に見ます。holiday の係数36.73は「祝日は、同じ曜日・同じ時期の平日より約37人多い」という意味で、仕込んだ35にほぼ一致します。t の係数0.05は「1日進むごとに0.05人増える」で、仕込んだトレンドそのものです。
肝心の曜日の係数を、正解と、これまでの2つの方法と並べた表にします。
以下、コードです。
coef2 = res2.params.values[1:7]  # 火〜日の係数(月曜との差)

result = pd.DataFrame({
    "正解": dow_effect_true[1:],
    "単純平均の差": summary["月曜との差"].values[1:],
    "回帰(曜日のみ)": coef1.round(1),
    "回帰(祝日+トレンド)": coef2.round(1),
}, index=names[1:])
print(result)
以下、実行結果です。
   正解  単純平均の差  回帰(曜日のみ)  回帰(祝日+トレンド)
火   3     0.1       0.1          3.5
水   5     1.0       1.0          6.7
木   4    -1.0      -1.0          4.8
金  10     4.1       4.1         10.6
土  30    25.4      25.4         31.1
日  20    14.3      14.3         18.6
右端の列が、祝日とトレンドを入れた回帰です。火曜3.5(正解3)、金曜10.6(正解10)、土曜31.1(正解30)、日曜18.6(正解20)と、正解に近づいています。グラフで比べます。
以下、コードです。
ax = result[["正解", "単純平均の差", "回帰(祝日+トレンド)"]].plot.bar(
    color=["#7f7f7f", "#ff7f0e", "#1f77b4"], figsize=(9, 4.5), rot=0)
ax.set_title("曜日効果(月曜との差)の推定値を正解と比べる", loc="left")
ax.set_ylabel("月曜との差(人)")
plt.show()
以下、実行結果です。
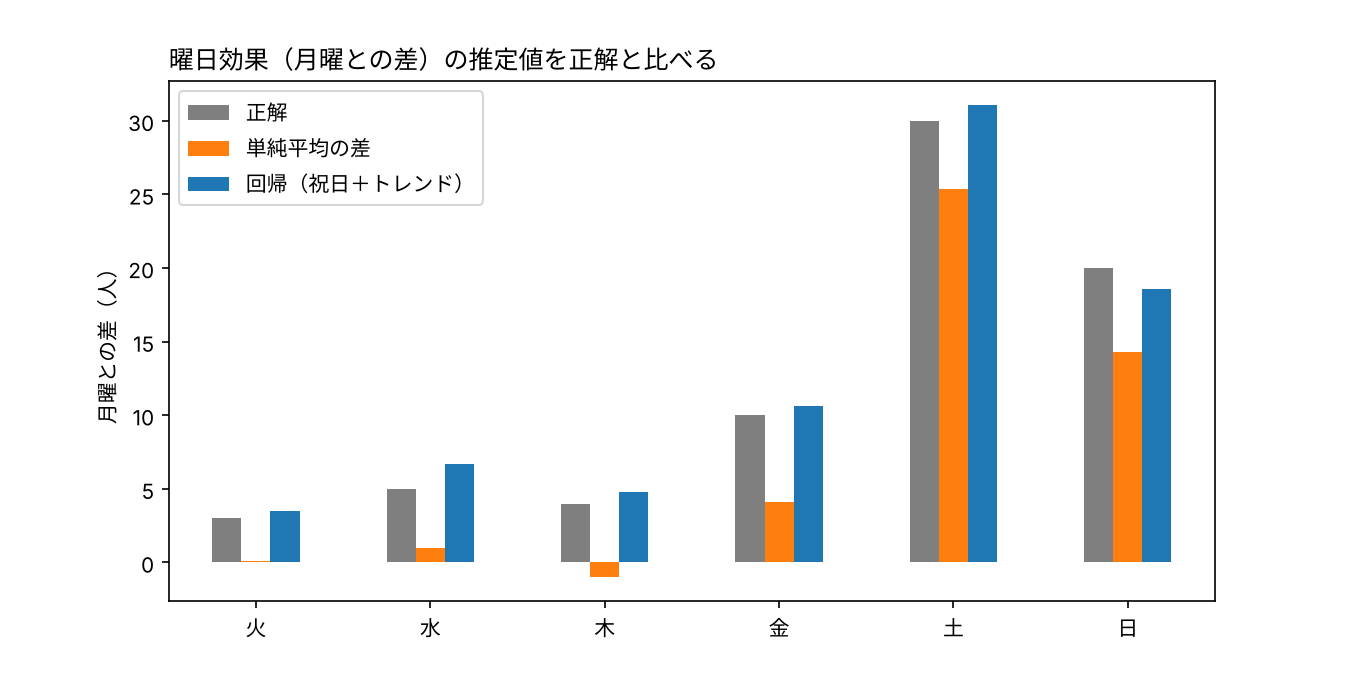
オレンジ(単純平均の差)は、どの曜日も正解(灰色)より小さく出ていました。青(祝日+トレンドを入れた回帰)は正解に重なっています。
月曜の祝日を手作業で除いたわけではありません。holiday を式に入れたことで、回帰が「祝日の分」を holiday の係数に振り分け、曜日の係数から祝日の影響を外してくれたのです。
推定値には、ゆらぎによる幅があります。95%信頼区間(その幅の目安)といっしょに描きます。
以下、コードです。
ci = res2.conf_int().iloc[1:7]  # 火〜日の係数の95%信頼区間(下限と上限)
est = res2.params.iloc[1:7]     # 火〜日の係数の推定値

fig, ax = plt.subplots(figsize=(8, 4.5))
ax.errorbar(est, names[1:], xerr=[est - ci[0], ci[1] - est], fmt="o",
            color="#1f77b4", capsize=4, label="推定値と95%信頼区間")
ax.scatter(dow_effect_true[1:], names[1:], marker="x", s=80, color="#d62728",
           zorder=3, label="正解")
ax.invert_yaxis()
ax.set_xlabel("月曜との差(人)")
ax.set_title("曜日効果の推定値(祝日+トレンドを入れた回帰)", loc="left")
ax.legend(loc="upper right")
plt.show()
以下、実行結果です。
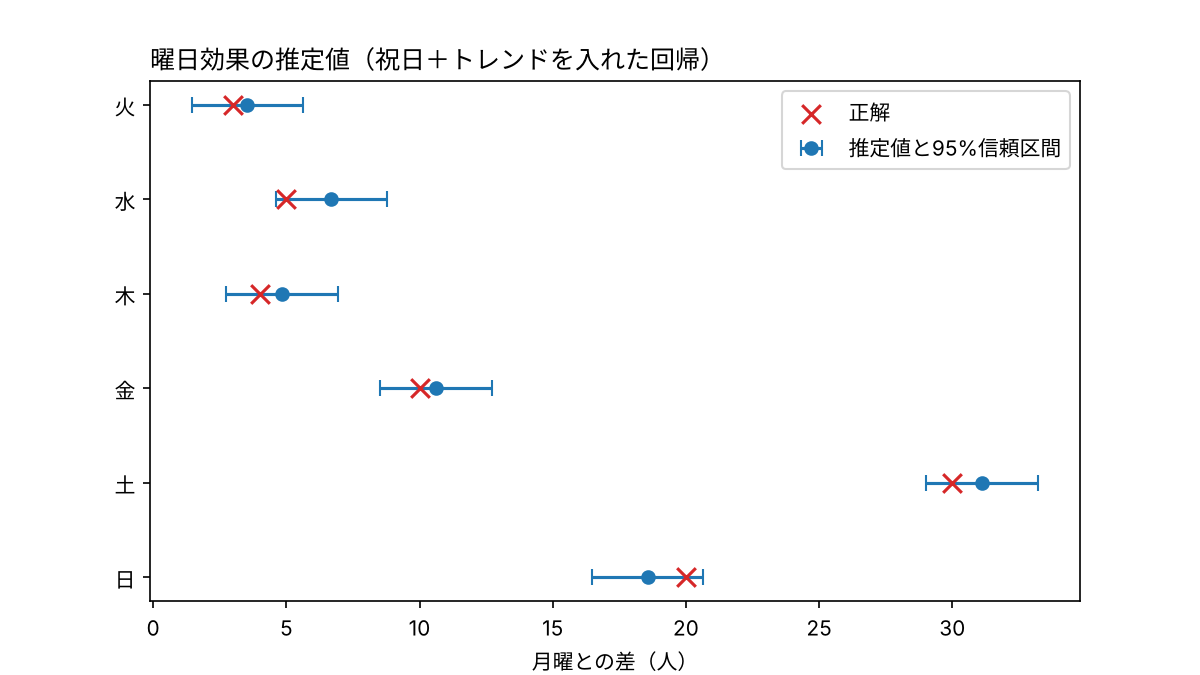
赤いバツ(正解)が、どの曜日も青い区間の中に入っています。水曜が正解5に対して6.7とやや高めなのは、特売日が水曜だったからです。特売日は式に入れていないので、その分が水曜の係数に少しだけ混ざっています。
祝日は「平日なのに週末のように動く日」です。曜日ダミーは曜日の規則しか表せないので、祝日のような「暦の上の例外」は、別のダミー変数として足すのが基本です。年末年始やお盆のような特別な期間も、同じようにフラグ化します。
曜日効果を「取り除く」:曜日調整済みの時系列
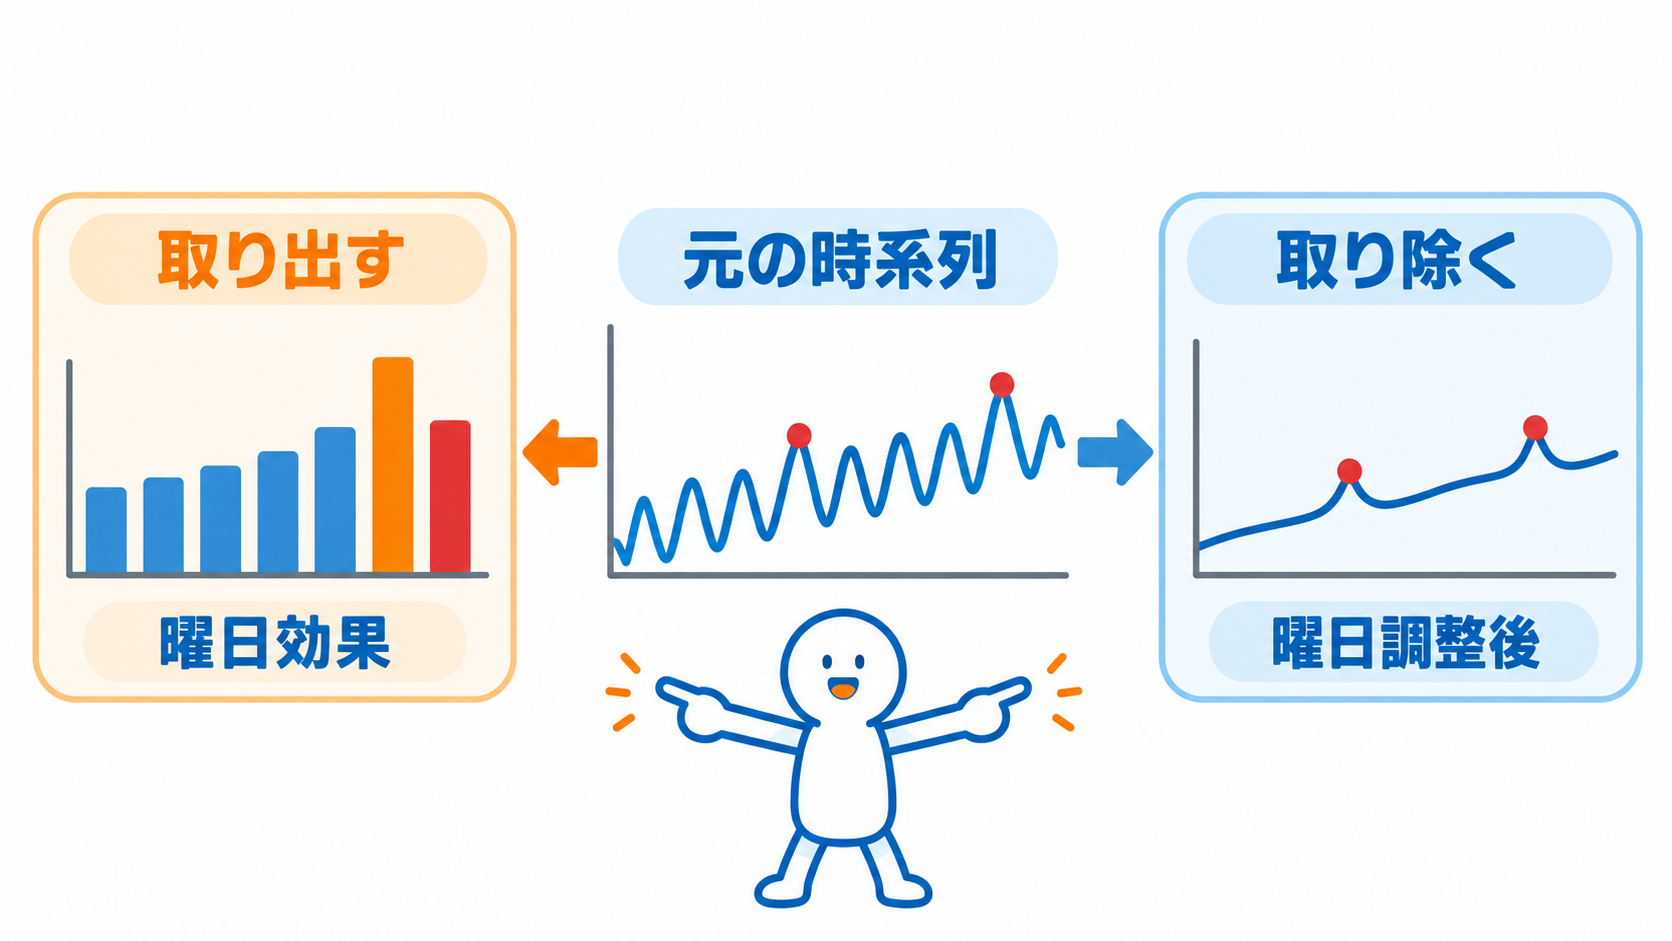
推定した曜日効果は、取り出して終わりではありません。元の時系列から差し引けば、曜日の波を取り除いた時系列(曜日調整済みの時系列)が作れます。
以下、コードです。
dow_effect_est = np.r_[0, coef2]                       # 月曜=0、火〜日は推定した係数
df["dow_adj"] = df["y"] - dow_effect_est[df["dow"]]    # 曜日効果を差し引く

print(df[["dow", "y", "dow_adj"]].head(7).round(1))
以下、実行結果です。
            dow      y  dow_adj
date
2025-01-01    2  141.5    134.8
2025-01-02    3   98.9     94.0
2025-01-03    4  113.9    103.2
2025-01-04    5  134.9    103.7
2025-01-05    6  110.4     91.9
2025-01-06    0   93.7     93.7
2025-01-07    1  103.9    100.4
dow_effect_est は「月曜0、火曜3.54、…、日曜18.57」という推定した曜日効果で、各日の曜日に対応する値を来客数から引いています。1月4日(土曜)は134.9人から31.1人を引いて103.7人、1月6日(月曜)は基準なのでそのまま93.7人です。
元の時系列と、調整後の時系列を上下に並べます。
以下、コードです。
axes = df[["y", "dow_adj"]].plot(subplots=True, figsize=(10, 7), legend=False,
                                 color="#1f77b4", linewidth=0.8)
axes[0].set_title("元の時系列(7日周期の波がある)", loc="left")
axes[1].set_title("曜日調整後の時系列(波が消え、トレンドと祝日の山が見える)", loc="left")
axes[0].set_ylabel("来客数(人)")
axes[1].set_ylabel("来客数(人)")
axes[1].set_xlabel("")
plt.show()
以下、実行結果です。
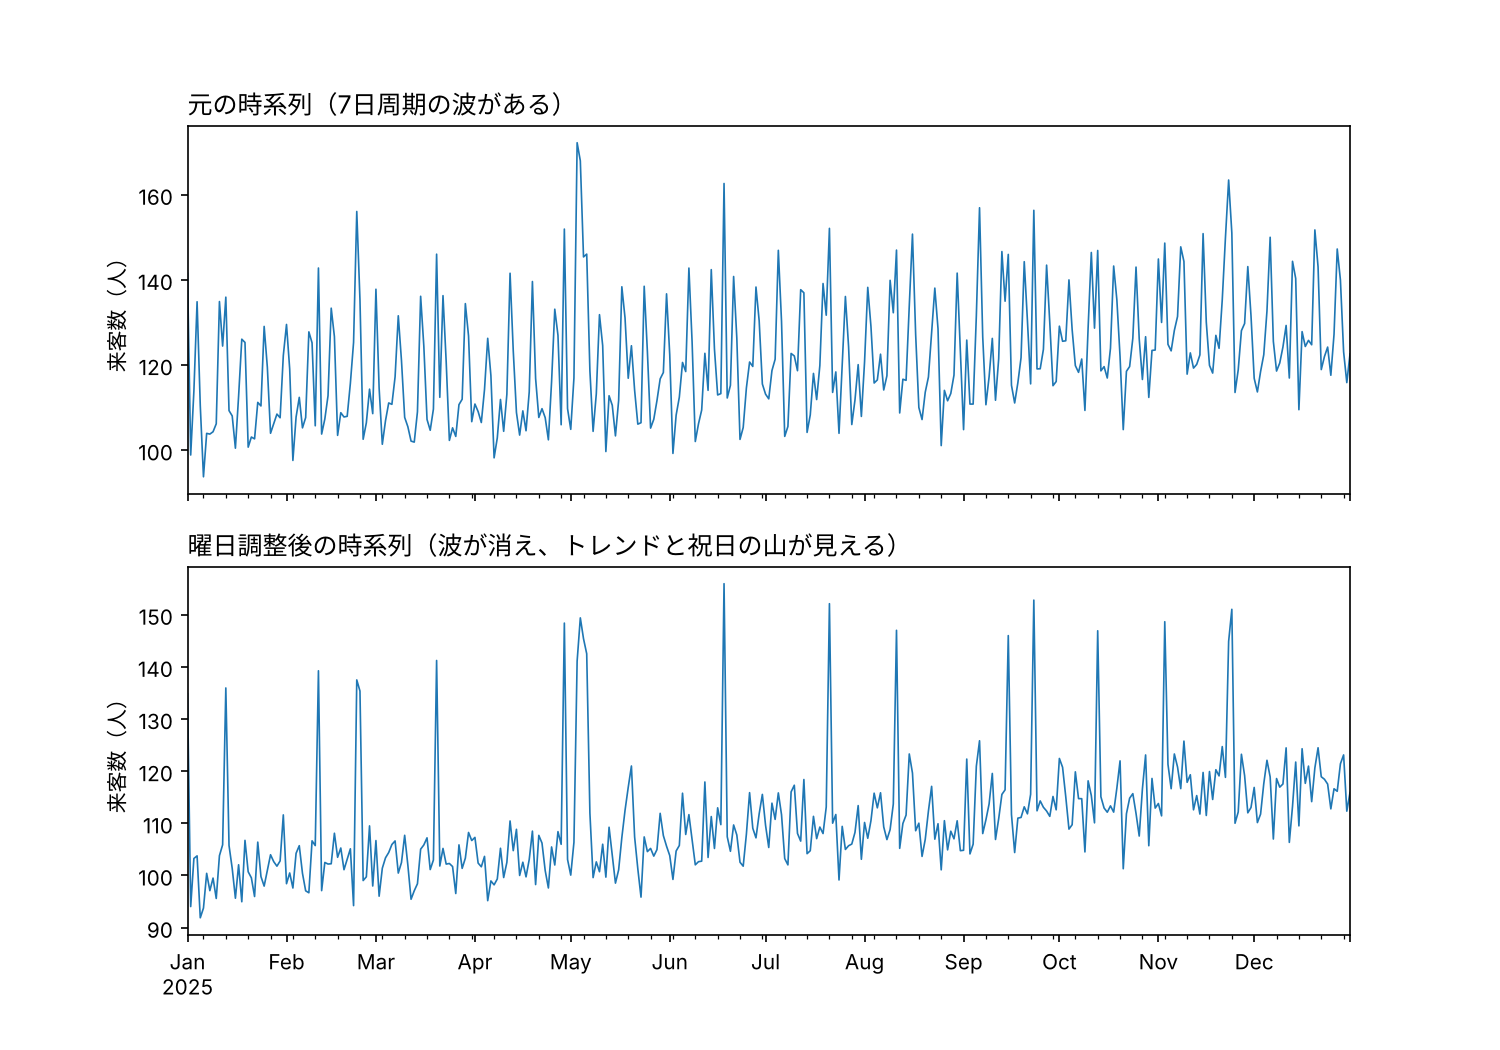
上の段では7日周期の波が目立ち、祝日の山は波に紛れて見分けにくい日もあります。下の段では波が消え、右肩上がりのトレンドと、祝日の山がくっきり見えます。
調整後の時系列で、来客数が多かった日を上から5日見てみます。
以下、コードです。
df["曜日"] = [names[k] for k in df["dow"]]
top5 = df.sort_values("dow_adj", ascending=False).head(5)
print(top5[["曜日", "holiday", "y", "dow_adj"]].round(1))
以下、実行結果です。
           曜日  holiday      y  dow_adj
date
2025-06-18  水        0  162.6    155.9
2025-09-23  火        1  156.3    152.8
2025-07-21  月        1  152.1    152.1
2025-11-24  月        1  151.0    151.0
2025-05-04  日        1  167.9    149.4
1位は6月18日の水曜日、仕込んだ特売日です。元の値162.6人のままでも目立ってはいましたが、調整後は「曜日のせいではない」ことがはっきりします。2位以下は、すべて祝日です。
この日を、グラフの上で指し示します。
以下、コードです。
peak = df["dow_adj"].idxmax()  # 調整後に最も大きい日

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(df.index, df["dow_adj"], color="#1f77b4", linewidth=0.8, label="曜日調整後")
h = df["holiday"] == 1
ax.scatter(df.index[h], df["dow_adj"][h], color="#d62728", s=20, zorder=3, label="祝日")
ax.annotate(f"{peak.month}/{peak.day}(特売日)", xy=(peak, df.loc[peak, "dow_adj"]),
            xytext=(peak + pd.Timedelta(days=40), 130), color="#ff7f0e",
            arrowprops=dict(arrowstyle="->", color="#ff7f0e"))
ax.set_title("曜日調整後の時系列:祝日と特売日が浮かび上がる", loc="left")
ax.set_ylabel("来客数(人)")
ax.legend(loc="upper left")
plt.show()
以下、実行結果です。
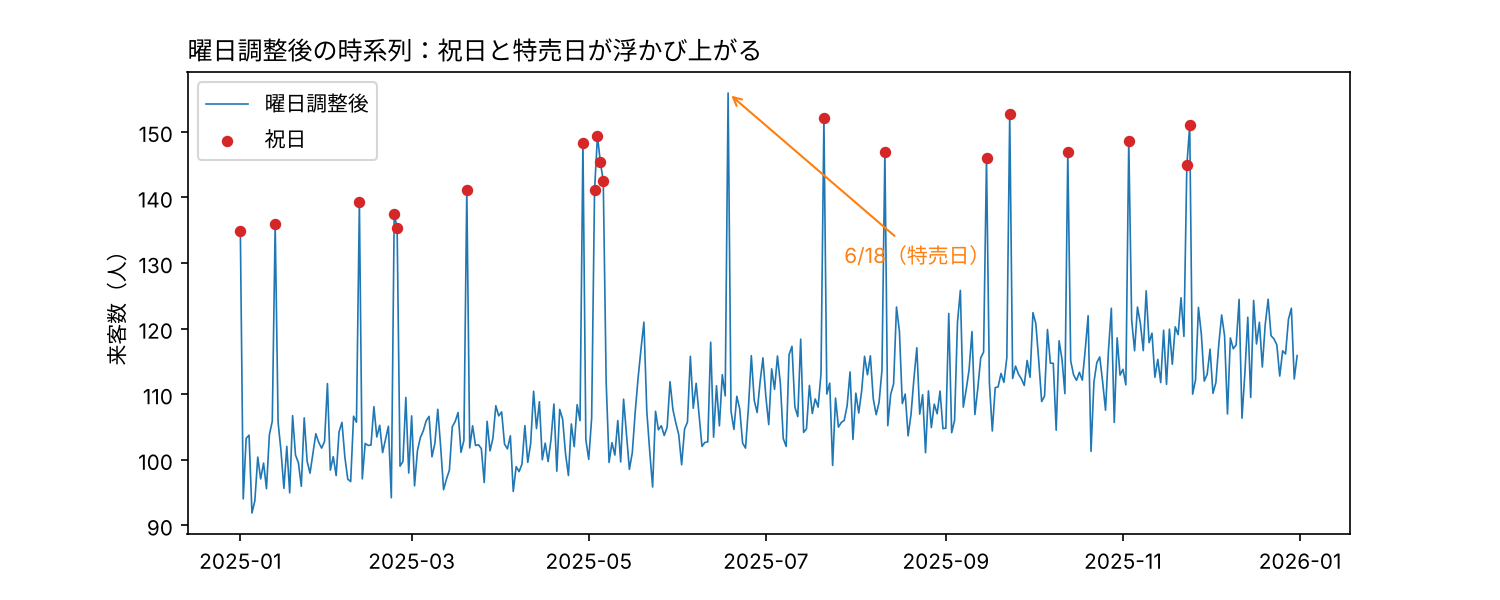
キャンペーンの効果を見たいときや、異常に多かった(少なかった)日を探したいときは、曜日の波を取り除いてから眺めると、見落としが減ります。
時系列ならではのチェック:残差の自己相関
時系列データの回帰には、ふつうの回帰にはない確認事項があります。残差(実際の値と予測値の差)に、日付の並び順での規則性が残っていないか、という点です。
以下、コードです。
resid = res2.resid  # 残差 = 実際の値 − 回帰の予測値
print(f"残差の標準偏差:{resid.std():.2f}")
以下、実行結果です。
残差の標準偏差:5.28
残差の標準偏差5.28が、仕込んだゆらぎの5より少し大きいのは、式に入れていない特売日の1日分です。残差を日付順に描き、その下に自己相関を描きます。
以下、コードです。
from statsmodels.graphics.tsaplots import plot_acf

fig, axes = plt.subplots(2, 1, figsize=(10, 7))
axes[0].plot(df.index, resid, color="#1f77b4", linewidth=0.8)
axes[0].axhline(0, color="#7f7f7f", linestyle=":")
axes[0].set_title("残差の時系列プロット(モデルで説明できなかった残り)", loc="left")
axes[0].set_ylabel("残差(人)")
plot_acf(resid, lags=21, ax=axes[1], title="", color="#1f77b4",
         vlines_kwargs={"colors": "#1f77b4"})
axes[1].set_title("残差の自己相関(ACF):青い帯の中なら「相関なし」とみてよい", loc="left")
axes[1].set_xlabel("ずらした日数(ラグ)")
plt.tight_layout()
plt.show()
以下、実行結果です。
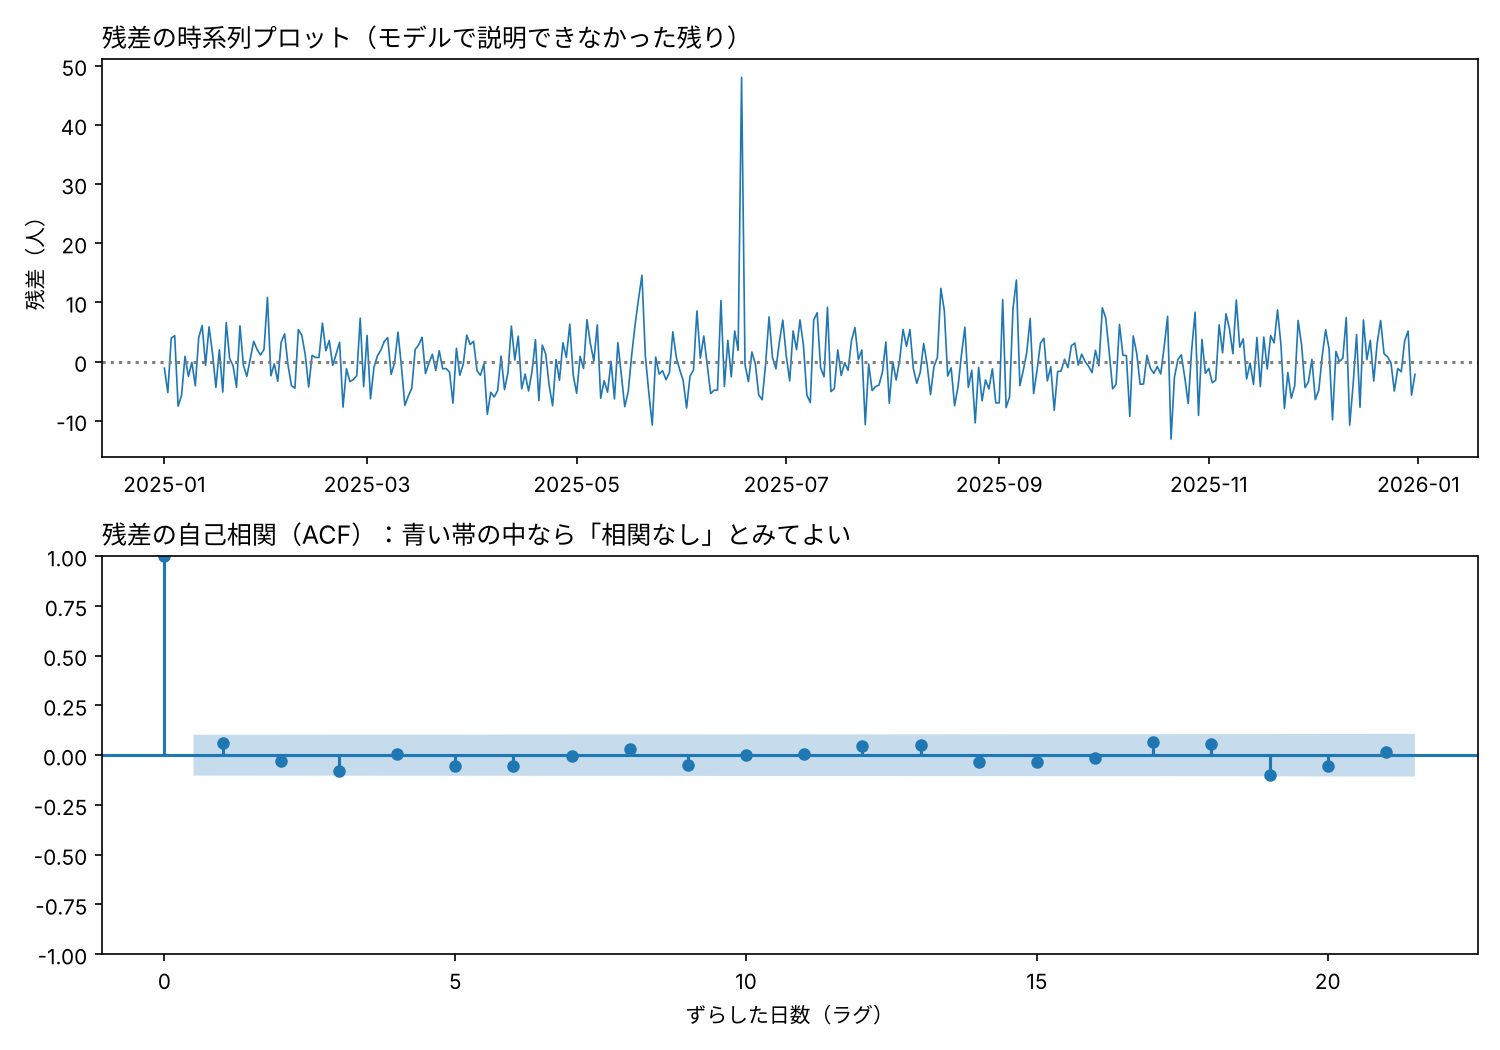
上の段は残差を日付順に並べたものです。0のまわりにでたらめに散っていて、特売日の1点だけが飛び出しています。
下の段は自己相関(ACF)です。横軸は「何日ずらしたか」で、縦軸は「ずらした日の残差とどれだけ似ているか」です。青い帯の中に収まっていれば、「相関はない」と考えてよい目安です。今回はすべて帯の中なので問題ありません。
もし実データで、7日ごとに帯の外へ飛び出すなら「曜日の規則が残っている」、1〜3日に大きな値が出るなら「前日の影響が残っている」というサインです。その場合は、係数の標準誤差やp値が本来より小さく出やすいので、誤差の構造までモデル化する方法(SARIMAXなど)を検討します。
実務で使うときの注意点
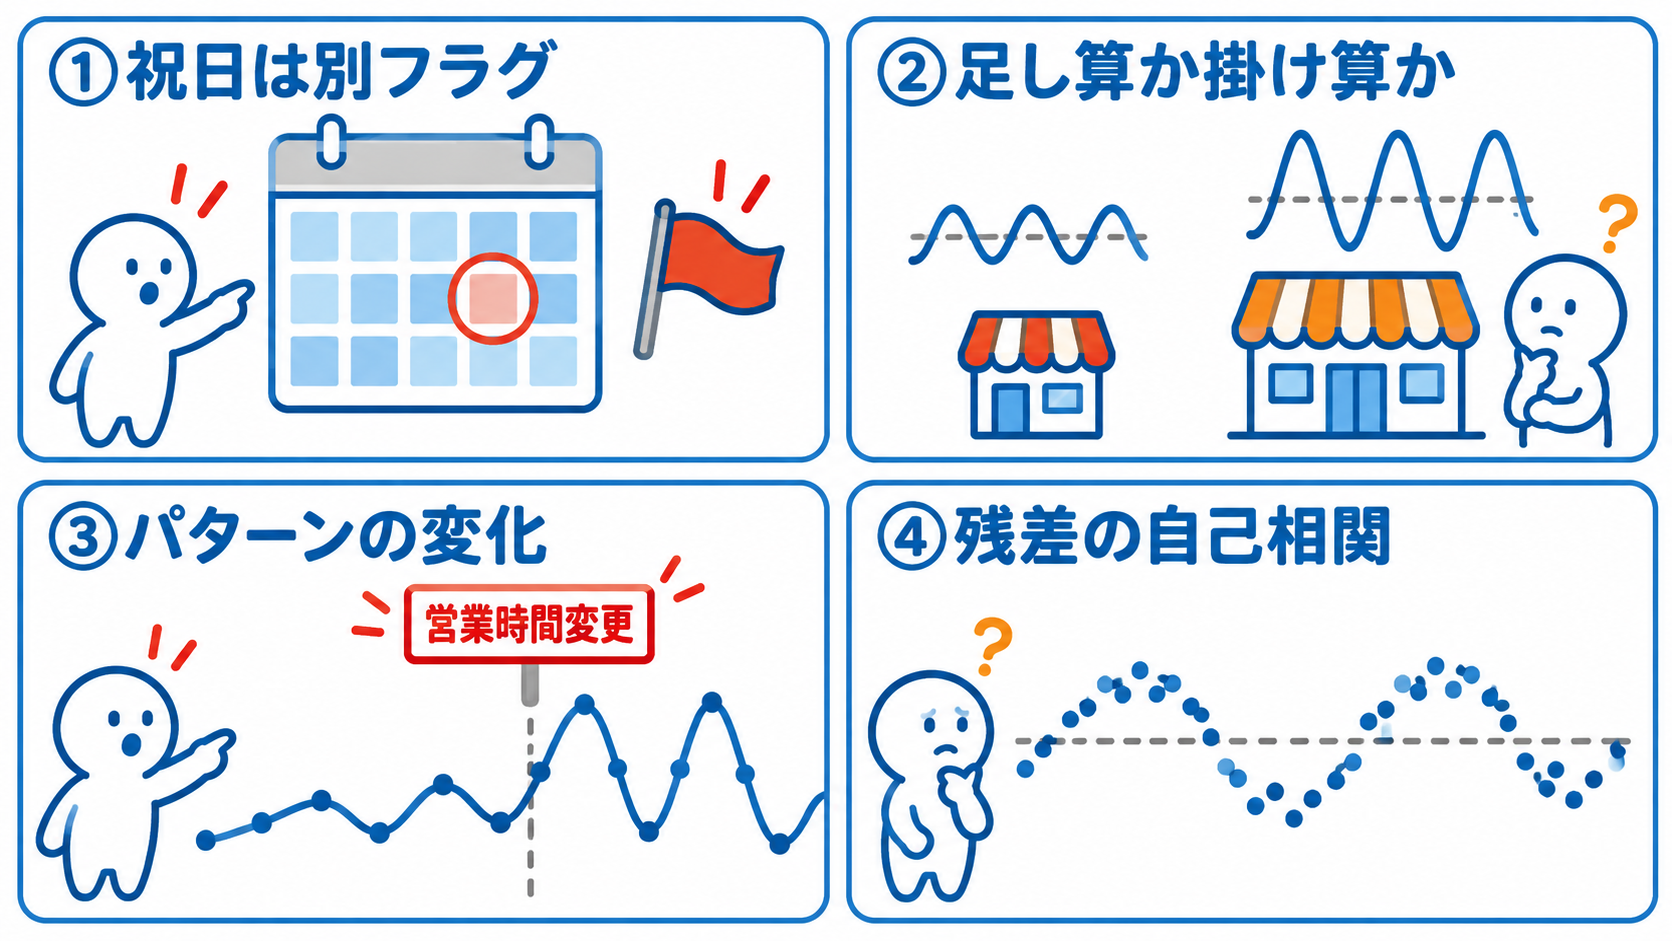
① 祝日は別のフラグにする
記事で見たとおり、祝日は曜日ダミーでは捉えられません。祝日フラグを必ず別に入れましょう。業種によっては、祝日の前日や連休の中日も別に扱います。
② 足し算か、掛け算か
今回は曜日効果を「+30人」のような足し算(加法的)で仕込みました。しかし売上などでは「土曜は月曜の1.3倍」のように、水準に比例して差が広がる(乗法的な)ことがよくあります。別のデータで確かめます。
以下、コードです。
# 別の練習用データ:1年で来客数が100人から300人に増え、曜日効果は「倍率」で効く
level = 100 * (1 + 2 * t / n)
ratio = np.array([1.00, 1.03, 1.05, 1.04, 1.10, 1.30, 1.20])[dow]  # 土曜は月曜の1.3倍
y_mult = level * ratio * np.exp(rng.normal(0, 0.03, n))

print(pd.Series(y_mult, index=dates).round(1).head(7))
以下、実行結果です。
date
2025-01-01    109.8
2025-01-02    102.3
2025-01-03    108.5
2025-01-04    132.9
2025-01-05    125.8
2025-01-06    102.8
2025-01-07    110.7
Freq: D, dtype: float64
水準が1年で3倍になり、曜日効果は倍率で効くデータです。そのままの値と、対数をとった値を並べて描きます。
以下、コードです。
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].plot(dates, y_mult, color="#1f77b4", linewidth=0.8)
axes[0].set_title("そのまま:水準が上がると曜日の差も広がる", loc="left", fontsize=10)
axes[0].set_ylabel("来客数(人)")
axes[1].plot(dates, np.log(y_mult), color="#1f77b4", linewidth=0.8)
axes[1].set_title("対数をとる:曜日の差が一定の幅になる", loc="left", fontsize=10)
axes[1].set_ylabel("log(来客数)")
plt.tight_layout()
plt.show()
以下、実行結果です。
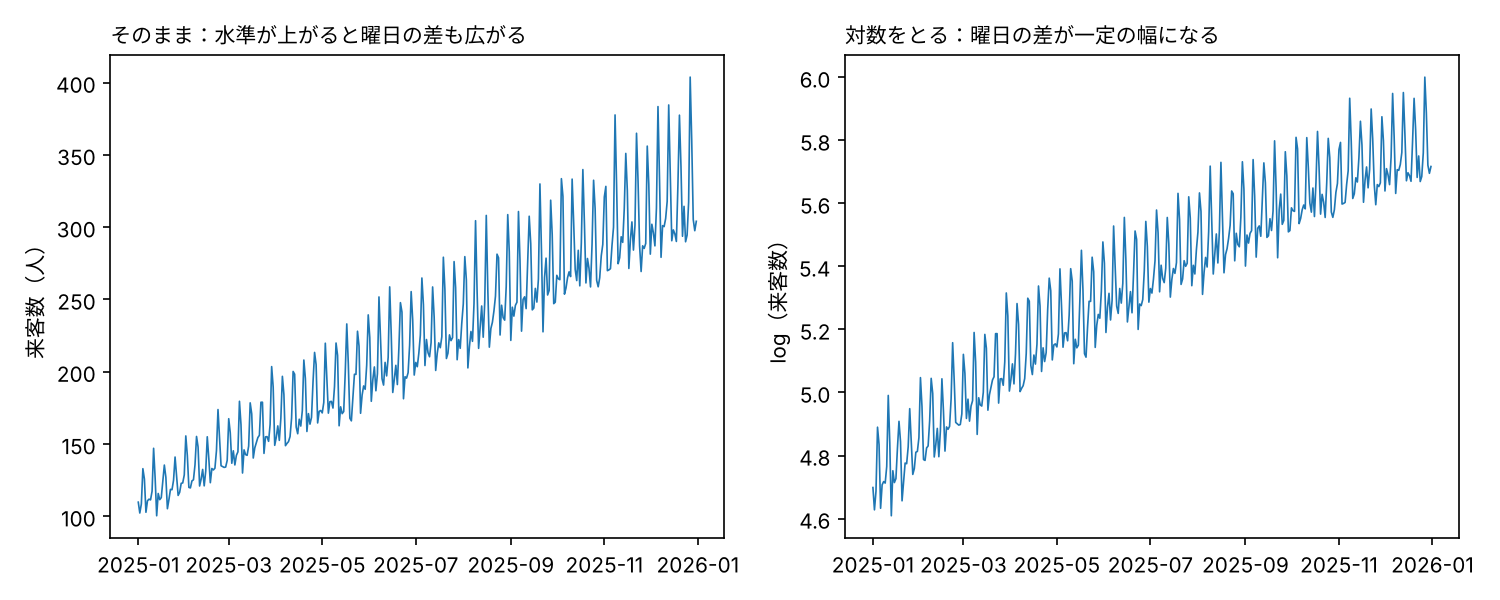
左のグラフでは、来客数が増えるにつれて曜日の波の振れ幅も広がっています。この場合、足し算の曜日効果では「前半は過大、後半は過小」になります。右のように目的変数の対数をとると、波の幅がそろいます。対数をとった回帰の係数は、指数関数で戻すと「月曜の何倍か」と読めます。
以下、コードです。
df_m = pd.DataFrame({"y": y_mult, "dow": dow, "t": t})
res_log = smf.ols("np.log(y) ~ C(dow) + t", data=df_m).fit()  # 対数をとってから回帰
sat = res_log.params["C(dow)[T.5]"]
print(f"土曜の係数(対数の回帰):{sat:.3f} → 月曜の {np.exp(sat):.2f} 倍")
以下、実行結果です。
土曜の係数(対数の回帰):0.278 → 月曜の 1.32 倍
土曜の係数0.278は、月曜の1.32倍という意味です。仕込んだ正解の1.30倍をよく再現しています。
③ 曜日パターンが途中で変わっていないか
ダミー変数の回帰は「曜日効果は全期間で一定」と仮定しています。営業時間の変更や、通販チャネルの追加などで曜日パターンが変わったら、期間を分けて推定するか、季節性が変化するモデルを検討します。
④ 残差の自己相関を確認する
前の節で見たとおりです。回帰を実行したら、残差の時系列プロットとACFを見る習慣をつけましょう。
なお、実際のデータには月ごとの季節性(年末が多い、2月が少ない、など)も入っています。その場合は y ~ C(dow) + holiday + t + C(month) のように、月のダミー変数も同時に入れます。
よくある質問
Q. 基準を月曜以外にしたいときは?
C(dow, Treatment(5)) のように書くと、土曜(5)が基準になります。定数項は土曜の水準、ほかの係数は土曜との差になります。基準を変えても予測値は変わらず、係数の「読み方」だけが変わります。
Q. 「月曜との差」ではなく「全曜日の平均との差」で見たいときは?
C(dow, Sum) と書きます(Sumコーディング)。定数項が全曜日の平均、各係数がそこからの差になります。この読み方の違いは、関連記事のノック103で詳しく扱っています。
Q. 実データで曜日ごとの日数がそろっていなくても大丈夫?
回帰なら問題ありません。曜日ごとの日数が違っていても、トレンドや祝日を式に入れていれば、曜日効果はそれらを差し引いた形で推定されます。単純平均の比較は、日数の偏りの影響を受けます。
まとめ
今回のポイントです。
- 日次の時系列データは「トレンド・曜日の周期・祝日・ゆらぎ」でできている。曜日効果は周期7日の季節性を数字にしたもの
- 曜日別の平均は、祝日(月曜に多い)やトレンドの影響で歪む。今回のデータでは、月曜が約6人かさ上げされ、土曜との差が正解30人に対して25.4人に見えた
- 曜日ダミー変数の回帰は、
y ~ C(dow)で書ける。1つの曜日(基準カテゴリ)を外すのは、定数項との重複(ダミー変数の罠)を避けるため - 曜日だけの回帰は単純平均と同じ結果になる。祝日フラグとトレンドを足した
y ~ C(dow) + holiday + tで、曜日効果が正解に近づいた(土曜31.1人) - 推定した曜日効果を差し引けば曜日調整済みの時系列になり、祝日や特売日が浮かび上がる
- 時系列の回帰では、残差の自己相関を必ず確認する
発展:曜日効果の他の扱い方
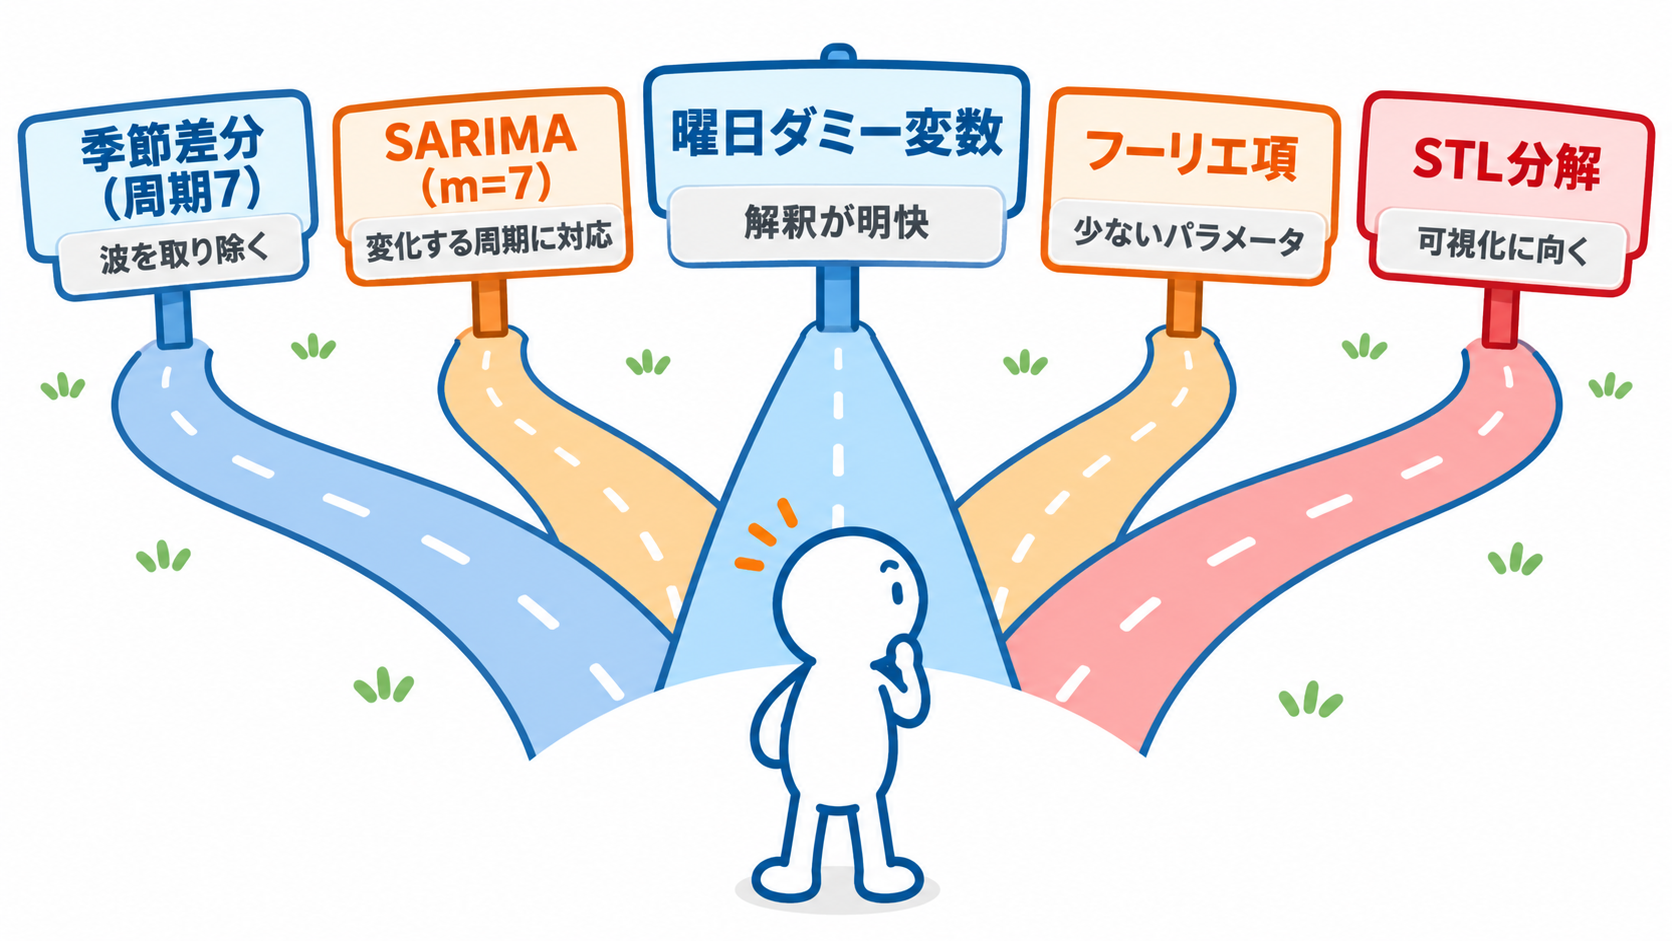
曜日効果は、ダミー変数の回帰以外にもいろいろな方法で扱えます。目的に応じて選びます。
| 方法 | 考え方 | 向いている場面 |
|---|---|---|
| 曜日ダミー変数(今回) | 曜日ごとに固定の水準差を推定する | 解釈が明快。祝日や施策など、他の説明変数と組み合わせたいとき |
| 季節差分(周期7) | 1週間前との差を取って曜日パターンを消す | 曜日効果を推定せず、取り除くだけでよいとき |
| SARIMA(m=7) | 周期7の季節ARMA構造でモデル化する | 曜日パターンが時間とともに変化するとき |
| フーリエ項 | sin・cosの組み合わせで周期を表す | 少ないパラメータで滑らかな周期を表したいとき |
| STL分解(period=7) | 季節成分として曜日パターンを分離する | 可視化や季節調整をしたいとき |
今回作った曜日ダミー変数は、SARIMAXの外生変数(exog)や、機械学習モデルの特徴量としてもそのまま使えます。
関連記事です。
Python 時系列分析 1,000本ノック – ノック103: 曜日効果のダミー変数 –(係数の読み方、基準カテゴリの変更、Sumコーディング)
