- 問題
- 答え
- 解説
Python コード:
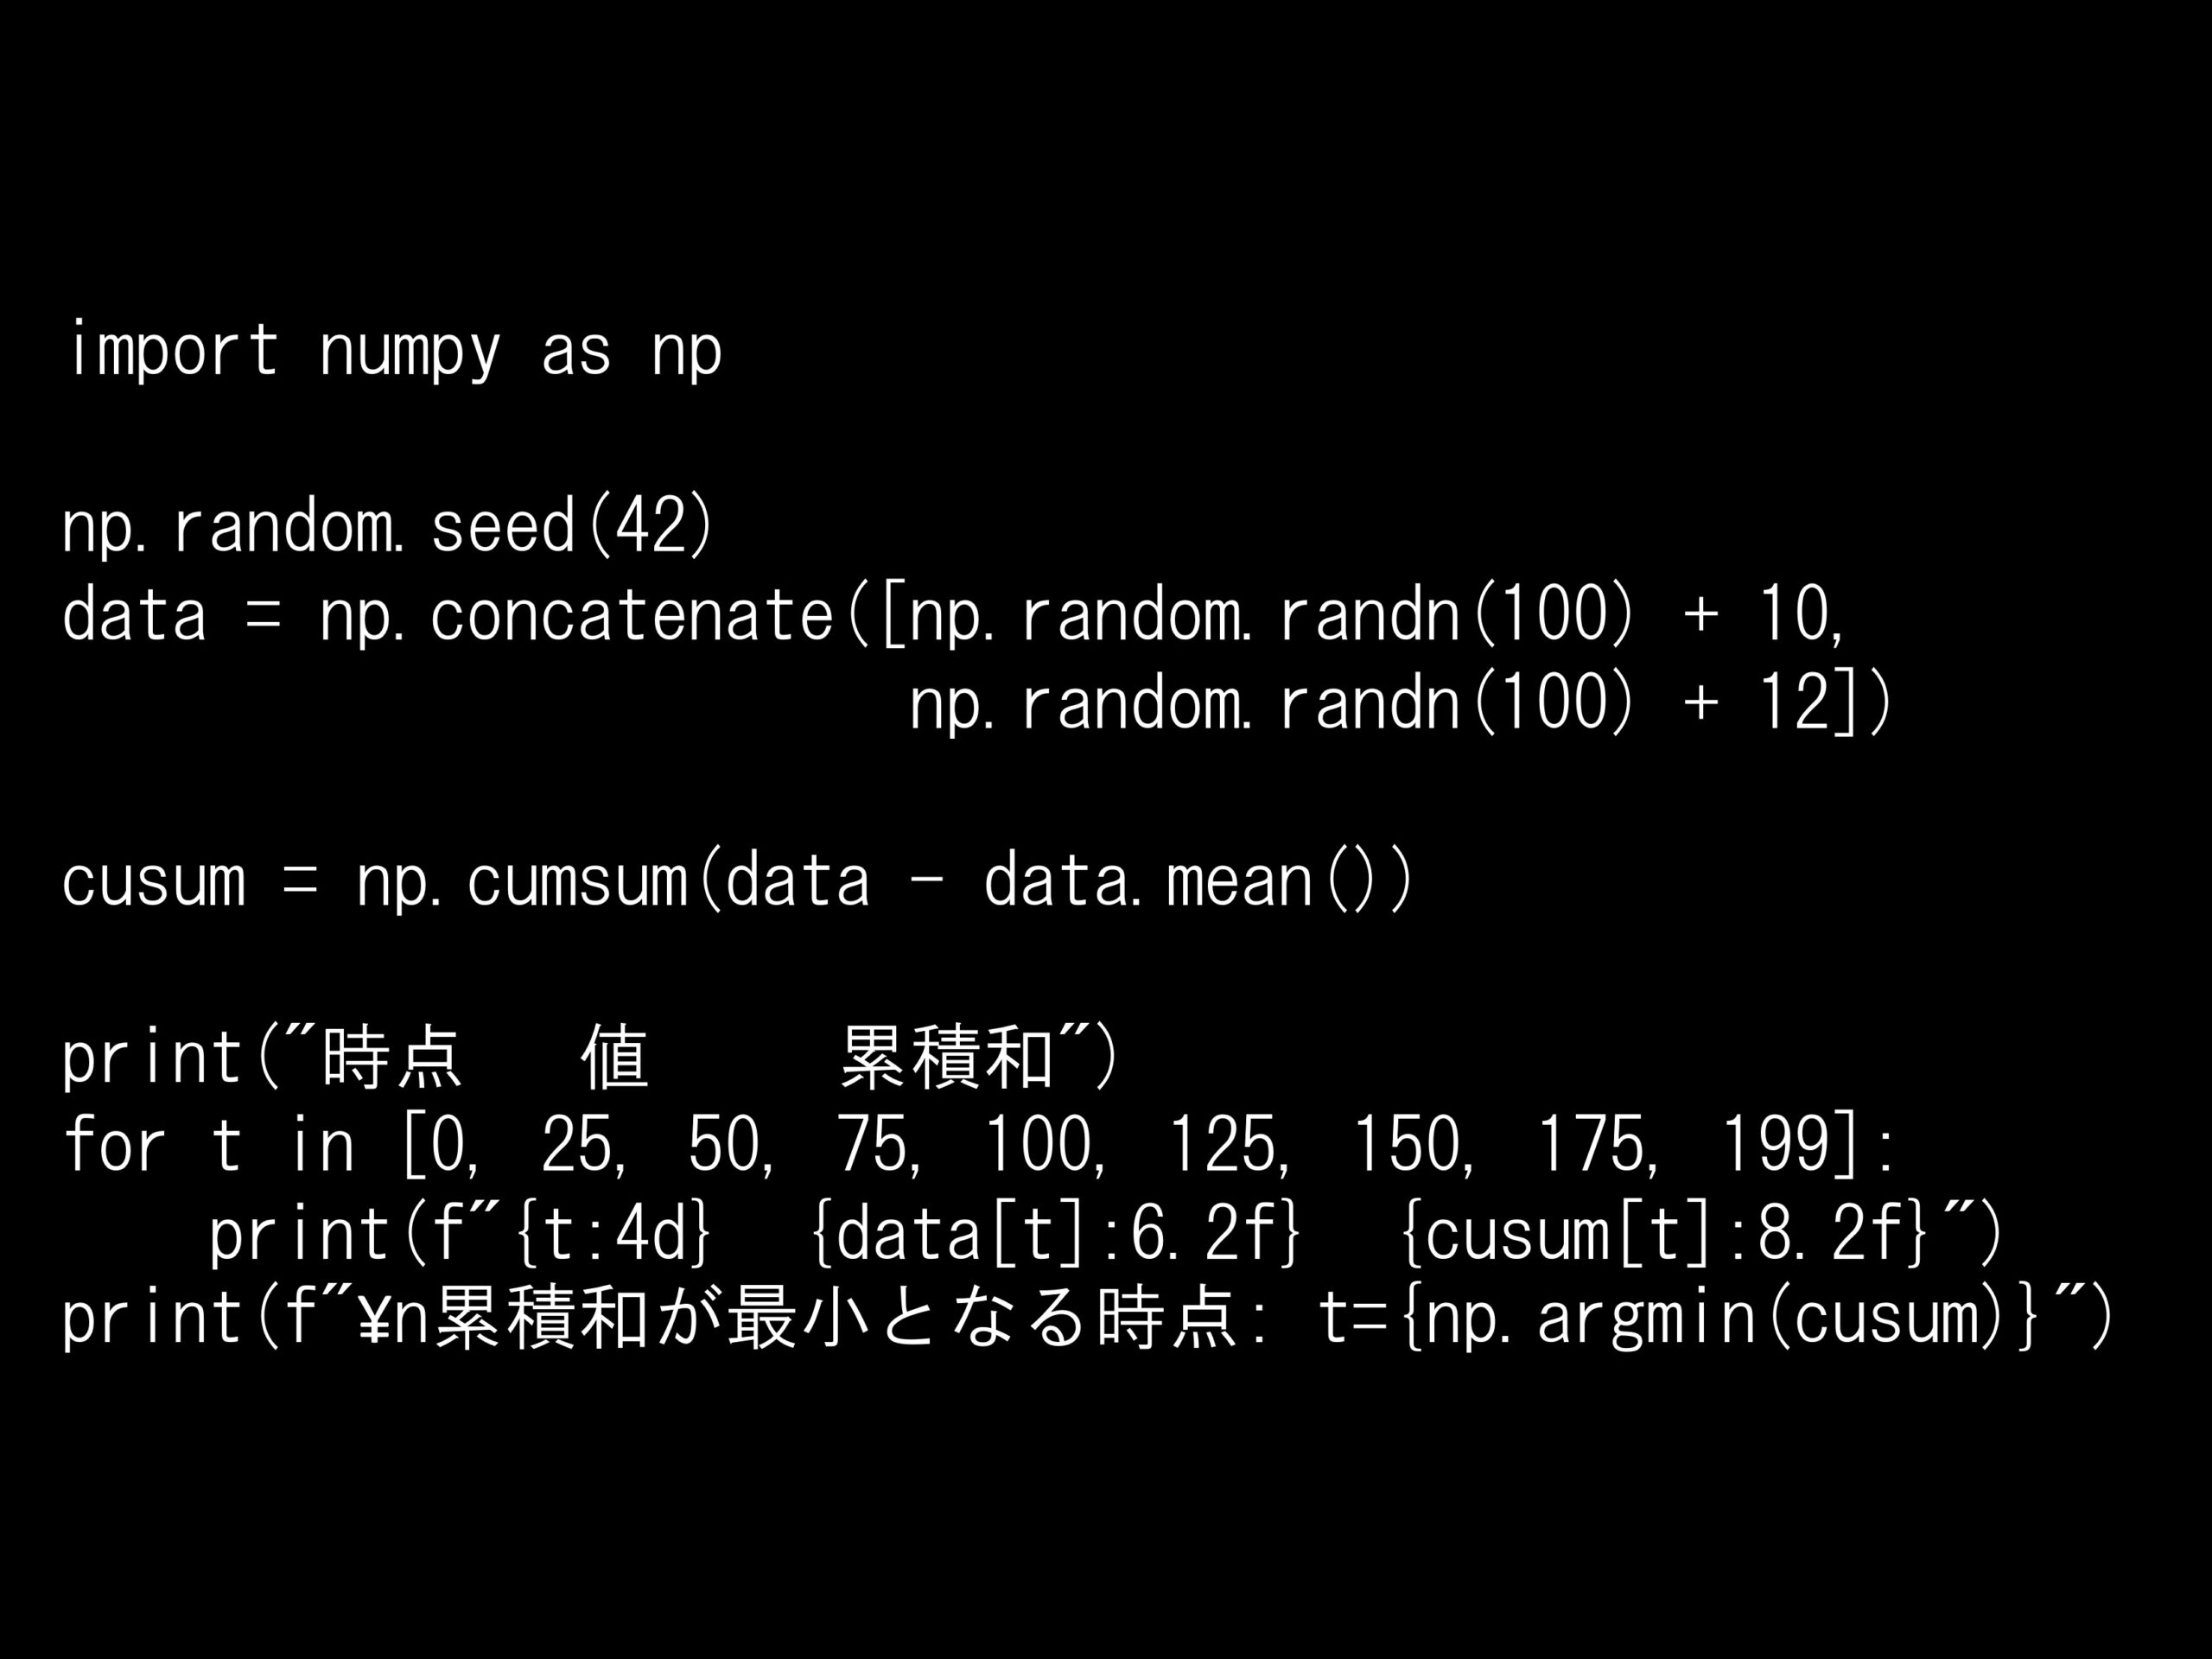
import numpy as np

np.random.seed(42)
data = np.concatenate([np.random.randn(100) + 10,
                       np.random.randn(100) + 12])

cusum = np.cumsum(data - data.mean())

print("時点   値     累積和")
for t in [0, 25, 50, 75, 100, 125, 150, 175, 199]:
    print(f"{t:4d}  {data[t]:6.2f}  {cusum[t]:8.2f}")
print(f"\n累積和が最小となる時点: t={np.argmin(cusum)}")
回答の選択肢:
(A) データの値そのものが時点100で最小になっている
(B) 時点100を境に、データの平均水準が切り替わっている
(C) 時点100でデータの分散が最も小さくなっている
(D) 時点100が季節周期の底にあたっている
時点   値     累積和
   0   10.50     -0.46
  25   10.11    -28.92
  50   10.32    -59.87
  75   10.82    -80.70
 100   10.58   -106.68
 125   14.19    -75.70
 150   12.25    -54.94
 175   12.83    -24.73
 199   10.86    -0.00

累積和が最小となる時点: t=100
正解: (B)
このコードはCUSUM(累積和)法による変化点検出です。各時点の値から全体平均を引いた偏差を累積していくと、平均より低い値が続く区間では累積和が減少し続け、平均より高い値が続く区間では増加し続けます。出力を見ると、累積和は時点0から100まで単調に減少し(データが全体平均11より低い10前後)、時点100で最小値-106.68を取ったあと、時点200に向かって単調に上昇しています(データが全体平均より高い12前後)。この「谷」の位置が、平均水準が切り替わった時点を示しています。実際、データはnp.concatenateで平均10の系列と平均12の系列をつないでおり、時点100が真の変化点です。
回答の選択肢:
(A) データの値そのものが時点100で最小になっている
(B) 時点100を境に、データの平均水準が切り替わっている
(C) 時点100でデータの分散が最も小さくなっている
(D) 時点100が季節周期の底にあたっている
- コードの解説
-
このコードは、平均水準が途中で変化するデータに対してCUSUMを計算し、変化点を特定しています。
import numpy as np

np.random.seed(42)
data = np.concatenate([np.random.randn(100) + 10,
                       np.random.randn(100) + 12])

cusum = np.cumsum(data - data.mean())

print("時点   値     累積和")
for t in [0, 25, 50, 75, 100, 125, 150, 175, 199]:
    print(f"{t:4d}  {data[t]:6.2f}  {cusum[t]:8.2f}")
print(f"\n累積和が最小となる時点: t={np.argmin(cusum)}")
詳しく説明します。
ライブラリのインポート
numpy:数値計算を行うためのライブラリ。ここでは乱数生成、累積和の計算、最小値の位置の特定に使用しています。
データの生成
np.random.randn(100) + 10:平均10、標準偏差1の系列100点です。np.random.randn(100) + 12:平均12、標準偏差1の系列100点です。np.concatenate:2つをつなぎ、時点100で平均が10から12へ切り替わるデータを作成しています。変動の大きさ(標準偏差1)に対して平均のシフト(2)は2倍程度で、個々の値を見ただけでは変化に気づきにくい設定です。
CUSUMの計算
data - data.mean():各時点の値から全体平均(約11)を引き、偏差を求めます。np.cumsum(...):偏差を先頭から順に足し合わせ、累積和を計算します。- 偏差の合計は定義上ゼロになるため、累積和は最終時点で必ず0に戻ります。出力の最終行が-0.00になっているのはそのためです。
変化点の特定
np.argmin(cusum):累積和が最小となるインデックスを返します。今回は時点100で、真の変化点と一致しています。
- 選択肢の解説
-
(A) データの値そのものが時点100で最小になっている → ×
出力を見ると、時点100の値は10.58であり、他の時点(時点25の10.11など)より小さいわけではありません。最小になっているのは値ではなく累積和です。(B) 時点100を境に、データの平均水準が切り替わっている → ○
正解です。累積和が減少から増加に転じる点は、データが「全体平均より低い状態」から「全体平均より高い状態」へ切り替わった時点を示します。これが平均水準のシフト、すなわち変化点です。(C) 時点100でデータの分散が最も小さくなっている → ×
CUSUMは平均からの偏差を累積するもので、分散の変化を捉える手法ではありません。今回のデータは全期間で標準偏差1に固定されており、分散は変化していません。(D) 時点100が季節周期の底にあたっている → ×
今回のデータに季節成分は含まれていません。また、季節性であれば累積和は周期的に上下を繰り返すはずですが、出力は一度だけ谷を作るV字型であり、周期性は見られません。 - CUSUMの仕組み
-
CUSUM(Cumulative Sum: 累積和)は、基準値からの偏差を積み上げていくことで、小さな変化を蓄積して顕在化させる手法です。
時点tまでの累積和は次のように定義されます。
$$
S_t = \sum_{i=1}^{t} (x_i – \mu)
$$ここで\muは基準となる平均です。今回のコードでは全体平均を使っています。
累積和の動きの読み方
- データが基準より高い状態が続く → 偏差が正 → 累積和が上昇
- データが基準より低い状態が続く → 偏差が負 → 累積和が下降
- データが基準と同じ水準で変動 → 偏差が正負に散らばる → 累積和は横ばい
累積和の「傾きが変わる点」が、データの水準が変わった点に対応します。なぜ小さな変化を検出できるのか
今回のデータでは、平均のシフト(2)はノイズの標準偏差(1)の2倍程度です。個々の値を見ると、変化前でも12前後の値は出ますし、変化後でも10前後の値は出るため、1点ずつ見ても変化は判別できません。しかしCUSUMでは、偏差を累積するため、たとえ1点あたりの偏差が小さくても、同じ方向の偏差が続けば累積和は着実に動きます。ノイズは正負に散らばるため累積しても相殺されますが、系統的なシフトは相殺されずに蓄積されます。この「ノイズは相殺され、シフトは蓄積される」性質が、CUSUMの検出力の源です。
- V字型と∧字型
-
全体平均を基準にしたCUSUMでは、累積和の形状が変化の方向を教えてくれます。
V字型(谷):平均が上方にシフト
前半が全体平均より低く、後半が高い場合、累積和は下降してから上昇します。今回の出力がこの形です。谷の位置が変化点です。∧字型(山):平均が下方にシフト
前半が全体平均より高く、後半が低い場合、累積和は上昇してから下降します。山の位置が変化点です。複数回の変化
平均が何度も変わる場合、累積和はジグザグの形になり、傾きが変わる点がそれぞれ変化点の候補になります。ただし、変化が複数あると全体平均が個々の区間の平均から離れるため、単純な最小値・最大値の位置では検出できないことがあります。この場合は、検出した変化点でデータを分割し、各区間で再帰的にCUSUMを適用する二分割法が使われます。変化点の位置を確認する
np.argminやnp.argmaxで極値の位置を取得すれば、変化点の候補が得られます。ただし、これが本当に有意な変化なのか、ノイズによる偶然のずれなのかは、別途判定が必要です。ブートストラップ法で「変化がない場合の累積和の変動幅」を推定し、観測された振幅がそれを超えているかで判定するのが一般的です。 - 逐次検定としてのCUSUM
-
今回のコードは、全データが揃った後に変化点を探す「事後分析」です。一方、CUSUMのもう1つの重要な用途は、データが1点ずつ到着するたびに変化を監視する逐次検定(オンライン検出)です。
Page-Hinkley法・片側CUSUM
リアルタイム監視では、全体平均は使えません(将来のデータがまだないため)。代わりに、正常時の平均\mu_0を基準とし、次のように累積和を更新します。$$
S_t = \max\left(0, \, S_{t-1} + (x_t – \mu_0 – k)\right)
$$ここでkは許容幅(小さな変動を無視するための閾値)です。累積和が負になったら0にリセットすることで、変化がない限りは0付近にとどまり、上方シフトが起きると急速に増加します。累積和があらかじめ決めた閾値hを超えた時点で「変化あり」と判定します。
管理図としての位置づけ
この逐次型CUSUMは、統計的品質管理におけるCUSUM管理図として広く使われています。製造ラインで製品の寸法を監視し、工程の平均がずれ始めたことをいち早く検出するといった用途です。従来のシューハート管理図(各点が管理限界を超えたかを個別に判定)は大きな変化には敏感ですが、小さな持続的シフトには鈍感です。CUSUM管理図は小さなシフトを蓄積して検出できるため、両者は補完的に使われます。
閾値の設計
kとhの設定にはトレードオフがあります。閾値を低くすると検出が速くなりますが誤報が増え、高くすると誤報は減りますが検出が遅れます。正常時に誤報が出るまでの平均時間(ARL: Average Run Length)を指標として設計するのが標準的です。 - 実務での注意点
-
基準平均の選び方
事後分析で全体平均を使う方法は、変化が1回だけの場合に有効です。変化が複数回ある場合や、変化点がデータの端に近い場合は、全体平均が適切な基準にならないことがあります。用途に応じて、変化前の期間の平均を基準にするなどの工夫が必要です。トレンドがある場合
データに上昇トレンドがあると、CUSUMは変化点がなくても放物線状に動きます。CUSUMは「平均のシフト」を検出する手法であり、トレンドとは相性が悪いため、事前にトレンド除去を行うか、差分系列に適用することを検討します。他の変化点検出手法との比較
手法 検出対象 特徴 CUSUM 平均のシフト 実装が簡単、逐次検定が可能 Prophetの変化点 トレンドの傾きの変化 季節性と同時にモデル化 Bayesian Online Changepoint Detection 分布の変化全般 確率的な判定が可能 ruptures ライブラリ 平均・分散・分布の変化 複数変化点を最適化で探索 CUSUMは最もシンプルな手法ですが、その分だけ仮定が明確で、結果の解釈もしやすいという利点があります。まずCUSUMで大まかな変化点を把握し、必要に応じてより高度な手法に進むという使い方が実務的です。
