- 問題
- 答え
- 解説
het_arch は、系列Aと系列Bの何を調べていますか?
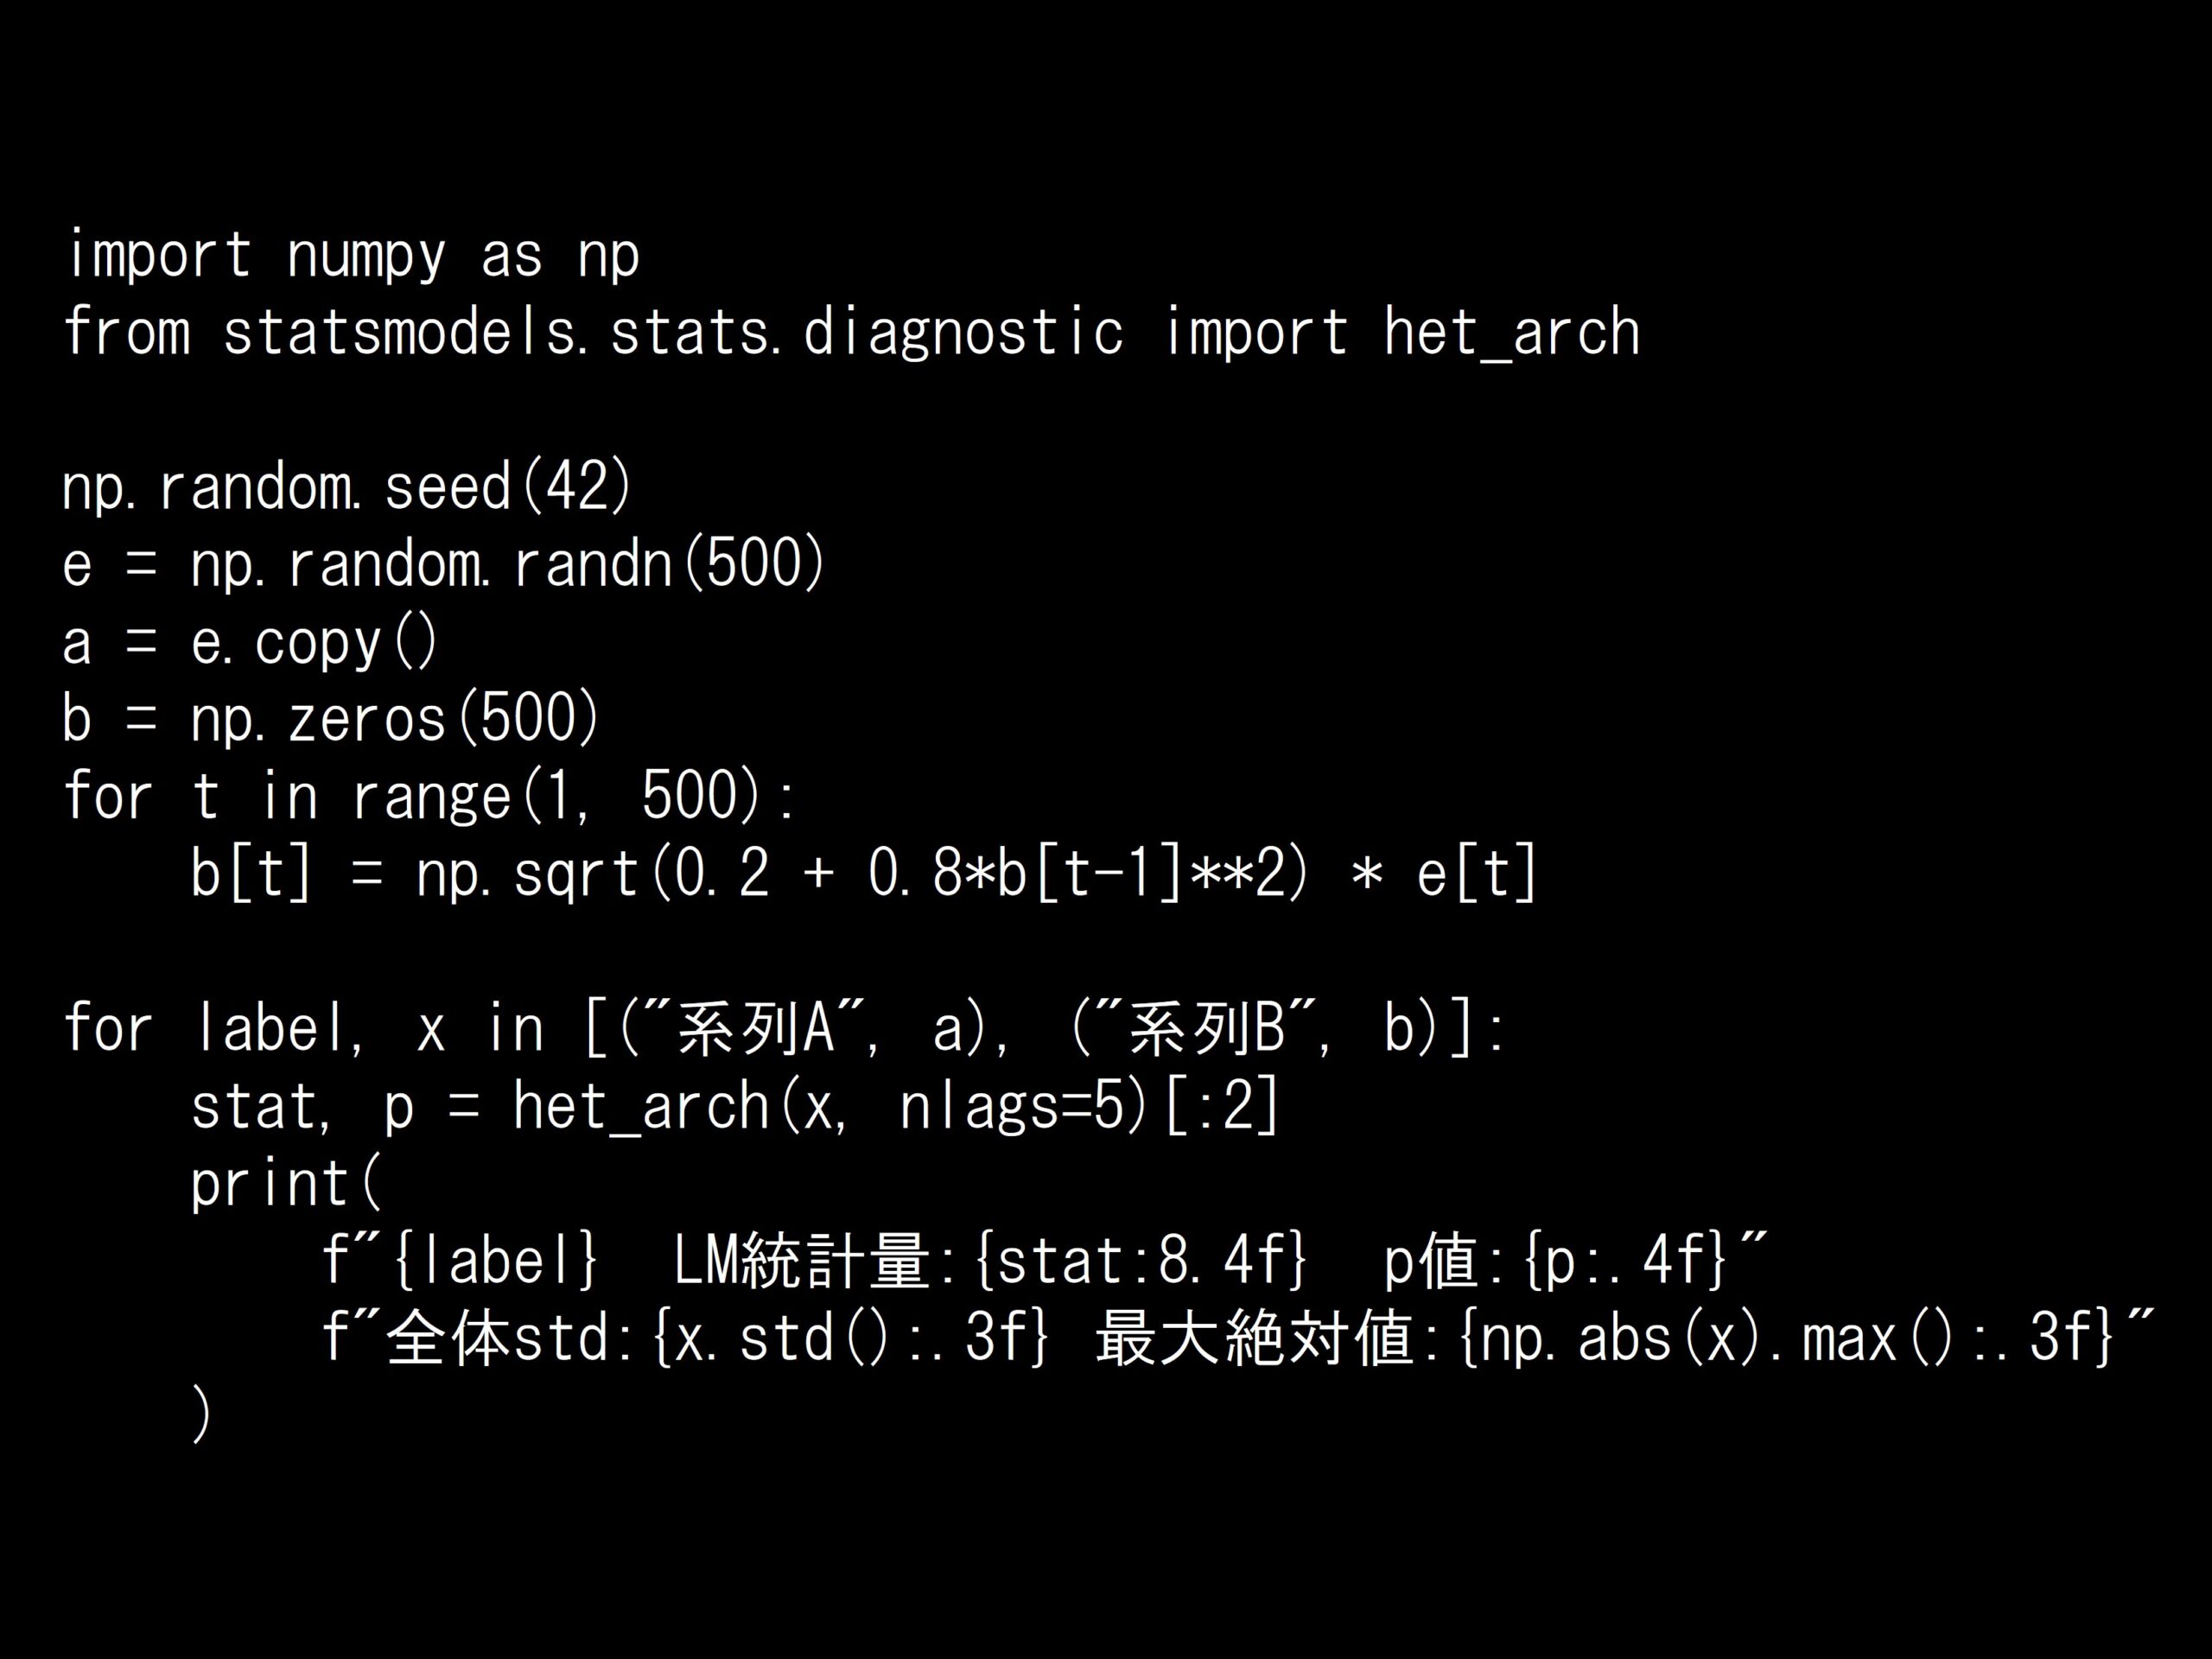
Python コード:
import numpy as np
from statsmodels.stats.diagnostic import het_arch

np.random.seed(42)
e = np.random.randn(500)
a = e.copy()
b = np.zeros(500)
for t in range(1, 500):
    b[t] = np.sqrt(0.2 + 0.8*b[t-1]**2) * e[t]

for label, x in [("系列A", a), ("系列B", b)]:
    stat, p = het_arch(x, nlags=5)[:2]
    print(f"{label}  LM統計量:{stat:8.4f}  p値:{p:.4f}"
          f"  全体std:{x.std():.3f}  最大絶対値:{np.abs(x).max():.3f}")
回答の選択肢:
(A) 系列の平均が時間とともに変化しているかどうか
(B) 系列の分散が過去の値の大きさに依存して変動しているかどうか
(C) 系列に自己相関が残っているかどうか
(D) 系列が正規分布に従っているかどうか
系列A  LM統計量:  1.6146  p値:0.8995  全体std:0.980  最大絶対値:3.853
系列B  LM統計量: 53.3028  p値:0.0000  全体std:0.731  最大絶対値:4.026
正解: (B)
het_archはARCH効果(分散の不均一性)を検定する関数で、帰無仮説は「ARCH効果がない(分散が一定である)」です。系列Aは分散一定のホワイトノイズであり、p値0.8995で帰無仮説を棄却できません。一方、系列Bはb[t] = np.sqrt(0.2 + 0.8*b[t-1]**2) * e[t]という式で生成されており、直前の値が大きいほど次の分散が大きくなる構造を持ちます。p値0.0000で帰無仮説が棄却され、ARCH効果が検出されました。全体の標準偏差は両者とも1前後で大差ないにもかかわらず検定結果が正反対になる点が、この検定が「全体のばらつき」ではなく「ばらつきの時間変動」を見ていることを示しています。
回答の選択肢:
(A) 系列の平均が時間とともに変化しているかどうか
(B) 系列の分散が過去の値の大きさに依存して変動しているかどうか
(C) 系列に自己相関が残っているかどうか
(D) 系列が正規分布に従っているかどうか
- コードの解説
-
このコードは、分散の性質が異なる2つの系列に対してARCH検定を適用し、結果を比較しています。
import numpy as np
from statsmodels.stats.diagnostic import het_arch

np.random.seed(42)
e = np.random.randn(500)
a = e.copy()
b = np.zeros(500)
for t in range(1, 500):
    b[t] = np.sqrt(0.2 + 0.8*b[t-1]**2) * e[t]

for label, x in [("系列A", a), ("系列B", b)]:
    stat, p = het_arch(x, nlags=5)[:2]
    print(f"{label}  LM統計量:{stat:8.4f}  p値:{p:.4f}"
          f"  全体std:{x.std():.3f}  最大絶対値:{np.abs(x).max():.3f}")
詳しく説明します。
ライブラリのインポート
numpy:数値計算を行うためのライブラリ。ここでは乱数生成と系列の生成に使用しています。statsmodels.stats.diagnostic.het_arch:ARCH効果の有無をLM検定(ラグランジュ乗数検定)で判定する関数です。
2つの系列の生成
a = e.copy():系列A。標準正規分布から生成した単純なホワイトノイズで、分散は時間を通じて一定です。b[t] = np.sqrt(0.2 + 0.8*b[t-1]**2) * e[t]:系列B。ARCH(1)過程です。直前の値b[t-1]の二乗が大きいほど、次の時点の標準偏差が大きくなります。- 両系列とも同じ乱数
eを使っているため、差は分散構造のみです。
ARCH検定の実行
het_arch(x, nlags=5):ラグ5までのARCH効果を検定します。戻り値の先頭2つがLM統計量とそのp値です。nlags=5:分散の依存関係を何期前まで見るかを指定します。- p値が0.05未満なら帰無仮説(ARCH効果なし)が棄却され、分散の不均一性があると判断します。
補助的な出力
x.std():系列全体の標準偏差です。両系列とも1前後で大きな差はありません。np.abs(x).max():絶対値の最大値です。こちらも両系列で近い値になっています。- これら「全体のばらつき」を見る指標では両系列の違いが見えないことが、ARCH検定の役割を際立たせています。
- 選択肢の解説
-
(A) 系列の平均が時間とともに変化しているかどうか → ×
平均の変化(トレンドや構造変化)を扱うのは、ADF検定・KPSS検定などの定常性検定や変化点検出の手法です。ARCH検定は平均ではなく分散の構造を対象としています。(B) 系列の分散が過去の値の大きさに依存して変動しているかどうか → ○
正解です。ARCH検定は、二乗残差が過去の二乗残差に依存しているかを回帰によって調べます。依存が有意であれば、分散が時間とともに変動する(分散の不均一性がある)と判断されます。(C) 系列に自己相関が残っているかどうか → ×
系列そのものの自己相関を検定するのはLjung-Box検定です。ARCH検定は「値」ではなく「二乗値」の自己相関を見ています。実際、ARCH過程は値自体には自己相関がなくても、二乗値には自己相関を持つという特徴があります。(D) 系列が正規分布に従っているかどうか → ×
正規性の検定にはJarque-Bera検定やShapiro-Wilk検定を使います。ARCH検定は分布形状ではなく分散の時間依存構造を対象としています。 - ボラティリティクラスタリングとは
-
ARCH効果が意味するのは、ボラティリティクラスタリングと呼ばれる現象です。これは「大きな変動の後には大きな変動が、小さな変動の後には小さな変動が続きやすい」という性質を指します。
金融時系列で典型的に観察される現象で、株価のリターン系列を例に取ると次のようになります。
- 市場が混乱している時期は、日々の値動きが激しい状態が数日〜数週間続く。
- 平穏な時期は、小さな値動きが継続する。
- 変動の「大きさ」には持続性があるが、変動の「方向」には持続性がない。
最後の点が重要です。リターンそのもの(上昇か下落か)は予測しにくくても、変動の大きさ(ボラティリティ)にはある程度の予測可能性があります。これがARCH/GARCHモデルの出発点です。
今回の系列Bを生成した式を見ると、この構造が明確です。
$$
\sigma_t^2 = 0.2 + 0.8 \, b_{t-1}^2
$$直前の値が大きく振れた(b_{t-1}^2が大きい)ほど、次の時点の分散\sigma_t^2が大きくなります。この連鎖により、大きな変動が塊(クラスター)となって現れます。
- ARCH検定の仕組み
-
ARCH検定(Engleの検定)は、以下の手順で実行されます。
ステップ1:二乗残差の計算
検定対象の系列(多くの場合はモデルの残差)を二乗します。二乗することで、変動の「大きさ」だけを取り出し、符号の情報を除きます。ステップ2:補助回帰
二乗残差\varepsilon_t^2を、その過去の値に回帰します。$$
\varepsilon_t^2 = \alpha_0 + \alpha_1 \varepsilon_{t-1}^2 + \alpha_2 \varepsilon_{t-2}^2 + \cdots + \alpha_q \varepsilon_{t-q}^2 + u_t
$$ステップ3:LM統計量の算出
帰無仮説は「\alpha_1 = \alpha_2 = \cdots = \alpha_q = 0(過去の二乗残差は現在の分散を説明しない)」です。補助回帰の決定係数R^2とサンプルサイズnから、LM統計量を計算します。$$
LM = n R^2
$$この統計量は帰無仮説のもとで自由度qのカイ二乗分布に従います。値が大きい(p値が小さい)ほど、二乗残差に自己相関がある=ARCH効果があると判断されます。
- Ljung-Box検定との役割分担
-
時系列モデルの残差診断では、ARCH検定とLjung-Box検定が補完的な役割を果たします。
Ljung-Box検定 ARCH検定 対象 残差そのもの 残差の二乗 診断する構造 平均構造(自己相関) 分散構造(不均一性) 帰無仮説 自己相関がない ARCH効果がない 棄却された場合 ARIMAの次数を見直す GARCHモデルの導入を検討 ARIMAモデルの残差がLjung-Box検定をパスしていても、ARCH検定で有意になることは珍しくありません。これは「平均の予測は適切だが、予測の不確実性が時期によって変動している」状態を意味します。
この場合、点予測そのものは大きく改善しませんが、予測区間の精度に問題が生じます。分散一定を仮定したモデルでは、変動が激しい時期に予測区間が狭すぎ、平穏な時期に広すぎるという状態になるためです。
- ARCH効果が検出された後の対応
-
ARCH検定で有意な結果が得られた場合、以下のような対応が考えられます。
ARCH/GARCHモデルの導入
分散の変動を明示的にモデル化する手法です。ARCHモデルは過去の二乗残差のみで分散を説明しますが、GARCHモデルは過去の分散も説明変数に加えることで、より少ないパラメータで長期の依存を表現できます。$$
\text{GARCH(1,1)}: \quad \sigma_t^2 = \omega + \alpha \varepsilon_{t-1}^2 + \beta \sigma_{t-1}^2
$$Pythonでは
archライブラリのarch_modelで推定できます。分散安定化変換
対数変換やボックス=コックス変換により、分散の変動を緩和できる場合があります。ただし、ボラティリティクラスタリングのような動的な分散変動には、変換だけでは対応しきれないことが多いです。予測区間の扱いに注意する
GARCHまで導入せずに済ませる場合でも、点予測の信頼性が時期によって異なることを認識しておく必要があります。特にリスク管理の文脈では、分散の変動を無視すると危険な判断につながります。なお、ARCH効果は金融時系列に特有というわけではありません。需要データやセンサーデータなど、外部環境の影響を受けやすい系列でも観察されることがあります。残差診断の一環として、Ljung-Box検定と併せてARCH検定も実施する習慣をつけておくとよいでしょう。