予測モデルの精度が、伸びなくなることがあります。
アルゴリズムを変える。パラメータを調整する。特徴量を追加する。
やれることをやり尽くして、それでも数字が動かない。そんなとき、見落とされがちな場所があります。
欠損値の扱いです。
今回は、あるサブスクリプション型サービスで起きた「モデルには一切触らず、欠損の扱いを変えただけで精度が動いた」という出来事を通して、前処理が結果に与える力の大きさを説明します。
出発点――2週間のチューニングで、数字が動かない
解約を予測したい
月額制のサービスを運営するK社では、解約しそうな顧客を事前に見つけて引き止める取り組みを始めました。
- 利用頻度
- 契約期間
- 問い合わせ回数
- アンケートの満足度
- 利用しているプラン
顧客ごとのこうしたデータから、解約の可能性を予測するモデルを作ります。
最初にできたモデルの精度は、まずまずでした。
ただ、現場が納得して使うには、もう一歩足りません。
モデルをいじり続けた2週間
担当者は、モデルの改善に取り組みました。
アルゴリズムを3種類試し、パラメータを何十通りも変え、特徴量の組み合わせを変える。
2週間かけて、精度は小数点以下でしか動きませんでした。
「このデータでは、ここが限界かもしれない」
そんな空気が漂い始めます。
転機――欠損値の扱いを見直す
欠損のある顧客を「除外」していた
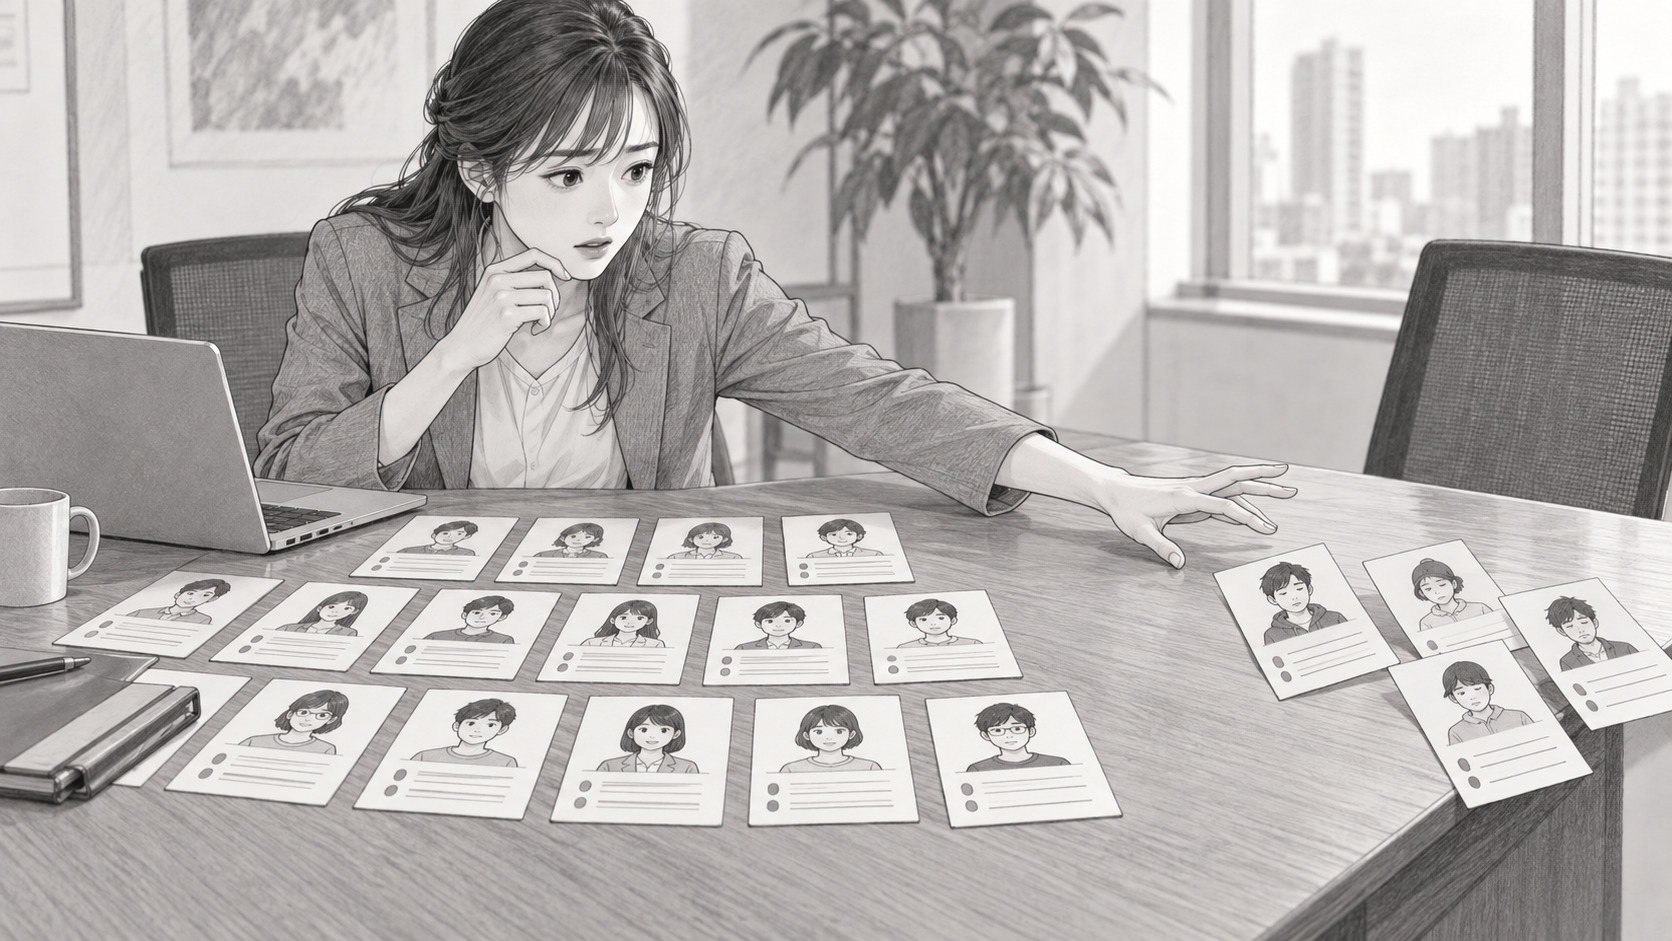
ここで担当者は、モデルではなくデータのほうに目を戻しました。
顧客データには、あちこちに欠損がありました。アンケートの満足度は未回答が多く、問い合わせ回数は、問い合わせのない顧客が空欄。
最初のモデルでは、欠損のある顧客を学習データから除外していました。その結果、学習に使えたのは全顧客の7割。
しかも、除外された3割には、アンケートに答えない顧客――つまり、サービスへの関心が薄い顧客が偏って含まれていました。
解約しやすい顧客ほど、学習データから消えていたのです。
3通りの扱いで、同じモデルを動かした
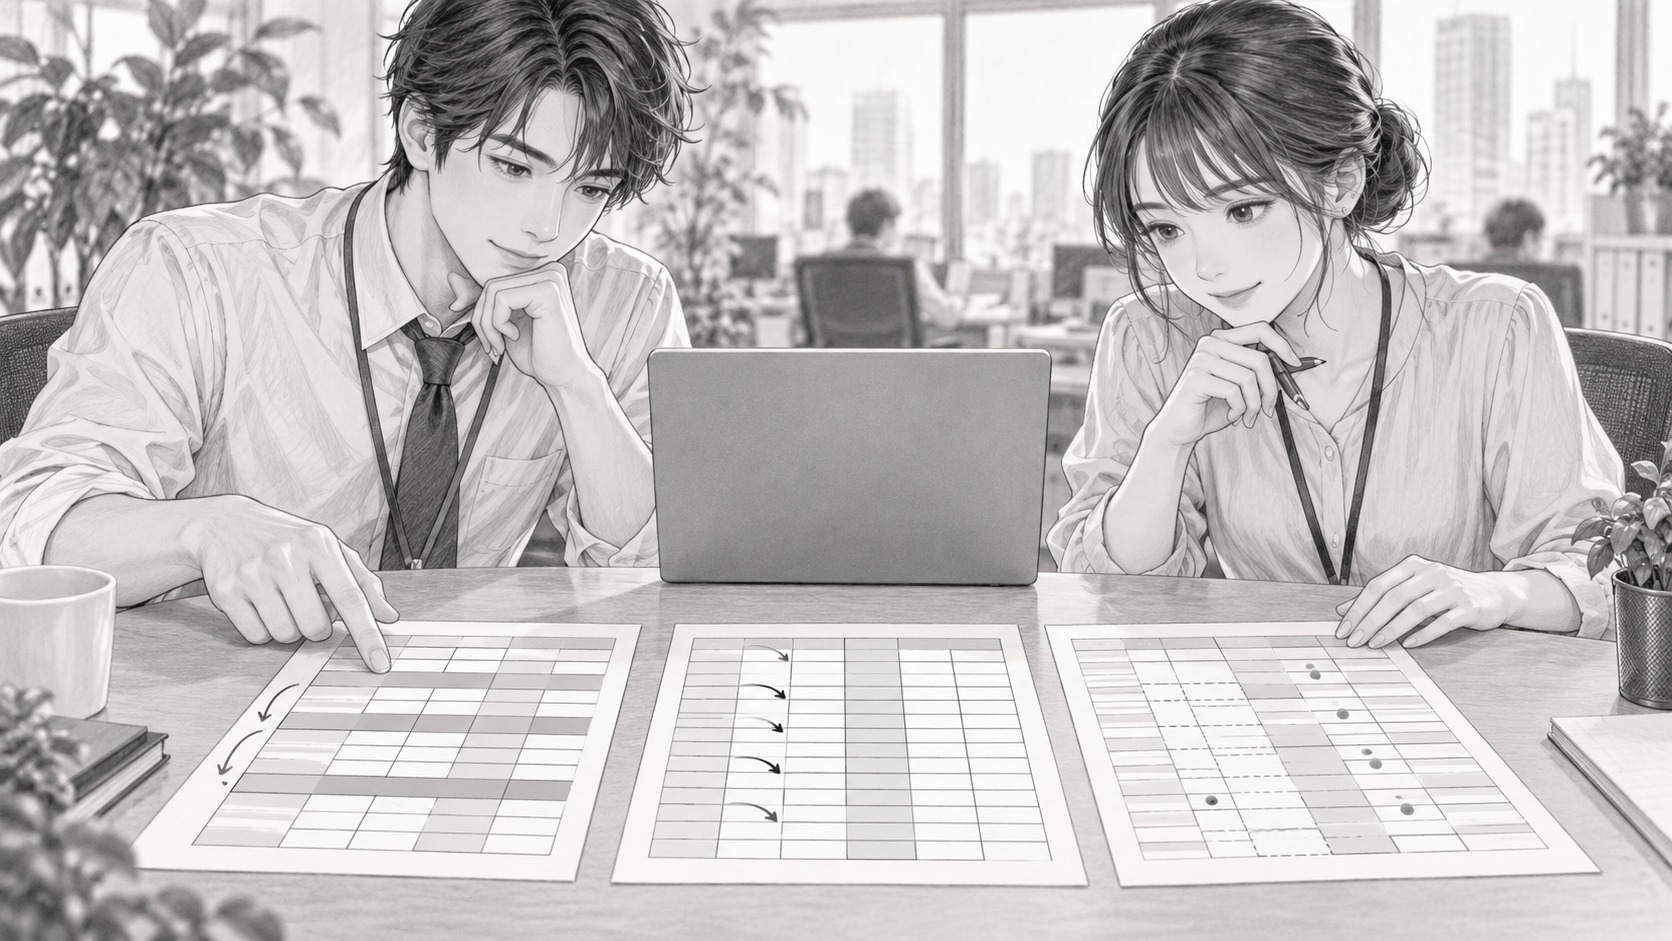
担当者は、モデルもパラメータも一切変えずに、欠損の扱いだけを3通り試しました。
- 1つ目は、これまで通り、欠損のある顧客を除外する
- 2つ目は、欠損を平均値で埋めて、全顧客を使う
- 3つ目は、欠損を他の情報から推定して埋めたうえで、「欠損があった」という印を1列残す
結果は、はっきり出ました。
精度を表す指標は、1つ目で0.74。2つ目で0.76。3つ目で0.79。
2週間のチューニングで動かなかった数字が、前処理を変えただけで動きました。
理屈――欠損処理は「モデルに何を見せるか」を決めている
除外は材料を減らし、平均は材料を歪める
モデルは、渡されたデータからしか学べません。
欠損の扱いは、どんな材料をモデルに渡すかを決める工程です。
- 除外は、材料を減らします。しかも偏って減らします。K社では、解約しやすい顧客が材料から消えていました。
- 平均で埋めるのは、材料を歪めます。答えなかった人を「平均的な人」として渡すため、本来の違いが薄まります。
- 他の情報から推定して埋め、欠損の印を残すのは、材料を活かします。
「答えなかった」という事実まで、モデルに渡しているからです。
モデルの良し悪し以前の話
アルゴリズムやパラメータの調整は、渡された材料をどう料理するかの工夫です。
材料が減っていたり歪んでいたりすれば、料理の腕でできることには限りがあります。
K社の2週間は、材料の問題を料理で解決しようとしていた時間でした。
精度が伸びないとき、疑う順番は逆です。まず材料。次に料理。
今回のまとめ
モデルを一切変えなくても、欠損の扱いを変えるだけで精度は動きます。
除外は材料を減らし、平均で埋めるのは材料を歪め、推定して埋めて欠損の印を残すのは材料を活かす。
欠損処理とは、モデルに何を見せるかを決める工程です。
精度が伸びないとき、最初に疑うのはアルゴリズムではなく、前処理です。
報告を受ける側が確認すべきことは1つです。
「欠損の扱いを変えて、結果を比べましたか」
モデルを固定して前処理だけを変えた比較があれば、その報告は土台から検証されています。
なければ、まだ伸びしろが残っているかもしれません。
よくある質問
Q. 予測モデルの精度が伸びないとき、何を確認すればよいですか?
アルゴリズムやパラメータより先に、欠損値の扱いを確認してください。
欠損のある行を除外していないか、平均値で埋めていないか。
モデルを固定したまま、欠損の扱いだけを変えて結果を比べると、前処理の影響がはっきり分かります。
Q. 欠損値の扱いで、予測精度はどれくらい変わりますか?
データ次第ですが、モデルのチューニングで得られる改善を上回ることは珍しくありません。
本文の例では、同じモデル・同じパラメータのまま、除外から「推定して埋める+欠損の印」に変えただけで、精度の指標が0.74から0.79に動きました。
特に、欠損が偏って起きている場合ほど、影響は大きくなります。
Q. 欠損値のある行を削除するのは、なぜ問題なのですか?
学習に使えるデータが減るだけでなく、偏って減るからです。
アンケートに答えない顧客を除外すると、関心の薄い顧客――解約しやすい顧客――が学習データから消えます。
モデルは、消えた顧客のパターンを学べません。
Q. 「欠損の印を残す」とは何ですか?
ある項目が空いていたかどうかを表す列を、1つ追加することです。空いていれば1、入っていれば0。
埋めた値だけでなく「もともと空いていた」という事実もモデルに渡せるため、欠損そのものが解約の兆しである場合に効きます。
欠損を埋める前に作っておくのがポイントです。
