前回の記事では、instructions に毎回守ってほしいルールを、input に今回の質問とデータを分けて書く方法を確認しました。
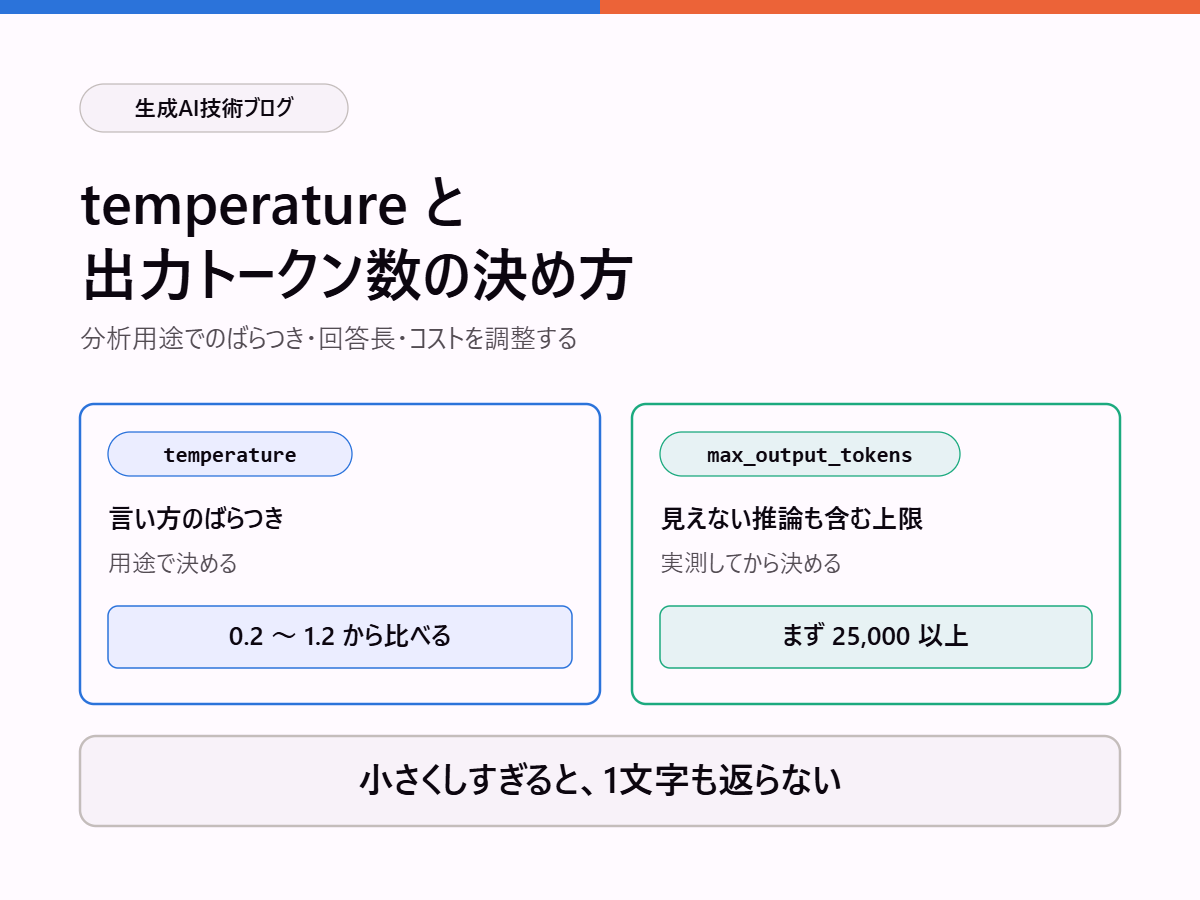
次に気になるのが、設定値です。OpenAIのResponses APIには temperature と max_output_tokens という2つのつまみがあります。
名前だけ見ると難しそうですが、役割は単純です。
temperature— 回答のばらつきをどのくらい許すかmax_output_tokens— 1回の回答で使えるトークン数の上限
分析用途で欲しいのは、文章の面白さではありません。数値が変わらないこと、同じ条件なら似た傾向の文章になること、必要な情報が途中で切れないこと、そして使用量が管理できることです。
この記事では、売上分析コメントを例に、どの値から試せばよいかと、決めたあとどう確かめるかまでを扱います。
先に、いちばん間違えやすいところを1つ。
「短い回答が欲しいからmax_output_tokensを小さくする」は危険です。現在の推論モデルでは、上限を小さくしすぎると1文字も返ってきません。
理由は記事の中ほどで説明します。
この記事を読み終えると、次のことができるようになります。
temperatureが何を調整する値か説明できる- 分析用途でどの帯から試せばよいか分かる
max_output_tokensが「文字数」ではないことを理解できる- 上限を小さくしすぎると何が起きるかを、具体的な数字で説明できる
- 回答が途中で切れたことを、コードで検知できる
- 見えない推論トークンが何個使われたかを実測できる
- 設定値を勘ではなく、比較して決められる

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
設定値の話は、用語が分からないだけで急に難しく感じます。この記事で使う言葉を先にまとめておきます。いま全部覚える必要はありません。本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| パラメーター | API呼び出しのときに渡す設定値。temperature や max_output_tokens のこと |
| トークン | モデルが文章を処理するときの単位。文字とは一致しません(後述) |
| トークナイズ | 文章をトークンに分ける処理。分け方はモデルによって違います |
| サンプリング | 次に来る語の候補から1つを選ぶこと。temperature はこの選び方を変えます |
| temperature | 選び方のばらつきを決める値。0〜2で指定します |
| top_p | temperature と並ぶ、もう1つのサンプリング設定。同時には使いません |
| max_output_tokens | 1回の回答で生成できるトークン数の上限 |
| 推論モデル | 答える前に内部で考えるモデル。gpt-5.6-luna もこれに当たります |
| 推論トークン | その「内部で考えた分」のトークン。画面には出ませんが、上限にも料金にも数えられます |
| 可視出力トークン | 実際に画面へ出る文章のトークン |
| reasoning.effort | 答える前にどれだけ考えるかを決める設定。temperature とは別の軸です |
| usage | レスポンスに付いてくる使用量の情報。入力・出力・推論のトークン数が分かります |
| incomplete | 回答が最後まで出せなかったことを表すステータス |
temperature:言い方のばらつきを決める
0に近いほど安定、高いほど多様
temperature は、生成する文章のばらつきに関係する設定です。公式のAPIリファレンスでは、0〜2の範囲で指定でき、0.2のような低い値はより集中的・決定的に、0.8のような高い値はよりランダムになると説明されています。
もう少し内部の話をすると、モデルは次に来る語の候補を確率つきで持っています。temperature は、その候補から1つを選ぶとき(サンプリング)に確率の高い候補をどれだけ優先するかを変えます。低いと上位の候補ばかり選び、高いと下位の候補も混ざります。
0にしても完全一致にはならない
ここは誤解しやすいところです。
temperatureを0にしたら、いつでも完全に同じ文章になる。
そうは考えないでください。低くするとばらつきは抑えやすくなりますが、モデルやバックエンドの更新、入力内容、ツールの利用などによって結果は変わりえます。
では何を見て評価するのか。前回の記事で作った機械的な検査がそのまま使えます。文章の完全一致ではなく、次の条件で判定します。
- 必要な項目が揃っている
- 入力になかった数値が混ざっていない
- 禁止している断定表現がない
- 指定した形式(3項目以内など)を守っている
「毎回同じ文章か」ではなく「毎回ルールを守っているか」で見る。これが実務での評価の仕方です。
分析用途はどの帯から試すか
たとえば、次の売上データを要約するとします。
売上合計:281,020円
最も売上が高い日:土曜日 51,590円
商品別売上1位:幕の内弁当 93,000円
欲しいのは派手なコピーではなく、次のような安定した要約です。
- 売上合計は281,020円でした。
- 最も売上が高い日は土曜日でした。
- 商品別では幕の内弁当が1位でした。
この用途なら、temperature=0.2 や temperature=0.3 あたりから比較を始めると分かりやすくなります。先ほどの図の帯も参考にしてください。
逆に、レポートの見出し案を10個出す、説明文を複数パターン作る、施策のアイデアを広げる──といった仕事では、temperature=0.8 のような高めの値を試す意味があります。
ただし、これらは公式が保証する推奨値ではありません。評価を始めるための出発点です。
top_p とは同時にいじらない
OpenAIのAPIには top_p という別のサンプリング設定もあります。公式リファレンスには、次のように書かれています。
temperatureかtop_pのどちらかを変更することを一般に推奨します。両方は変えないでください。
両方動かすと、出力が変わったときにどちらが効いたのか分からなくなります。初学者の段階では temperature だけで十分です。
max_output_tokens:出力の上限を決める
文字数ではなくトークン数
max_output_tokens は、1回のレスポンスで生成できるトークン数の上限です。
ここでまず押さえておきたいのが、トークンは文字ではないということです。生成AIは文章を文字単位ではなく、トークンという単位に分けて処理します(この分け方をトークナイズと呼びます)。日本語では「1文字=1トークン」とは限りません。
したがって max_output_tokens=500 を「500文字まで」と読み替えてはいけません。実際のトークン数は、文章の内容とモデルのトークナイズによって変わります。
「予約」ではなく「上限」
もう1つ。max_output_tokens=1000 と書いたからといって、必ず1000トークン生成されるわけではありません。短い回答で十分なら、モデルはそれより少ないトークンで終わります。
つまり「最大何トークンまで許すか」であって、「何トークン使う」という指定ではありません。料金も、実際に使われたトークンに基づきます。
見えない推論トークンも上限に含まれる
ここがこの記事でいちばん重要な部分です。
公式のAPIリファレンスには、max_output_tokens の説明として次のように書かれています。
レスポンスのために生成できるトークン数の上限。可視出力トークンと推論トークンを含みます。
gpt-5.6-luna のような推論モデルは、答える前に内部で考えます。その考えた分が推論トークンです。画面には出ませんが、上限にも料金にも数えられます。
この図は、公式ドキュメントに載っている実例です。出力1,186トークンのうち、1,024トークン(86%)が画面に出ない推論でした。実際に見える文章は162トークンしかありません。
数字を確かめておきます。入力75 + 出力1,186 = 合計1,261。出力のうち推論が1,024なので、可視出力は 1,186 − 1,024 = 162トークンです。
上限を小さくしすぎると、1文字も返らない
ここまでを踏まえると、次のことが起きます。
先ほどの例で max_output_tokens=500 と指定したとしましょう。モデルは推論だけで1,024トークンを必要とします。500の時点で打ち切られるので、可視出力は0トークンです。3行の要約が欲しかったのに、1文字も返ってきません。
つまり、こういうことです。
短い回答が欲しいことと、上限を小さくすることは、別の話。
回答を短くしたいなら instructions で指定します。max_output_tokens は「暴走を止める安全装置」であって、長さの調整つまみではありません。
公式は「最低25,000トークン」と案内している
どのくらい確保すればよいのか。推論モデルの公式ガイドには、こう書かれています。
これらのモデルを試し始めるときは、推論と出力のために最低25,000トークンを確保することを推奨します。
3行の要約に25,000トークン、と聞くと大きすぎるように感じます。しかし上限は「使う量」ではなく「許す量」です。実際に3行しか出なければ、課金されるのも3行ぶんと推論ぶんだけです。
大きめに取っておくことのコストは、ほぼありません。一方、小さすぎたときのコストは「何も返らず、再実行が必要になる」です。どちらの失敗が痛いかは明らかです。
切れたことを検知する
上限にぶつかったとき、APIは黙って短い回答を返すのではありません。ステータスで教えてくれます。公式ドキュメントにある確認方法がこれです。
if (
    response.status == "incomplete"
    and response.incomplete_details.reason == "max_output_tokens"
):
    print("トークンが足りずに打ち切られました")
response.status が "incomplete"(未完了)で、response.incomplete_details.reason が "max_output_tokens" なら、上限で切れたということです。
前回の記事で作った検査コードに、この判定を足しておくと安心です。「出力が変だ」と気づく前に、「そもそも最後まで出ていない」を弾けます。
2つのつまみは、決め方が違う
ここまでで分かるとおり、2つのパラメーターは性質が違います。決め方も分けたほうが迷いません。
temperature は用途で決めます。数値の定型要約なら低く、アイデア出しなら高く。これは最初に決めて、あとは比較で微調整する種類の値です。
max_output_tokens は実測で決めます。用途から「だいたい500くらい」と決め打ちできる値ではありません。まず切れない値(25,000以上)から始めて、実際に何トークン使ったかを見てから絞ります。
実際に設定してみる
Step 1:temperature を入れる
前回の売上分析コードへ、temperature を足します。
from openai import OpenAI

client = OpenAI()

rules = """
あなたは売上分析レポートの作成支援者です。
- 入力された数値を変更しない
- 原因を断定しない
- 3項目以内の箇条書きで簡潔に書く
"""

sales_data = """
売上合計:281,020円
最も売上が高い日:土曜日 51,590円
商品別売上1位:幕の内弁当 93,000円
"""

response = client.responses.create(
    model="gpt-5.6-luna",
    instructions=rules,
    input=f"次の集計結果を要約してください。\n\n{sales_data}",
    temperature=0.3,
)

print(response.output_text)
まずは同じ入力で数回実行し、文章のばらつきを見てください。
比較するときに大切なのは、一度に複数の条件を変えないことです。temperature を 0.2 から 0.8 へ変えるときは、model、instructions、input、max_output_tokens はそのままにします。そうすれば、違いが temperature によるものだと分かります。
Step 2:max_output_tokens を入れる
response = client.responses.create(
    model="gpt-5.6-luna",
    instructions=rules,
    input=f"次の集計結果を要約してください。\n\n{sales_data}",
    temperature=0.3,
    max_output_tokens=25000,
)
25,000という数字に驚くかもしれませんが、前の章のとおりです。まず切れないことを確認してから、実測して絞ります。
Step 3:usage で実測する
レスポンスには使用量の情報が付いてきます。
u = response.usage

print("入力トークン :", u.input_tokens)
print("出力トークン :", u.output_tokens)
print("うち推論     :", u.output_tokens_details.reasoning_tokens)
print("うち可視     :", u.output_tokens - u.output_tokens_details.reasoning_tokens)
print("合計         :", u.total_tokens)
出力例です。
入力トークン : 75
出力トークン : 1186
うち推論     : 1024
うち可視     : 162
合計         : 1261
usage.output_tokens_details.reasoning_tokens が、画面には出ていないけれど課金されている分です。ここを見ないと、なぜ思ったより料金がかかるのかが分かりません。
この実測値が分かれば、上限を絞れます。推論に1,024使うタスクなら、その2〜3倍の3,000前後を上限にしておけば、切れずに暴走も止められます。
2〜3パターンを回して比べる
比較スクリプト
設定値は、数字を眺めて決めるものではありません。代表的なデータで実際に回して、結果を並べて決めます。次のスクリプトが、その最小形です。
パターン = [
    {"name": "A", "temperature": 0.2, "max_output_tokens": 25000},
    {"name": "B", "temperature": 0.5, "max_output_tokens": 25000},
    {"name": "C", "temperature": 0.8, "max_output_tokens": 25000},
]

print(f"{'案':<4}{'temp':>6}{'状態':>12}{'推論':>8}{'可視':>8}{'項目':>6}")

for p in パターン:
    r = client.responses.create(
        model="gpt-5.6-luna",
        instructions=rules,
        input=f"次の集計結果を要約してください。\n\n{sales_data}",
        temperature=p["temperature"],
        max_output_tokens=p["max_output_tokens"],
    )

    切れた = (r.status == "incomplete"
              and r.incomplete_details.reason == "max_output_tokens")
    推論 = r.usage.output_tokens_details.reasoning_tokens
    可視 = r.usage.output_tokens - 推論
    項目 = len([x for x in r.output_text.splitlines()
                if x.strip().startswith("-")])

    print(f"{p['name']:<4}{p['temperature']:>6}"
          f"{'切れた' if 切れた else '完了':>12}{推論:>8}{可視:>8}{項目:>6}")
実行すると、こういう表が出ます。
案     temp          状態      推論      可視    項目
A      0.2          完了    1024     162     3
B      0.5          完了     988     171     3
C      0.8          完了    1102     205     3
f"{値:>8}" は「幅8で右寄せ」、:<4 は「幅4で左寄せ」という書き方です。これで列が揃います。
何を見るか
表の数字だけでなく、出力そのものも並べて見てください。確認するのは次の点です。
| 見るもの | 確認すること |
|---|---|
| 状態 | どれも「完了」か。1つでも「切れた」があれば上限が足りない |
| 項目数 | 指定した3項目以内を守っているか |
| 数値 | 入力になかった数値が混ざっていないか(前回の検査コード) |
| 表現のばらつき | 案ごとの違いが、業務として許容できる範囲か |
| 推論トークン | 案によって大きく変わらないか。変わるなら費用も変わる |
代表的なデータを10〜20件用意して、この比較を回すのが確実です。1件だけで決めると、たまたま良かった設定を選んでしまいます。
長さは instructions 側でも指定する
max_output_tokens だけで文章量を制御しようとするのは、おすすめしません。
max_output_tokens=25000 と書いても、モデルには「3行で書いてほしいのか、長い説明が欲しいのか」までは伝わりません。伝わるのは「これ以上は生成するな」という上限だけです。
そのため、instructions 側でも欲しい分量を日本語で指定します。
- 3項目以内の箇条書きにする
- 1項目は2文以内にする
役割を分けると、こうなります。
| 役割 | |
|---|---|
instructions |
どんな長さ・形式で書くか(狙いを伝える) |
max_output_tokens |
APIとして許容する最大量(暴走を止める) |
temperature と reasoning.effort は別の軸
gpt-5.6-luna のような推論モデルでは、reasoning.effort という設定も出てきます。名前が近いので混同しやすいのですが、動かしている場所が違います。
reasoning.effort は none / low / medium(既定)/ high / xhigh / max から選びます。公式ガイドでは、none は推論の恩恵がない低遅延タスク、medium は品質と信頼性が要るとき、high は難しい推論や複雑なデバッグ、と説明されています。
売上の数字を3点で要約するだけなら、深い推論は必要ないかもしれません。一方、複数の施策案を比較して長所・短所を整理するなら、推論量を増やすことで品質が上がる可能性があります。
そして、reasoning.effort を下げると推論トークンが減ります。前の章の「推論に1,024トークン使っていた」という実測値は、この設定でも変わります。コストを見るときは、temperature より先にこちらを疑ってください。
コストを下げたいときに効く順番
「APIの費用を抑えたい」と思ったとき、max_output_tokens を下げるのは最後の手段です。上限を小さくして必要な情報まで切れれば、再実行が必要になり、かえって高くつきます。
効く順番はこうです。
| 順 | やること | 効く理由 |
|---|---|---|
| 1 | instructions で短く書かせる |
可視出力トークンが直接減る |
| 2 | reasoning.effort をタスクに合わせる |
推論トークンが減る。出力の大半を占めることがある |
| 3 | 不要な入力を減らす | 入力トークンが減る |
| 4 | 適切なモデルを選ぶ | 単価そのものが変わる |
| 5 | max_output_tokens を必要十分な上限にする |
暴走したときの上限を決める。常時の削減策ではない |
1と2が、実際にいちばん効きます。特に2は、出力の86%が推論だった先ほどの例を思い出してください。見えない部分のほうが大きいことがあります。
temperature は次の世代でなくなる
最後に、知っておくと損をしない話を1つ。
OpenAIの最新モデルへの移行ガイドには、次世代の gpt-6-astra について、こう書かれています。
temperature、top_p、top_logprobsを削除してください。
これらは gpt-6-astra ではサポート対象外です。移行ガイドは代わりに、いま使っている実質的な推論量を保つよう reasoning.effort を指定することを案内しています。
つまり、出力の制御は「サンプリングをいじる」から「考える量を決める」へ移りつつあります。
2026年9月18日時点では、gpt-5.6-luna で temperature を引き続き指定できます。ただし、これから新しく作る仕組みなら、temperature に強く依存しない設計にしておくほうが安全です。具体的には、次の2つを守っておけば移行で困りません。
- 出力の安定性を
temperatureだけに頼らず、instructionsのルールと検査コードで担保する temperatureの値を設定ファイルや変数に切り出し、コードのあちこちに直書きしない
まとめ
2つのつまみを、性質の違いで整理します。
temperature |
max_output_tokens |
|
|---|---|---|
| 何を決めるか | 言い方のばらつき | 生成できるトークン数の上限 |
| 決め方 | 用途で決める | 実測で決める |
| 出発点 | 分析用途なら0.2〜0.6 | まず25,000以上、実測後に2〜3倍で固定 |
| 間違えると | 表現がぶれる/単調になる | 1文字も返らない |
| 将来 | 次世代モデルではサポート外 | 引き続き使う |
そして、今回いちばん覚えて帰ってほしいのはこの1点です。
max_output_tokensは、画面に出ない推論トークンも数えている。
3行しか欲しくなくても、モデルはその3行を書くために1,000トークン考えているかもしれません。上限はそこまで含めて確保します。
最後に、決めたあとの確認を3つ。
- 2〜3パターンを実際に回して、出力を並べて見る
status == "incomplete"を検知する処理を入れておくusage.output_tokens_details.reasoning_tokensで、見えない分を実測する
