ここまでの記事では、ずっと同じ2行を使ってきました。
response = client.responses.create(model=..., input=...)
print(response.output_text)
動かすことを優先してきたので、response の中に何が入っているのかには踏み込んでいません。今回は一度立ち止まって、そこを開けます。
生成AI APIとは?チャット画面との違いをPOS売上分析で理解する
https://www.salesanalytics.co.jp/datascience/datascience348/PythonからOpenAI APIを1回だけ呼び出す
https://www.salesanalytics.co.jp/datascience/datascience350/APIキーをコードへ直接書いてはいけない理由
https://www.salesanalytics.co.jp/datascience/datascience352/Pythonで環境変数からAPIキーを読み込む
https://www.salesanalytics.co.jp/datascience/datascience354/systemメッセージとuserメッセージの役割
(守ってほしいルールと、その都度変わるデータを分ける)
https://www.salesanalytics.co.jp/datascience/datascience358/temperatureと出力トークン数をどう決めるか
(分析用途でのばらつき・回答長・コストを調整する)
https://www.salesanalytics.co.jp/datascience/datascience359/APIの利用量と料金をPythonで確認する
(response.usageからコストを概算する)
https://www.salesanalytics.co.jp/datascience/datascience360/APIエラーとリトライの基本
401・429・5xxを切り分け、SDKの自動再試行に任せる範囲を決める
https://www.salesanalytics.co.jp/datascience/datascience361/APIレスポンスをログへ残す
許可リストで秘密情報を締め出し、成功率・p95・コストを追える形にする
https://www.salesanalytics.co.jp/datascience/datascience362/複数レコードをループで生成AI APIへ送る
止めるエラーと飛ばすエラーを分け、途中から再開できるようにする
https://www.salesanalytics.co.jp/datascience/datascience363/
先に、この記事の結論を3つ書いておきます。
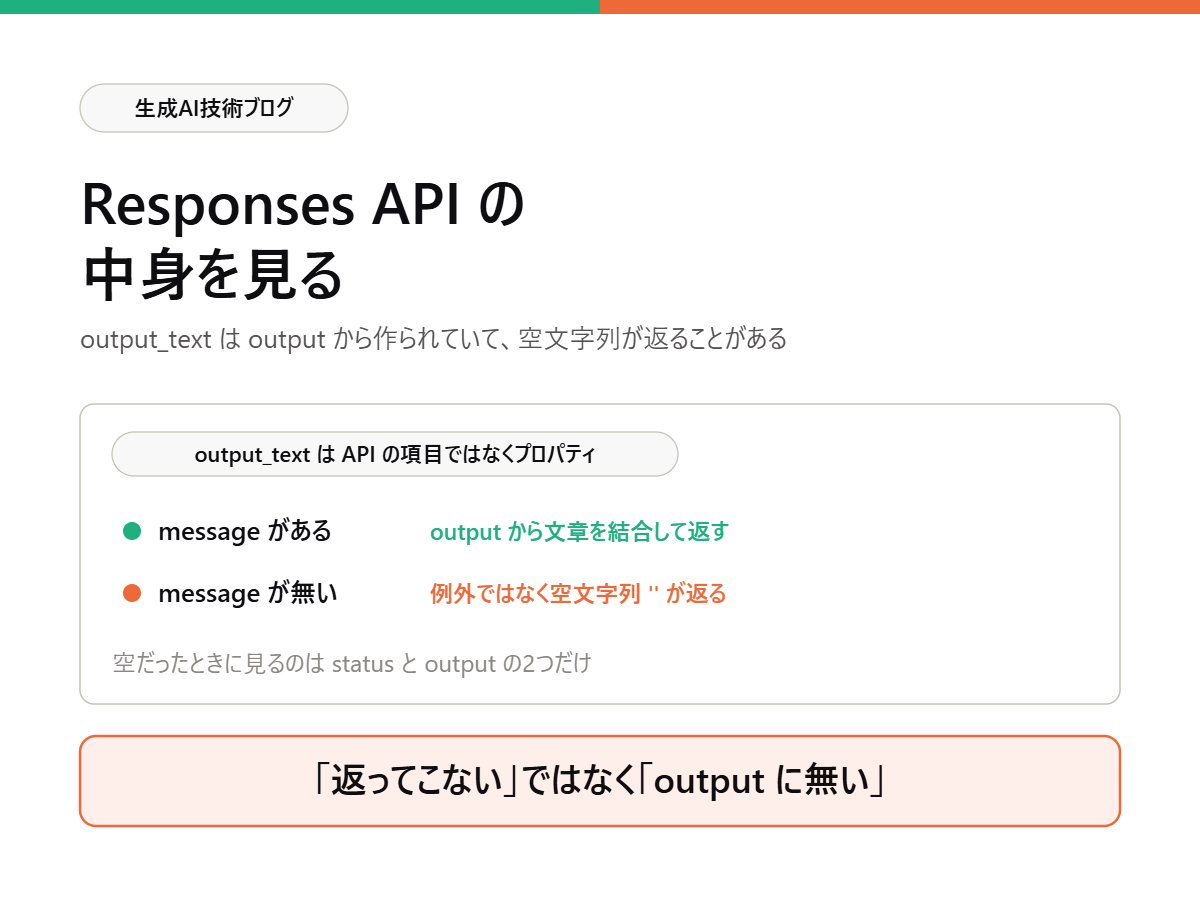
output_textはAPIから返ってくる項目ではありません。 SDKがoutputを走査して作るプロパティで、条件しだいで空文字列が返ります(エラーにはなりません)- 会話をつなぐと、入力トークンが積み上がります。 50ターンで、最初のターンの48倍になる例を出します
- 上限に達すると、既定では400エラーで失敗します。 古い分を落として続ける設定もありますが、既定ではありません
この記事を読み終えると、次のことができるようになります。
- Responseオブジェクトに何が入っているかを説明できる
output_textがoutputから作られていることを説明できるoutput_textが空文字列だったときに、原因を特定できるresponse.idとrequest_idを使い分けられるprevious_response_idで会話をつなげられるinstructionsが引き継がれないことを知っている- 会話をつないだときの入力トークンの増え方を見積もれる
- コンテキスト上限に達したときに何が起きるかを知っている
- 会話をつなぐか、毎回独立に呼ぶかを判断できる

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| Responseオブジェクト | create() が返すもの。文字列ではなく、複数の情報を持つ入れ物 |
| プロパティ | アクセスしたときに計算される値。保存された値ではありません |
| 出力アイテム | output に入る1つ1つ。type を持ちます |
| ターン | 会話の1往復。質問1つと回答1つ |
| コンテキスト | モデルが一度に読める文章の量。上限があります |
| コンテキスト上限 | その上限のトークン数。モデルごとに違います |
| 切り詰め(truncation) | 上限を超えたときに、古い部分を落とすこと |
| プロンプトキャッシュ | 同じ前置きを再利用する仕組み。読み出しは安くなります |
| 推論トークン | モデルが答える前に内部で考えた分。画面には出ませんが課金されます |
| ステートレス | 前回の呼び出しを覚えていないこと。APIは基本これです |
Responseは「文字列」ではない
create() が返すのは、文字列ではなくResponseオブジェクトです。
送るもの
| 引数 | 何を入れるか |
|---|---|
model |
どのモデルへ依頼するか |
instructions |
毎回同じルール。 systemまたはdeveloper相当のメッセージとして差し込まれます |
input |
その都度変わるデータ。 文字列でも、構造化されたアイテムの配列でも渡せます |
previous_response_id |
前回のResponseのID。会話をつなぐときに使います |
max_output_tokens |
生成できる量の上限(推論トークンを含む) |
store |
Responseを保存するか。既定は true |
truncation |
上限を超えたときの動作。既定は "disabled" |
instructions と input の分け方は、以前の記事で決めたとおりです。変わらないルールは instructions、変わるデータは input。
返ってくるもの
| 取り出し方 | 中身 |
|---|---|
response.id |
resp_...。このResponseのID。 会話をつなぐのに使います |
response.output |
出力アイテムの配列。 これが本体です |
response.output_text |
output から作られる文字列(後述) |
response.status |
completed / incomplete / failed など6種類 |
response.incomplete_details |
途中で終わった理由 |
response.usage |
トークン数。以前の記事で扱ったもの |
response._request_id |
req_...。HTTPリクエストのID。 障害調査に使います |
2行目と3行目の関係が、この記事でいちばん大事なところです。
output_text は output から作られている
これまで response.output_text を「回答を取り出す方法」として使ってきました。しかしこれはAPIから返ってくる項目ではありません。
SDKの実装を見る
SDKのソースを開くと、こうなっています。
@property
def output_text(self) -> str:
    """Convenience property that aggregates all `output_text` items
    from the `output` list.

    If no `output_text` content blocks exist, then an empty string
    is returned.
    """
    texts: List[str] = []
    for output in self.output:
        if output.type == "message":
            for content in output.content:
                if content.type == "output_text" and content.text is not None:
                    texts.append(content.text)

    return "".join(texts)
やっていることは3行で言えます。
outputの中を1つずつ見るtypeが"message"のものだけ拾う- その中のテキストをつなげて返す
つまり、output_text は output のショートカットです。手元で確かめると、フィールドですらありません。
from openai.types.responses import Response

print("output_text" in Response.model_fields)   # False
print(isinstance(Response.output_text, property))   # True
だから、空文字列が返ることがある
上のコードを読み直してください。type == "message" のアイテムが1つもなければ、"".join([]) つまり空文字列が返ります。 例外にはなりません。
実際に4つの場面を作って確かめます。
| 場面 | status |
output の中身 |
output_text |
|---|---|---|---|
| ふつうに文章が返った | completed |
['message'] |
「売上合計は281,020円」 |
| 推論アイテムだけ | incomplete |
['reasoning'] |
'' |
output が空 |
failed |
[] |
'' |
| 推論+メッセージ | completed |
['reasoning', 'message'] |
「土曜日が最高」 |
2行目が、以前の記事で扱った場面そのものです。max_output_tokens を小さくしすぎると、推論の途中で打ち切られて可視出力が0になります。そのとき output_text は空文字列です。
4行目も見てください。推論アイテムがあっても、メッセージがあれば文章は取れます。 推論アイテムの存在自体は問題ではありません。
空だったときに原因を特定する
空文字列を受け取ったときに見るのは、output と status の2つです。
if not response.output_text:
    print("status:", response.status)
    print("理由  :", getattr(response.incomplete_details, "reason", None))
    print("output:", [item.type for item in response.output])
| 見えたもの | 起きていること | 対処 |
|---|---|---|
status='incomplete'/reason='max_output_tokens' |
推論の途中で打ち切られた | max_output_tokens を増やす |
status='failed' |
生成に失敗した | response.error を見る |
output にツール呼び出しだけ |
モデルがツールを呼ぼうとしている | 呼んで結果を返す(次回以降の記事) |
status='completed' なのに空 |
モデルが本当に何も書かなかった | プロンプトを見直す |
まずは output_text で十分
ここまで読むと output を毎回見るべきかと思うかもしれませんが、そうではありません。 要約や説明文を作るだけなら output_text で足ります。
SDKのドキュメントにも、output の説明にこう書かれています。
output配列の最初のアイテムがモデルの生成したassistantメッセージだと決めてかかるのではなく、SDKが対応している場合はoutput_textプロパティを使うことを検討してください。
「自分で output[0] を掘るよりは output_text を使え」というのが公式の立場です。今回覚えておきたいのは、空だったときに output を見るという1点だけです。
response.id と request_id は別物
IDが2種類あって紛らわしいので、ここで整理します。
response.id |
response._request_id |
|
|---|---|---|
| 形 | resp_... |
req_... |
| 何のID | 生成されたResponse | HTTPリクエスト |
| 主な用途 | 会話をつなぐ | 障害を追う |
| 渡す先 | previous_response_id |
サポートへの問い合わせ |
| 失敗したとき | 取れない | exc.request_id で取れる |
| 接続エラーのとき | 取れない | 属性そのものが無い |
ひとことで言えば、会話をつなぐのが response.id、障害を追うのが request_id です。
前回までの記事で作った運用ログには request_id を入れました。会話型のアプリなら response_id も足しておくと、ターンごとの追跡ができるようになります。
{"timestamp": "...", "job": "chat", "status": "success",
 "response_id": "resp_...", "request_id": "req_...",
 "input_tokens": 410, "output_tokens": 160, "cost_usd": 0.000274}
previous_response_id で会話をつなぐ
APIはステートレスです。前回の呼び出しを覚えていません。それでも会話ができるのは、前回のResponseのIDを渡すからです。
1回目
ルール = """あなたは売上分析の補助者です。

- 与えられた数値を変更しない
- 根拠のない原因は断定しない
- 日本語で簡潔に"""

一回目 = client.responses.create(
    model=MODEL,
    instructions=ルール,
    input="""次の売上情報を2点で要約してください。

売上合計:281,020円
最高日:土曜日 51,590円
商品別1位:幕の内弁当 93,000円""",
)

print(一回目.output_text)
print(一回目.id)          # resp_...
2回目
二回目 = client.responses.create(
    model=MODEL,
    instructions=ルール,                       # ← 毎回渡す(後述)
    previous_response_id=一回目.id,
    input="商品別1位の商品名と売上金額だけ答えてください。",
)

print(二回目.output_text)
2回目の input には「幕の内弁当」も「93,000円」も書いていません。それでも答えられるのは、1回目のやりとりが文脈として渡っているからです。
instructions は引き継がれない
ここが見落とされやすいところです。 SDKの型定義には、こう書かれています。
モデルのコンテキストへ差し込まれるsystem(またはdeveloper)メッセージ。
previous_response_idと一緒に使った場合、前のResponseのinstructionsは次のResponseへ引き継がれません。 これにより、新しいResponseでsystem(またはdeveloper)メッセージを差し替えるのが簡単になります。
つまり、次のように書くとルールが外れた状態になります。
二回目 = client.responses.create(
    model=MODEL,
    previous_response_id=一回目.id,     # 文脈は引き継がれる
    input="続きの質問",                 # でも instructions は消えている
)
会話の中身は引き継がれ、ルールは引き継がれない。 この非対称が仕様です。
ドキュメントの言い方に注目してください。これは不便さではなく、意図された設計です。1ターン目は「初心者向けに説明」、2ターン目は「専門家向けに説明」と差し替えられます。文脈は保ったまま、ふるまいだけ変えられるわけです。
毎回守らせたいルールなら、ターンごとに
instructionsを渡し直します。 書き忘れても動いてしまうので、気づきにくい種類のバグです。
conversation とは併用できない
会話状態の管理方法には、もう1つ Conversations API があります。会話を長く残せるオブジェクトを作り、そこへメッセージを溜めていく方式です。セッションや端末をまたいで続けたい場合に使います。
ただし、2つは同時に使えません。 SDKの型定義に明記されています。
previous_response_id:モデルへの前のResponseの一意なID。複数ターンの会話を作るのに使います。conversationと組み合わせて使うことはできません。
この記事では、簡単なほうの previous_response_id を扱います。
つないだ会話は、入力が積み上がる
会話をつなぐと、ターンが進むほど入力トークンが増えていきます。公式ガイドにも明記があります。
previous_response_idを使っている場合でも、チェーン内のResponseの過去の入力トークンはすべて入力トークンとして課金されます。
IDだけ渡しているから過去は無料、ではありません。 実際に毎回、履歴ぜんぶがモデルへ渡っています。
ターンごとの入力トークン
ルール90トークン、1回目の質問120トークン、2回目以降の質問40トークン、毎回の回答160トークンとして概算します。
| ターン | 入力トークン | うちキャッシュ | このターンの料金 | 累計 |
|---|---|---|---|---|
| 1 | 210 | 0 | $0.000234 | $0.000234 |
| 2 | 410 | 0 | $0.000274 | $0.000508 |
| 5 | 1,010 | 0 | $0.000394 | $0.001570 |
| 6 | 1,210 | 1,080 | $0.000240 | $0.001810 |
| 10 | 2,010 | 1,880 | $0.000256 | $0.002808 |
| 50 | 10,010 | 9,880 | $0.000416 | $0.016312 |
50ターン目の入力は10,010トークン。1ターン目の48倍です。 質問そのものは40トークンのままなのに、履歴が積み上がった結果です。
6ターン目から、キャッシュが効きはじめる
表の「うちキャッシュ」の列を見てください。5ターン目までは0、6ターン目から急に1,080になります。
これは以前の記事で扱ったプロンプトキャッシュです。1,024トークン未満のプロンプトはキャッシュされません。 会話の履歴が1,024トークンを超えたところで、条件に入ります。
そして、会話をつなぐ形はキャッシュが効く形そのものです。毎回の先頭に同じ履歴が並ぶので、変わらない部分が先頭にまとまっています。読み出しは通常入力の0.1倍です。
| 50ターンの累計料金 | |
|---|---|
| キャッシュが効かない場合 | $0.060700 |
| 効いた場合 | $0.016312(73%減) |
毎回独立に呼ぶ場合との比較
では会話をつながず、毎回ルールと質問だけを送ったらどうなるか。
| ターン数 | 会話をつなぐ | 毎回独立 | 倍率 |
|---|---|---|---|
| 10 | $0.002808 | $0.002180 | 1.3倍 |
| 50 | $0.016312 | $0.010900 | 1.5倍 |
| 100 | $0.042192 | $0.021800 | 1.9倍 |
思ったほどは増えません。 キャッシュが効いているからです。入力トークンは48倍に増えていても、料金は1.5倍で収まっています。
とはいえ、倍率はターン数とともに上がり続けます。100ターンで1.9倍、その先はもっと開きます。「会話をつなぐのはタダではないが、思ったほど高くもない」というのが正確なところです。
上の数値は概算のシミュレーションです。実際のトークン数はプロンプトとモデルで変わります。手元では
usage.input_tokensとusage.input_tokens_details.cached_tokensを実測してください。
上限に達すると、既定では400エラー
料金より先に来る問題があります。コンテキスト上限です。
上の例だと1ターンにつき約200トークンずつ増えるので、こうなります。
| コンテキスト上限 | 何ターンまで続けられるか |
|---|---|
| 8,000トークン | 約39ターン |
| 32,000トークン | 約159ターン |
| 128,000トークン | 約639ターン |
truncation の既定は disabled
到達したときに何が起きるか。SDKの型定義に書かれています。
モデルレスポンスに使う切り詰め方針。
auto:このResponseへの入力がモデルのコンテキストウィンドウのサイズを超える場合、会話の先頭からアイテムを落とすことでコンテキストウィンドウに収まるよう切り詰めますdisabled(既定):入力サイズがコンテキストウィンドウのサイズを超える場合、リクエストは400エラーで失敗します
既定は「失敗する」ほうです。 黙って古い分が落ちるのではなく、エラーになります。
これは親切な設計です。勝手に履歴が落ちると、モデルが忘れたことに気づけません。 400エラーなら気づけます。
長い会話をどう畳むか
| やり方 | どうなるか |
|---|---|
| そのまま(既定) | 上限で400エラー。気づける |
truncation="auto" |
古い順に落として継続。落ちたことは分からない |
| 区切って新しい会話にする | アプリ側で「新しい相談」ボタンなどを用意する |
| 要約して渡し直す | これまでの会話を短くまとめ、新しいチェーンの1ターン目にする |
いちばん確実なのは3番目です。 長い会話を無理に続けるより、区切ったほうが料金も精度も安定します。
store と保存期間
store の説明も確認しておきます。
生成したモデルレスポンスを、あとでAPIから取得できるように保存するかどうか。省略した場合は true になります。 true にすると、レスポンスのデータは少なくとも30日間保存されます。
store=True(既定) |
store=False |
|
|---|---|---|
| 保存 | 少なくとも30日 | されない |
| ダッシュボードで見る | できる | できない |
| あとで取得 | できる | できない |
「とりあえず全部
store=False」と機械的に決めないでください。 会話をつなぐ仕組みは、サーバー側に前のResponseがあることが前提です。保存を止める判断は、アプリの用途とデータの扱い方針を確認してから決めてください。
手元で確かめる
ここまでの内容は、APIを呼ばずに確かめられる部分と、実際に呼んで測る部分に分かれます。両方やっておきます。
空文字列のシナリオを、偽のResponseで作る
output_text が空文字列になる場面は、本物のAPIを呼ばなくても再現できます。 SDKの型は construct() で手組みできるからです。料金もかかりません。
from openai.types.responses import Response
from openai.types.responses.response_output_message import (
    ResponseOutputMessage)
from openai.types.responses.response_output_text import ResponseOutputText
from openai.types.responses.response_reasoning_item import (
    ResponseReasoningItem)


def メッセージ(text):
    return ResponseOutputMessage.construct(
        id="msg_1", type="message", role="assistant", status="completed",
        content=[ResponseOutputText.construct(
            type="output_text", text=text, annotations=[])])


def 推論だけ():
    return ResponseReasoningItem.construct(
        id="rs_1", type="reasoning", summary=[])


def 偽のResponse(出力, status="completed", 理由=None):
    return Response.construct(
        id="resp_test", created_at=0.0, model=MODEL, object="response",
        output=出力, parallel_tool_calls=False, tool_choice="auto",
        tools=[], status=status,
        incomplete_details={"reason": 理由} if 理由 else None)
あとは4つの場面を並べて、output_text を見るだけです。
場面 = {
    "ふつうに文章が返った": 偽のResponse([メッセージ("売上合計は281,020円")]),
    "推論だけで打ち切られた": 偽のResponse([推論だけ()],
                                          "incomplete", "max_output_tokens"),
    "output が空": 偽のResponse([], "failed"),
    "推論+メッセージ": 偽のResponse([推論だけ(), メッセージ("土曜日が最高")]),
}

for 名, r in 場面.items():
    print(f"{名:12s} {r.status:11s} {r.output_text!r}")
    print(f"{'':12s} output: {[i.type for i in r.output]}")
ふつうに文章が返った   completed   '売上合計は281,020円'
             output: ['message']
推論だけで打ち切られた  incomplete  ''
             output: ['reasoning']
output が空    failed      ''
             output: []
推論+メッセージ     completed   '土曜日が最高'
             output: ['reasoning', 'message']
2番目と3番目が、空文字列です。 例外は出ていません。この4つを一度自分の画面で出しておくと、本番で空が返ってきたときに慌てずに済みます。
これは自分の書いた後処理をテストする道具にもなります。「空文字列だったら再送する」「status を見てログに残す」といった処理は、本物のAPIでは狙って起こせません。偽のResponseなら一瞬です。
会話のトークンを実測する
積み上がり方は概算で示しましたが、実際の数字はプロンプトしだいです。 つないだ会話を回しながら、ターンごとに usage を出します。
前のID = None
for i, 質問 in enumerate(質問リスト, start=1):
    r = client.responses.create(
        model=MODEL,
        instructions=ルール,          # ← 毎ターン渡し直す
        previous_response_id=前のID,
        input=質問,
    )
    u = r.usage
    キャッシュ = u.input_tokens_details.cached_tokens
    print(f"{i:>3d}  入力 {u.input_tokens:>6,d}"
          f"  うちキャッシュ {キャッシュ:>6,d}"
          f"  出力 {u.output_tokens:>5,d}")
    前のID = r.id
見るところは2つです。入力トークンがターンごとにいくら増えるかと、キャッシュが何ターン目から効きはじめるか。この2つが分かれば、上限に何ターンで届くかも、料金がいくらになるかも自分の数字で計算できます。
会話をつなぐか、毎回独立に呼ぶか
ここまでを踏まえて、使い分けを整理します。
| 毎回独立に呼ぶ | 会話をつなぐ | |
|---|---|---|
| 向いている用途 | 一覧処理・バッチ | 対話・掘り下げ |
| 入力トークン | 毎回同じ | 積み上がる |
| 上限 | 気にしなくてよい | いつか到達する |
| 再実行 | 何度でも同じ | チェーンをやり直す必要がある |
| 失敗の影響 | その1件だけ | そこから先が続けられない |
| ルールの渡し方 | 毎回 instructions |
やはり毎回 instructions |
前回の記事で作った「5商品を1件ずつ処理する」ループは、左の列です。商品Aのコメントを作るのに、商品Bのやりとりは要りません。つながないほうが速く、安く、失敗しても1件で済みます。
一方、店舗スタッフが「先週の売上を要約して」→「その中で一番売れた商品は?」→「それは先月と比べてどう?」と掘り下げる場面は右の列です。
迷ったら、つながないほうから始めてください。 必要な情報を毎回
inputに入れて済むなら、そのほうが単純です。会話をつなぐのは「前のやりとりを参照しないと質問が成り立たない」ときだけで十分です。
この記事で扱っていないこと
構造化された input
この記事の input はすべて文字列です。しかし input はアイテムの配列も受け取れます。ユーザーメッセージ、画像、ツールの出力などを並べる形です。
文字列で渡したときは、それが1つのユーザーメッセージとして扱われます。文字列は配列の省略形だと思っておいてください。
Conversations API
先ほど触れたとおり、会話を長期に保持する別の仕組みがあります。previous_response_id がResponseからResponseへ数珠つなぎにするのに対し、Conversations APIは会話そのものを1つのオブジェクトとして持ちます。
セッションや端末をまたぐ用途では、そちらが向いています。ただし previous_response_id とは併用できません。
まとめ
今回、覚えておいた方がいいことです。
output_text |
output から作られるプロパティ。 メッセージが無ければ空文字列が返る |
| 空だったとき | status と output の type を見る。エラーにはならない |
| 2つのID | 会話をつなぐのが response.id、障害を追うのが request_id |
instructions |
会話をつないでも引き継がれない。 毎ターン渡し直す |
| 入力トークン | ターンごとに積み上がる。 50ターンで48倍の例 |
| キャッシュ | 履歴が1,024トークンを超えると効きはじめ、料金の伸びを抑える |
| 上限 | 既定(truncation="disabled")では400エラー。 黙って落ちはしない |
| 使い分け | 迷ったら、つながない。 バッチは独立、対話はチェーン |
ここまで、response.output_text の1行で済ませてきました。それは正しい使い方です。ただし、空文字列が返ったときに中を見られるかどうかで、次の段階へ進めるかが変わります。
