前回の記事では、temperature と max_output_tokens の決め方を見ました。そこで usage から実測した「見えない推論トークン」が、今回そのまま料金の話につながります。
APIを実務で使い始めると、次に気になるのはこれです。
この1回の呼び出しで、いくら使ったのか。
1回なら小さな金額でも、100店舗・毎日・複数回と積み上がれば月額は変わります。今回は response.usage からトークン数を取り出し、料金表を掛けて1回のコストを概算し、そこから運用の回数へ広げます。
先に、この記事の結論を3つ書いておきます。
- 料金の9割以上は出力側で決まります。入力を短くするより、出力を減らすほうが効きます
- まとめて処理できるなら、Batch でちょうど半額になります
- 同じ前置きを2回以上送るなら、キャッシュが効きます。ただし1回だけだと逆に高くつきます
この記事を読み終えると、次のことができるようになります。
response.usageからAPIの利用量を取り出せるcached_tokensとreasoning_tokensが内数であることを理解し、二重計上を避けられる- 1回のAPI料金をPythonで概算できる
- 料金の内訳のうち、どこが効いているかを説明できる
- 100回・3,000回・30,000回の運用コストへ広げられる
- Batch とキャッシュで、どれだけ下がるかを計算できる
- 何回も回して平均と最大を取り、CSVへ記録できる
- 自作の概算値と、正式な請求額を区別できる

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
料金の話は、用語が分からないだけで急に難しく感じます。この記事で使う言葉を先にまとめておきます。いま全部覚える必要はありません。本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| トークン | モデルが文章を処理する単位。文字数とは一致しません。課金もこの単位です |
| 単価 / 1M | 100万トークンあたりの料金。1M は100万のこと |
| input_tokens | モデルへ渡した入力側のトークン数 |
| output_tokens | モデルが生成したトークン数。推論トークンも含みます |
| 推論トークン | 答える前に内部で考えた分。画面には出ませんが課金されます |
| 内数(うちすう) | 「すでにその中に含まれている数」のこと。別に足してはいけません |
| total_tokens | 入力と出力を合わせたトークン数 |
| プロンプトキャッシュ | 同じ前置きを再利用する仕組み。読み出しは安く、書き込みは少し高くなります |
| サービスティア | 処理方式の区分。Standard のほか、安いが遅い Batch、速いが高い Fast があります |
| Batch | すぐに結果が要らない処理をまとめて流す方式。単価が半額になります |
| 短いコンテキスト | 入力が一定量以下のリクエスト。これを超えると単価が上がります(後述) |
| Usage / Billing | OpenAIの管理画面にある、利用状況と請求のページ |
| 概算 | 自分で料金表を掛けて出した見積もり。正式な請求額とは区別します |
料金の基本は「トークン数 × 単価」
テキスト生成APIの料金は、基本的にこう考えます。
入力トークン数 × 入力単価
+
出力トークン数 × 出力単価
掛け算と足し算だけです。難しいのは計算ではなく、どのトークン数を、どの単価で掛けるかのほうです。
今回使う単価
これまでの記事と同じ gpt-5.6-luna を使います。2026年9月19日時点の Standard・短いコンテキストの料金は次のとおりです。
| 種類 | 100万トークンあたり |
|---|---|
| 入力 | $0.20 |
| キャッシュ済み入力(読み出し) | $0.02 |
| キャッシュ書き込み | $0.25 |
| 出力 | $1.20 |
3行目に注目してください。キャッシュ書き込みは $0.25 で、通常の入力 $0.20 より高いです。キャッシュはタダではありません。この点は後半で扱います。
単価は1種類ではない
同じモデルでも、条件によって単価が変わります。主なものは2軸です。
| サービスティア | 入力 | 出力 | 使いどころ |
|---|---|---|---|
| Standard | $0.20 | $1.20 | 通常。この記事の基準 |
| Batch | $0.10 | $0.60 | ちょうど半額。すぐ結果が要らない処理 |
| Fast | $0.40 | $2.40 | 2倍。応答速度を優先したいとき |
もう1軸が、入力の長さです。入力が272Kトークンを超えると単価が上がります。これも後半で扱います。
response.usage で使用量を見る
APIを1回呼ぶ
まずは普通に呼びます。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.6-luna",
    input="""
次の売上情報を2文以内で要約してください。

売上合計:281,020円
最高日:土曜日 51,590円
商品別1位:幕の内弁当 93,000円
""",
)

print(response.output_text)
回答はたとえばこうなります。
1週間の売上合計は281,020円で、最も売上が高い日は土曜日の51,590円でした。
商品別では幕の内弁当が93,000円で最も高い売上でした。
今回見たいのは、この回答文ではなく response.usage のほうです。
5つの項目
取り出せるのは次の5つです。
| 項目 | 中身 |
|---|---|
input_tokens |
モデルへ渡した入力側のトークン数 |
input_tokens_details.cached_tokens |
そのうち、キャッシュから読み出した分 |
output_tokens |
モデルが生成したトークン数 |
output_tokens_details.reasoning_tokens |
そのうち、画面に出ない推論に使った分 |
total_tokens |
入力と出力の合計 |
まとめて表示すると、こうなります。
u = response.usage

print("input_tokens     :", u.input_tokens)
print("cached_tokens    :", u.input_tokens_details.cached_tokens or 0)
print("output_tokens    :", u.output_tokens)
print("reasoning_tokens :", u.output_tokens_details.reasoning_tokens or 0)
print("total_tokens     :", u.total_tokens)
input_tokens     : 420
cached_tokens    : 0
output_tokens    : 1186
reasoning_tokens : 1024
total_tokens     : 1606
末尾の or 0 は、値が None のときに0として扱うための書き方です。推論に対応していないモデルや、キャッシュが効かなかった場合に None が返ることがあります。
内数に気をつける
ここがこの記事でいちばん間違えやすい部分です。
cached_tokensもreasoning_tokensも、内数です。
内数とは「すでにその中に含まれている数」という意味です。上の例なら、
reasoning_tokensの 1,024 は、output_tokensの 1,186 の中に含まれています- だから、画面に見える文章は 1,186 − 1,024 = 162トークンだけです
- 料金計算で
1186 + 1024としてはいけません。二重に数えることになります
cached_tokens も同じです。input_tokens が 10,000 で cached_tokens が 6,000 なら、通常入力は 10,000 − 6,000 = 4,000トークンと考えます。
一方 total_tokens は内数ではなく、input_tokens + output_tokens の合計です。420 + 1,186 = 1,606 で合っています。
1回の料金を計算する
式を先に
式はこうなります。
通常入力 = input_tokens − cached_tokens

料金 = 通常入力        ÷ 1,000,000 × 入力単価
     + cached_tokens ÷ 1,000,000 × キャッシュ読み出し単価
     + output_tokens ÷ 1,000,000 × 出力単価
reasoning_tokens はどこにも出てきません。すでに output_tokens に含まれているからです。
上の例に当てはめると、こうなります。
| 種類 | トークン数 | 単価 / 1M | 小計 |
|---|---|---|---|
| 通常入力 | 420 | $0.20 | $0.000084 |
| キャッシュ済み入力 | 0 | $0.02 | $0.000000 |
| 出力(推論を含む) | 1,186 | $1.20 | $0.001423 |
| 1回あたり | $0.001507 |
Pythonで書く
IN_USD_PER_1M     = 0.20
CACHED_USD_PER_1M = 0.02
OUT_USD_PER_1M    = 1.20

def 概算料金(usage):
    cached = usage.input_tokens_details.cached_tokens or 0
    通常入力 = usage.input_tokens - cached
    return (通常入力 / 1_000_000 * IN_USD_PER_1M
            + cached / 1_000_000 * CACHED_USD_PER_1M
            + usage.output_tokens / 1_000_000 * OUT_USD_PER_1M)

print(f"1回あたり ${概算料金(response.usage):.6f}")
1_000_000 のアンダースコアは、Pythonで数字を読みやすくするための区切りです。1000000 と書いたのと同じ意味になります。
上限は「使った量」ではない
前回の記事で設定した max_output_tokens は、あくまで生成できる量の上限です。料金の計算に使うのは、実際に使った output_tokens のほうです。
| 意味 | |
|---|---|
max_output_tokens |
最大どこまで許すか(設定値) |
usage.output_tokens |
実際にいくつ使ったか(実績値) |
前回、上限を25,000にしておくことをおすすめしましたが、それで料金が25,000トークンぶんになるわけではありません。実際に1,186しか使わなければ、課金も1,186ぶんです。
料金を決めているのは、ほぼ出力側
ここで、内訳を見てみてください。
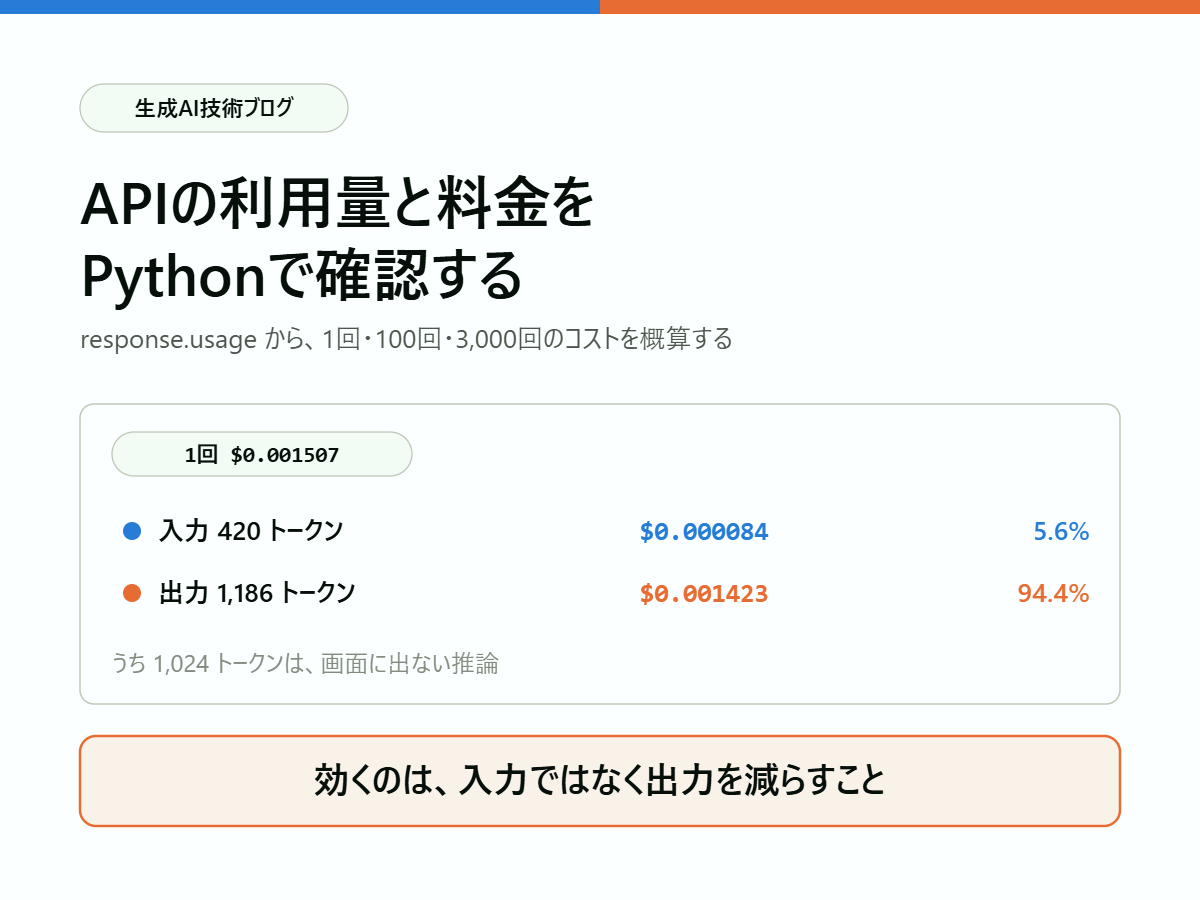
1回 $0.001507 のうち、入力は $0.000084 で5.6%。残りの94.4%が出力です。
理由は2つあります。単価が6倍違うこと(入力 $0.20 に対して出力 $1.20)と、トークン数そのものが多いこと(入力420に対して出力1,186)です。
そして出力1,186のうち1,024は、前回見たとおり画面に出ない推論です。つまり、この呼び出しの料金のほとんどは「見えないところで考えた分」で占められています。
推論の量が違うと、どれくらい変わるか。
| 出力トークン | 1回の料金 | 3,000回では | |
|---|---|---|---|
| 推論が少ない | 180 | $0.000300 | $0.90 |
| 推論が多い | 1,186 | $0.001507 | $4.52 |
見える文章の量は同じでも、5倍変わります。ここから、実務的な結論が1つ出ます。
入力のプロンプトを削るより、出力(ほぼ推論)を減らすほうが効く。
出力を減らす手段は、前回の記事で扱った instructions での長さ指定と、reasoning.effort の調整です。「入力のCSVを短くしよう」と考える前に、まずこちらを見てください。
回数へ広げる
1回から月額まで
1回の料金が出たら、運用の回数を掛けます。
たとえば、100店舗へ展開して各店舗について毎朝1回レポートを生成するとします。
100店舗 × 1回/日 × 30日 = 3,000回/月
1回 $0.001507 なら、月額は $4.52 です。API設計では、この「1回の料金 × 利用回数」まで広げて考えます。
まとめて処理できるなら Batch で半額
ここで効いてくるのが、さきほどの表にあった Batch です。
Batch は「すぐに結果が返る必要のない処理を、まとめて流す」方式で、入力も出力もちょうど半額になります。
「100店舗のレポートを毎朝作る」という処理は、まさにこれに当てはまります。深夜のうちに流して朝までに揃っていればよいのなら、対話的に1件ずつ呼ぶ必要はありません。
| Standard | Batch | |
|---|---|---|
| 3,000回/月 | $4.52 | $2.26 |
| 30,000回/月 | $45.22 | $22.61 |
逆に、画面で待っている人がいる処理(チャット、その場での質問応答)には使えません。「待てるかどうか」で振り分けると考えてください。
何回も回して平均を取る
計測スクリプト
1回の結果だけで「このアプリは1回いくら」と決めるのは早すぎます。プロンプトもデータも毎回違うので、トークン数は揺れます。
代表的なデータで複数回回して、記録するスクリプトがこれです。
import csv, statistics

記録 = []

for i, データ in enumerate(代表データ, start=1):      # 10〜20件用意する
    r = client.responses.create(
        model="gpt-5.6-luna",
        instructions=rules,
        input=データ,
    )
    u = r.usage
    記録.append({
        "回": i,
        "入力": u.input_tokens,
        "キャッシュ": u.input_tokens_details.cached_tokens or 0,
        "出力": u.output_tokens,
        "推論": u.output_tokens_details.reasoning_tokens or 0,
        "合計": u.total_tokens,
        "概算USD": round(概算料金(u), 8),
    })

with open("usage_log.csv", "w", encoding="utf-8-sig", newline="") as f:
    w = csv.DictWriter(f, fieldnames=list(記録[0]))
    w.writeheader()
    w.writerows(記録)

料金 = [r["概算USD"] for r in 記録]
出力 = [r["出力"] for r in 記録]
推論 = [r["推論"] for r in 記録]

平均出力 = statistics.mean(出力)
平均推論 = statistics.mean(推論)
平均料金 = statistics.mean(料金)
最大料金 = max(料金)

print(f"出力 平均 {平均出力:,.0f} / 最大 {max(出力):,}")
print(f"推論 平均 {平均推論:,.0f}(出力の {平均推論/平均出力:.0%})")
print(f"料金 平均 ${平均料金:.6f} / 最大 ${最大料金:.6f}")
print(f"月3,000回: 平均基準 ${平均料金*3000:,.2f} / 最大基準 ${最大料金*3000:,.2f}")
出力は、たとえば以下のようになります。
出力 平均 1,287 / 最大 1,561
推論 平均 1,113(出力の 86%)
料金 平均 $0.001630 / 最大 $0.001964
月3,000回: 平均基準 $4.89 / 最大基準 $5.89
encoding="utf-8-sig" は、CSVをExcelでそのまま開いても文字化けしないようにするための指定です。statistics はPython標準の統計モジュールで、追加のインストールは要りません。
平均だけでなく最大も見る
予算を立てるときに見るべきは、平均と最大の両方です。
- 平均は、通常月にいくらかかるかの目安になります
- 最大は、入力が大きい月や推論が伸びた月の上振れを示します
上の例なら、平均基準で $4.89、最大基準で $5.89。この幅を知っていれば「今月は $6 だった」と言われても慌てずに済みます。
ログに残しておく項目
分析アプリでは、APIキーなどの秘密情報を除き、次を記録しておくと後で助かります。
| 項目 | 何に使うか |
|---|---|
| 日時、モデル | いつ・どのモデルで増えたかの特定 |
| 入力・出力・推論・合計のトークン数 | どこが増えたかの切り分け |
| キャッシュ済みトークン数 | キャッシュが効いているかの確認 |
| 概算料金 | 日次・月次の積み上げ |
| 処理時間、成功/失敗 | 再実行の有無と、その分の費用 |
「なぜ今月のAPI料金が増えたのか」を後から調べられるかどうかは、ここを残しているかで決まります。
同じ前置きを何度も送るなら、キャッシュが効く
2回目から得になる
プロンプトキャッシュは、プロンプトの前のほうにある変わらない部分(プレフィックス)を再利用する仕組みです。自動で有効になっていて、こちらで設定する必要はありません。
ただし、単価をよく見てください。
| 単価 / 1M | 通常入力との比 | |
|---|---|---|
| 通常入力 | $0.20 | 1倍 |
| キャッシュ書き込み | $0.25 | 1.25倍 |
| キャッシュ読み出し | $0.02 | 0.1倍 |
書き込みは通常より高いのです。つまり、1回しか送らないプレフィックスをキャッシュすると損をします。
同じ3,000トークンの前置きを n 回送る場合を計算すると、こうなります。
| 回数 | キャッシュなし | キャッシュあり | |
|---|---|---|---|
| 1回 | $0.000600 | $0.000750 | 損 |
| 2回 | $0.001200 | $0.000810 | ここから得 |
| 5回 | $0.003000 | $0.000990 | 33% |
| 30回 | $0.018000 | $0.002490 | 14% |
損益分岐は2回目です。回数が増えるほど差は開き、30回なら14%まで下がります。100店舗ぶんを同じルールで処理するような使い方では、ここが大きく効きます。
効かせるための3つの条件
キャッシュは自動ですが、効く条件があります。
| 条件 | 内容 |
|---|---|
| 長さ | 1,024トークン未満のプロンプトはキャッシュされません |
| 並び順 | キャッシュされるのは先頭からの変わらない部分だけです |
| 時間 | 既定では、最後に使ってから30分以上は保持されます |
1つ目が効いてくるのが、この記事の例です。入力420トークンでは1,024に届かないので、cached_tokens は構造的に常に0になります。先ほどの出力例で0だったのは、キャッシュが失敗したからではありません。
2つ目が、前々回の記事とつながります。instructions(毎回同じルール)と input(毎回変わるデータ)を分ける設計は、変わらない部分を先頭にまとめることでもありました。あの分け方は、そのままキャッシュが効く形になっています。
逆に、プロンプトの冒頭に日付やリクエストIDのような毎回変わる値を入れると、そこから先が一切キャッシュされません。変動する値は後ろへ回してください。
入力が272Kを超えると単価が変わる
もう1つ、金額が跳ねる条件があります。モデルページには、こう書かれています。
入力トークンが272Kを超えるプロンプトは、リクエスト全体に対して入力2倍・出力1.5倍の料金になります。
注意したいのは「リクエスト全体に対して」という部分です。超えた分だけが高くなるのではありません。
| 入力トークン | 1回の料金 |
|---|---|
| 272,000 | $0.0558 |
| 272,001 | $0.1109 |
1トークン超えただけで、約2倍になります。大きなCSVやドキュメントをまるごと投げる設計では、ここを踏む可能性があります。
対処は単純で、しきい値の手前に収まるよう入力を分割するか、必要な部分だけを送ることです。前回までの記事で「巨大なCSV全文ではなく集計結果を送る」と書いたのは、品質の話であると同時に、この料金の話でもあります。
この計算の限界
扱っていない条件
今回の計算は、学習用に単純化しています。次のケースではそのまま使えません。
- キャッシュ書き込みが発生する場合(計算に $0.25 の行が要ります)
- Batch / Fast など、Standard 以外のサービスティア
- 入力が272Kを超える長いコンテキスト
- Web検索やComputer useなどのツール利用(別料金がかかります)
- データレジデンシーなど、別の契約条件
したがって、この記事のコードは「Standard・短いコンテキスト・通常のテキスト生成の概算」として使ってください。
正式な請求額ではない
Pythonで出した金額は、料金表を自分で掛けた概算です。正式な利用状況と請求額は、OpenAI Platform の Usage / Billing で確認します。
では自作の概算に意味がないかというと、そうではありません。次の場面で役に立ちます。
- 設計時の見積もり — 作る前に月額のオーダーが分かる
- モデルや設定の比較 — 同じ入力で、どちらが安いかを並べられる
- 異常の発見 — 「今日だけ推論トークンが3倍」に気づける
- 予算の説明 — 上司や顧客に根拠つきで示せる
概算は設計と監視のため、正式な請求はPlatform側で。この2つを分けて考えてください。
コストを下げる順番
料金が大きくなってきたら、次の順で見直します。上ほど効きます。
| 順 | やること | 効く理由 |
|---|---|---|
| 1 | 不要なAPI呼び出しを減らす | 回数が半分になれば料金も半分。いちばん確実 |
| 2 | Pythonでできる計算はPythonへ戻す | 売上合計、ランキング、ABC分析に生成AIは要らない |
| 3 | 出力を短くする(instructions と reasoning.effort) |
料金の94%は出力側 |
| 4 | 待てる処理を Batch へ回す | ちょうど半額 |
| 5 | 同じ前置きを使うなら、変わらない部分を先頭へ | 2回目からキャッシュが効く |
| 6 | 入力を短くする | 効くが、料金に占める割合は小さい |
| 7 | より低コストのモデルで足りないか確認する | 単価そのものが変わる |
下書き段階でよくあるのが、6番から手をつけてしまうことです。入力を半分にしても、この例では料金が2.8%しか下がりません。3番と4番のほうが、桁違いに効きます。
まとめ
APIのコストは、実際に使ったトークン数を見て考えます。基本は response.usage の3つです。
response.usage.input_tokens
response.usage.output_tokens
response.usage.total_tokens
推論対応モデルでは、内訳も見られます。
response.usage.output_tokens_details.reasoning_tokens
response.usage.input_tokens_details.cached_tokens
この2つは内数です。足さないでください。
今回の要点を4つに整理します。
| 覚えておくこと | |
|---|---|
| 何が料金を決めるか | 94%は出力側。入力を削るより出力を減らす |
| まとめて処理できるなら | Batch でちょうど半額 |
| 同じ前置きを繰り返すなら | キャッシュが2回目から得。1回だけなら損 |
| 見積もりの出し方 | 10〜20件回して平均と最大を取り、回数を掛ける |
そして、自作の概算と正式な請求は分けて考えます。概算は設計と監視のため、請求額はPlatform側で確認する。これが実務での付き合い方です。
