前回、キャンペーンをした5月の売上は、前の月より14.7%多い、という数字を出しました。
前の年の5月と比べると17.9%。キャンペーン前の平均と比べると19.6%。
同じ店、同じキャンペーンなのに、比べる相手を変えるだけで「効果」が変わります。データに仕込んだ正解は10%です。
結論を先に3行で書きます。
- 前後比較の差には、トレンド・季節性・偶然のゆらぎが混ざります。キャンペーンをしていない店舗Aでも、前後比較では4.5〜10.6%の「効果」が出ます。
- 本当に比べたいのは「キャンペーンをした5月」と「キャンペーンをしなかった5月」です。後者を反実仮想と呼び、現実には観測できません。
- 観測できないなら、予測で作ります。キャンペーンをしていない店舗の伸びを借りるだけで、推定は10.0%と正解に近づきます。これを精密にしたのがCausalImpactです。
この記事を読み終えると、次のことができるようになります。
- 前後比較の数字に何が混ざっているかを、3つに分けて説明できる
- キャンペーンをしていない店で前後比較をして、比べ方の危うさを自分で確かめられる
- 反実仮想とは何かを、一言で説明できる
- 対照店舗の伸びを使って、簡単な反実仮想を作れる
この記事では、CausalImpactのライブラリはまだ使いません。pandas・NumPy・matplotlibだけで動きます。
データは前回と同じ campaign_sales.csv です。以下からダウンロードできます。
比べ方を変えると、効果が変わる
キャンペーン期間(2026年5月)の1日あたり平均売上を、3通りの相手と比べます。自店舗(sales_own)だけでなく、キャンペーンをしていない店舗A・B(store_a、store_b)も一緒に計算しておきます。
以下、コードです。
import pandas as pd

data = pd.read_csv("campaign_sales.csv", index_col="date", parse_dates=True)
may = data.loc["2026-05"]  # キャンペーン期間(2026年5月)

# 比べる相手(キャンペーン前の期間)を3通り用意する
comparisons = {
    "前月比": data.loc["2026-04"],
    "前年同月比": data.loc["2025-05"],
    "キャンペーン前の平均比": data.loc[:"2026-04-30"],
}

# 1日あたり平均売上の伸び率(%)を、3つの店舗それぞれで計算する
result = pd.DataFrame({
    name: (may.mean() / before.mean() - 1) * 100
    for name, before in comparisons.items()
}).T.round(1)
print(result)
以下、実行結果です。
             sales_own  store_a  store_b
前月比               14.7      4.5      4.1
前年同月比             17.9      8.0      5.9
キャンペーン前の平均比       19.6     10.6      9.1
自店舗の列を見てください。前月比14.7%、前年同月比17.9%、キャンペーン前の平均比19.6%。どれも正解の10%より大きく、しかも比べ方によってバラバラです。
報告書にどの数字を書くかで、キャンペーンの評価が変わってしまいます。
キャンペーンをしていない店でも「効果」が出る
次に、店舗A(store_a)の列を見ます。
店舗Aはキャンペーンをしていません。効果は0のはずです。それでも前後比較では、4.5%、8.0%、10.6%。店舗Bも4.1〜9.1%です。
もし店舗Aの店長が「5月に独自の施策をした」と言えば、「10.6%の効果があった」と報告できてしまいます。
自店舗の14.7〜19.6%にも、この「キャンペーンと関係なく増えた分」が同じように混ざっています。効果がないはずのものに手法を当てて、ゼロと出るかを確かめる。この確かめ方は、第10回でプラセボテストとして本格的に扱います。
前後比較に混ざる3つのもの:トレンド・季節性・偶然
「関係なく増えた分」の正体を、効果ゼロの売上を作って確かめます。8週間の売上のうち後半4週間を「施策後」とし、施策の効果はどれもゼロにします。
以下、コードです。
import numpy as np
import matplotlib.pyplot as plt
# 日本語を表示するためのフォント(Windows・Mac・Linuxの順に探す)
plt.rcParams["font.sans-serif"] = [
"Meiryo", "Hiragino Sans", "Noto Sans CJK JP", "DejaVu Sans"]
rng = np.random.default_rng(0)
days = np.arange(56) # 8週間(56日)
after = days >= 28 # 後半4週間を「施策後」とする。施策の効果はどれもゼロ
# ① トレンド:少しずつ伸びている
trend = 100 + 0.3 * days + rng.normal(0, 3, 56)
# ② 季節性:土日に増え、施策後に連休がある
season = (100 + np.where(days % 7 >= 5, 15, 0)
+ np.where((days >= 30) & (days < 34), 40, 0)
+ rng.normal(0, 3, 56))
# ③ 偶然のゆらぎ:ゆらぐだけ
noise = 100 + rng.normal(0, 8, 56)
fig, axes = plt.subplots(3, 1, figsize=(8, 8), sharex=True, sharey=True)
patterns = [(trend, "① トレンド"),
(season, "② 季節性(土日・連休)"),
(noise, "③ 偶然のゆらぎ")]
for ax, (y, title) in zip(axes, patterns):
before_mean, after_mean = y[~after].mean(), y[after].mean()
ax.axvspan(28, 55, color="#eeeeee")
ax.plot(days, y, color="#2a78d6")
ax.hlines(before_mean, 0, 27, color="#52514e", linestyle="--")
ax.hlines(after_mean, 28, 55, color="#eb6834", linestyle="--")
rate = after_mean / before_mean - 1
ax.set_title(f"{title} 前後比較の「効果」:{rate:+.1%}", loc="left")
ax.set_ylabel("売上")
axes[-1].set_xlabel("日(灰色が施策後)")
plt.tight_layout()
plt.show()
# ③ を1,000回くり返したとき、偶然だけで前後比較の差がどこまで出るか
sims = 100 + rng.normal(0, 8, size=(1000, 56))
diffs = sims[:, after].mean(axis=1) / sims[:, ~after].mean(axis=1) - 1
low, high = np.percentile(diffs, [2.5, 97.5])
print(f"偶然だけで出る差(1,000回のうち95%が入る範囲):{low:+.1%} 〜 {high:+.1%}")
print(f"差が ±2% を超えた回数:{(abs(diffs) > 0.02).sum()} 回")
以下、実行結果です。
偶然だけで出る差(1,000回のうち95%が入る範囲):-4.2% 〜 +4.0%
差が ±2% を超えた回数:327 回
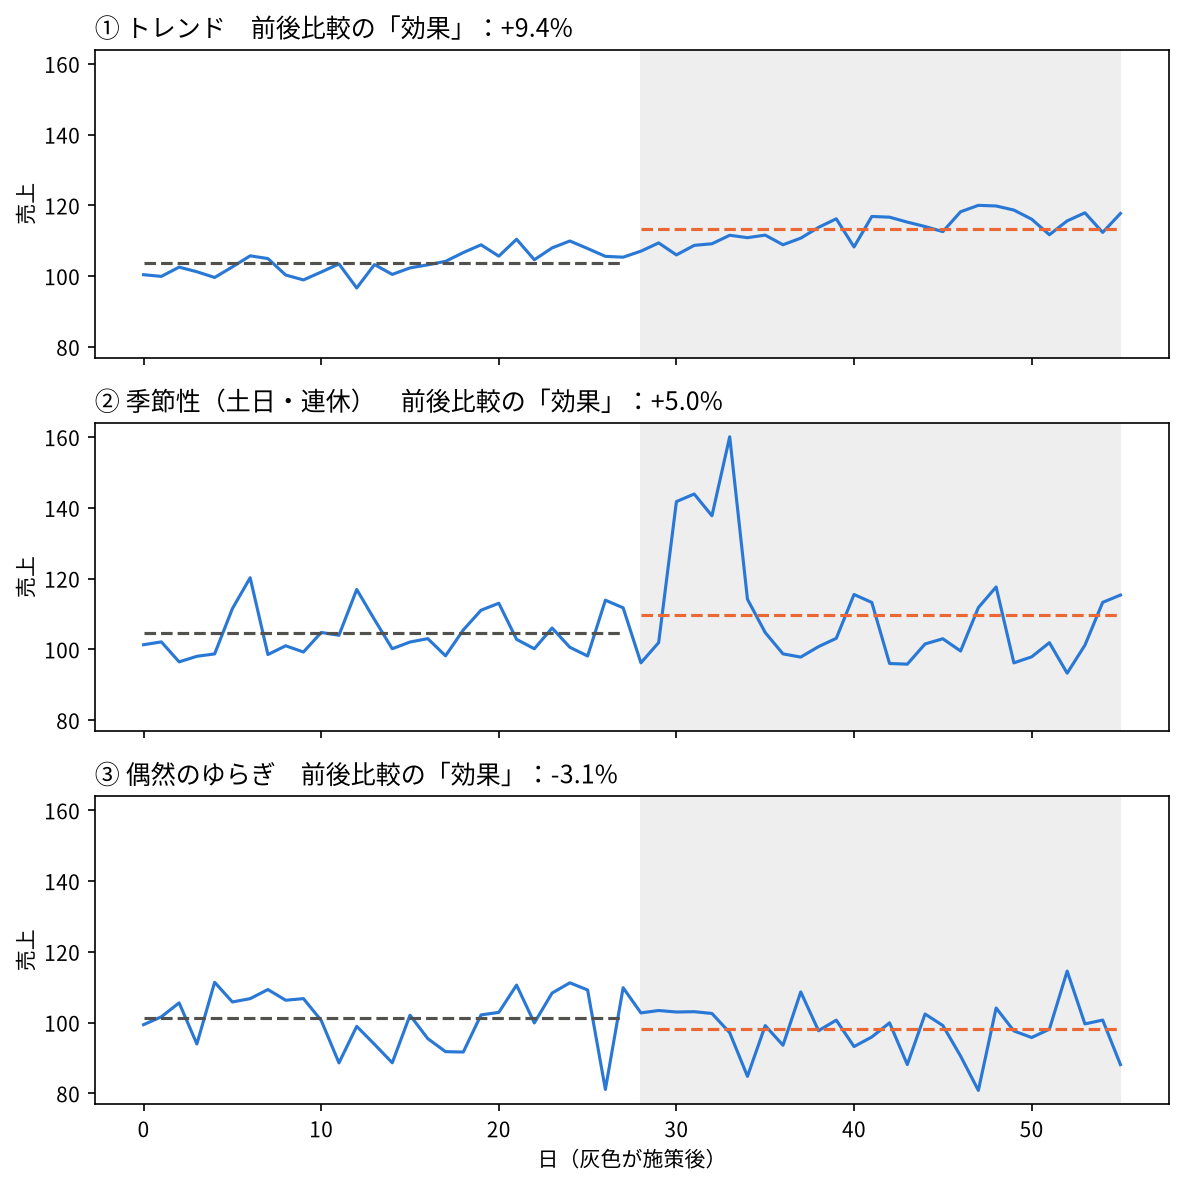
効果ゼロの売上でも前後比較が効果を示す3つのパターンです。点線は前半(グレー)と後半(オレンジ)の平均です。
どのパターンも効果はゼロなのに、前後比較は「効果」を出しました。
- トレンド:売上がもともと伸びていれば、後半が高くなる(+9.4%)
- 季節性:施策後に連休や土日が多ければ、後半が高くなる(+5.0%)。今回のデータでも、5月にはGWがあり、土日も4月より2日多い
- 偶然のゆらぎ:何もなくても、前半と後半の平均はずれる(−3.1%)。1,000回くり返すと、95%の回が−4.2%〜+4.0%に入った。±4%くらいの差は、偶然でも普通に出る
前後比較の数字は、この3つと本当の効果を足し合わせたものです。差だけを見ても、どれがどれだけ入っているかは分かりません。
本当に比べたいもの:反実仮想とは
本当に比べたいのは、「キャンペーンをした5月の自店舗」と「キャンペーンをしなかった5月の自店舗」です。同じ店の同じ5月なので、トレンドも季節性もそろっています。
効果 = キャンペーンをした5月の売上 − キャンペーンをしなかった5月の売上
ただ、後者は実際には起きていません。この「もし〜しなかったら」の世界を反実仮想(はんじつかそう、counterfactual)と呼びます。
キャンペーンをした以上、「しなかった5月」を観測することは二度とできません。同じ店の同じ期間で、「した」と「しなかった」の両方を見ることはできない。これが、施策の効果を測るときのいちばんの難しさです。
観測できないなら、予測で作るしかありません。そう考えると、前月比は「4月の売上を、キャンペーンがなかった5月の売上とみなす」という、いちばん粗い予測だと言えます。
対照店舗の伸びを借りて、反実仮想を作る
予測の手がかりになるのが、キャンペーンをしていない店舗A・Bです。GWも土日も、地域の景気も、自店舗と同じように受けています。このような比較用の系列を対照系列と呼びます。
考え方はこうです。
対照店舗が4月から5月に4.3%伸びたなら、キャンペーンがなかった自店舗も4.3%伸びていたはず
先ほどの3通りの比べ方すべてで、この方法を試します。最初のコードの続きで実行してください。
以下、コードです。
controls = ["store_a", "store_b"]  # キャンペーンをしていない対照店舗

for name, before in comparisons.items():
    # 対照店舗(2店舗の合計)が、比較前からキャンペーン期間までにどれだけ伸びたか
    growth = may[controls].sum(axis=1).mean() / before[controls].sum(axis=1).mean()
    # 反実仮想:比較前の自店舗の売上 × 対照店舗の伸び
    counterfactual = before["sales_own"].mean() * growth
    effect = may["sales_own"].mean() / counterfactual - 1
    print(f"{name}:対照店舗の伸び {growth - 1:+.1%} → "
          f"反実仮想 {counterfactual:.1f}千円 → 効果 {effect:+.1%}")
以下、実行結果です。
前月比:対照店舗の伸び +4.3% → 反実仮想 478.5千円 → 効果 +10.0%
前年同月比:対照店舗の伸び +7.1% → 反実仮想 477.8千円 → 効果 +10.2%
キャンペーン前の平均比:対照店舗の伸び +9.9% → 反実仮想 483.5千円 → 効果 +8.9%
どの比べ方でも、効果は8.9〜10.2%に収まりました。前後比較の14.7〜19.6%より、正解の10%にずっと近づいています。
前月比の場合を図にします。
以下、コードです。
before = data.loc["2026-04"]
growth = may[controls].sum(axis=1).mean() / before[controls].sum(axis=1).mean()
april = before["sales_own"].mean()          # 4月の実測
counterfactual = april * growth             # 5月の反実仮想
actual = may["sales_own"].mean()            # 5月の実測

labels = ["4月の実測", "キャンペーンが\nなくても増えた分",
          "キャンペーンの効果", "5月の実測"]
bottoms = [0, april, counterfactual, 0]
heights = [april, counterfactual - april, actual - counterfactual, actual]
colors = ["#b5b3ab", "#eb6834", "#86b6ef", "#2a78d6"]

fig, ax = plt.subplots(figsize=(8, 4.5))
bars = ax.bar(labels, heights, bottom=bottoms, color=colors, width=0.6)
ax.bar_label(bars, labels=[f"{april:.1f}", f"+{counterfactual - april:.1f}",
                           f"+{actual - counterfactual:.1f}", f"{actual:.1f}"])
ax.set_ylabel("1日あたり平均売上(千円)")
ax.set_ylim(0, 600)
plt.show()
以下、実行結果です。
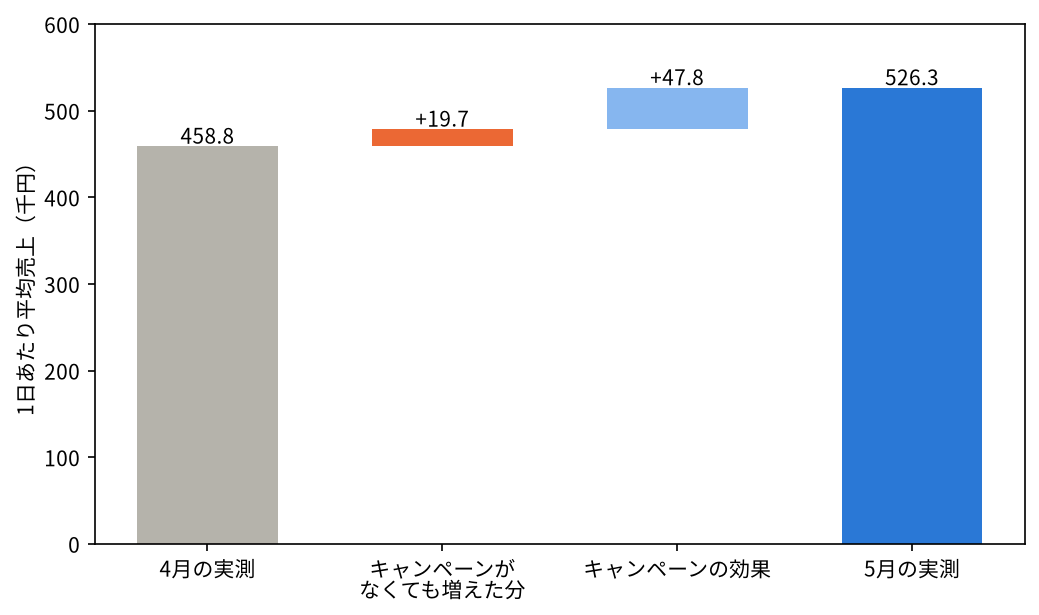
4月から5月への14.7%の増加のうち、1日あたり19.7千円(4.3%)はキャンペーンがなくても増えていた分。残りの47.8千円(10.0%)が、キャンペーンの効果です。
ありがちな失敗:前年同月比なら大丈夫だと思う
前年同月比は、季節をそろえるための定番の比べ方です。同じ5月どうしなので、GWも両方に入っています。
それでも、自店舗は17.9%、キャンペーンをしていない店舗Aでも8.0%でした。前月比より、むしろ大きくずれています。
理由は2つです。
- 1年分のトレンドがまるごと入る:比べる相手が1年前なので、その間の伸びがすべて「効果」に見える
- 曜日の並びがそろわない:2025年5月の土日は9日、2026年5月は10日
季節はそろっても、トレンドはそろいません。前年同月比を使うときも、施策をしていない店舗や指標の伸びと並べて見るのが最低限の確認です。
この簡易版で足りないもの(CausalImpactがやること)
対照店舗の伸びを借りる方法は分かりやすい反面、足りないところがあります。
| 簡易版(対照店舗の伸びを借りる) | CausalImpact | |
|---|---|---|
| 自店舗と対照店舗の関係 | 同じ割合で伸びると決めつける | 介入前期間のデータから学ぶ |
| 比べる期間 | 自分で選ぶ(選び方で結果が変わる) | 介入前期間をまるごと使う |
| 予測の細かさ | 期間の平均だけ | 日ごと |
| 誤差の幅 | 出ない | 95%区間が出る |
特に大きいのは、誤差の幅です。偶然のゆらぎだけで±4%くらいの差が出るなら、「10.0%」という1つの数字だけでは、本当に効果があったのかを判断できません。
CausalImpactは、介入前期間のデータから自店舗と対照店舗の関係を学び、日ごとの反実仮想と95%区間を出します。第0回で見た「9.6%(95%区間 8.17〜11.13%)」が、その結果です。
まとめ
今回のポイントです。
- 比べ方を変えるだけで、前後比較の「効果」は14.7%にも19.6%にもなる。正解は10%
- キャンペーンをしていない店舗Aでも、前後比較では4.5〜10.6%の「効果」が出る
- 前後比較には、トレンド・季節性・偶然のゆらぎが混ざる。偶然だけでも±4%くらいの差は出る
- 本当に比べたいのは「キャンペーンをしなかった5月」、つまり反実仮想。観測できないので予測で作る
- 対照店舗の伸びを借りるだけで、推定は10.0%に近づく。これを精密にし、誤差の幅まで出すのがCausalImpact
よくある質問
Q. 反実仮想とは何ですか?
「もし施策をしなかったら、どうなっていたか」という、実際には起きなかった状態のことです。
英語ではcounterfactualといいます。施策の効果は、実際の結果と反実仮想の差として考えます。反実仮想は観測できないので、予測で作ります。
Q. 前後比較は、まったく使ってはいけないのですか?
変化をざっくりつかむ入口としては使えます。ただし、その差をそのまま「効果」として報告するのは危険です。
最低限、施策をしていない店舗や指標の、同じ期間の伸びと並べてください。この記事の簡易版のように対照の伸びを差し引く考え方は、「差の差分法(DID)」と呼ばれる手法に近いものです。
Q. 偶然のゆらぎは、どのくらい見込めばよいですか?
データによって違います。この記事の例では、効果ゼロでも前後比較で±4%くらいの差が出ました。
自分のデータでどのくらいかを数字で示してくれるのが、CausalImpactの95%区間です。読み方は第5回で扱います。
