この連載で使っている campaign_sales.csv は、答えが分かっているデータです。
5月の自店舗の売上には、キャンペーンの効果として、ちょうど10%を上乗せしてあります。だから第0回では、CausalImpactの推定9.6%が正解に近いと確かめられました。
今回は、このデータを作るコードを、部品ごとに見ていきます。
結論を先に3行で書きます。
- 練習用データは「ふだんの動き(トレンド・曜日・GW)」「ゆらぎ」「キャンペーンの効果」を組み合わせて作ります。部品ごとに作るので、どこに何が入っているかが全部分かります。
- 効果を仕込む前の売上を残しておけば、それが本当の反実仮想です。5月の平均は478.5千円で、第0回のCausalImpactの予測(480.25千円)はこれに近い値でした。
- 乱数のシードを42に固定すれば、誰が作っても、配布しているCSVとまったく同じデータになります。
この記事を読み終えると、次のことができるようになります。
- 答えの分かるデータで手法を確かめる、という考え方を説明できる
- トレンド・曜日・祝日・ゆらぎを組み合わせて、時系列データを作れる
- 効果の大きさや期間を変えた練習用データを、自分で作れる
- 配布しているCSVと同じデータを作れたかを、確かめられる
この回も、CausalImpactのライブラリは使いません。前回(第2回)で作った仮想環境でも、普段のPython環境でも動きます。
なぜ、答えの分かるデータを自分で作るのか
実際の売上データでは、キャンペーンの本当の効果は誰にも分かりません。CausalImpactが「効果は9.6%」と出しても、それが合っているのか確かめようがないのです。
そこで、効果の大きさを自分で決めて仕込んだデータを作ります。手法がその大きさを言い当てられるかを見れば、手法の使い方や設定が正しいかを確かめられます。
この連載でも、後半の回で「対照店舗が施策の影響を受けたら」「施策がなかった期間に当てたら」といった条件を、このデータを少し変えて試します。今回のコードは、その土台になります。
データは、次の4つの部品から作ります。
| 部品 | 中身 |
|---|---|
| ① 曜日・祝日の効果 | 平日1.0倍、土日1.15倍、ゴールデンウィーク(GW)1.5倍 |
| ② 対照店舗A・B | 基準の売上 × 年率の伸び × ①、にゆらぎを足す |
| ③ 自店舗(キャンペーンなし) | 店舗A・Bと連動する売上に、ゆらぎを足す |
| ④ キャンペーンの効果 | 2026年5月だけ、③を1.10倍にする |
部品①:日付と、曜日・祝日の効果を作る
まず、2025年1月1日から2026年5月31日までの日付を作り、日ごとに「曜日・祝日でどれだけ売上が増えるか」の倍率を決めます。
以下、コードです。
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)  # 乱数のシードを42に固定する

dates = pd.date_range("2025-01-01", "2026-05-31", freq="D")
n = len(dates)    # 日数(516日)
t = np.arange(n)  # 0, 1, 2, … と数える通し番号(トレンドに使う)

# 曜日・祝日の効果:平日1.0、土日1.15、ゴールデンウィーク1.5
gw_days = pd.to_datetime([
    "2025-04-29", "2025-05-03", "2025-05-04", "2025-05-05", "2025-05-06",
    "2026-04-29", "2026-05-03", "2026-05-04", "2026-05-05", "2026-05-06",
])
day_effect = np.where(dates.dayofweek >= 5, 1.15, 1.0)
day_effect = np.where(dates.isin(gw_days), 1.5, day_effect)

# 2026年のGWの前後を表示して確かめる
check = pd.Series(day_effect, index=dates)
print(check["2026-04-27":"2026-05-07"])
以下、実行結果です。
2026-04-27    1.00
2026-04-28    1.00
2026-04-29    1.50
2026-04-30    1.00
2026-05-01    1.00
2026-05-02    1.15
2026-05-03    1.50
2026-05-04    1.50
2026-05-05    1.50
2026-05-06    1.50
2026-05-07    1.00
Freq: D, dtype: float64
4月29日(昭和の日)と5月3〜6日が1.5倍、土曜日の5月2日が1.15倍になっています。
1行目の np.random.default_rng(42) は、乱数(でたらめな数)を作る道具を用意する命令です。かっこの中の42をシード(乱数の種)と呼び、これを固定すると、何度実行しても同じ乱数が出てきます。
部品②:対照店舗A・Bの売上を作る
次に、キャンペーンをしていない店舗A・Bの売上を作ります。考え方は「ふだんの動き + ゆらぎ」です。
以下、コードです。
trend_a = 1 + 0.08 * t / 365  # 店舗A:年8%の伸び
trend_b = 1 + 0.05 * t / 365  # 店舗B:年5%の伸び

# ふだんの動き(基準の売上 × 伸び × 曜日・祝日の効果)+ ゆらぎ
store_a = 300 * trend_a * day_effect + rng.normal(0, 15, n)
store_b = 250 * trend_b * day_effect + rng.normal(0, 12, n)

# 最初の月(2025年1月)と最後の月(2026年5月)の平均を比べる
print(
    f"店舗A:{store_a[:31].mean():.1f}千円 "
    f"→ {store_a[-31:].mean():.1f}千円"
)
print(
    f"店舗B:{store_b[:31].mean():.1f}千円 "
    f"→ {store_b[-31:].mean():.1f}千円"
)
以下、実行結果です。
店舗A:313.9千円 → 366.1千円
店舗B:259.7千円 → 294.7千円
店舗Aを例に、式を読み解きます。
| 式の部分 | 意味 |
|---|---|
300 |
基準の売上(1日300千円) |
trend_a |
1年で8%ずつ伸びる倍率(1年後に1.08倍) |
day_effect |
部品①の、曜日・祝日の倍率 |
rng.normal(0, 15, n) |
平均0、ばらつき(標準偏差)15のゆらぎを、n日分作る |
最初の月から最後の月にかけて、店舗Aは313.9千円から366.1千円に増えています。伸びのトレンドに加えて、最後の月(2026年5月)にはGWが入っているためです。
部品③:自店舗の売上を、対照店舗と連動させて作る
自店舗の売上は、店舗A・Bの売上に連動するように作ります。ここではまだキャンペーンの効果を入れないので、名前を no_campaign(キャンペーンがなかった場合の売上)にしておきます。
以下、コードです。
# キャンペーンがなかった場合の自店舗の売上:対照店舗と連動して動く + ゆらぎ
no_campaign = (
    40
    + 0.8 * store_a
    + 0.5 * store_b
    + rng.normal(0, 12, n)
)

print(
    f"店舗Aとの相関:{np.corrcoef(no_campaign, store_a)[0, 1]:.3f}"
)
print(
    f"店舗Bとの相関:{np.corrcoef(no_campaign, store_b)[0, 1]:.3f}"
)
以下、実行結果です。
店舗Aとの相関:0.932
店舗Bとの相関:0.884
相関は、2つの数字の動きがどれだけそろっているかを表す値で、1に近いほど同じように動きます。自店舗は店舗Aと0.932、店舗Bと0.884で、強く連動しています。
この連動が、CausalImpactにとっての手がかりです。店舗A・Bの5月の売上から「キャンペーンがなかった自店舗の5月」を予測できるのは、ふだんから一緒に動いているからです。
部品④:キャンペーンの効果を仕込む
最後に、キャンペーン期間(2026年5月)だけ、売上を1.10倍にします。これが正解の効果(+10%)です。
以下、コードです。
# キャンペーン期間(2026年5月)だけ、売上を1.10倍にする(これが正解の効果)
campaign = (dates >= "2026-05-01") & (dates <= "2026-05-31")
sales_own = np.where(
    campaign,
    no_campaign * 1.10,
    no_campaign
)

print(
    "5月の平均(キャンペーンなし):"
    f"{no_campaign[campaign].mean():.1f}千円"
)
print(
    "5月の平均(キャンペーンあり):"
    f"{sales_own[campaign].mean():.1f}千円"
)
以下、実行結果です。
5月の平均(キャンペーンなし):478.5千円
5月の平均(キャンペーンあり):526.3千円
ここが今回のいちばん大事なところです。no_campaign は、キャンペーンがなかった場合の本当の売上、つまり本当の反実仮想です。実際のデータでは決して見られないものが、練習用データでは手元にあります。
5月の平均は478.5千円でした。第0回でCausalImpactが予測した「キャンペーンがなかった場合の5月」は480.25千円(95%区間 472.92〜487.13千円)で、正解を区間の中に捉えていました。
第1回の簡易版(対照店舗の伸びを借りる方法)も、前月比では478.5千円とほぼ同じ値でした。ただし簡易版は、比べる期間によって効果が8.9〜10.2%まで動いたことも思い出してください。
CSVに保存して、配布版と同じか確かめる
部品をひとつの表にまとめ、CSVファイルに保存します。続けて、配布している campaign_sales.csv と中身が同じかを確かめます。
以下、コードです。
df = pd.DataFrame(
    {
        "sales_own": sales_own,
        "store_a": store_a,
        "store_b": store_b
    },
    index=dates,
).round(1)
df.index.name = "date"
df.to_csv(
    "campaign_sales_my.csv",
    encoding="utf-8-sig"
)
print(df.head())

# 配布しているCSV(同じフォルダに置いておく)と同じかを確かめる
mine = pd.read_csv(
    "campaign_sales_my.csv",
    index_col="date",
    parse_dates=True
)
original = pd.read_csv(
    "campaign_sales.csv",
    index_col="date",
    parse_dates=True
)
print("配布版と同じか:", mine.equals(original))
以下、実行結果です。
            sales_own  store_a  store_b
date
2025-01-01      406.7    304.6    258.0
2025-01-02      394.3    284.5    241.8
2025-01-03      413.2    311.4    260.8
2025-01-04      481.0    359.3    307.2
2025-01-05      442.7    316.0    276.0
配布版と同じか: True
最後の行が True なら、配布版とまったく同じデータを作れています。
ファイルどうしを直接比べず、読み込んでから中身を比べているのには理由があります。WindowsとMac・Linuxでは、保存したときの改行の記号が違います。中身が同じでも、ファイルとしては一致しないことがあるのです。
グラフで見る:GWの山と、仕込んだ効果
作ったデータをグラフにします。上は全期間の3店舗、下は2026年3〜5月の自店舗と正解の反実仮想です。
以下、コードです。
import matplotlib.pyplot as plt
import matplotlib_fontja

start = pd.Timestamp("2026-05-01")  # キャンペーン開始日
fig, axes = plt.subplots(2, 1, figsize=(9, 8))

# 上:全期間の3店舗の売上
ax = axes[0]
ax.plot(
    df.index,
    df["store_b"],
    color="#b5b3ab",
    linewidth=1,
    label="店舗B(対照)"
)
ax.plot(
    df.index,
    df["store_a"],
    color="#52514e",
    linewidth=1,
    label="店舗A(対照)"
)
ax.plot(
    df.index,
    df["sales_own"],
    color="#2a78d6",
    linewidth=1,
    label="自店舗"
)
ax.axvspan(
    start,
    pd.Timestamp("2026-05-31"),
    color="#eeeeee"
)
ax.set_title(
    "3店舗の日次売上(灰色の帯がキャンペーン期間)",
    loc="left"
)
ax.set_ylabel("売上(千円)")
ax.legend(loc="upper left")

# 下:2026年3〜5月の自店舗と、正解の反実仮想
ax = axes[1]
p = df.index >= "2026-03-01"
ax.plot(
    df.index[p],
    df["sales_own"][p],
    color="#2a78d6",
    label="実測値(キャンペーンあり)"
)
ax.plot(
    df.index[p],
    no_campaign[p],
    color="#eb6834",
    linestyle="--",
    label="正解の反実仮想(キャンペーンなし)"
)
ax.fill_between(
    df.index[campaign],
    no_campaign[campaign],
    sales_own[campaign],
    color="#86b6ef",
    alpha=0.5,
    label="仕込んだ効果(+10%)"
)
ax.axvline(
    start,
    color="#898781",
    linestyle=":"
)
ax.set_title(
    "自店舗の売上と、正解の反実仮想(2026年3〜5月)",
    loc="left"
)
ax.set_ylabel("売上(千円)")
ax.legend(loc="upper left")

plt.tight_layout()
plt.show()
以下、実行結果です。
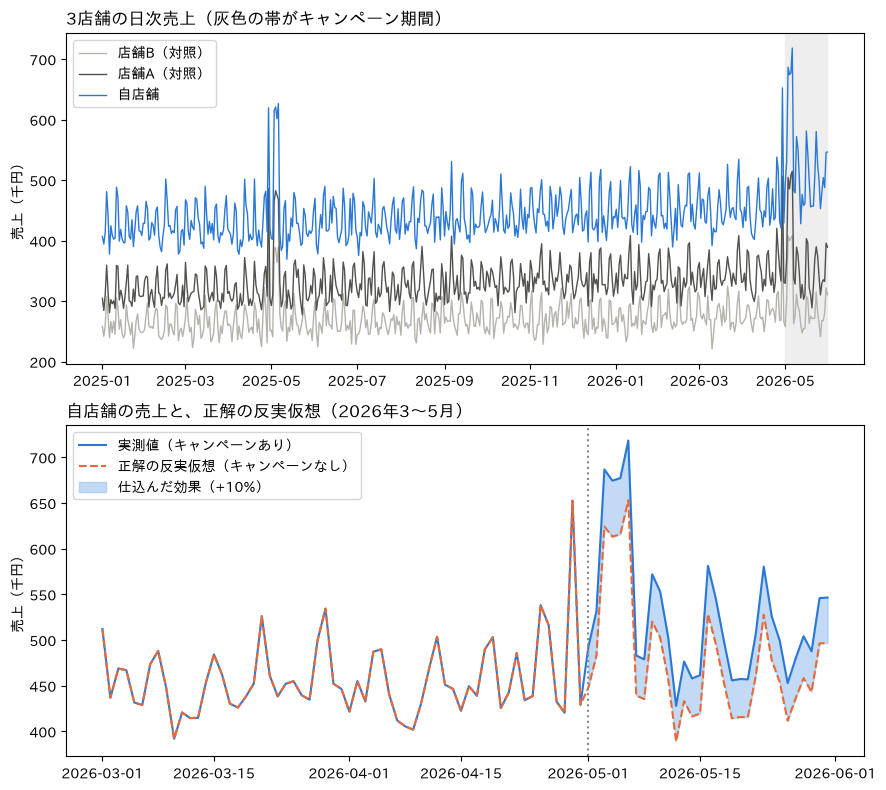
上のグラフを見ると、5月の自店舗の売上が高いのは分かります。ただし、それがGWのせいなのか、キャンペーンのせいなのかは、見た目だけでは分かりません。2025年5月にも、同じくらいのGWの山があるからです。
下のグラフは、正解を知っているからこそ描ける図です。CausalImpactが予測しようとしているのは、このオレンジの点線です。
ありがちな失敗:乱数のシードを固定し忘れる
シードを指定しないと、実行するたびに違う乱数が出てきます。試してみます。
以下、コードです。
# シードを指定しないと、実行するたびに違う乱数になる
print(
    "シードなし:",
    np.random.default_rng().normal(0, 15, 3).round(1)
)
print(
    "シードなし:",
    np.random.default_rng().normal(0, 15, 3).round(1)
)

# シードを42にすると、何度実行しても同じ乱数になる
print(
    "シード42 :",
    np.random.default_rng(42).normal(0, 15, 3).round(1)
)
print(
    "シード42 :",
    np.random.default_rng(42).normal(0, 15, 3).round(1)
)
以下、実行結果です。
シードなし: [-12.8   4.6 -25. ]
シードなし: [ -6.4 -24.5  -4.8]
シード42 : [  4.6 -15.6  11.3]
シード42 : [  4.6 -15.6  11.3]
シードなしの2行は、実行するたびに数字が変わります(皆さんが実行すると、上とは別の数字になります)。シード42の2行は、何度実行しても同じです。
シード42の最初の数字4.6は、店舗Aの1日目のゆらぎと同じです。店舗Aの2025年1月1日の売上304.6千円は、基準の300千円にこの4.6を足したものです。
シードを固定し忘れると、記事と違うデータができて、結果を見比べられなくなります。自分で練習用データを作るときも、シードは必ず決めておきましょう。
なお、第0回で使った tf.random.set_seed(42) は、CausalImpactの推定で使う乱数を固定するものです。今回の default_rng(42) は、データを作るときの乱数を固定するもので、役割が違います。
よくある質問
Q. 効果の大きさや期間を変えるには、どこを直せばよいですか?
部品④の2行です。1.10 を 1.05 にすれば効果は5%、日付を変えればキャンペーン期間が変わります。効果を小さくするほど、ゆらぎに埋もれて見つけにくくなります。
Q. なぜ自店舗の売上を、対照店舗から作るのですか?
実際の店舗でも、近くの店舗とは天気や地域の行事、景気の影響を同じように受けて、一緒に動くことが多いからです。対照店舗と連動しない売上だと、対照店舗は予測の手がかりになりません。どんな対照店舗が役に立つかは第8回で扱います。
Q. NumPyやpandasのバージョンが違っても、同じデータになりますか?
この記事では、Python 3.11(NumPy 2.4、pandas 2.2と3.0)と、Python 3.13(NumPy 2.5、pandas 2.2)の組み合わせで、配布版と同じデータになることを確かめています。
まとめ
今回のポイントです。
- 答えの分かるデータを自分で作れば、手法が効果を言い当てられるかを確かめられる
- 練習用データは、曜日・祝日の効果、伸びのトレンド、ゆらぎ、キャンペーンの効果を組み合わせて作る
- 自店舗の売上を対照店舗と連動させておくことが、CausalImpactの予測の手がかりになる
- 効果を仕込む前の売上が、本当の反実仮想。5月の平均は478.5千円で、第0回の予測480.25千円の区間に入っていた
- 乱数のシードを固定すれば、誰が作っても同じデータになる
