- 問題
- 答え
- 解説
幅 の列は予測期間が先になるほど大きくなっています。この「幅」は何を表しており、なぜ広がっていくのでしょうか?
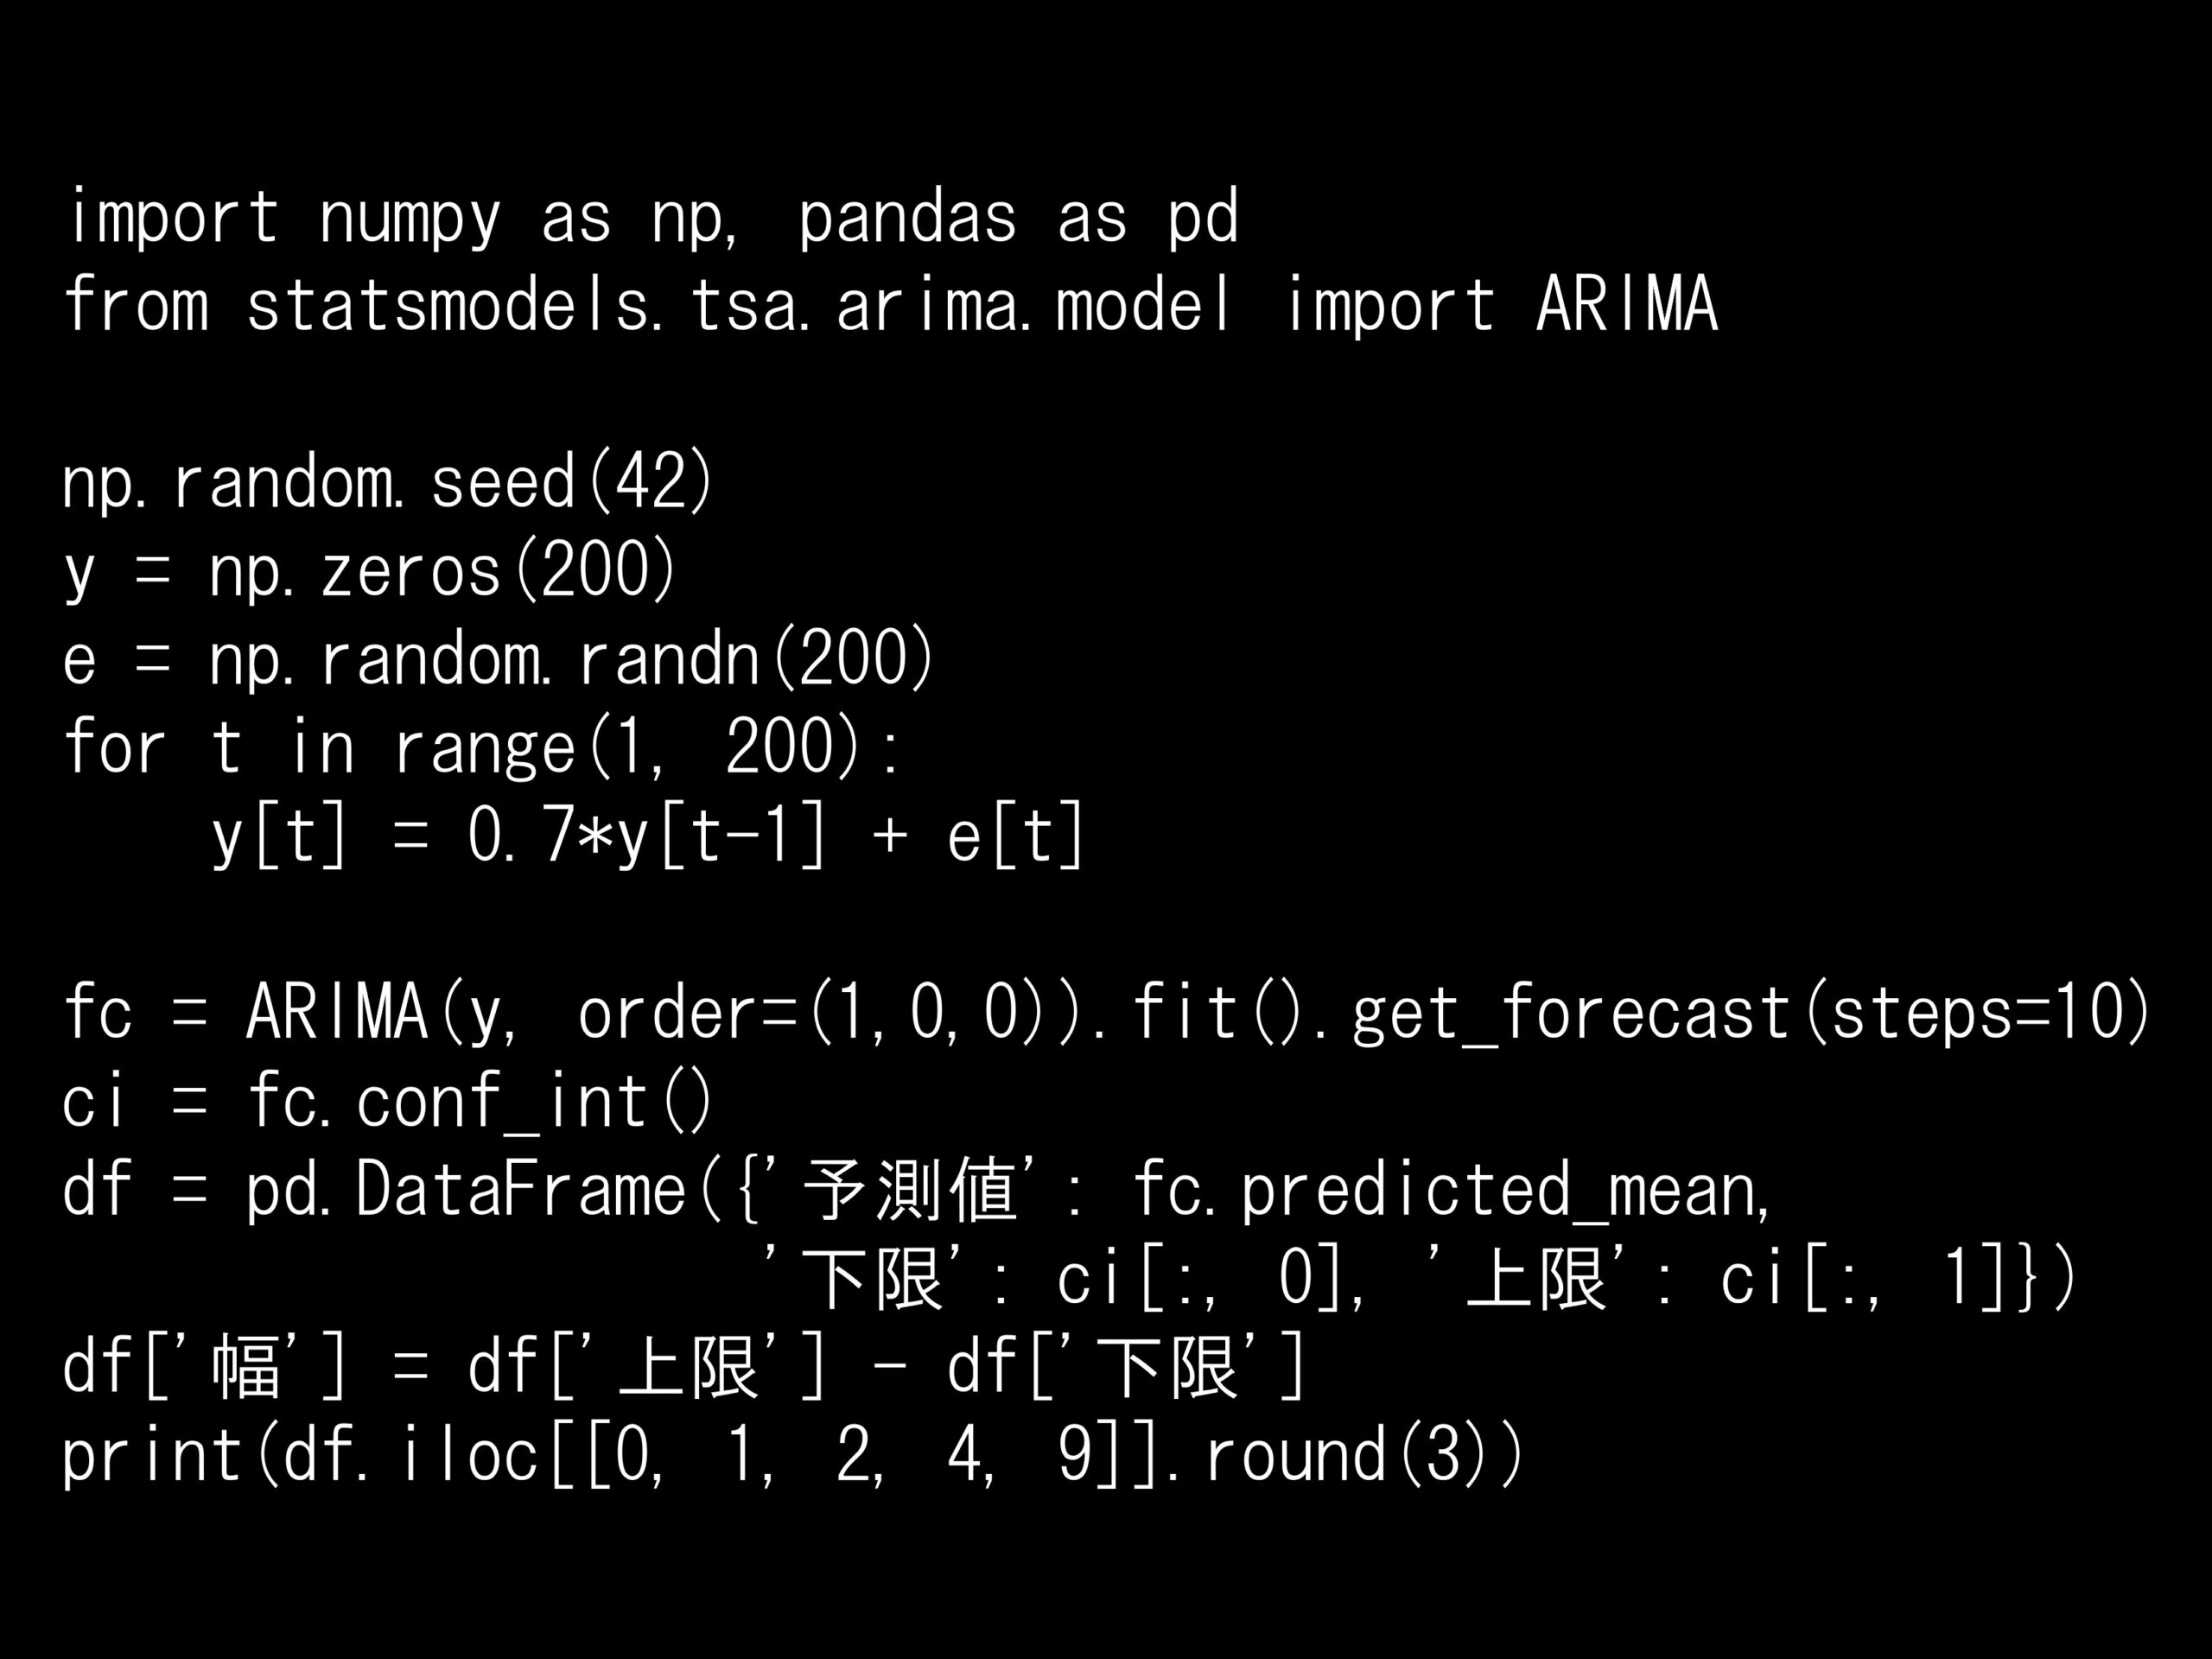
Python コード:
import numpy as np, pandas as pd
from statsmodels.tsa.arima.model import ARIMA

np.random.seed(42)
y = np.zeros(200)
e = np.random.randn(200)
for t in range(1, 200):
    y[t] = 0.7*y[t-1] + e[t]

fc = ARIMA(y, order=(1,0,0)).fit().get_forecast(steps=10)
ci = fc.conf_int()
df = pd.DataFrame({'予測値': fc.predicted_mean,
                   '下限': ci[:, 0], '上限': ci[:, 1]})
df['幅'] = df['上限'] - df['下限']
print(df.iloc[[0, 1, 2, 4, 9]].round(3))
回答の選択肢:
(A) 予測値の変動幅であり、遠い将来ほど予測値そのものが大きく振れるため広がる
(B) 予測の不確実性の範囲であり、遠い将来ほど誤差が累積して不確実性が増すため広がる
(C) モデルの学習誤差であり、予測期間が長いほど学習データとの乖離が増すため広がる
(D) 季節変動の振幅であり、周期の後半に向かって振幅が大きくなるため広がる
     予測値     下限     上限      幅
0   -0.923   -2.738    0.891    3.629
1   -0.644   -2.803    1.514    4.317
2   -0.464   -2.750    1.822    4.572
4   -0.273   -2.631    2.084    4.716
9   -0.153   -2.526    2.219    4.745
正解: (B)
下限と上限は95%予測区間の境界であり、幅はその広さです。予測区間とは「実際の値がこの範囲に入る確率が95%である」と見込まれる範囲で、予測の不確実性を表しています。1期先の幅は3.629ですが、10期先では4.745まで広がっています。これは、遠い将来を予測するほど、途中の各時点で発生するノイズの影響が積み重なり、予測値からの乖離が大きくなりうるためです。なお、予測値そのものは-0.923から-0.153へと0に収束していくだけで、大きく振れているわけではありません。
回答の選択肢:
(A) 予測値の変動幅であり、遠い将来ほど予測値そのものが大きく振れるため広がる
(B) 予測の不確実性の範囲であり、遠い将来ほど誤差が累積して不確実性が増すため広がる
(C) モデルの学習誤差であり、予測期間が長いほど学習データとの乖離が増すため広がる
(D) 季節変動の振幅であり、周期の後半に向かって振幅が大きくなるため広がる
- コードの解説
-
このコードは、AR(1)モデルで10期先までの予測を行い、点予測とともに予測区間を出力しています。
import numpy as np, pandas as pd
from statsmodels.tsa.arima.model import ARIMA

np.random.seed(42)
y = np.zeros(200)
e = np.random.randn(200)
for t in range(1, 200):
    y[t] = 0.7*y[t-1] + e[t]

fc = ARIMA(y, order=(1,0,0)).fit().get_forecast(steps=10)
ci = fc.conf_int()
df = pd.DataFrame({'予測値': fc.predicted_mean,
                   '下限': ci[:, 0], '上限': ci[:, 1]})
df['幅'] = df['上限'] - df['下限']
print(df.iloc[[0, 1, 2, 4, 9]].round(3))
詳しく説明します。
ライブラリのインポート
numpy:数値計算を行うためのライブラリ。ここでは乱数生成と系列の生成に使用しています。pandas:予測結果を表形式で整理するために使用しています。statsmodels.tsa.arima.model.ARIMA:ARIMAモデルを構築するクラスです。
データの生成
y[t] = 0.7*y[t-1] + e[t]:AR(1)過程です。現在の値が1期前の値の0.7倍にノイズを加えたもので決まります。係数0.7は1未満なので定常過程です。
予測の実行
ARIMA(y, order=(1,0,0)).fit():AR(1)モデルを推定します。.get_forecast(steps=10):10期先までの予測結果オブジェクトを取得します。forecast()が点予測のみを返すのに対し、get_forecast()は予測区間などの付加情報も含みます。fc.predicted_mean:点予測(予測値の期待値)です。fc.conf_int():予測区間の下限と上限を2列の配列で返します。デフォルトは95%区間です。
出力の整理
df['幅'] = df['上限'] - df['下限']:予測区間の幅を計算しています。df.iloc[[0, 1, 2, 4, 9]]:1期先、2期先、3期先、5期先、10期先の5行だけを抜き出して表示しています。
- 選択肢の解説
-
(A) 予測値の変動幅であり、遠い将来ほど予測値そのものが大きく振れるため広がる → ×
出力の予測値列を見ると、-0.923から-0.153へと単調に0へ近づいているだけで、振れているわけではありません。幅が広がるのは予測値の振れではなく、予測値の「周り」の不確実性が増すためです。(B) 予測の不確実性の範囲であり、遠い将来ほど誤差が累積して不確実性が増すため広がる → ○
正解です。1期先の予測には1期分のノイズしか影響しませんが、2期先には2期分、3期先には3期分のノイズが影響します。この累積により、遠い将来ほど「実際の値がどこに落ちるか」の見通しが悪くなり、予測区間が広がります。(C) モデルの学習誤差であり、予測期間が長いほど学習データとの乖離が増すため広がる → ×
学習誤差(残差)は学習データに対するモデルの当てはまりの悪さであり、将来の予測期間とは無関係です。予測区間はモデルの誤差分散をもとに計算されますが、その値自体は予測期間によって変わりません。変わるのは、その誤差が何期分累積するかです。(D) 季節変動の振幅であり、周期の後半に向かって振幅が大きくなるため広がる → ×
今回のデータはAR(1)過程であり、季節成分は含まれていません。また、季節変動の振幅は周期内で増減を繰り返すものであり、単調に広がり続ける予測区間の挙動とは異なります。 - 点予測と区間予測
-
時系列予測の出力には、2つの種類があります。
点予測(point forecast)
「将来の値はおそらくこのくらい」という1つの数値です。今回の出力では予測値列がこれにあたります。統計的には、将来の値の条件付き期待値として計算されます。区間予測(interval forecast)
「将来の値はこの範囲に入るだろう」という区間です。今回の出力では下限と上限がこれにあたります。点予測を中心に、不確実性の大きさに応じた幅を持ちます。点予測だけを報告すると、「その予測がどのくらい信頼できるか」が伝わりません。例えば「来月の売上は1,000万円」という点予測があったとき、予測区間が「950〜1,050万円」なのか「500〜1,500万円」なのかで、意思決定はまったく異なります。前者なら計画を立てやすく、後者なら幅広いシナリオへの備えが必要です。
予測区間は、点予測に「どこまで信じてよいか」という情報を添えるものであり、実務では点予測と併せて必ず確認すべき出力です。
- 予測区間が広がる仕組み
-
AR(1)モデルを例に、予測区間の幅が広がる仕組みを数式で確認します。
モデルは次の形です。
$$
y_t = \phi \, y_{t-1} + \varepsilon_t, \quad \varepsilon_t \sim N(0, \sigma^2)
$$現時点Tからh期先の予測値は、期待値を取ることで求まります。
$$
\hat{y}_{T+h} = \phi^h \, y_T
$$一方、h期先の予測誤差の分散は、途中の各期で発生するノイズの影響を合計したものになります。
$$
hが増えるほど項が増えるため、分散は単調に増加します。予測区間の幅はこの分散の平方根に比例するので、遠い将来ほど区間は広がります。
\text{Var}(e_{T+h}) = \sigma^2 \left( 1 + \phi^2 + \phi^4 + \cdots + \phi^{2(h-1)} \right)
$$今回のデータでは\phi = 0.7であり、この和はh \to \inftyで次の値に収束します。
$$
\frac{\sigma^2}{1 – \phi^2} = \frac{\sigma^2}{1 – 0.49} \approx 1.96 \, \sigma^2
$$出力で幅が4.7付近で頭打ちになっているのは、この収束を反映しています。
- 定常過程と非定常過程での違い
-
予測区間の広がり方は、データが定常か非定常かで大きく異なります。
定常過程(今回のAR(1)など)
予測誤差の分散は増加するものの、ある値に収束します。これは、定常過程では遠い将来の値が過去の値の影響を受けなくなり、予測が「系列の無条件分布」に落ち着くためです。出力で幅が4.7付近で安定しているのはこのためです。非定常過程(ランダムウォークなど)
予測誤差の分散は収束せず、予測期間に比例して増え続けます。ランダムウォークy_t = y_{t-1} + \varepsilon_tの場合、h期先の予測誤差分散はh \sigma^2となり、区間の幅は\sqrt{h}に比例して広がります。この違いは実務上重要です。非定常なデータ(株価、累積売上など)に対する長期予測は、予測区間がきわめて広くなるため、点予測にほとんど意味がなくなることがあります。予測区間を見ることで、「このデータで何期先までなら実用的な予測ができるか」を判断できます。
- 実務での注意点
-
予測区間は「モデルが正しい」前提での区間
予測区間は、推定したモデルが真のデータ生成過程を正しく捉えているという仮定のもとで計算されます。モデルの構造が間違っていたり、将来に構造変化が起きたりした場合、実際の値は予測区間を外れる可能性が高くなります。予測区間は「モデル内の不確実性」を表すものであり、「モデル自体の不確実性」は含んでいません。パラメータの推定誤差は通常含まれない
statsmodelsのデフォルトの予測区間は、推定したパラメータを既知として扱います。実際にはパラメータ自体に推定誤差があるため、真の不確実性はやや大きくなります。サンプルサイズが小さい場合は特に注意が必要です。信頼水準は変更できる
conf_int(alpha=0.2)のように指定すると80%予測区間が得られます。95%区間は広すぎて実用性に欠ける場合、80%区間の方が意思決定に使いやすいことがあります。目的に応じて適切な水準を選びます。正規性の仮定
標準的な予測区間は誤差の正規分布を仮定しています。誤差分布が歪んでいたり裾が厚かったりする場合は、区間の実際のカバー率が名目上の水準からずれます。ブートストラップによる予測区間の構築など、分布を仮定しない方法もあります。予測区間の妥当性を検証する
過去のデータで予測区間を作り、実際の値がどの程度の割合で区間に入ったかを確認します。95%区間なら約95%が入るはずで、大きく下回る場合は区間が狭すぎる(不確実性を過小評価している)ことを示唆します。