- 問題
- 答え
- 解説
dayofweek:月曜=0〜日曜=6)で回帰しています。出力の C(d)[T.5] の係数(29.5)は何を意味しますか?
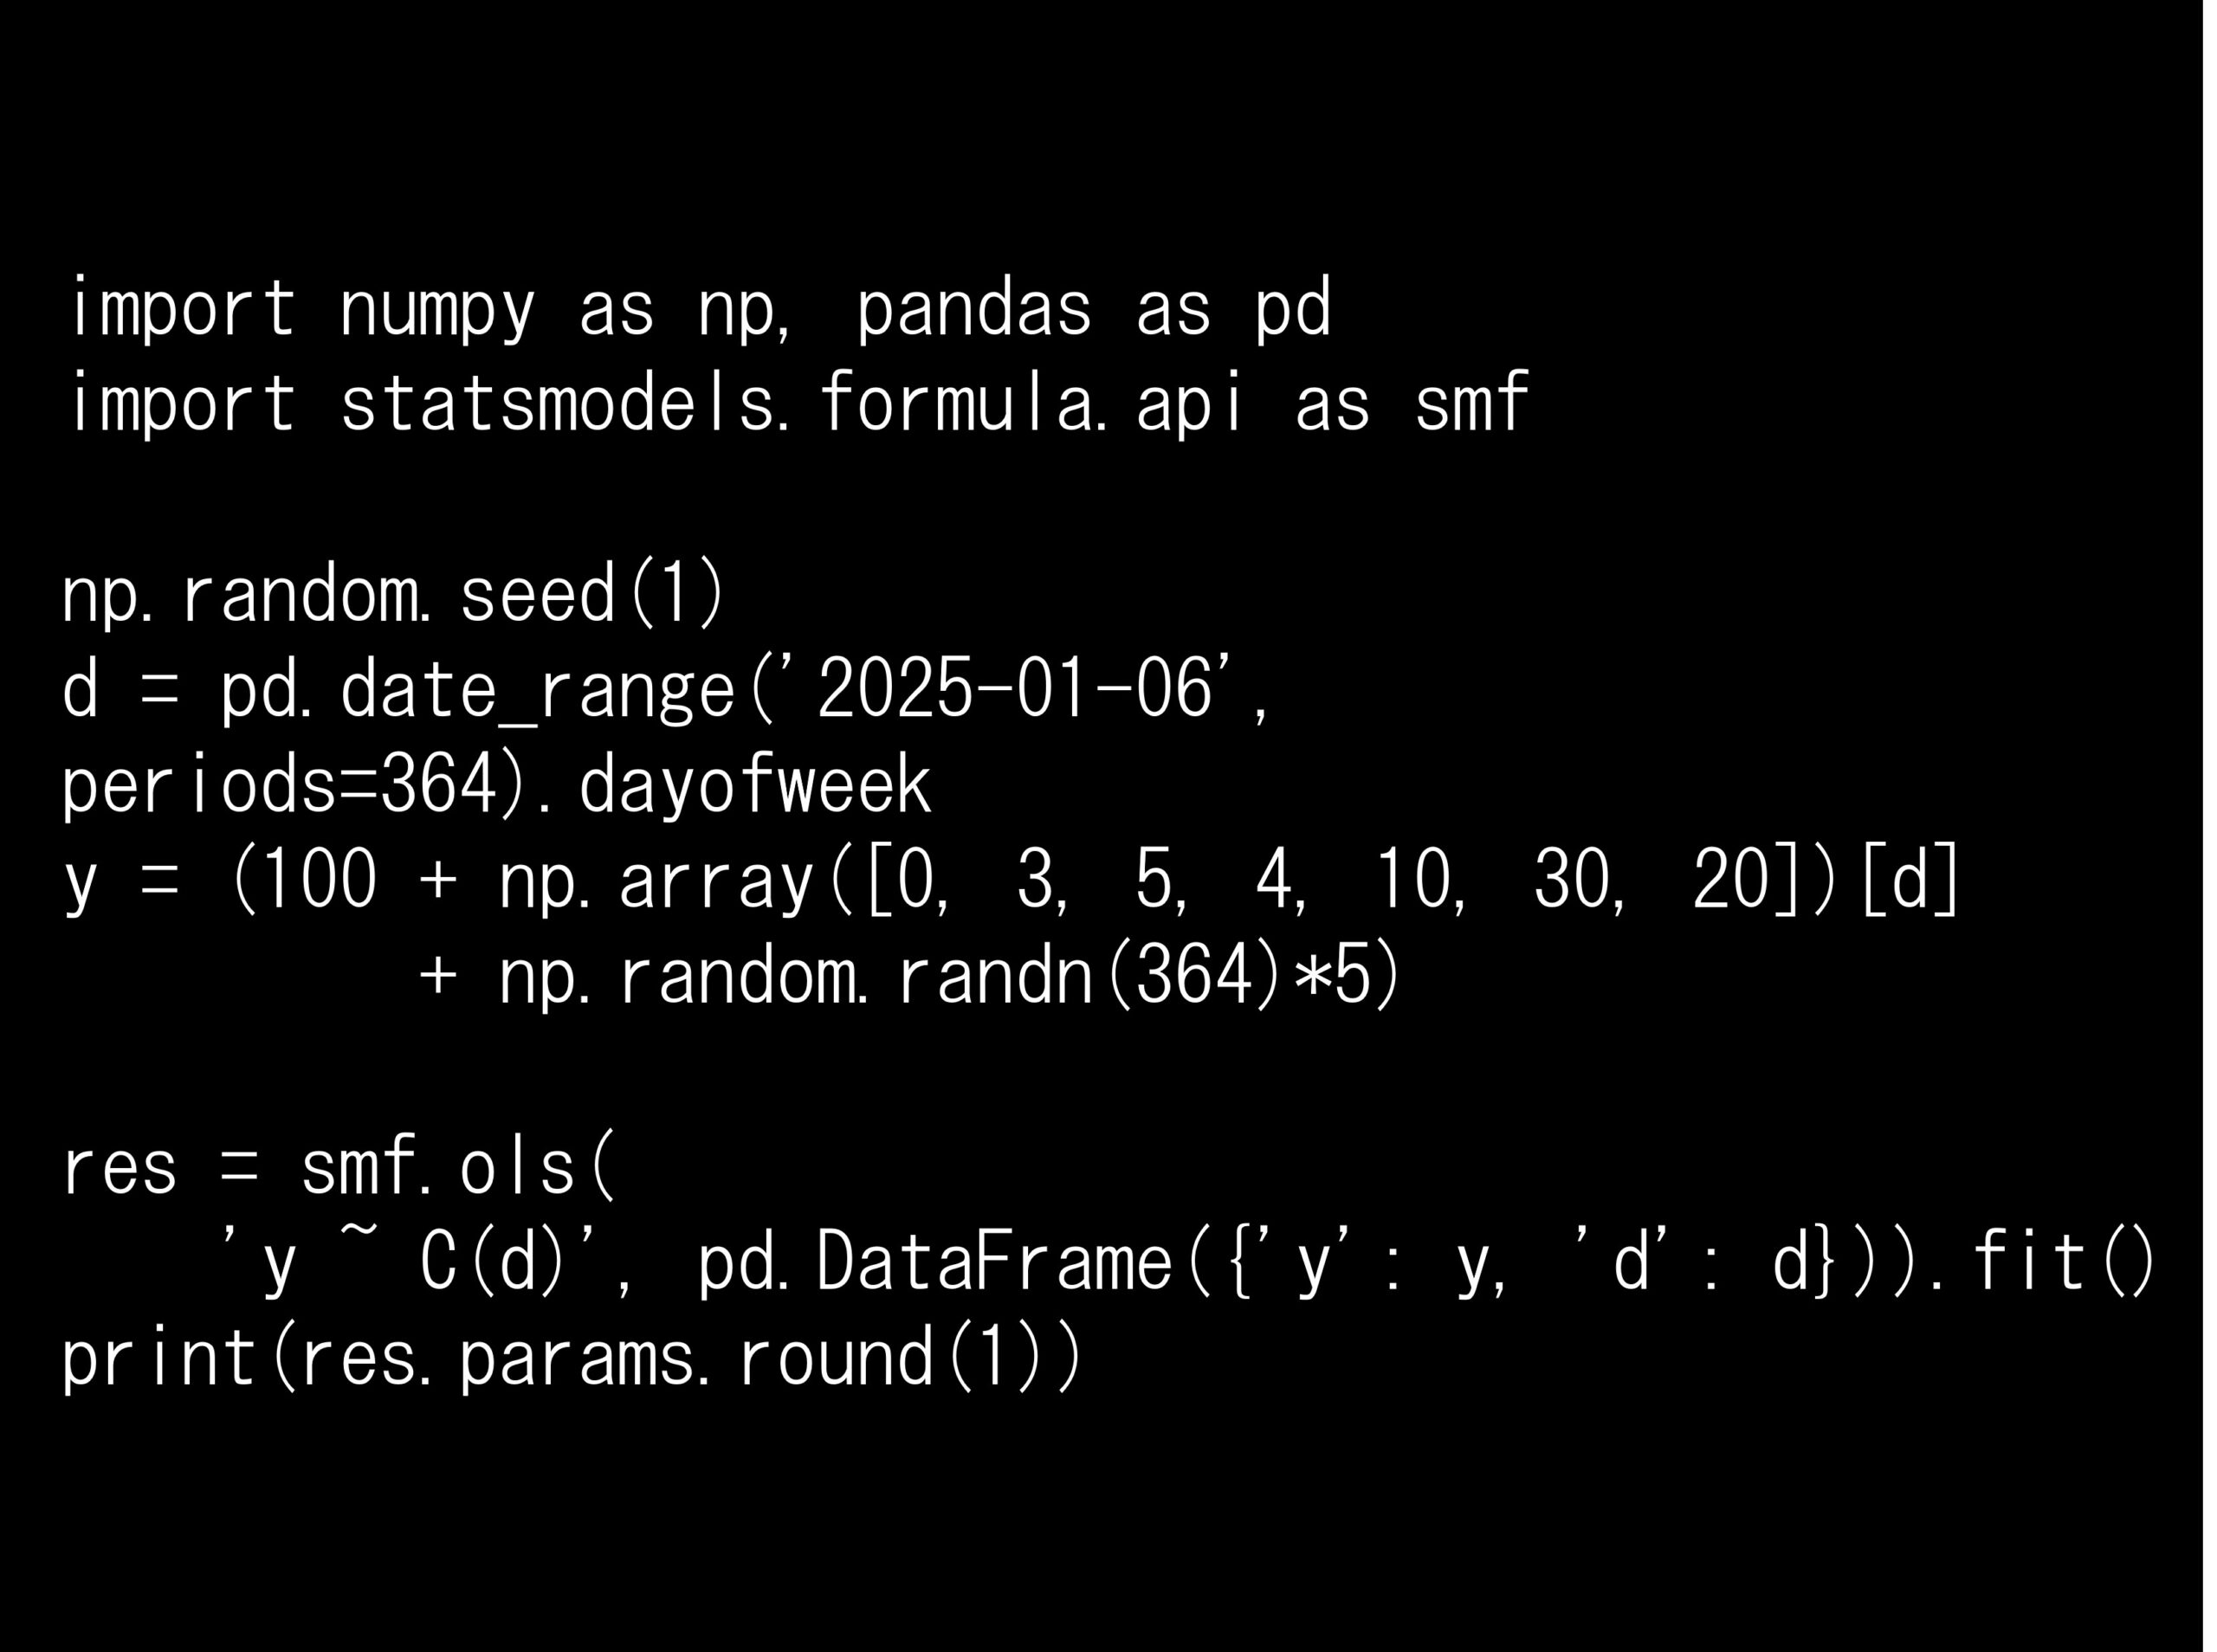
Python コード:
import numpy as np, pandas as pd
import statsmodels.formula.api as smf

np.random.seed(1)
d = pd.date_range('2025-01-06', periods=364).dayofweek
y = (100 + np.array([0, 3, 5, 4, 10, 30, 20])[d]
         + np.random.randn(364)*5)

res = smf.ols(
    'y ~ C(d)', pd.DataFrame({'y': y, 'd': d})).fit()
print(res.params.round(1))
回答の選択肢:
(A) 土曜日は月曜日より、平均して約29.5大きい
(B) 土曜日は全曜日の平均より、約29.5大きい
(C) 土曜日の平均値は約29.5である
(D) 土曜日は前日(金曜日)より、平均して約29.5大きい
Intercept    100.5
C(d)[T.1]      3.1
C(d)[T.2]      3.8
C(d)[T.3]      4.2
C(d)[T.4]      9.5
C(d)[T.5]     29.5
C(d)[T.6]     20.0
dtype: float64
正解: (A)
C(d)は、変数dをカテゴリ変数として扱い、曜日ダミー変数に変換する指定です。7つの曜日すべてにダミー変数を作ると定数項と重複するため、1つの曜日を基準カテゴリとして除外します。statsmodelsの既定では最小の値(d=0、月曜日)が基準になり、出力にC(d)[T.0]がないのはこのためです。
このとき、Intercept(100.5)は基準である月曜日の平均値、各曜日の係数は月曜日との差を表します。C(d)[T.5]の29.5は「土曜日は月曜日より平均して29.5大きい」という意味です。データ生成時に設定した差30をよく再現しています。
回答の選択肢:
(A) 土曜日は月曜日より、平均して約29.5大きい
(B) 土曜日は全曜日の平均より、約29.5大きい
(C) 土曜日の平均値は約29.5である
(D) 土曜日は前日(金曜日)より、平均して約29.5大きい
- コードの解説
-
このコードは、曜日によって水準が異なる日次データを作り、曜日ダミー変数による回帰で曜日効果を推定しています。
import numpy as np, pandas as pd
import statsmodels.formula.api as smf

np.random.seed(1)
d = pd.date_range('2025-01-06', periods=364).dayofweek
y = (100 + np.array([0, 3, 5, 4, 10, 30, 20])[d]
         + np.random.randn(364)*5)

res = smf.ols(
    'y ~ C(d)', pd.DataFrame({'y': y, 'd': d})).fit()
print(res.params.round(1))
詳しく説明します。
ライブラリのインポート
numpy:数値計算を行うためのライブラリです。ここでは乱数生成と配列操作に使用しています。pandas:日付の生成とデータフレームの作成に使用しています。statsmodels.formula.api:R風の数式(フォーミュラ)でモデルを指定できるインターフェースです。
データの生成
pd.date_range('2025-01-06', periods=364):2025年1月6日(月曜日)から364日分(ちょうど52週)の日付を作ります。各曜日のデータ数が52ずつそろいます。.dayofweek:曜日を整数で取り出します。月曜日が0、日曜日が6です。np.array([0, 3, 5, 4, 10, 30, 20])[d]:曜日ごとの効果です。月曜日を0として、金曜日は+10、土曜日は+30、日曜日は+20としています。小売店の来客数のように、週末に多くなるデータをイメージしてください。np.random.randn(364)*5:標準偏差5のノイズです。
モデルの推定
'y ~ C(d)':yを目的変数、dを説明変数とするモデルです。C()で囲むと、dは数値ではなくカテゴリ変数として扱われ、自動的にダミー変数に変換されます。.fit():最小二乗法で係数を推定します。res.params:推定された係数です。
出力の読み方
Intercept(100.5):基準カテゴリである月曜日の平均値です。C(d)[T.1]〜C(d)[T.6]:火曜日〜日曜日のそれぞれが、月曜日より平均してどれだけ大きいかを表します。T.はTreatment(処置)コーディングであることを示しています。
- 選択肢の解説
-
(A) 土曜日は月曜日より、平均して約29.5大きい → ○
正解です。既定のTreatmentコーディングでは、各ダミー変数の係数は基準カテゴリ(月曜日)との差を表します。(B) 土曜日は全曜日の平均より、約29.5大きい → ×
全曜日の平均との差を表すのは、Sum(効果)コーディングを使った場合です。今回のデータで計算すると、全体平均は110.6、土曜日の平均は130.1で、差は約19.5です。(C) 土曜日の平均値は約29.5である → ×
土曜日の平均値は、定数項と係数の和100.5+29.5=130.0(丸め前の値では130.1)です。係数は平均値そのものではなく、基準との差です。(D) 土曜日は前日(金曜日)より、平均して約29.5大きい → ×
係数はすべて月曜日との差であり、隣り合う曜日との差ではありません。土曜日と金曜日の差は29.5-9.5=20.0です。 - ダミー変数の罠と基準カテゴリ
-
なぜ1つの曜日を除外するのか
7つの曜日すべてにダミー変数を作ると、どの日も必ずどれか1つの曜日に該当するため、7つのダミー変数の和は常に1になります。これは定数項(すべて1の列)と完全に一致してしまいます。$$
D_{\text{月}} + D_{\text{火}} + \cdots + D_{\text{日}} = 1
$$この状態を完全な多重共線性といい、係数を一意に推定できなくなります。これをダミー変数の罠と呼びます。実際、定数項+7つのダミー変数の計8列の行列を作ると、ランクは7にしかなりません。そこで、1つのカテゴリを基準として除外します。
モデル式
月曜日を基準とした今回のモデルは、次のように表されます。$$
D_{k,t}は時点tが曜日kのとき1、それ以外は0をとるダミー変数です。月曜日はすべてのダミーが0なのでy_t=\beta_0+\varepsilon_tとなり、\beta_0が月曜日の平均になります。土曜日はD_5=1なので\beta_0+\beta_5が土曜日の平均であり、\beta_5は月曜日との差になります。
y_t = \beta_0 + \beta_1 D_{1,t} + \beta_2 D_{2,t} + \cdots + \beta_6 D_{6,t} + \varepsilon_t
$$基準カテゴリの変更
基準はTreatment(reference=...)で変更できます。たとえば土曜日を基準にすると、各係数は土曜日との差になります。smf.ols('y ~ C(d, Treatment(5))', pd.DataFrame({'y': y, 'd': d})).fit()この場合、
Interceptは土曜日の平均130.1となり、月曜日の係数は-29.5になります。どの曜日を基準にしても予測値は変わらず、係数の「読み方」だけが変わります。 - コーディング方式による係数の違い
-
同じデータでも、ダミー変数の作り方(コーディング方式)によって係数の意味が変わります。
Treatmentコーディング(既定) Sumコーディング 指定方法 C(d)C(d, Sum)定数項の意味 基準カテゴリの平均(100.5) 全カテゴリの平均(110.6) 係数の意味 基準カテゴリとの差 全体平均との差 土曜日の係数 29.5 19.5 出力されない曜日 基準カテゴリ(月曜日) 最後のカテゴリ(日曜日) Sumコーディングでは、係数の合計が0になるように制約されます。出力されない日曜日の効果は、他の6つの係数の和の符号を反転させたもの(+10.0)として求められます。
「どの曜日が平均的な日より多いか少ないか」を見たい場合はSumコーディング、「特定の曜日(例:平日の代表)と比べてどうか」を見たい場合はTreatmentコーディングが読みやすいでしょう。
- 曜日効果の他のモデル化方法
-
曜日効果は、ダミー変数による回帰以外にもさまざまな方法で扱えます。
方法 考え方 特徴 曜日ダミー変数 曜日ごとに固定の水準差を推定 解釈が明快。他の説明変数と組み合わせやすい 周期7の季節差分 1週間前との差を取って曜日パターンを除去 曜日効果を推定するのではなく取り除く SARIMA(m=7) 周期7の季節ARMA構造でモデル化 曜日パターンが時間とともに変化する場合にも対応 フーリエ項 sin・cosの組み合わせで周期パターンを表現 少ないパラメータで滑らかな周期を表せる STL分解(period=7) 季節成分として曜日パターンを分離 可視化・季節調整に向く ダミー変数は、SARIMAXの外生変数(
exog)や機械学習モデルの特徴量としてもそのまま利用できます。 - 実務での注意点
-
祝日は曜日とは別に扱う
祝日は平日であっても週末と似た動きをすることが多く、曜日ダミーだけでは捉えられません。祝日フラグを別のダミー変数として追加するのが一般的です。年末年始やお盆などの特殊期間も、同様にフラグ化を検討しましょう。トレンドや年間の季節性と同時に扱う
実際のデータには、曜日効果に加えてトレンドや月ごとの季節性が含まれることがほとんどです。曜日ダミーだけで回帰すると、それらの影響が誤差や係数に混入します。y ~ C(d) + t + C(month)のように、他の要因も同時にモデルに入れて推定しましょう。加法的か乗法的か
今回は曜日効果を「+30」のような足し算(加法的)で表しました。しかし売上などでは「土曜日は月曜日の1.3倍」のように、水準に比例して効果が大きくなる(乗法的な)ことがよくあります。その場合は、目的変数を対数変換してから回帰すると、係数を「月曜日比で約何%増」と解釈できます。曜日パターンが変化していないか
ダミー変数による回帰は、曜日効果が全期間で一定であると仮定しています。営業時間の変更や販売チャネルの変化などで曜日パターンが変わった場合は、期間を分けて推定する、あるいは時間とともに変化する季節性を扱えるモデルを検討しましょう。残差の自己相関
時系列データの回帰では、残差に自己相関が残りやすく、係数の標準誤差やp値が過小評価されることがあります。残差のACFやLjung-Box検定で確認し、必要に応じてSARIMAXなどで誤差の構造もモデル化しましょう。
