- 問題
- 答え
- 解説
b0 のちょうど半分ずつ増えています。この予測方法の説明として正しいものはどれですか?
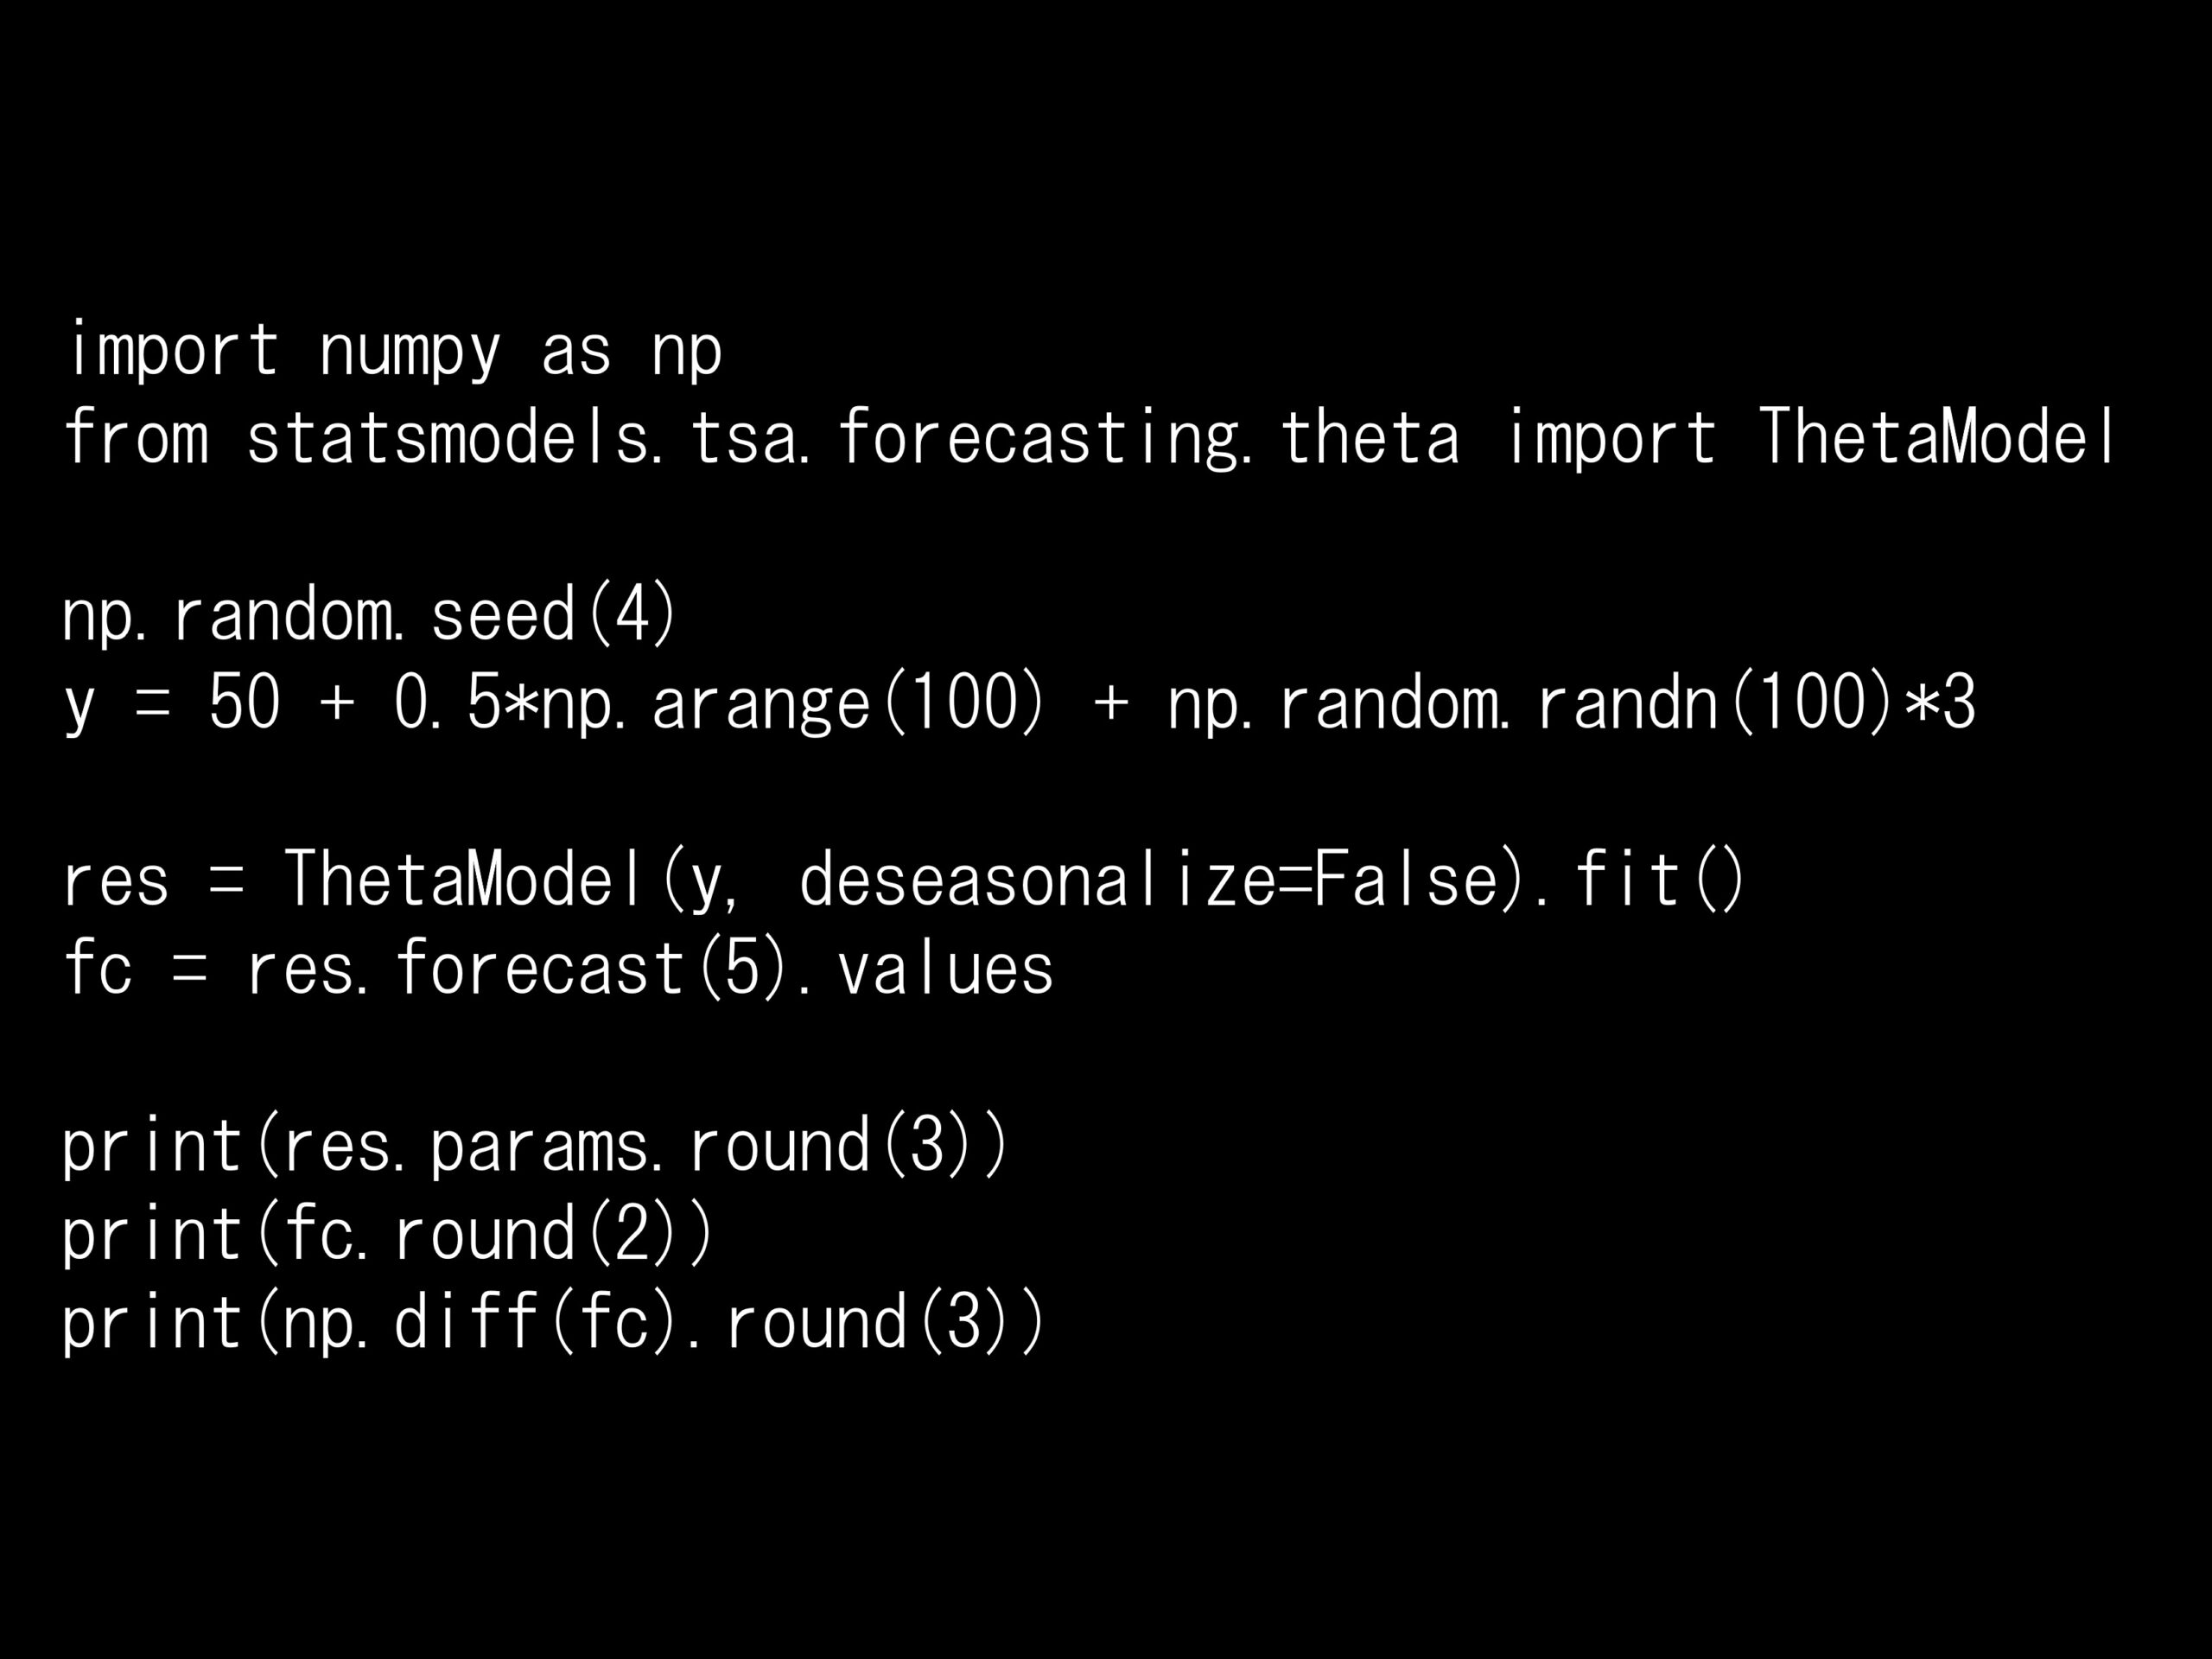
Python コード:
import numpy as np
from statsmodels.tsa.forecasting.theta import ThetaModel

np.random.seed(4)
y = 50 + 0.5*np.arange(100) + np.random.randn(100)*3

res = ThetaModel(y, deseasonalize=False).fit()
fc = res.forecast(5).values
print(res.params.round(3))
print(fc.round(2))
print(np.diff(fc).round(3))
回答の選択肢:
(A) 回帰直線の傾きを、そのまま将来に延長している
(B) 直近の値に、過去の平均的な変化量(最初と最後の値を結んだ傾き)を足し続けている
(C) 回帰直線のトレンドと単純指数平滑の予測を、同じ重みで組み合わせている
(D) 水準と傾きをそれぞれ指数平滑で逐次更新し、最新の傾きで延長している
b0       0.500
alpha    0.406
dtype: float64
[ 99.    99.25  99.5   99.75 100.  ]
[0.25 0.25 0.25 0.25]
正解: (C)
ThetaModelはTheta法を実装したクラスです。Theta法は、元の系列を「長期のトレンドを表す直線(θ=0の線)」と「短期の変動を強調した線(θ=2の線)」に分け、前者は直線をそのまま延長し、後者は単純指数平滑(SES)で予測して、2つの予測を等しい重み(1/2ずつ)で平均します。
b0(0.500)は回帰直線の傾き、alpha(0.406)はSESの平滑化係数です。SESの予測は将来にわたって一定(水平)なので、予測値の傾きは「直線の傾きb0 × 1/2 + SESの傾き0 × 1/2」=0.25になります。予測値が1期あたりb0のちょうど半分ずつ増えるのは、このためです。
回答の選択肢:
(A) 回帰直線の傾きを、そのまま将来に延長している
(B) 直近の値に、過去の平均的な変化量(最初と最後の値を結んだ傾き)を足し続けている
(C) 回帰直線のトレンドと単純指数平滑の予測を、同じ重みで組み合わせている
(D) 水準と傾きをそれぞれ指数平滑で逐次更新し、最新の傾きで延長している
- コードの解説
-
このコードは、トレンドを持つ時系列データにTheta法を当てはめ、5期先までの予測値とその増加幅を確認しています。
import numpy as np
from statsmodels.tsa.forecasting.theta import ThetaModel

np.random.seed(4)
y = 50 + 0.5*np.arange(100) + np.random.randn(100)*3

res = ThetaModel(y, deseasonalize=False).fit()
fc = res.forecast(5).values
print(res.params.round(3))
print(fc.round(2))
print(np.diff(fc).round(3))
詳しく説明します。
ライブラリのインポート
numpy:数値計算を行うためのライブラリです。ここでは乱数生成と差分の計算に使用しています。statsmodels.tsa.forecasting.theta.ThetaModel:Theta法による予測モデルを実装したクラスです。
データの生成
50 + 0.5*np.arange(100):切片50、傾き0.5の線形トレンドです。np.random.randn(100)*3:標準偏差3のノイズです。トレンドの周りを不規則に変動するデータになります。
モデルの推定と予測
ThetaModel(y, deseasonalize=False):季節調整を行わない設定でモデルを定義します。デフォルト(deseasonalize=True)では季節性の検定と季節調整が行われ、周期(period)の指定が必要になります。今回のデータには季節性がないため、無効にしています。.fit():回帰直線の傾きb0とSESの平滑化係数alphaを推定します。res.forecast(5):5期先までの予測値を計算します。引数thetaは省略しており、デフォルトのθ=2が使われます。np.diff(fc):予測値の1期あたりの増加幅を計算しています。
出力の読み方
b0(0.500):時点0, 1, …, 99に対して当てはめた回帰直線の傾きです。真の傾き0.5と一致しています。alpha(0.406):SESの平滑化係数です。- 予測値の増加幅(0.25):
b0のちょうど半分です。
- 選択肢の解説
-
(A) 回帰直線の傾きを、そのまま将来に延長している → ×
回帰直線の延長であれば、予測値は1期あたりb0(0.500)ずつ増えるはずです。Theta法では回帰直線のトレンドは予測の半分にしか寄与しないため、増加幅は0.25になります。(B) 直近の値に、過去の平均的な変化量(最初と最後の値を結んだ傾き)を足し続けている → ×
これはドリフト法です。今回のデータでドリフトを計算すると(y_{100}-y_1)/99 \approx 0.507で、増加幅は約0.5になります。後述のとおりTheta法は「ドリフト付きSES」と等価ですが、そのドリフトはb0の半分であり、ドリフト法とは異なります。(C) 回帰直線のトレンドと単純指数平滑の予測を、同じ重みで組み合わせている → ○
正解です。θ=0の線(回帰直線)の延長と、θ=2の線のSES予測を1/2ずつ平均するのが、標準的なTheta法です。(D) 水準と傾きをそれぞれ指数平滑で逐次更新し、最新の傾きで延長している → ×
これはHoltの線形トレンド法です。同じデータにHolt法を当てはめると、予測の増加幅は0.5になります。Holt法では傾き自体を指数平滑で推定しますが、Theta法の傾きは回帰直線から固定的に決まり、その半分が使われます。 - Theta法の仕組み(θ線とは)
-
Theta法は、2000年にAssimakopoulosとNikolopoulosが提案した手法です。予測コンペティション「M3」で最高水準の精度を示し、シンプルながら強力なベンチマーク手法として知られるようになりました。
θ線(Theta line)
元の系列y_tの2階差分(曲がり具合)を\theta倍した系列を「θ線」と呼びます。$$
\Delta^2 Z_t(\theta) = \theta \, \Delta^2 y_t
$$- θ=0の線:曲がり具合が0になるため、直線になります。これはy_tに当てはめた回帰直線(長期トレンド)そのものです。
- θ=2の線:曲がり具合が2倍に強調され、短期的な変動が大きくなります。
θ=0の線とθ=2の線を平均すると、元の系列に戻ります。
予測の手順
- θ=0の線(回帰直線)を将来に延長する
- θ=2の線をSESで予測する(将来にわたって水平)
- 2つの予測を1/2ずつ平均する
「長期のトレンドは直線で、短期の水準は指数平滑で捉える」という役割分担が、Theta法の考え方です。
- θの値と予測の傾き
-
forecast()の引数thetaを変えると、トレンドの重みが変わります。statsmodelsでは、トレンドの重みを(\theta-1)/\theta、SESの重みを1/\thetaとして組み合わせます。予測式は次のとおりです。$$
\tilde{y}_{T+h|T}はSESの予測値です。今回のデータで
\hat{y}_{T+h|T} = \tilde{y}_{T+h|T} + \frac{\theta-1}{\theta}\, b_0 \left[h – 1 + \frac{1}{\alpha} – \frac{(1-\alpha)^T}{\alpha}\right] $$thetaを変えて予測の増加幅を比較すると、次のようになります。for th in [1, 2, 3, 10]: print(th, np.diff(res.forecast(5, theta=th)).round(3))θ トレンドの重み 増加幅 解釈 1 0 0.000 SESのみ(水平な予測) 2 1/2 0.250 標準的なTheta法 3 2/3 0.333 トレンドを強めに反映 10 9/10 0.450 回帰直線の傾きに近づく θを大きくするほど、予測の傾きは回帰直線の傾き
b0に近づきます。「ドリフト付きSES」との等価性
HyndmanとBillah(2003)は、標準的なTheta法(θ=2)が「ドリフトb_0/2を持つSES」と等価であることを示しました。一見複雑な「θ線の分解と合成」は、結局のところ「SESに回帰直線の傾きの半分を足す」ことと同じです。他の手法との比較
同じデータに対する予測の増加幅は次のとおりです。手法 傾きの決め方 増加幅 回帰直線の延長 全期間の回帰直線 0.500 ドリフト法 最初と最後の値を結んだ傾き 0.507 Holt法 指数平滑で逐次更新 0.500 Theta法(θ=2) 回帰直線の傾きの半分 0.250 - なぜトレンドを半分にするのか
-
トレンドを半分に抑えるのは、一見すると予測を過小にするように思えます。しかし実務の予測では、これが精度向上に寄与することが多いとされています。
トレンドのダンピング(減衰)効果
過去のトレンドが将来もそのまま続くとは限りません。成長はいずれ鈍化し、市場は飽和します。トレンドをそのまま延長する予測は、長期になるほど外れたときの誤差が大きくなります。Theta法は、トレンドを半分に抑えることで、この「トレンドの過信」を防いでいます。減衰トレンド法(Damped trend)との共通点
Holt法にトレンドの減衰を加えた減衰トレンド法も、同じ発想の手法です。M3などの予測コンペティションでは、トレンドを控えめに扱う手法が安定して好成績を収めています。予測の組み合わせとしての側面
Theta法は「回帰直線の予測」と「SESの予測」の単純平均でもあります。異なる性質の予測を平均すると、個々の予測の誤差が打ち消し合い、精度が安定しやすくなります。 - 実務での注意点
-
季節性のあるデータでは季節調整が前提
Theta法自体は季節性を扱えません。ThetaModelのデフォルト(deseasonalize=True)では、季節性の検定を行い、有意であれば古典的な季節分解で季節調整してから予測し、最後に季節成分を戻します。そのため、周期periodを指定するか、頻度(freq)付きのDatetimeIndexを持つpandasの系列を渡す必要があります。ベンチマークとして使う
Theta法は計算が軽く、パラメータも少ないため、複雑なモデル(ARIMAや機械学習)を評価する際の比較対象として有用です。複雑なモデルがTheta法に勝てないのであれば、そのモデルの複雑さは正当化されません。構造変化に弱い
トレンドの傾きb0は全期間の回帰直線から求めるため、途中でトレンドが変化した系列では、古い期間の傾きに引きずられます。構造変化がある場合は、変化後の期間に絞って当てはめることを検討しましょう。θの選び方
θ=2が標準ですが、データによってはθを調整したほうが精度が上がる場合があります。時系列交差検証で複数のθを比較する、あるいはθ自体を最適化する「Optimized Theta法」を用いる方法があります。
