「ChatGPTに聞けば答えが返ってくる」という段階から、「AIが自分で調べ、ツールを動かし、結果を見て、やり直す」という段階へ。生成AIの話題は、ここ1〜2年で明らかに後者へ移っています。
本記事では、2026年に公開された A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents(arXiv:2601.12538)を、簡単に解説します。
先に結論(3行)
1. この論文は、LLMを「受け身の文章生成器」ではなく「計画し、行動し、学ぶエージェント」として捉え直す Agentic Reasoning(エージェント的推論) という考え方を提案し、約800件の文献を1枚の地図に整理したものです。
2. 地図の軸は「3つの層(基礎・自己進化・集合)」×「2つの最適化モード(In-context/Post-training)」。この6マスに既存研究を配置しています。
3. 新しい実験結果を示す論文ではなく、分野の全体像と設計指針を得るためのロードマップです。業務でAIエージェントを検討する人にとっては「何から手をつけ、何を当面見送るか」を判断する物差しになります。
この論文の基本情報
| 項目 | 内容 |
|---|---|
| タイトル | A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents |
| 著者 | Zhining Liu、Tianxin Wei、Ting-Wei Li ほか計29名(筆頭3名は同等貢献)。責任著者は Jingrui He、Hanghang Tong(イリノイ大学アーバナ・シャンペーン校) |
| 所属 | イリノイ大学アーバナ・シャンペーン校を中心に、Meta、Amazon、Google DeepMind、UCSD、Yale が参加 |
| 公開 | arXiv:2601.12538。本記事は v2(2026年9月20日付)に基づく |
| 対象期間 | 2025年までの研究を整理 |
| 付属資料 | GitHub の文献リスト「Awesome-Agentic-Reasoning」 |
分量は本文約70ページ、参考文献は約800件。サーベイ(survey)とは、ある分野の既存研究を網羅的に集めて分類・整理する論文のことで、新しい手法の提案や実験が主役ではありません。その代わり「この分野には何があり、何が未解決か」を短時間で把握できます。
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。本文を読んでいて引っかかったら戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| LLM | 大規模言語モデル。ChatGPT や Claude などの基盤となる、文章を生成するAIモデル |
| エージェント(AIエージェント) | 目標を与えると、自分で計画を立て、ツールを使い、結果を見て次の行動を決めるAIシステム |
| Agentic Reasoning(エージェント的推論) | 本論文の中心概念。推論(考えること)をエージェントの中核に置き、計画・行動・学習を一つのループとして扱う考え方 |
| 推論時計算(test-time compute) | 学習が終わったモデルを「使うとき」に投入する計算量。長く考えさせる、何通りも試す、などで性能を上げる |
| In-context 推論 | モデルの重みは変えず、プロンプトやワークフローの工夫、探索アルゴリズムで性能を引き出す方式 |
| Post-training(事後学習) | 基盤モデルの学習後に、追加の学習(強化学習や教師あり微調整)で振る舞いを変える方式 |
| 強化学習(RL) | 行動の結果に報酬を与え、報酬が高くなる行動を学ばせる学習法。本論文では GRPO という手法が頻出する |
| SFT(教師あり微調整) | お手本となる入出力例を見せて模倣させる追加学習 |
| ツール利用 | LLM が検索API、電卓、コード実行環境、社内システムなど外部の機能を呼び出すこと |
| RAG/Agentic RAG | 外部文書を検索して回答に反映する仕組み。Agentic RAG は「いつ・何を・どう検索するか」をエージェント自身が判断する発展形 |
| 内省(Reflection) | 自分の出力を自分で批評し、修正すること |
| メモリ | 対話や経験を保存し、後で取り出して使う仕組み。単なる履歴保存から、構造化・学習による制御へ発展している |
| マルチエージェントシステム(MAS) | 役割の異なる複数のエージェントが協調して一つの課題を解くシステム |
| 世界モデル | 「この行動をするとどうなるか」を内部でシミュレーションするためのモデル |
| ベンチマーク | 性能を測るための標準的な課題集。本論文は7章を丸ごとこの整理に充てている |
なぜ「エージェント的推論」なのか:従来のLLM推論との違い
論文は冒頭で、従来のLLM推論の限界を明確にしています。Chain-of-Thought(途中の思考を書き出させる手法)や問題分解などによって、数学やコーディングのような「答えが決まっている閉じた世界」ではLLMの成績が大きく伸びました。しかしこれらは、文脈が固定され、短い手順で終わる問題を前提にしています。情報が時間とともに変わる開かれた環境では、従来のLLMには「行動する」「適応する」「改善する」仕組みがありません。
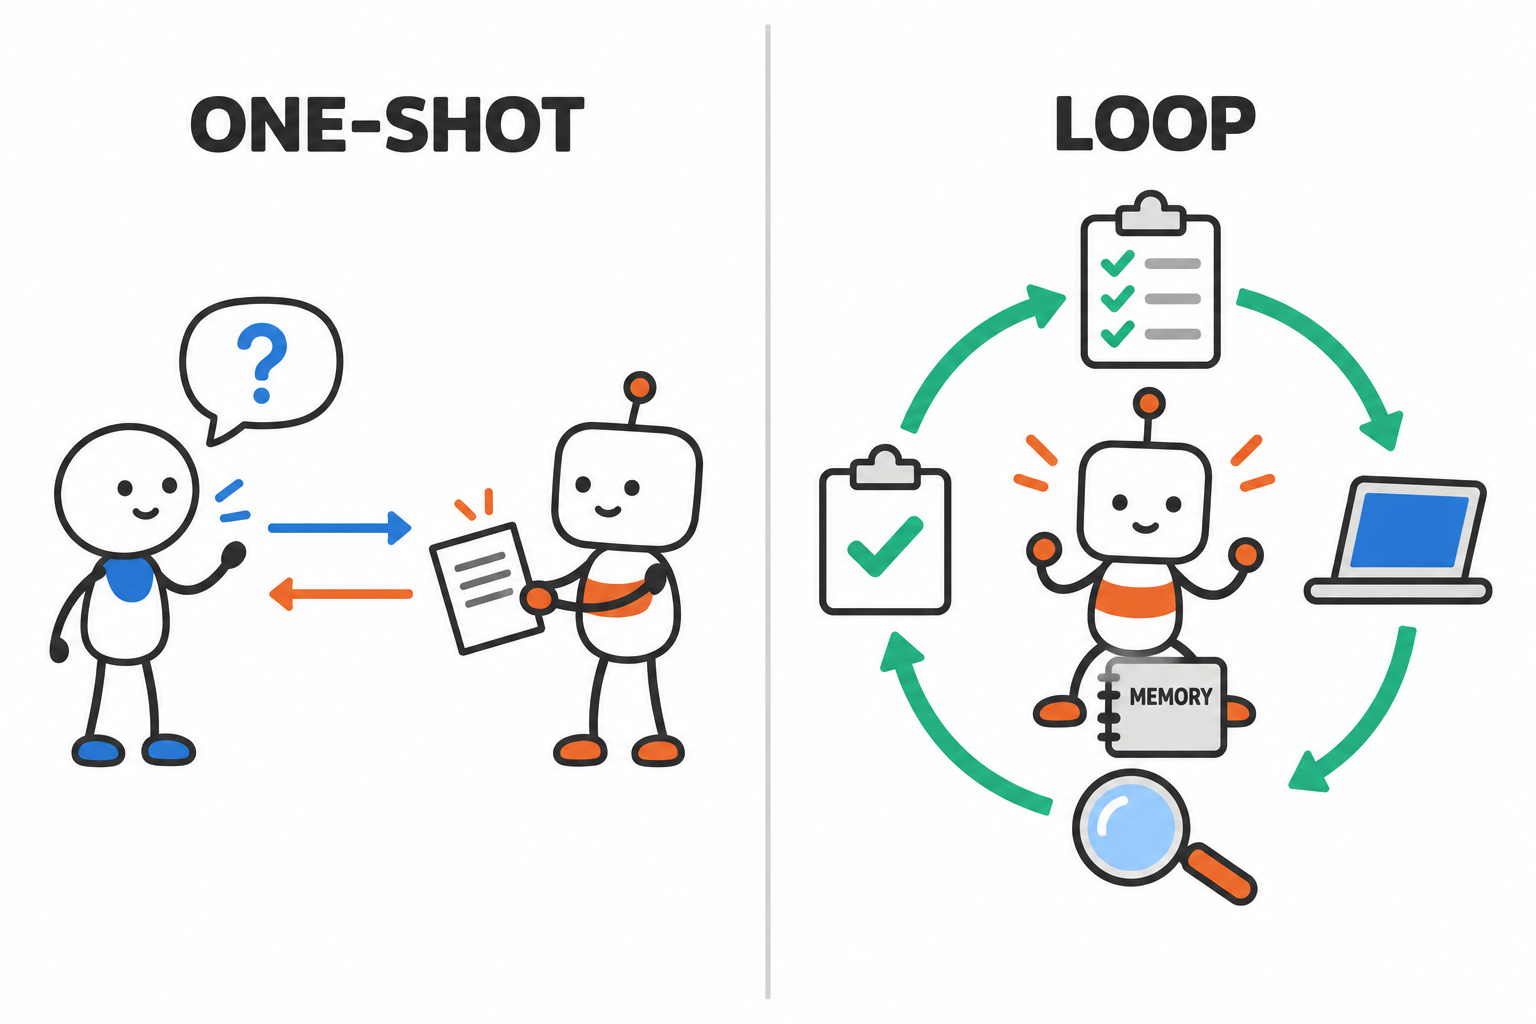
そこで論文が提案するのが、LLMを計画し、行動し、環境との継続的なやり取りを通じて学ぶ自律的エージェントとして捉え直す枠組みです。論文はこの転換を「推論時計算のスケーリング」から「推論時インタラクションのスケーリング」への移行と表現しています。モデルを大きくしたり長く考えさせたりするのではなく、ツールを呼び、選択肢を試し、メモリを更新し、フィードバックを取り込むという「やり取りの回数と質」で性能を伸ばす、という発想です。
論文の Table 1 は、この違いを「受け身か能動か」「文脈が固定か動的か」「一回で終わるか多段階か」「状態を持つか」「知識が固定か自己進化するか」といった軸で対比しています。重要なのは、どれか一つの技術が変わったのではなく、推論というプロセスそのものが「文章を出す」から「ループを回す」に変わった点です。
論文の全体地図:3つの層 × 2つの最適化モード
本論文の最大の貢献は、乱立するエージェント研究を一つの座標系に置いたことです。座標系は2軸で構成されます。
第1の軸:環境のダイナミクスによる3つの層
- 基礎的推論(Foundational):単一のエージェントが安定した環境で発揮する中核能力。計画(Planning)、ツール利用(Tool Use)、探索(Search)の3要素。
- 自己進化型推論(Self-evolving):フィードバックとメモリによって、経験から継続的に能力を磨く仕組み。
- 集合的マルチエージェント推論(Collective):複数のエージェントが役割を分担し、知識を共有し、共進化する仕組み。
第2の軸:2つの最適化モード
- In-context 推論:モデルの重みは固定したまま、推論時の工夫(ワークフロー設計、木探索、プロンプト)で能力を引き出す。
- Post-training 推論:強化学習や教師あり微調整によって、うまくいった推論パターンやツール利用の戦略をモデルの重みに内在化する。
この2軸は、3層すべてを横断して適用されます。つまり「基礎能力を In-context で」「集合的推論を Post-training で」といった組み合わせがすべてあり得ます。論文はさらに、この地図を応用分野(6章)とベンチマーク(7章)で肉付けし、最後に未解決課題(8章)を挙げる構成です。
第1層:基礎的推論――計画・ツール利用・探索
単一エージェントの基本動作は「計画を立て、ツールで行動し、必要な情報を探索し、結果を検証する」というサイクルです。論文はこの3要素をそれぞれ In-context と Post-training に分けて整理しています。
計画(Planning)
In-context 側の計画手法は5つの型に分けられています。(1)知覚・推論・実行・検証といった段階を明示するワークフロー設計、(2)幅優先・深さ優先・モンテカルロ木探索(MCTS)などの木探索で複数の思考経路を比べる方法、(3)PDDL やプログラムとして計画を記述する形式化、(4)観測と推論を分離するなどの分解、(5)知識グラフや世界モデル、外部ツールによる外部支援です。Post-training 側では、報酬設計や最適制御の考え方で計画そのものを学習させます。
ツール利用(Tool Use)
ツール利用の核心は「いつ使うか、どのツールを選ぶか、どう正しく呼び出すか」を判断できることだと論文は述べます。In-context 側では ReAct のように思考とツール呼び出しを交互に並べる方法が基本で、ツールの説明文を整えるだけでも未知のツールを使えるようになるという知見も紹介されています。Post-training 側は、まず SFT でお手本を模倣させて基礎能力を付け、次に RL で「結果が良くなる使い方」を試行錯誤で習得させる、という流れが主流です。論文は、SFT だけでは学習データのパターンに過適合しやすく、RL を組み合わせた方が未知の状況に強いと整理しています。
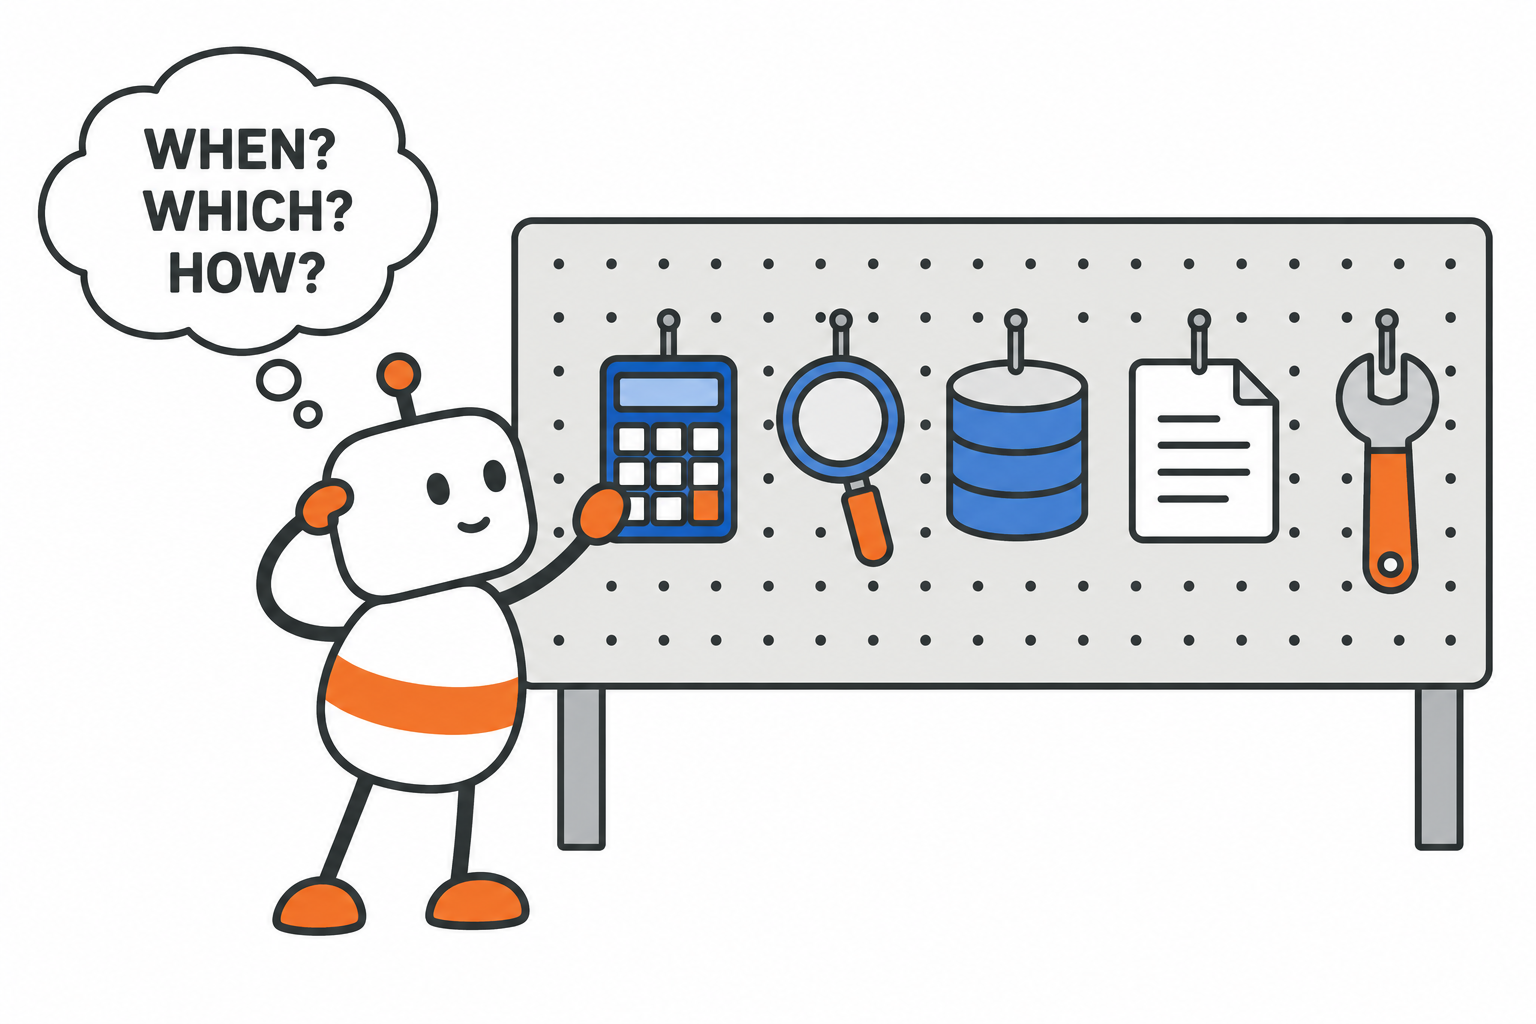
さらに実務では複数のツールを組み合わせる場面が多いため、ツール群を束ねて計画・実行するオーケストレーション型(HuggingGPT、TaskMatrix.AI など)が第3の類型として挙げられています。
探索(Agentic Search)
従来の RAG は「最初に一回検索してから生成する」固定的な流れでした。Agentic RAG では、エージェントが推論の途中で「いま追加情報が必要か」を判断し、クエリを練り直し、複数の情報源を統合します。論文はこれを In-context 型(Self-Ask、IRCoT など)、知識グラフなどを扱う構造強化型、そして検索行動そのものを学習する Post-training 型(WebGPT、Search-R1、DeepResearcher など)に分類しています。
第2層:自己進化型推論――フィードバックとメモリ
第2層の主役は「フィードバック」と「メモリ」です。フィードバックは自己修正のための評価信号を与え、メモリは過去の経験を蓄積して再利用可能にします。この2つが揃うと、推論は静的な処理から、継続的に改善するループへ変わります。
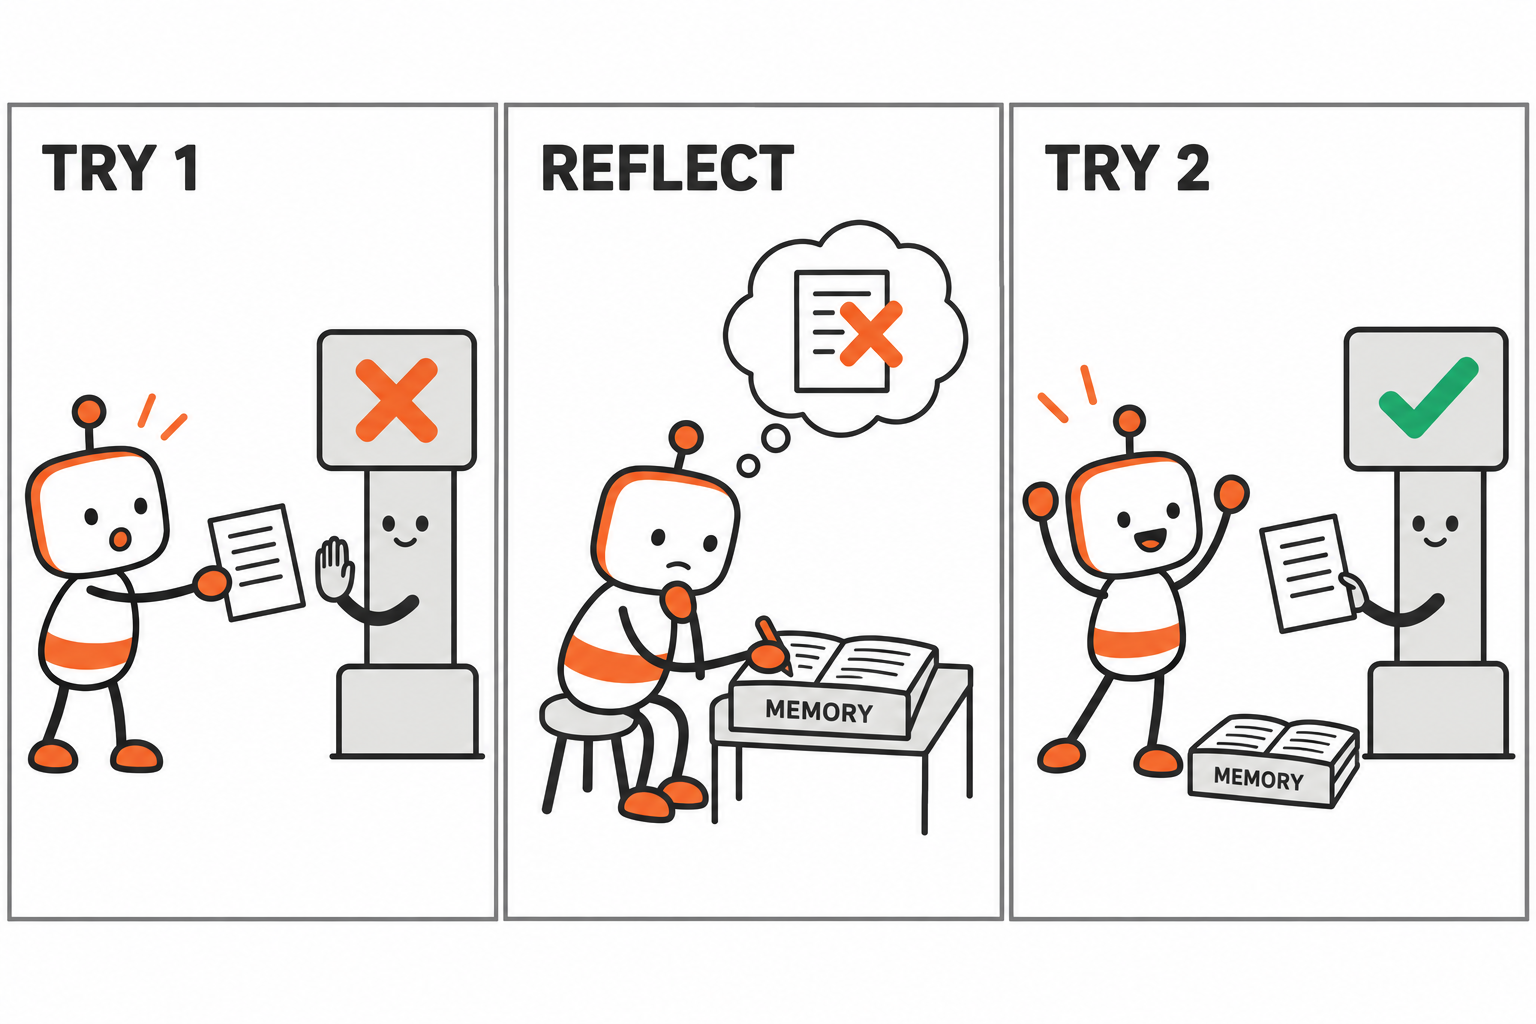
フィードバックの3方式
論文はフィードバックを「何を更新するか」で3つに分けています。内省型は推論中に自分の出力を批評して軌跡を修正する方式で、モデルの重みは変わりません。パラメータ適応はフィードバックを学習データに変換して重みを更新する方式で、効果は持続しますが追加の学習コストがかかります。検証器駆動は単体テストやシミュレータの合否だけを見て再試行する方式で、安価で確実な検証器があるときに最も効率的です。ただし、なぜ失敗したかは教えてくれない「非診断的」なフィードバックだという限界も指摘されています。
メモリの3段階
メモリも3段階で整理されています。第1段階は対話履歴などを文のまま保存し、必要に応じて取り出すフラットメモリ。ここには事実の記憶だけでなく、成功した手順や戦略を蓄積する「経験メモリ」(Workflow Memory、Dynamic Cheatsheet など)も含まれます。第2段階はグラフや木、ワークフローとして整理する構造化メモリ(GraphRAG、Mem0、Zep など)。第3段階は「何を覚え、何を捨て、いつ取り出すか」を強化学習で方策として学習する事後学習によるメモリ制御(Memory-R1、MemAgent など)です。論文はこの流れを「受け身のバッファから、推論ループの一部としてのメモリへ」という転換と位置づけています。
基礎能力そのものの進化
第2層にはもう一つ、計画・ツール・探索という基礎能力自体を進化させる話題があります。エージェントが自分で練習問題を生成して解く、不足しているツールを自分でコードとして作る(LATM、CRAFT、ToolMaker など)、検索対象であるメモリを推論のたびに書き換える、といった研究です。
第3層:集合的マルチエージェント推論――役割・協調・共進化
第3層では、複数のエージェントが補完的な役割を担って一つの課題に取り組みます。論文はまず、分野を問わず現れる汎用的な5つの役割を挙げています。
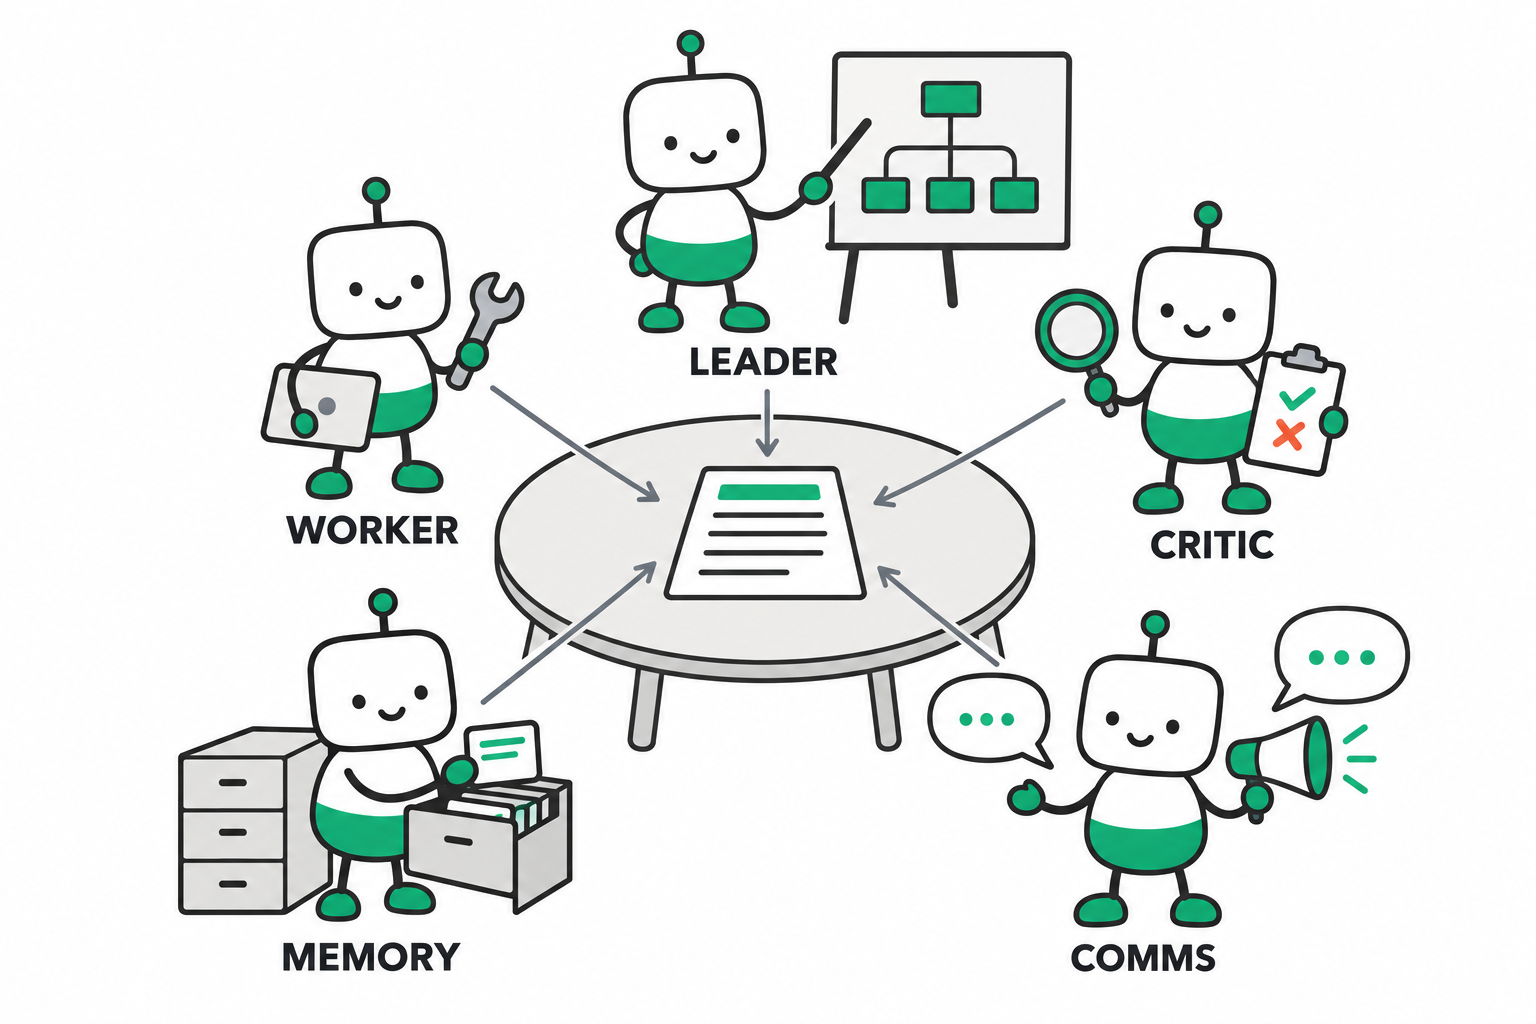
リーダーが目標を分解して割り当て、ワーカーが実行し、批評家が検証し、メモリ管理役が知識を保守し、通信調整役がやり取りを整える。この構図は、ソフトウェア開発(アーキテクト・開発者・レビュアー)、金融(アナリスト・リスク管理・トレーダー・コンプライアンス)、医療(トリアージ・専門医・主治医)など、分野ごとの専門職の構造にそのまま写像されていると論文は述べます。
協調の設計:手で組むか、学習させるか
協調のさせ方も In-context と Post-training に分かれます。In-context 側では、人が役割と手順を決める手設計パイプライン、LLM が課題に応じて役割を分解・割当する LLM 主導型、問いに応じて専門エージェントを選ぶルーティングがあります。Post-training 側では、各役割のプロンプトを自動改善する方法と、エージェント間の通信構造(トポロジー)をグラフとして生成・剪定・探索する方法、さらに「次にどの役割が動くか」を強化学習で学ぶ方法が整理されています。
共進化とメモリの共有
論文は、自己進化を個体から集団へ広げる「マルチエージェント共進化」も扱います。複数のエージェントが共有メモリを持つ場合、メモリをどう構造化するか(階層型か役割別か)、どこに置くか(集中か分散か)、何を入れるか、どう更新するかという4つの設計次元が示されます。一方で論文自身が、マルチエージェントのメモリを事後学習で共同最適化する研究はまだほとんどないと認めており、ここは明確な空白地帯です。
エンジニア向け補足:論文の定式化
ここからは少し踏み込みます。論文の2.2節は、エージェント的推論を制御理論の枠組みで統一的に記述しています。環境を部分観測マルコフ決定過程(POMDP)としてモデル化し、通常の状態・観測・行動に加えて「推論の軌跡」を表す変数 z を導入する点が特徴です。方策は次のように分解されます。
π_θ(z_t, a_t | h_t) = π_reason(z_t | h_t) × π_exec(a_t | h_t, z_t)

  z_t : 内部の推論(思考・計画。言語化すれば Chain-of-Thought)
  a_t : 外部への行動(ツール呼び出し、最終回答)
  h_t : それまでの観測・思考・行動の履歴(メモリで要約してもよい)
「まず内部で考え(z)、それから外に向けて行動する(a)」という構造を明示したのがポイントです。この枠組みで見ると、In-context 推論は重み θ を固定したまま推論空間 Z の中を探索する問題(Tree of Thoughts や MCTS は、部分的な思考をノードとして価値の高い経路を探す)、Post-training 推論は長期の報酬に対して θ を最適化する問題(PPO や GRPO)として統一的に説明できます。GRPO については、同じ問いに対する複数の出力の報酬を群内で正規化して優位性を計算することで、価値ネットワークを不要にしている点が紹介されています。
自己進化は、エピソードをまたぐメタ更新として書かれます。
S_{k+1} ← U(S_k, τ_k, F_k)

  S_k : 進化する対象(反省文、ツール群、エージェント自身のコードなど)
  τ_k : k回目のエピソードの軌跡
  F_k : 環境からのフィードバック(報酬、実行エラーなど)
S に何を置くかで、言語的進化(Reflexion のように反省文を蓄積)、手続き的進化(Voyager のようにスキルをコードとして蓄積)、構造的進化(AlphaEvolve のようにエージェントのコード自体を書き換える)に分類されます。マルチエージェントについては、各エージェントの観測に通信チャネルを加えた分散型 POMDP(Dec-POMDP)として扱い、課題は「通信構造と報酬をどう設計すれば分散した推論が一つの目的に揃うか」というメカニズムデザインに移る、と整理されています。
応用分野とベンチマーク
6章では、3層の枠組みを使って5つの応用分野を読み解いています。
| 応用分野 | 論文が挙げる特徴的な動き |
|---|---|
| 数学探索・バイブコーディング | オリンピック級の幾何問題、プログラム探索による数学的発見。コードでは対話的に設計・修正を繰り返す「バイブコーディング」が実務化 |
| 科学的発見 | 化学・材料・創薬で、仮説生成→シミュレータや実験装置で検証→反省のループを自動化(ChemCrow、Coscientist など) |
| ロボティクス(Embodied) | 言語指示をロボットの技能に変換、物理的に検証可能な報酬での強化学習、複数ロボットの役割交渉 |
| 医療 | 診断計画の階層化、臨床計算ツールの大規模統合、専門医役の多エージェント合議 |
| Web探索・GUI操作・自律リサーチ | ブラウザや画面を直接操作するエージェント、文献調査から実験・執筆までを回す研究エージェント |
7章のベンチマーク整理も実務上の価値が高い部分です。論文は評価を2つの視点に分けます。一つはメカニズム単位の評価で、ツール利用、探索、メモリと計画、マルチエージェント協調をそれぞれ切り出して測るもの。もう一つは応用単位の評価で、ロボット、科学、研究、医療、Web、汎用ツール利用の6カテゴリで、知覚から行動までを通しで測るものです。前者は「どの部品が弱いか」を特定でき、後者は「実運用に近い条件で動くか」を確かめられる、という補完関係にあります。
論文が挙げる6つの未解決課題
8章で論文が挙げる課題は、そのまま「いま実務で苦労するポイント」の一覧でもあります。
- ユーザー中心の推論とパーソナライゼーション:ユーザー自身を環境の一部とみなし、意図の変化に長期的に適応する。短期の成果と長期の信頼のバランスが難しい。
- 長期タスクにおける推論と信用割当:長いタスクでは誤りが急速に蓄積する。どのトークン・ツール呼び出し・メモリ更新が成否に効いたかを割り当てる方法が未確立。
- 世界モデルを使った推論:内部シミュレーションで先読みする設計は有望だが、表現が場当たり的で、非定常な環境での共進化はほとんど手つかず。
- マルチエージェントの協調推論と学習:協調構造の多くはまだ手設計で、群レベルの信用割当は十分に理解されていない。
- 潜在空間での推論:言語化せず内部表現で計画・協調する方向は効率が良いが、解釈性と監査性が下がる。
- ガバナンス:長期計画・永続メモリ・実世界での行動実行という3点が、従来のLLM安全性にはない新しいリスクを生む。既存の評価や防護策は短期の振る舞いに偏っている。
ビジネスへの含意(筆者の見解)
ここから先は論文の記述ではなく、論文の枠組みを業務に当てはめた筆者の解釈です。
1. 「LLMに計算させない」設計が現実解
論文を通読すると、エージェントの力の源泉は LLM 単体の賢さではなく「適切なツールを適切なタイミングで呼べること」にあると分かります。社内データの集計、在庫の最適化、検索はそれぞれ専用システムやソルバーに任せ、LLM はその編成役に徹する。HuggingGPT 型のオーケストレーションは、業務システムが分散している企業ほど相性が良い構成です。
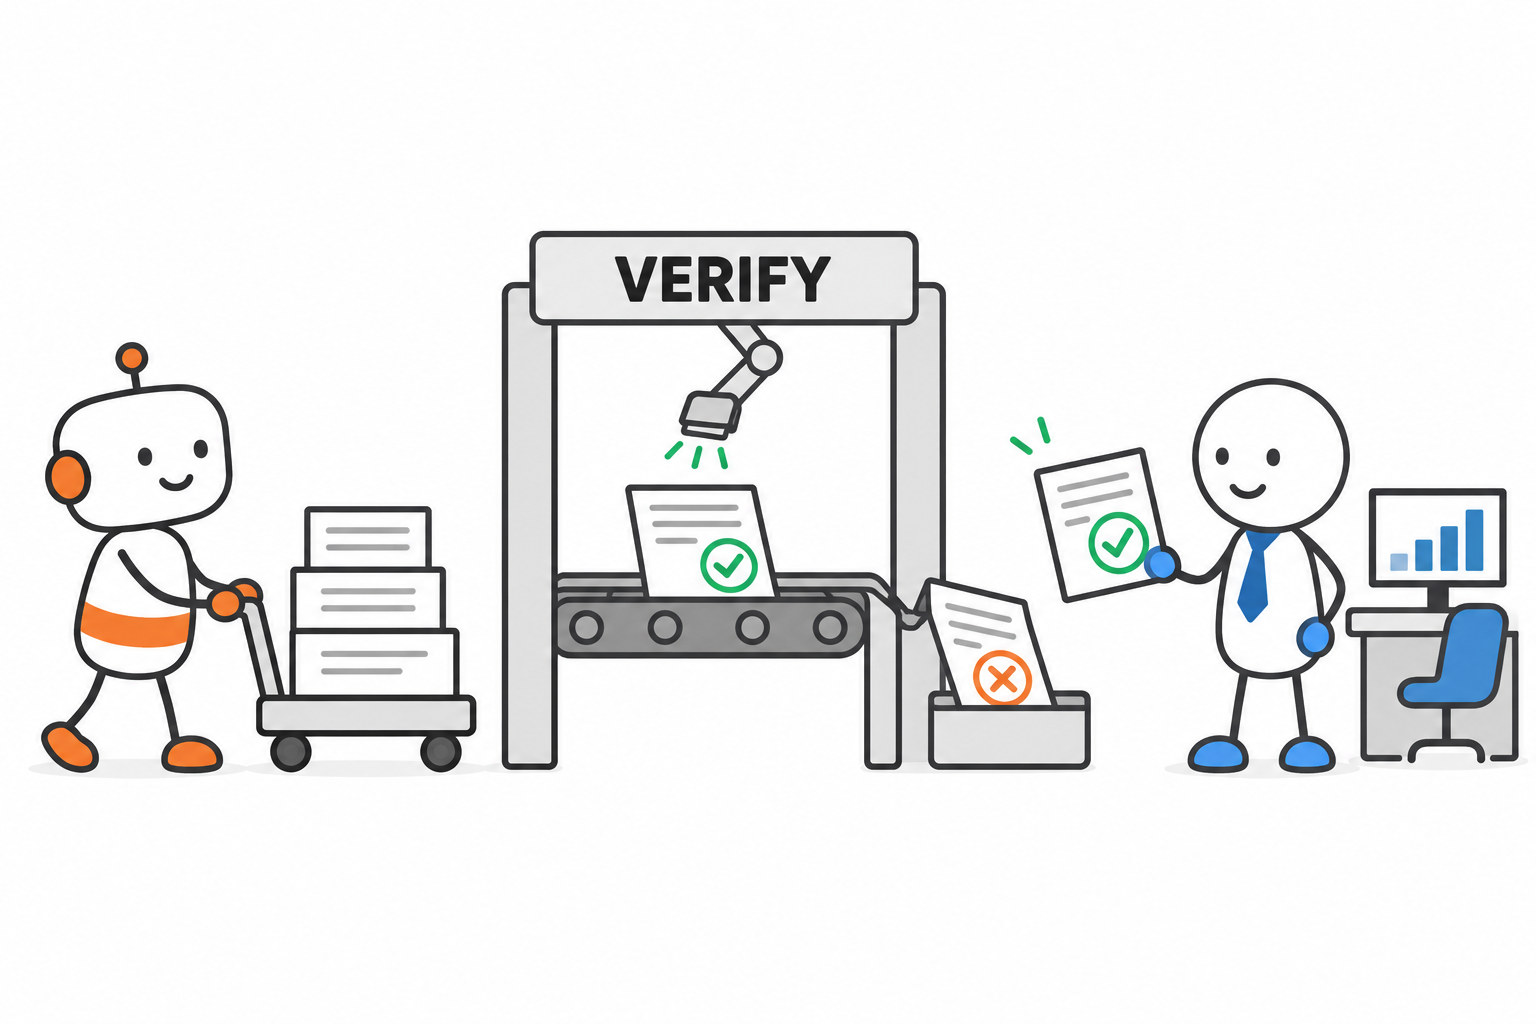
2. 「合否を機械的に判定できる工程」から始める
論文は、安価で確実な検証器があるときは検証器駆動のフィードバックが最も効率的だと整理しています。裏を返せば、品質を人が目視でしか判断できない業務は、エージェント化の難度が高い。SQL の実行結果、帳票の整合性チェック、既存ルールとの照合など、「正解判定を自動化できる工程」を先に見つけることが導入の近道です。
3. メモリ設計は「ナレッジマネジメント」の問題
Workflow Memory や Reasoning Bank(失敗事例の再利用)の発想は、トラブル対応の履歴やレビューの指摘事項を「次に活かせる形」で蓄積する設計そのものです。何をどの粒度で記録し、どう検索し、いつ捨てるか。論文の4つの設計次元(構造・配置・内容・管理)は、社内ナレッジの棚卸しにもそのまま使えるチェックリストになります。
4. マルチエージェントは組織設計の問題でもある
5つの汎用役割は、企画・実行・品質保証・情報管理・連絡調整という、人間の組織の分業と同じ形をしています。逆に言えば、人間側で役割と検証の流れが曖昧な業務を、エージェントに任せてもうまくいきません。論文自身が「協調構造はまだ手設計が中心」と認めている通り、当面は人が役割と手順を明示的に設計する前提で考えるのが現実的です。
5. 導入の順序は In-context から
Post-training(自社データでの強化学習)は論文でも研究段階の話題が多く、報酬設計や安定化に専門的な工数がかかります。まずは既存モデルにツールとワークフローを組み合わせる In-context 型で小さく始め、検証器と評価指標(自社版ベンチマーク)を先に整える。評価基準がないまま高度化すると、8章のガバナンス課題にそのまま直面します。
どこから読むか:読者別ガイド
- 全体像だけ掴みたい:1章(序論)と2章(従来推論との対比、位置づけ)。Table 1 と Figure 1 を見れば骨格は分かります。
- 業務への適用を検討したい:3.2節(ツール利用)、4.1節(フィードバック)、7章(ベンチマーク)、8.6節(ガバナンス)。
- 手法を深く知りたい:2.2節(定式化)を押さえてから、3〜5章の各表(Table 2〜6)で代表手法を一覧し、気になる文献へ。
- 最新動向を追い続けたい:付属の GitHub リポジトリが文献リストとして更新されています。
まとめ
本論文は、「考えるAI」から「行動しながら考えるAI」への転換を、3層×2モードという一つの座標系で整理したロードマップです。個々の手法名を覚えることより、「いまの自社の取り組みはどの層の、どのモードの話をしているのか」を言語化できるようになることが、この論文を読む最大の実益だと筆者は考えています。エージェント導入の議論が「できる・できない」の水掛け論になりがちな組織ほど、共通の地図として役立つはずです。
出典・参考リンク
- Zhining Liu, Tianxin Wei, Ting-Wei Li, et al. “A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents.” arXiv:2601.12538 (v2, 2026年9月20日). https://arxiv.org/abs/2601.12538
- 付属の文献リスト:Awesome-Agentic-Reasoning(GitHub)
本記事の内容は2026年11月2日時点で確認した論文 v2 に基づいています。論文は改訂される可能性があるため、引用の際は最新版をご確認ください。記事中の図はいずれも論文の記述をもとに筆者が作成したもので、論文中の図版の転載ではありません。
