「プロンプトエンジニアリングの次はコンテキストエンジニアリングだ」。AIエージェントの話題とともに、この言葉を目にする機会が増えました。AIに何を見せ、何を覚えさせ、何を渡さないか。その設計が成果を左右する、という考え方です。
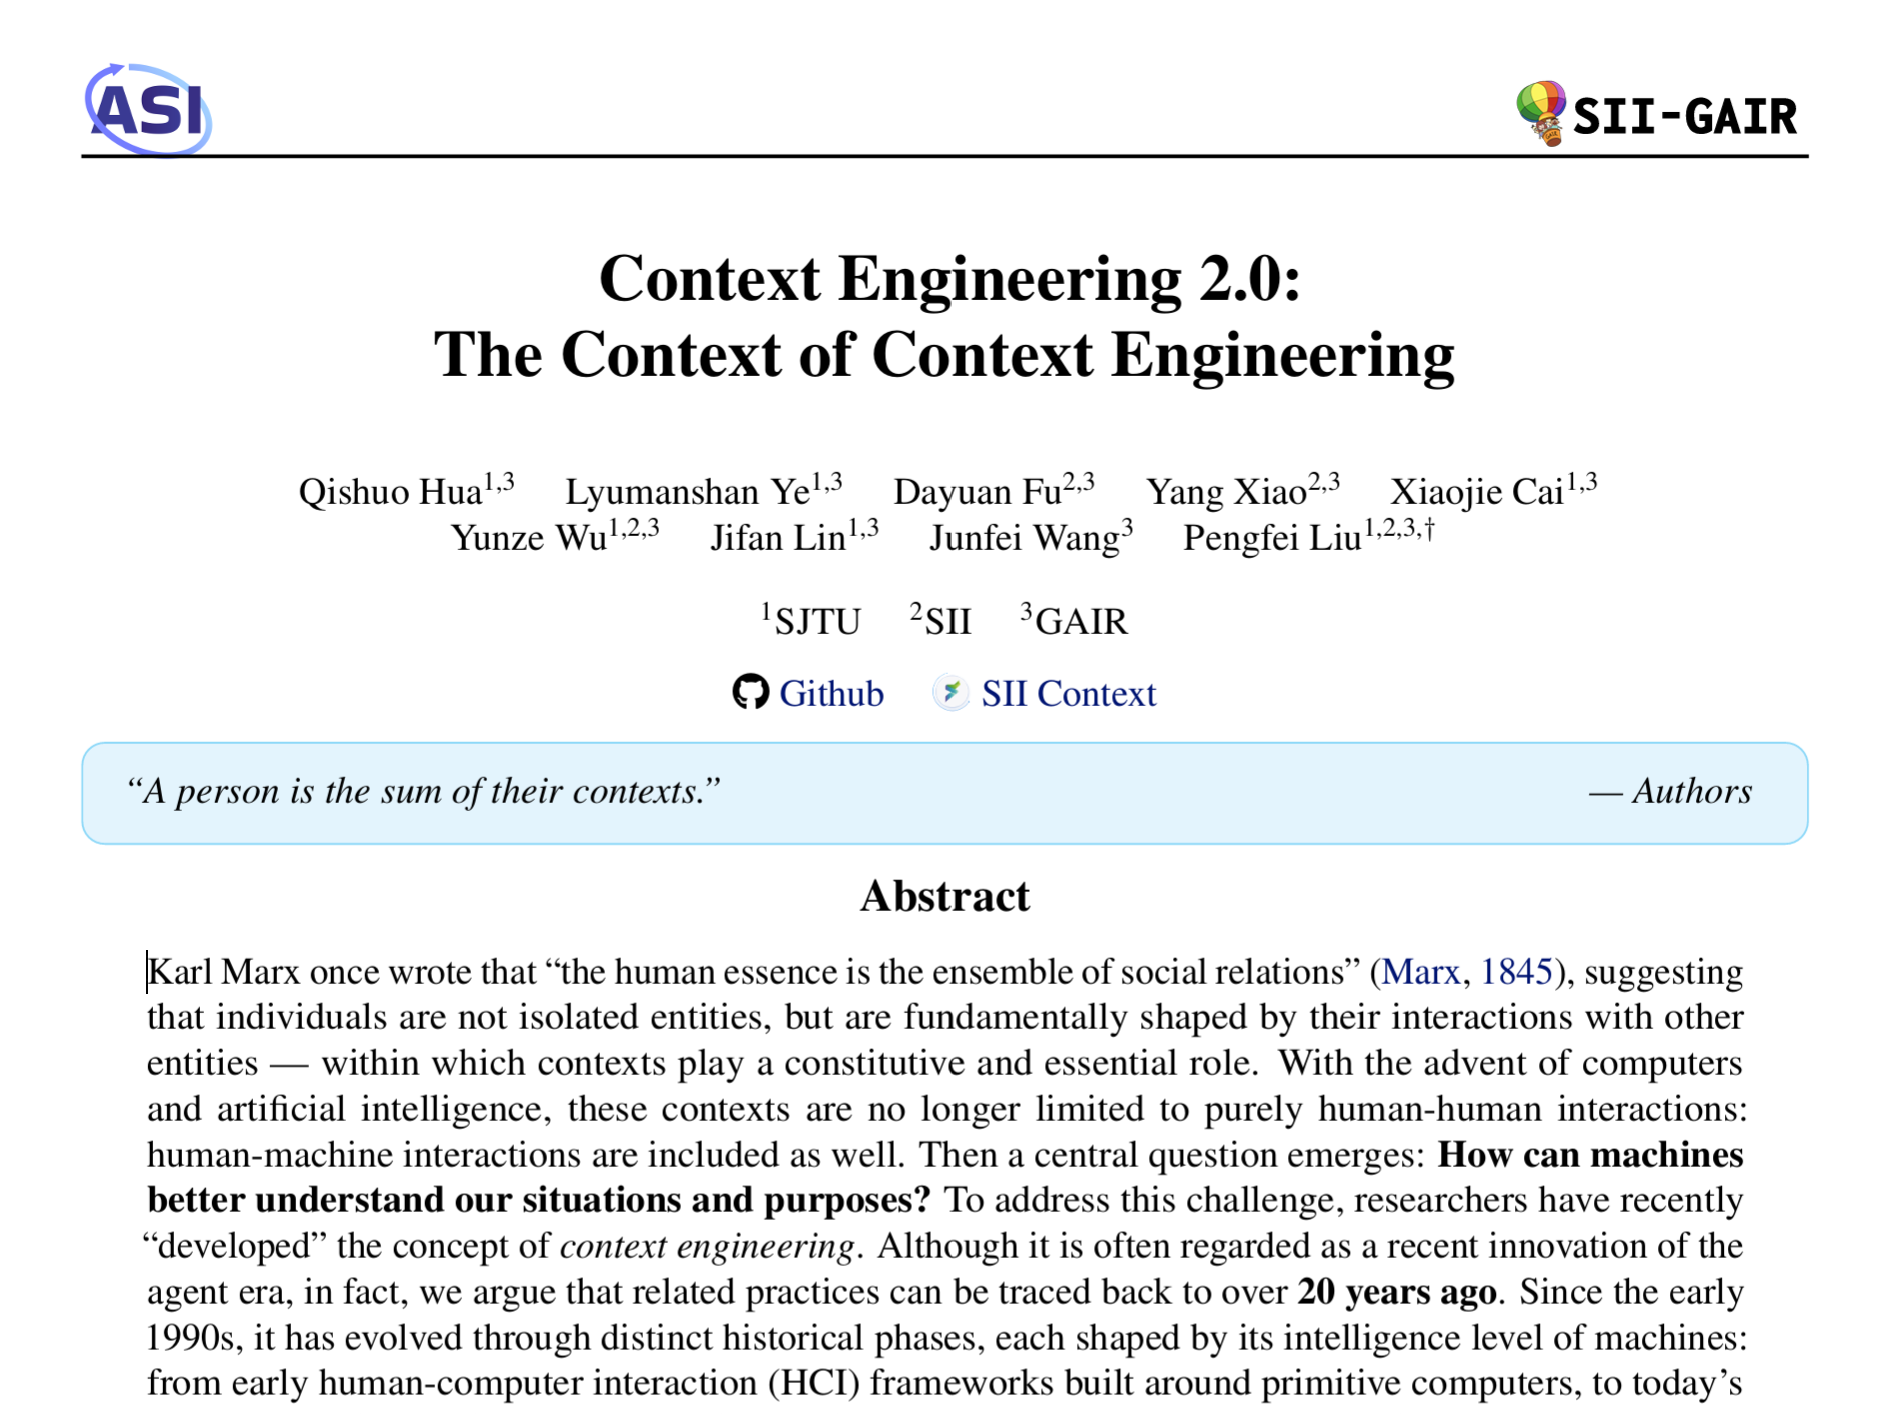
では、これは本当に新しい考え方なのでしょうか。今回取り上げる論文 Context Engineering 2.0: The Context of Context Engineering(arXiv:2510.26493)は、「いいえ、20年以上前から続く営みです」と答えます。本記事では、この論文をAIの専門家ではないビジネス実務者にも読めるように解説し、後半ではエンジニア向けに定義や実践知にも踏み込みます。最後に、業務への含意を筆者の見解として整理します。
先に結論(3行)
1. コンテキストエンジニアリングとは、人の曖昧な意図や状況を、機械が扱える形に変換する努力のことです。論文はこれを「エントロピー(あいまいさ)を下げる営み」と捉え、1990年代のコンテキスト認識システムから連続するものとして位置づけます。
2. 論文は機械の知能に応じた4つの時代(1.0〜4.0)を描き、いまを「2.0:エージェント中心の時代」と呼びます。設計の観点は「収集・保存」「管理」「利用」の3本柱です。
3. 新しい実験結果を示す論文ではなく、定義・歴史・設計観点を整理した概念的な論文です。「何をAIに渡すか」を場当たりではなく設計として考えるための共通言語になります。
| 項目 | 内容 |
|---|---|
| タイトル | Context Engineering 2.0: The Context of Context Engineering |
| 著者 | Qishuo Hua、Lyumanshan Ye、Dayuan Fu、Yang Xiao、Xiaojie Cai、Yunze Wu、Jifan Lin、Junfei Wang、Pengfei Liu(責任著者)の9名 |
| 所属 | 上海交通大学(SJTU)、SII、GAIR |
| 公開 | arXiv:2510.26493。本記事は v1(2025年10月30日付)に基づく |
タイトルの後半「The Context of Context Engineering」は、「コンテキストエンジニアリングという概念そのものの文脈(背景)」という意味の言葉遊びです。流行語として消費されがちな概念に、歴史と定義という土台を与えることが論文の狙いです。
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。本文を読んでいて引っかかったら戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| コンテキスト(文脈) | ある対象の状況を特徴づける情報すべて。会話履歴だけでなく、場所・時刻・利用者の状態・ツール・過去の記録なども含む |
| コンテキストエンジニアリング | コンテキストの収集・保存・管理・利用を設計し、機械の理解とタスクの成果を高める取り組み |
| プロンプトエンジニアリング | AIへの指示文の書き方を工夫すること。コンテキストエンジニアリングの一部にあたる |
| エントロピー | 情報のあいまいさ・不確かさの度合い。高いほど「何を意味するか」が定まらない |
| LLM | 大規模言語モデル。ChatGPT や Claude などの基盤となるAIモデル |
| エージェント | 目標に向けて自分で計画し、ツールを使い、結果を見て次の行動を決めるAIシステム |
| コンテキストウィンドウ | LLM が一度に読める情報量の上限。作業机の広さのようなもの |
| トークン | LLM が文章を処理する単位。コンテキストウィンドウの大きさはトークン数で表す |
| コンテキスト認識(Context-Aware) | 利用者の場所や状態をセンサーで感知し、振る舞いを変える1990年代からの研究分野 |
| ユビキタスコンピューティング | コンピュータが環境に溶け込み、意識せず使える状態を目指す構想(Mark Weiser、1991年) |
| 短期記憶/長期記憶 | いまの作業のために保持する文脈と、重要なものを圧縮して長く残す文脈 |
| self-baking | 生の文脈を、要約や構造化によって再利用しやすい「知識」に焼き固めること。論文の用語 |
| RAG | 外部の文書を検索し、その内容をAIに渡して回答させる仕組み |
| サブエージェント | 親のエージェントから一部の仕事を任され、独立した文脈で作業する子のエージェント |
| KVキャッシュ | LLM が一度処理した文脈の計算結果を再利用して、速度とコストを改善する仕組み |
コンテキストエンジニアリングは「新しい言葉」だが「新しい営み」ではない
論文の出発点は、コンテキストエンジニアリングをエージェント時代の発明とみなす見方への異議です。関連する実践は20年以上前までさかのぼれる、と論文は主張します。
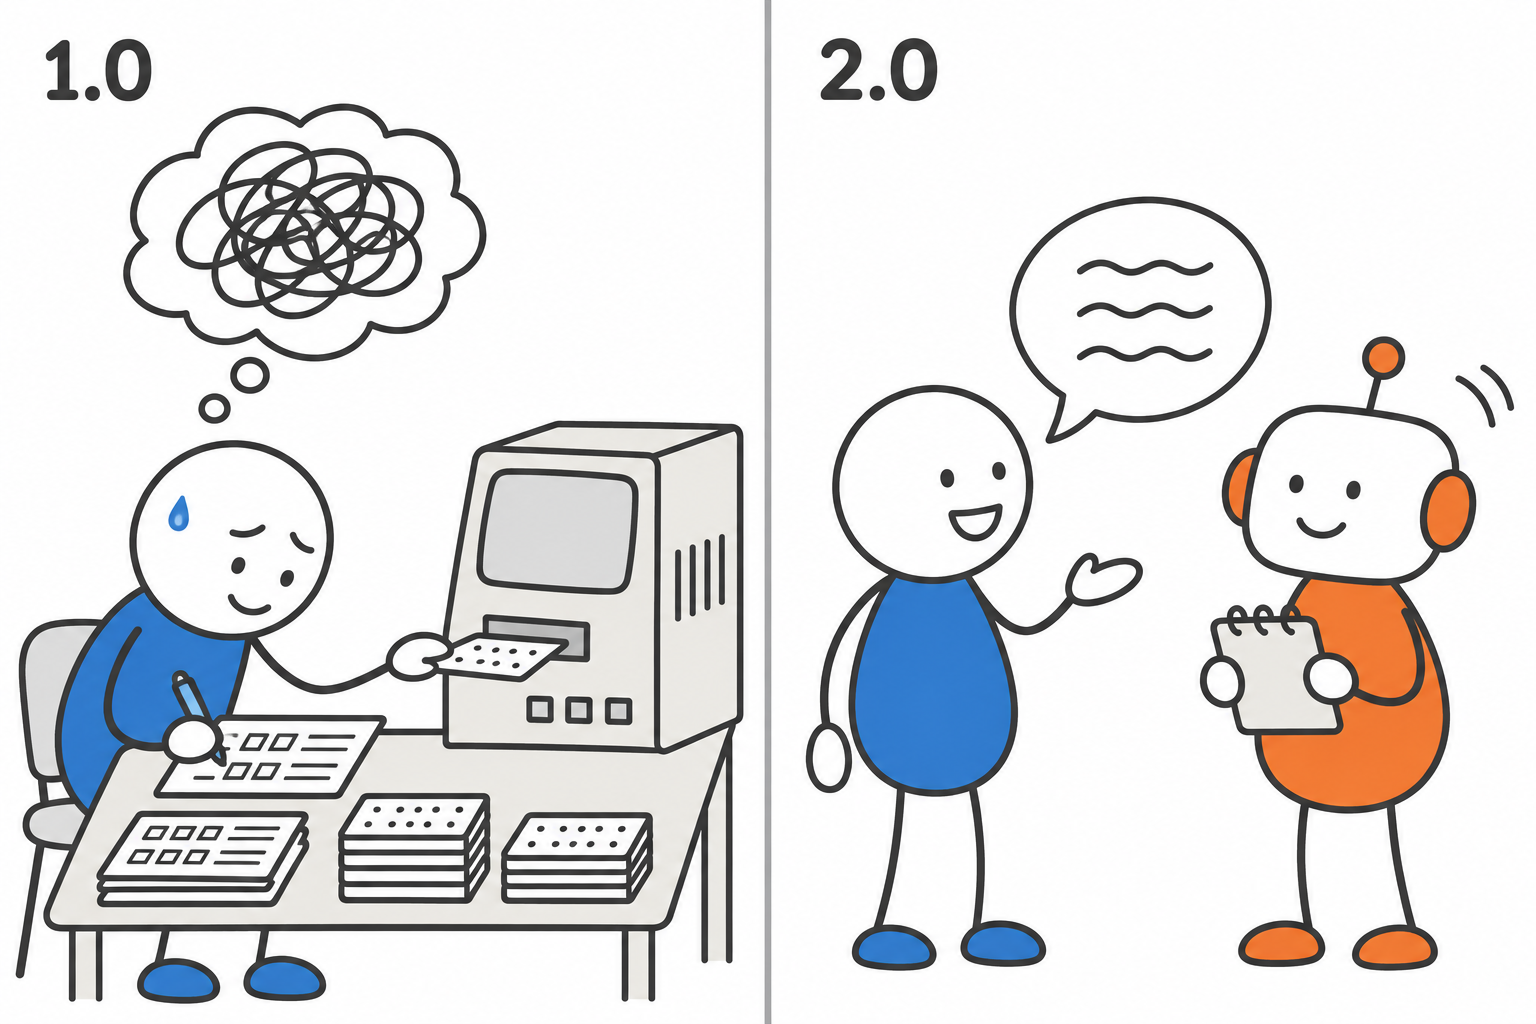
1.0の時代:人が機械に合わせていた
1991年、Mark Weiser は「ユビキタスコンピューティング」を提唱しました。そこから、利用者の場所や状態を感知して振る舞いを変える「コンテキスト認識」の研究が広がります。2001年には Anind K. Dey が、コンテキストを「ある対象の状況を特徴づけるために使える、あらゆる情報」という趣旨で定義しました。論文はこの定義を現在も有効な土台として採用しています。
同じ時期の Context Toolkit(1999年)は、センサーの抽象化、意味の解釈、複数の情報源の統合、アプリへの提供、部品の発見という5つの部品を定義していました。「集める・解釈する・まとめる・渡す」という骨格は、現在のエージェント基盤とよく似ています。ただし当時の機械は、あらかじめ決められたルール(条件が成立したら動作する)しか実行できません。人が意図を細かく分解し、機械が読める形に翻訳する必要がありました。
2.0の時代:機械が歩み寄りはじめた
LLM の登場で、機械は自然言語を理解し、曖昧さや欠けた情報をある程度推論で補えるようになりました。論文は、あらかじめ決めた信号に反応するだけの「コンテキスト認識(context-aware)」から、利用者の作業を解釈して目標の達成に協力する「コンテキスト協調(context-cooperative)」への移行と表現しています。論文の Table 1 は、両時代を次のように対比しています。
| 項目 | 1.0(1990年代〜2020年) | 2.0(2020年〜現在) |
|---|---|---|
| 技術的背景 | ユビキタスコンピューティング、コンテキスト認識システム、HCI | 大規模言語モデル、エージェント、プロンプトエンジニアリング |
| 代表的システム | Context Toolkit、Cooltown、ContextPhone | ChatGPT、LangChain、AutoGPT、Letta |
| コンテキストの種類 | 位置、身元、活動、時刻、環境、デバイス状態 | トークン列、検索した文書、ツールAPI、利用履歴 |
| 中核の仕組み | センサーの融合、ルールによるトリガー | プロンプト、RAG、Chain-of-Thought、メモリ型エージェント |
| 受け取れる文脈の幅 | 比較的狭い | 比較的広い |
興味深いのは、論文が「現在はコンテキストを対話履歴に絞って考えがちで、Dey の多次元的な定義から見ると後退している」という趣旨の指摘をしている点です。場所、時刻、利用者の状態、周囲の環境。こうした情報も本来はコンテキストです。
定義:コンテキストエンジニアリングとは「エントロピーを下げる」こと
論文の中心にある考え方は、情報のあいまいさ(エントロピー)です。人どうしの会話では、聞き手が共有知識や場の状況から、言葉にされていない部分を補います。機械はこれが苦手です。そこで人が前もって、曖昧な意図や状況を、機械が扱える明確な表現に変換しておく必要があります。論文は、この変換の努力こそがコンテキストエンジニアリングの中核だと述べます。
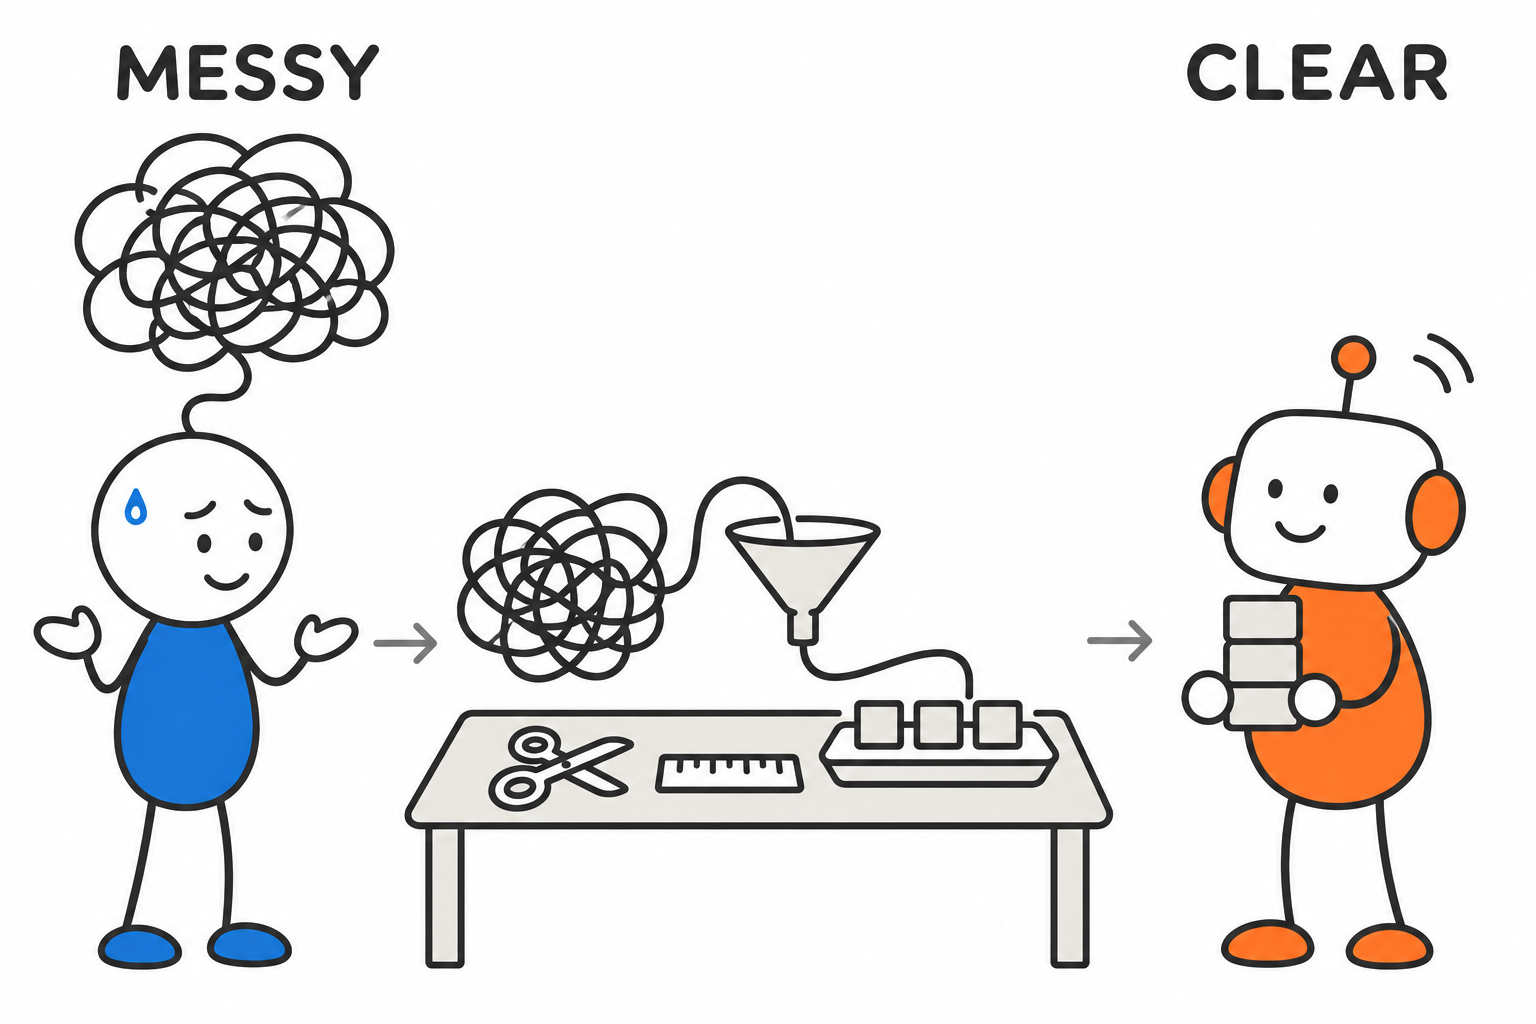
この見方に立つと、時代による違いも一本の線で説明できます。機械の知能が上がるほど、機械が自分で補える範囲が広がり、人が担う変換の負担は減ります。プロンプトの「呪文」が以前ほど必要なくなってきたのは、この流れの表れです。
エンジニア向け補足:形式的な定義
論文の2.1節は、Dey の定義を集合の言葉で書き直しています。要点は次のとおりです。
Char(e)  : 対象 e(利用者、アプリ、物、環境など)を特徴づける情報の集合
C        = ∪ Char(e)   (やり取りに関係する対象 e すべてについての和集合)= コンテキスト

CE : (C, T) → f_context
  C         : 生のコンテキスト
  T         : 対象のタスク
  f_context : コンテキストを変換・最適化する関数
              f_context(C) = F(φ1, φ2, …, φn)(C)   … 複数の操作 φ の合成
コンテキストエンジニアリングは「一つの技」ではなく、複数の操作の組み合わせだという定義です。論文は現在(2.0)の操作として、次の8つを挙げています。
4つの時代:機械が賢くなるほど、人の負担は減る
論文は機械の知能の水準に応じて、コンテキストエンジニアリングを4つの段階に分けます。各段階で、機械と人の役割分担が変わります。
論文の Figure 1 は、各時代のコンテキストの位置づけを「翻訳(translation)」「指示(instruction)」「場面(scenario)」「世界(world)」という言葉で表しています。1.0では人が意図を機械の言葉に翻訳し、2.0では自然言語で指示し、3.0では場面を共有するだけで通じ、4.0では機械の側が文脈を構築する、という流れです。
注意したいのは、3.0は将来の予測、4.0は論文自身が「思索的」と断っている段階だという点です。4.0の兆しとして論文は、囲碁のプロ棋士がAIから新しい打ち方を学んでいる例を挙げています。実証された話として読めるのは、1.0と2.0までです。
設計の3本柱と、収集・保存の2原則
論文の4〜6章は、コンテキストエンジニアリングの設計を3つの観点で整理しています。集めて置く(収集・保存)、整理して圧縮する(管理)、選んで渡す(利用)の3つです。
このうち収集・保存について、論文は2つの原則を示します。
「とりあえず全部ためておく」は、この2原則のどちらにも反します。1.0の時代は単一の端末のログやローカルのファイルが中心でした。2.0ではスマートフォン、ウェアラブル、クラウド、外部APIへと収集元が分散し、保存先も、短命なデータはキャッシュ、中期のデータは端末内のデータベース、長期のデータはクラウド、というように階層化されています。コード生成エージェントが作業メモを外部ファイルに書き出し、必要なときに読み戻す方式も、この流れの一例として紹介されています。
管理:集めた文脈を整理し、圧縮し、分離する
テキストの整理:4つの方法と弱点
集めた文脈をどう整理するか。論文は代表的な4つの方法を、長所と短所とともに挙げています。どれにも弱点があり、万能な方法はない、というのが論文の整理です。
| 方法 | 長所 | 短所 |
|---|---|---|
| タイムスタンプを付けて時系列に並べる | 単純で保守しやすく、順序を保てる | 意味の構造がなく、離れた情報どうしの関係をたどりにくい。たまる一方になる |
| 役割や意味のタグを付ける | 各項目の役割が明確になり、優先度や出典などで検索・管理できる | 枠組みが硬くなり、柔軟な推論や創造的な統合を妨げることがある |
| 質問と回答のペアに圧縮する | 検索の効率が高く、FAQ型の用途に向く | 思考の流れが失われ、要約や推論のように全体理解が必要な仕事には向かない |
| 階層的なノートにまとめる | 概念を木構造で整理でき、見通しがよい | 分類は表せるが、因果や根拠と結論のような論理関係、理解の変化は表せない |
記憶の階層:短期記憶と長期記憶
次の論点は記憶です。すべてを同じ重みで持ち続けることはできないので、「いま必要なもの」と「長く残すべきもの」を分けます。
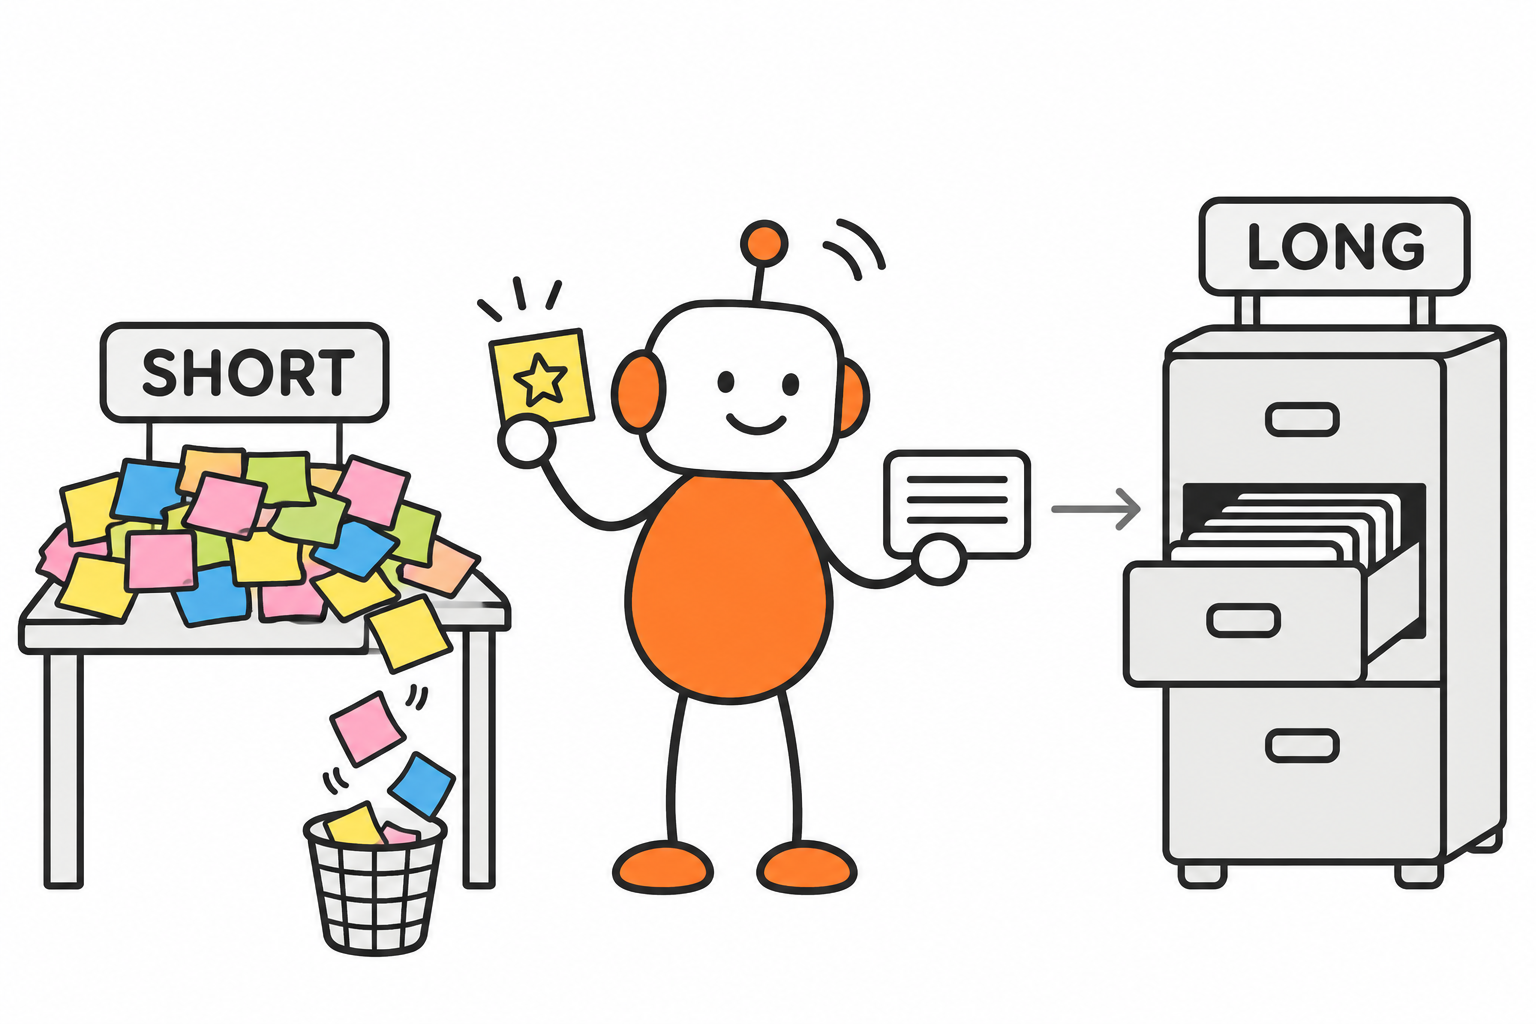
論文は、短期記憶を「時間的な関連性が高い文脈」、長期記憶を「重要度が高い文脈を選択・抽象化・圧縮したもの」と定義し、前者から後者への転送(統合)を一つの処理として扱います。例として、マルチエージェント型のリサーチシステムが、文脈が20万トークンを超えるような長い作業で研究計画を永続的なメモリに保存する事例が挙げられています。
文脈の分離:混ぜないための設計
一つの文脈に何でも入れると、関係のない情報が判断を鈍らせます。そこで文脈を分ける設計が使われます。代表例がサブエージェントです。それぞれが独立したコンテキストウィンドウ、専用の指示、制限されたツール権限を持ち、親のエージェントは必要な仕事だけを任せます。親の文脈が細かな作業記録で汚れないことが利点です。
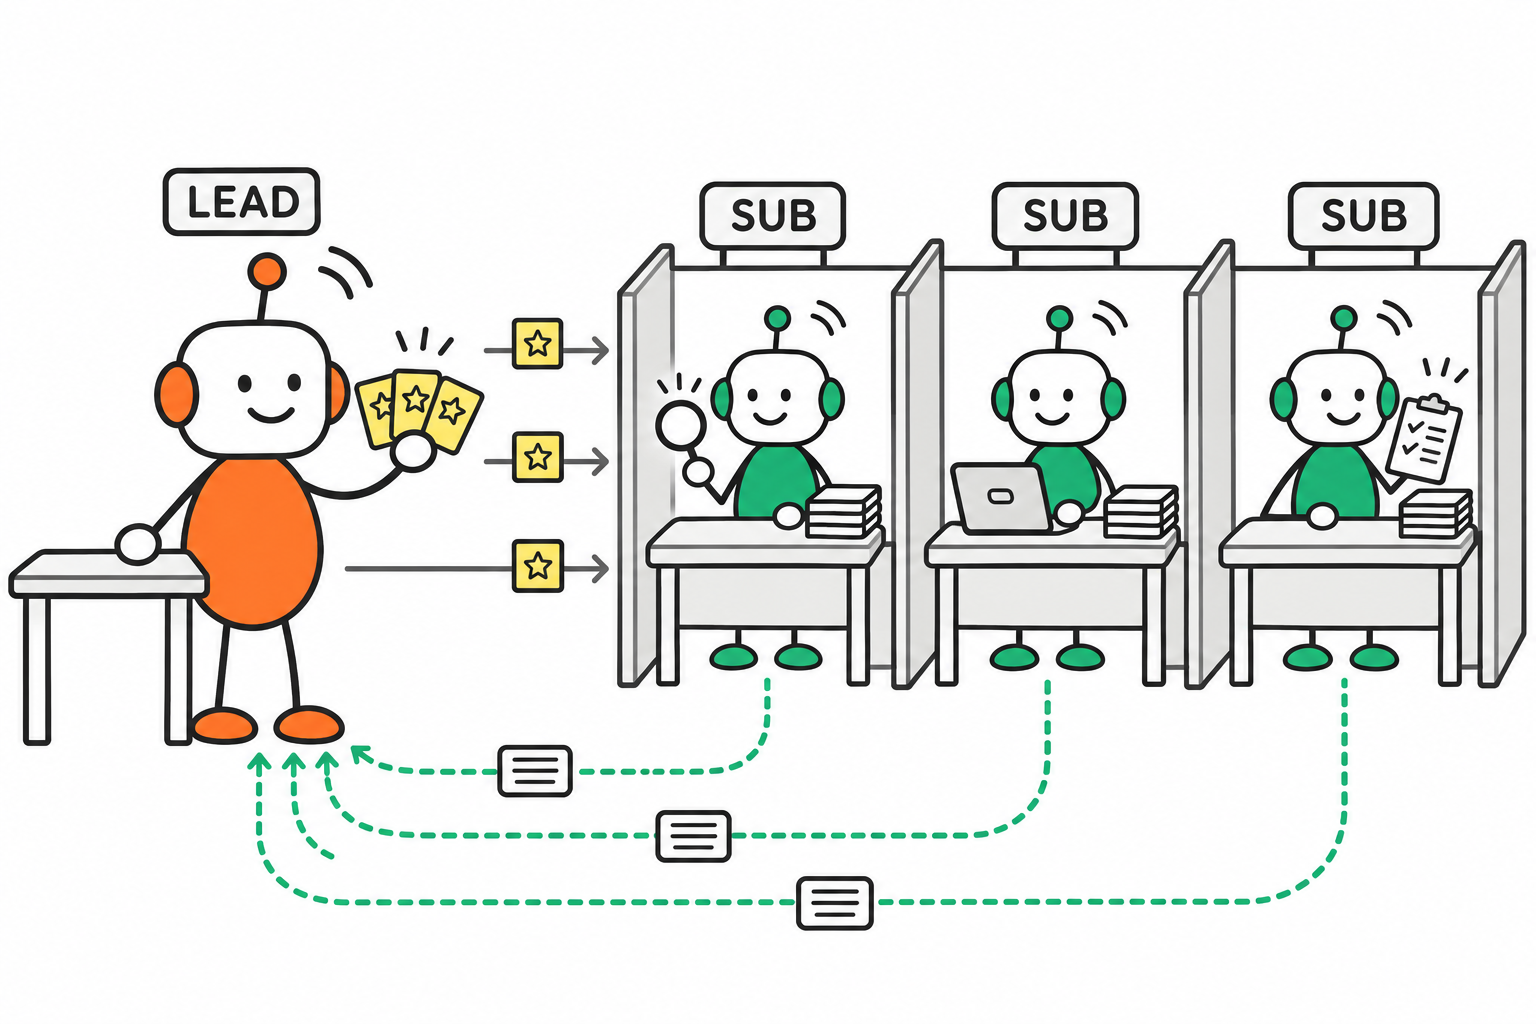
もう一つの方法は、大きな出力(ファイルやログ)を別の場所に置き、必要な部分だけを取り出すやり方です。文脈に載せるのは「どこに何があるか」という軽い参照にとどめ、トークンの消費を抑えます。
self-baking:生の文脈を知識に変える
論文が独自の用語で呼ぶのが self-baking です。生の文脈をそのままためるのではなく、要約や構造化を通じて、再利用できる知識に「焼き固める」処理を指します。論文は、単なる記憶と学習を分けるものがここにあると位置づけています。
固定スキーマの例として論文は、コードレビューの前にファイル間の依存関係や過去の変更履歴、チーム固有のルールを決まった型にまとめる CodeRabbit を挙げています。3つの方式は排他的ではなく、生データを下の層に残しつつ、上の層へ段階的に要約していく階層的なメモリと組み合わせて使われます。
利用:どう共有し、どう選ぶか
エージェント間の共有
複数のエージェントが協力するとき、文脈をどう受け渡すかが問題になります。論文は一つのシステムの中での共有を3つの方式に分けています。
異なるシステムの間で共有する場合は、相手ごとに変換器を用意する方式と、最初から共通の表現を決めておく方式があります。共通の表現にも、JSONのような決まったデータ形式、自然言語の要約、意味ベクトルの3種類があり、精密さ、柔軟さ、コンパクトさのどれを優先するかのトレードオフになる、と論文は整理しています。
選択:全部渡さない
文脈は多ければよいわけではありません。論文は、AIによるコーディングの性能はコンテキストウィンドウの使用率がおよそ50%を超えると下がりやすい、という実務家の報告を引用し、「何を渡すか」の選択が重要だと述べます。選ぶときの観点は次の5つです。
先回りと、一生分の文脈
利用の話題はあと2つあります。一つは能動的なニーズの推定です。会話や行動の履歴から好みを学び、質問の流れから背後の目的を推測し、利用者のつまずきを検知して支援を提案する、という方向です。
もう一つは、生涯にわたる文脈の保存と更新です。論文は4つの課題を挙げます。限られた容量にどれだけ保持できるか(ストレージのボトルネック)、文脈が長くなると注意が薄まること(処理の劣化)、小さな誤りが蓄積した記憶全体に波及すること(システムの不安定化)、そして正しく更新・訂正できているかを測りにくいこと(評価の難しさ)です。その先の構想として、知識を追加・修正・忘却でき、推論の過程を追跡できる「意味的なオペレーティングシステム」が必要になる、と論文は述べています。
現場の実践知:論文が集めた設計のコツ
論文の6.6節は、エージェント開発の現場から出てきた実践知をまとめています。学術的な検証を経たものではなく、開発チームの公開記事などからの引用である点には注意が必要ですが、実務者にとっては最もすぐに使える部分です。
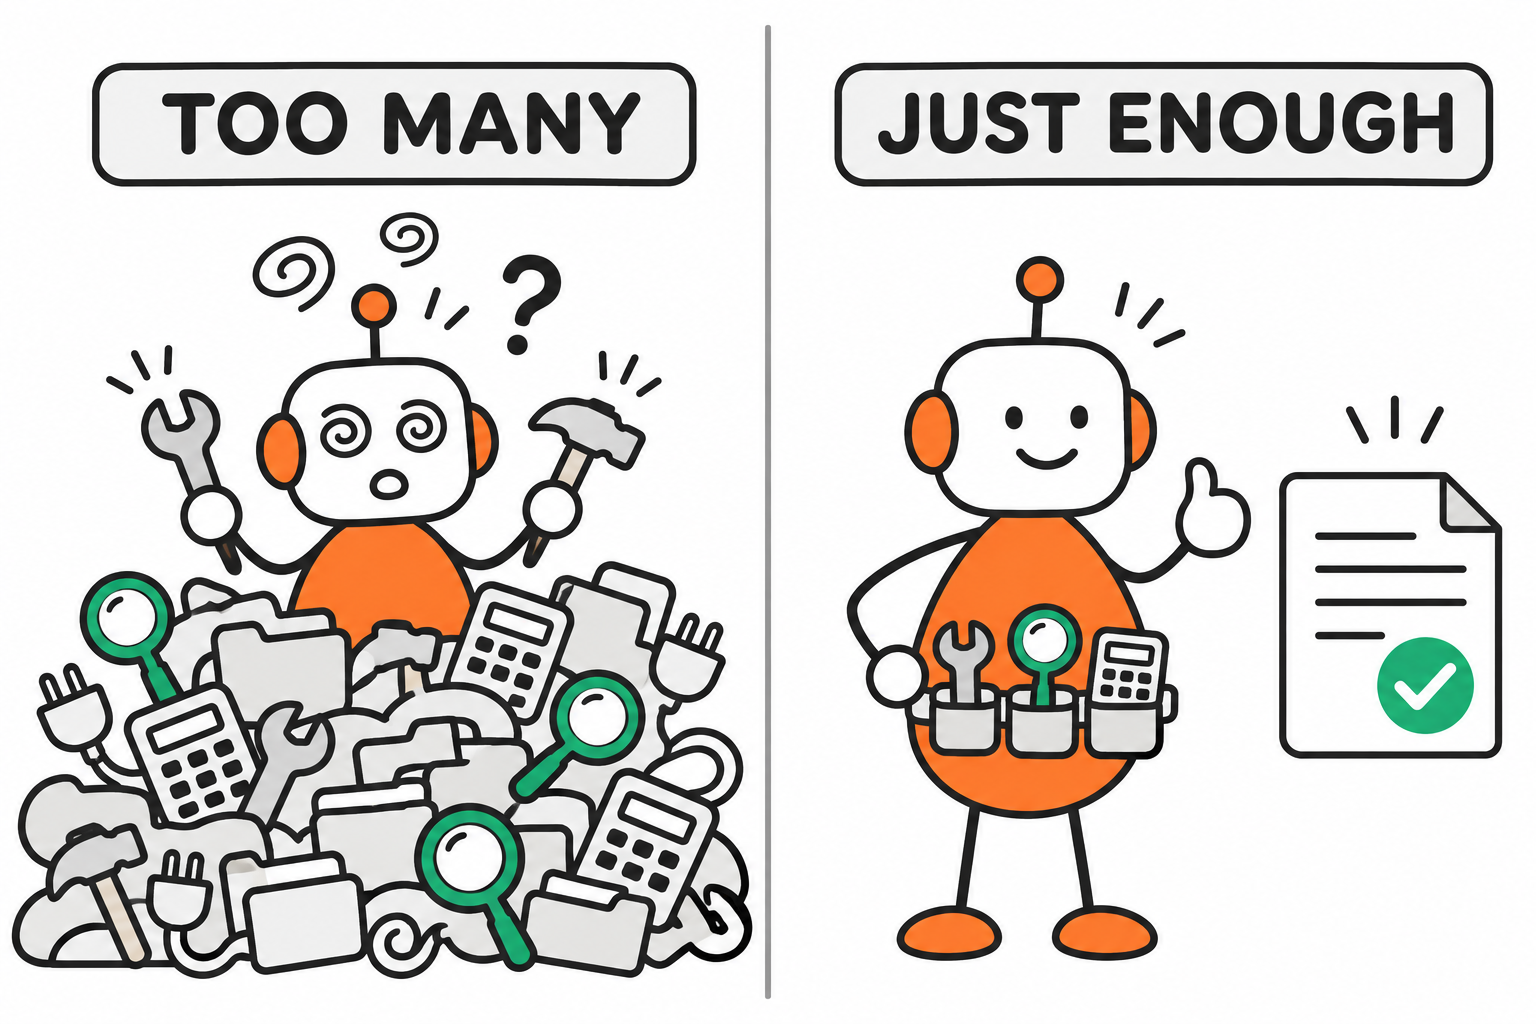
いくつか補足します。ツールの数について論文は、あるモデル(DeepSeek-v3)ではツールが30個を超えると性能が下がり、100個を超えるとほぼ確実に失敗した、という報告を引用しています。特定のモデルについての報告であり、一般的な閾値ではありませんが、「使える道具を増やすほど賢くなる」とは限らないことを示す例です。
KVキャッシュの話は地味ですが、コストと速度に直接効きます。プロンプトの先頭に現在時刻を入れるといった小さな変動でも、キャッシュ全体が無効になります。先頭部分を固定し、履歴は書き換えずに追記していくのが基本です。また、長い作業では todo ファイルで目標を管理し、目標を文脈の末尾で繰り返し確認させる、という小技も紹介されています。
3つの応用例:CLI、Deep Research、脳とコンピュータのインターフェース
7章では、ここまでの枠組みが実際のシステムにどう現れているかを3つの例で示しています。
- CLI(コマンドライン型のコーディング支援):Gemini CLI を例に、プロジェクトの背景や規約を書いた Markdown ファイル(GEMINI.md)を階層的に配置し、起動時に自動で読み込む設計を紹介しています。対話が長くなると、履歴を「全体の目標・重要な知識・ファイルの状態・直近の行動・現在の計画」という定型の要約に置き換えて圧縮します。
- Deep Research(自律的な調査):Tongyi DeepResearch を例に、検索・抽出・追加の問いの生成・統合を繰り返す流れを説明しています。履歴がコンテキストウィンドウを超えやすいため、定期的に要約して「いま分かっていること、足りない情報、次に調べる方向」というスナップショットに圧縮し、以降はそれをもとに推論します。
- 脳とコンピュータのインターフェース(BCI):注意の度合いや認知的な負荷など、外からの観察では得にくい文脈を集められる可能性があります。ただし信号は粗くノイズが多く、まだ方向性を示す段階です。
前の2つに共通するのは、「集める → 定期的に圧縮する → 圧縮したものをもとに推論する」というライフサイクルです。self-baking が実際のシステムでどう使われているかを示す例になっています。
論文が挙げる5つの課題
- 収集が限定的で非効率:多くのシステムは利用者の明示的な入力に頼っています。利用者自身が意図を言葉にできないこともあります。
- 大規模な文脈の保存と管理:蓄積が進むと規模と複雑さが急に増えます。拡張性を保ちながら選択と検索を支える仕組みが必要です。
- モデルの文脈理解の限界:複雑な論理や、画像の中の関係の扱いはまだ弱く、人による設計への依存が残っています。
- 長い文脈での性能の壁:現在主流の Transformer は、文脈が長くなるほど計算量が大きく増えます。別の方式(Mamba など)も、細かな推論では課題が残ります。
- 有用な文脈の選択:必要な情報を見逃したり、ノイズや重複が残ったりします。残す・捨てる・強調するを継続的に調整する仕組みが必要です。
論文は最後に、やや哲学的な展望にも触れています。会話、判断、やり取りの痕跡といった「デジタルな文脈」が、その人を特徴づけるものになっていくという見方です。「人の心はアップロードできないかもしれないが、人の文脈はできる」という趣旨の一文で締めくくられています。ここは実証ではなく、著者の展望として読む部分です。
ビジネスへの含意(筆者の見解)
ここから先は論文の記述ではなく、論文の枠組みを業務に当てはめた筆者の解釈です。
1. 「AIに何を渡すか」は、業務知識の棚卸しである
エントロピーを下げるという見方は、AI活用の成否がどこで決まるかをよく説明します。成果が出ない原因の多くは、モデルの性能ではなく、暗黙の前提が渡されていないことにあります。用語の定義、判断の基準、例外の扱い、過去の経緯。これらを言葉にして渡せる形にすることは、AI以前に、業務の標準化そのものです。
2. 「全部入れる」をやめる
社内文書を丸ごと検索対象にする、過去のやり取りを全部渡す、という設計は、最小十分性の原則に反します。文脈が増えるほどノイズも増え、コストも上がります。「このタスクに必要十分な情報は何か」をタスクごとに決めることが、精度とコストの両方に効きます。データ分析でいえば、変数を増やすほどモデルが良くなるわけではないのと同じ構図です。
3. 生ログではなく「焼き固めた知識」を資産にする
議事録やチャット履歴をためるだけでは、再利用できる資産になりません。self-baking の発想に従えば、定期的に要約し、決まった型(顧客・案件・決定事項・未解決の課題など)に抽出しておくことが、人にとってもAIにとっても使える記憶になります。どの方式にも弱点があるという論文の整理は、要約と構造化を併用する根拠になります。
4. 道具は増やすより絞る
エージェントに接続できるツールが増えると、つい全部つなぎたくなります。しかし選択肢が多いほど迷いも増えます。役割ごとに道具を絞ったサブエージェントに分け、親は目的・出力形式・範囲を明示して任せる。これは人の組織で、担当と権限を明確にするのと同じ設計です。
5. 「いずれ機械が補ってくれる」を前提にしすぎない
論文の描く道筋では、人が担う文脈整備の負担は減っていきます。ただし3.0以降は予測です。現時点では、文脈を整える側の設計力が成果の差になります。逆にいえば、いま整えた業務知識の言語化は、モデルが世代交代しても無駄にならない投資です。
どこから読むか:読者別ガイド
- 全体像だけ掴みたい:1章(序論)と2章(定義と4つの時代)。Figure 1 と Table 1 を見れば骨格が分かります。
- 業務への適用を検討したい:4章(2つの原則)、5.4節(self-baking)、6.6節(実践知)、7章(応用例)。
- エージェントを開発している:5.3節(記憶の階層と分離)、6.1〜6.3節(共有と選択)、6.6節(KVキャッシュとツール設計)。
- 歴史的な背景に関心がある:3章。ユビキタスコンピューティングからの系譜が整理されています。
まとめ
本論文は、コンテキストエンジニアリングを一過性の流行語としてではなく、「人の意図と機械の理解の間を埋める」という数十年来の課題の現在形として位置づけ直したものです。新しい手法を覚えるための論文ではありません。「いま自社がAIに渡している文脈は、収集・管理・利用のどこが弱いのか」を点検するための枠組みとして読むのが、最も実益のある使い方だと筆者は考えています。
出典・参考リンク
Qishuo Hua, Lyumanshan Ye, Dayuan Fu, et al. “Context Engineering 2.0: The Context of Context Engineering.” arXiv:2510.26493 (v1, 2025年10月30日). https://arxiv.org/abs/2510.26493
本記事の内容は2026年11月14日時点で確認した論文 v1 に基づいています。論文は改訂される可能性があるため、引用の際は最新版をご確認ください。記事中のツール数やコンテキスト使用率に関する数値は、論文が他の報告から引用しているもので、論文自身の実験結果ではありません。記事中の図はいずれも論文の記述をもとに筆者が作成したもので、論文中の図版の転載ではありません。
