生成AIの回答をJSON(データを文字で表すための書き方の決まり)で受け取るとき、OpenAIのAPIの Structured Outputs(構造化出力)を使うと、決めた形どおりのJSONが返ってきます。
キーが欠けることも、数値のはずの項目に文章が入ることもありません。では、次の回答はどうでしょうか。
1週間の売上データを渡して、「売れ筋商品」「その売上金額」「コメント」の3項目を頼んだときの回答の例です。
{"売れ筋商品": "緑茶 500ml", "売れ筋の売上金額": 93000, "コメント": "今週の売れ筋は緑茶 500mlで、売上金額は93,000円でした。"}
キーは3つそろっていて、商品名は文字列、金額は整数です。形は、完全に正しい回答です。 ところが、渡したデータでは、緑茶 500ml の売上金額は 41,100円です。93,000円は、幕の内弁当の売上金額です。商品と金額が食い違っています。
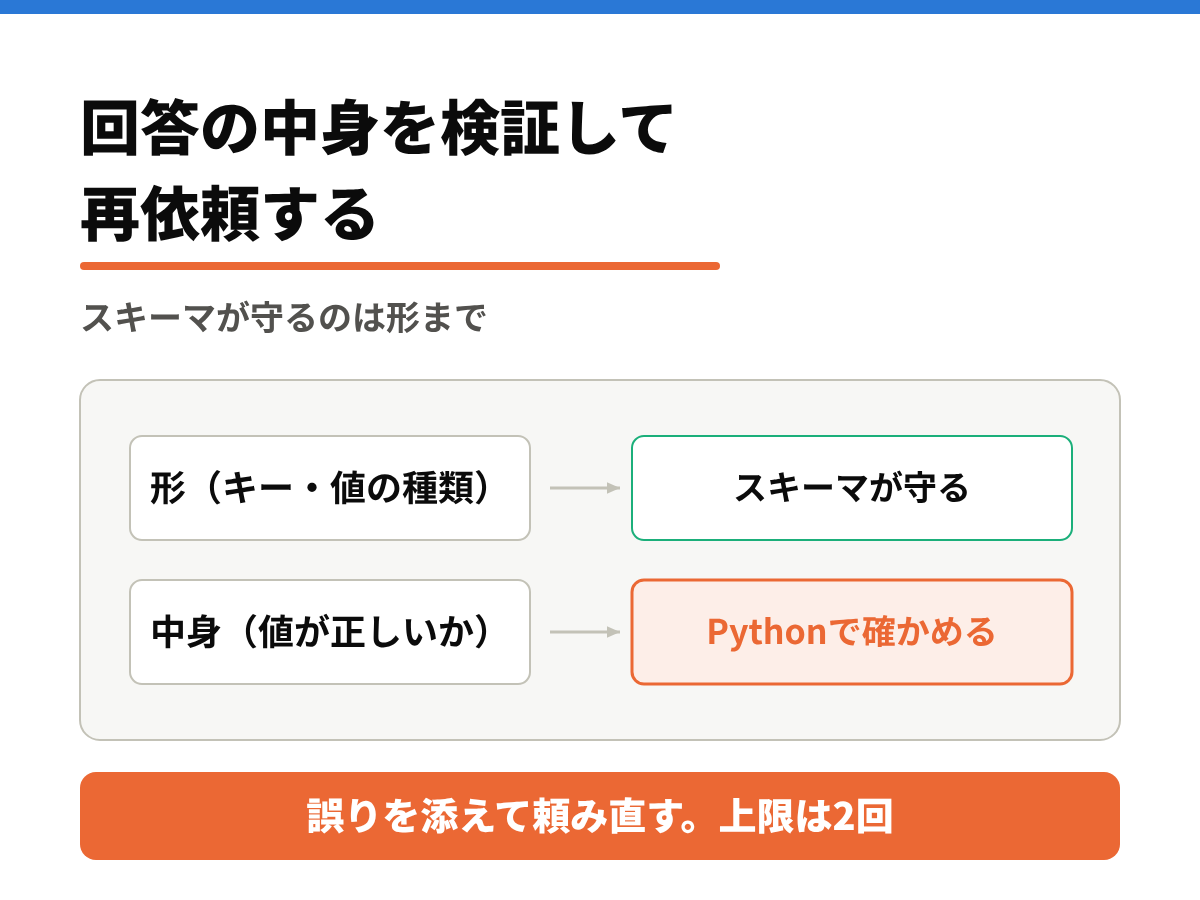
この食い違いは、Structured Outputs では防げません。スキーマ(形の定義)が決めているのは「どんなキーがあり、値はどんな種類か」までで、値が正しいかどうかは決めていないからです。この記事では、形が正しい回答の中身の誤りをPythonで見つけ、誤りを伝えて頼み直す方法を扱います。
先に、この記事の結論を3つ書いておきます。
- スキーマが守るのは、形までです。 商品名がデータにあるか、金額が合っているか、「売れ筋」をどの基準で選んだかは、スキーマでは確かめられません
- 中身は、Pythonで確かめます。 選ぶ基準は項目の説明(
description)に書いて生成AIへ伝え、返ってきた値は、Pythonで計算した値・データにある商品名と照らし合わせます - 誤りが見つかったら、誤りの内容を添えて頼み直します。 頼み直す回数には上限(この記事では2回)を置き、それでも通らない回答は使いません
この記事を読み終えると、次のことができるようになります。
- スキーマで確かめられることと、確かめられないことを区別できる
- 選ぶ基準を、Pydanticの
Field(description=…)で生成AIへ伝えられる - 回答の商品名・金額を、Pythonで計算した値と照らし合わせる関数を書ける
- 誤りの内容を添えて頼み直す処理を、回数の上限つきで書ける
- APIキーがなくても、「回答の例」を使って検証と再依頼の流れを試せる

【月1 特定テーマ講座(12月)】
需要予測エージェントを作る(需要予測 × PYTHON × 生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| JSON | データを文字で表すための書き方の決まり。{"商品名": "幕の内弁当"} のように書く |
| スキーマ | JSONの形(キーの名前・値の種類)の定義 |
| Structured Outputs | OpenAIのAPIにスキーマを渡し、その形どおりのJSONを返させる仕組み。日本語では「構造化出力」 |
| Pydantic | データの形をクラスとして書き、その形に合っているかを確かめるPythonのライブラリ |
| クラス/BaseModel | クラスは、データの形(どんな項目があり、それぞれどんな種類か)を定義するPythonの書き方。BaseModel はPydanticのクラスの土台 |
| Field/description | Field は、項目に追加の情報を付けるPydanticの書き方。description は、その項目に何を書くかの説明文 |
| オブジェクト/属性 | クラスから作った実物がオブジェクト。結果.売れ筋商品 のように . で取り出す中身が属性 |
| 形の検証 | キーがそろっているか、値の種類が合っているかを確かめること。スキーマとPydanticが行う |
| 中身の検証 | 値そのものが正しいか(データにある商品名か、金額が合っているか)を確かめること。自分でPythonのコードを書いて行う |
| 関数/引数 | 関数は、処理に名前を付けてまとめたもの。引数は、関数に渡す値 |
| 集合(set) | 重複のない値の集まり。「この値が含まれているか」を調べるのに使う |
| 正規表現 | 文字の並びのパターンを書く方法。文章の中から「〜円」の部分だけを取り出すのに使う |
| 再依頼 | 回答に誤りがあったとき、誤りの内容を伝えて、もう一度生成AIに頼むこと |
| トークン | 生成AIが文章を数える単位。APIの料金は、入力と出力のトークン数で決まる |
| 環境変数 | パソコン側に置いておく設定値。APIキーをコードに直接書かないために使う |
使うものと準備
この記事のコードは、JupyterLab(ブラウザの中でPythonを少しずつ実行できる開発環境)で動かす前提で書いています。JupyterLabでは、ノートブック(拡張子が .ipynb のファイル)を開き、コードをセル(コードを入力して実行する枠)に貼って、Shift + Enter で1つずつ実行します。この記事のコードも、上から順にセルへ貼って実行してください。
APIキーが必要なのは、生成AIを実際に呼び出すセルだけです。 中身を検証する関数も、頼み直す流れも、「回答の例」を使ってAPIキーなしで試せます。
ライブラリを入れる
次のコマンドで、pandas(表の集計に使う)と openai(OpenAIのAPIを呼ぶのに使う)を入れます。pip は、Pythonのライブラリを入れるためのコマンドです。
pip install pandas openai
このコマンドは、ターミナル(WindowsならPowerShell)で実行します。JupyterLabのセルで実行するときは、先頭に % を付けて %pip install pandas openai とします。JupyterLab自体がまだ入っていない場合は、ターミナルで pip install jupyterlab を実行して入れ、jupyter lab で起動します。
Pydanticは、openai を入れると一緒に入ります(openai が内部で使っているためです)。
売上CSVを読む
使うのは、コンビニの売上を想定した学習用のCSVファイル sample_sales_202607.csv です。CSVは、値をカンマで区切って並べた表のファイルで、Excelでも開けます。2026年7月6日(月)〜12日(日)の7日間について、5商品の売上が1日1行ずつ、計35行入っています。この記事からダウンロードして、ノートブック(.ipynb ファイル)と同じフォルダに置いてください。
以下からダウンロードできます。
import json
import pandas as pd

df = pd.read_csv("sample_sales_202607.csv")
print(df.head())
           日付 曜日       商品名 カテゴリ  単価(円)  数量  売上金額(円)
0  2026-07-06  月   おにぎり(鮭)   主食    160  29     4640
1  2026-07-06  月   アイスコーヒー   飲料    180  28     5040
2  2026-07-06  月    サンドイッチ   軽食    380  26     9880
3  2026-07-06  月     幕の内弁当   弁当    620  19    11780
4  2026-07-06  月  緑茶 500ml   飲料    150  36     5400
import jsonは、JSON(データを文字で表すための書き方の決まり)を扱うための道具を読み込みます。Pythonに最初から入っているので、インストールは要りませんimport pandas as pdは、pandasをpdという短い名前で使えるようにしますpd.read_csv()はCSVファイルを読み込み、表(DataFrame)にします。df.head()は先頭の5行だけを表示します
生成AIに渡すデータと、正解を作る
計算はPythonで済ませ、生成AIには文章を書く役を頼みます。この記事では、そのPythonの計算結果が、あとで回答を確かめるための正解にもなります。
商品別に集計する
商品別 = (
    df.groupby(["商品名", "カテゴリ"], as_index=False)
      .agg(売上金額=("売上金額(円)", "sum"), 販売数量=("数量", "sum"))
      .sort_values("売上金額", ascending=False)
      .reset_index(drop=True)
)
商品別["売上構成比"] = (商品別["売上金額"] / 商品別["売上金額"].sum() * 100).round(1)

print(商品別)
        商品名 カテゴリ   売上金額  販売数量  売上構成比
0     幕の内弁当   弁当  93000   150   33.1
1    サンドイッチ   軽食  64220   169   22.9
2   アイスコーヒー   飲料  41580   231   14.8
3   おにぎり(鮭)   主食  41120   257   14.6
4  緑茶 500ml   飲料  41100   274   14.6
groupby(["商品名", "カテゴリ"], as_index=False)は、商品名(とカテゴリ)が同じ行を1つのグループにまとめますagg(売上金額=("売上金額(円)", "sum"), …)は、グループごとに合計(sum)し、売上金額という名前の列にしますsort_values("売上金額", ascending=False)は売上金額の大きい順に並べ、reset_index(drop=True)は行番号を0から振り直します- 最後の行で、売上構成比(全体の売上に占める割合、%)の列を足しています
5商品ぶんをJSONにする
レコード = 商品別.to_dict("records")
データ = json.dumps(レコード, ensure_ascii=False)

print(len(レコード))
print(データ[:100])
5
[{"商品名": "幕の内弁当", "カテゴリ": "弁当", "売上金額": 93000, "販売数量": 150, "売上構成比": 33.1}, {"商品名": "サンドイッチ", "カテゴリ"
to_dict("records") は、表の1行を1つの辞書にして、リスト(順番に並べたもの)にまとめます。json.dumps() でそれをJSONの文字列にし、ensure_ascii=False で日本語をそのまま出しています。len(レコード) は件数(5件)、データ[:100] は文字列の先頭100文字です。この データ を、生成AIへ渡します。
「売れ筋」の正解は、基準で変わる
生成AIに「売れ筋商品」を答えさせる前に、Pythonで正解を出しておきます。
金額1位 = 商品別.loc[商品別["売上金額"].idxmax()]
数量1位 = 商品別.loc[商品別["販売数量"].idxmax()]

print("売上金額の1位:", 金額1位["商品名"], 金額1位["売上金額"])
print("販売数量の1位:", 数量1位["商品名"], 数量1位["販売数量"])
売上金額の1位: 幕の内弁当 93000
販売数量の1位: 緑茶 500ml 274
商品別["売上金額"].idxmax()は、売上金額がいちばん大きい行の行番号です。商品別.loc[行番号]で、その行を取り出します金額1位["商品名"]のように、取り出した行から列の名前で値を取り出せます
売上金額で見ると幕の内弁当、販売数量で見ると緑茶 500ml です。 しかも幕の内弁当は、販売数量では5商品のうち最下位(150点)です。「売れ筋」という言葉だけでは、どちらを指すのかが決まりません。
形だけを決めても、答えは1つに決まらない
ここは、APIキーがなくても試せます。まず、形だけを書いたクラスを用意します。
from pydantic import BaseModel

class WeeklySummaryPlain(BaseModel):
    売れ筋商品: str
    売れ筋の売上金額: int
    コメント: str
class WeeklySummaryPlain(BaseModel):で、クラスを作ります。(BaseModel)は「PydanticのBaseModelを土台にする」という意味です売れ筋商品: strは「売れ筋商品という項目があり、値は文字列(str)」、売れ筋の売上金額: intは「値は整数(int)」という意味です- クラス名は半角英数字にしています。OpenAIのSDK(ライブラリ)がクラス名をスキーマの名前として送り、その名前には日本語が使えないためです。項目名は日本語でかまいません
このクラスに、2通りの「回答の例」を読ませます。売上金額で選んだ回答と、販売数量で選んだ回答です。
例_金額 = '{"売れ筋商品": "幕の内弁当", "売れ筋の売上金額": 93000, "コメント": "売れ筋は幕の内弁当で、売上金額は93,000円でした。"}'
例_数量 = '{"売れ筋商品": "緑茶 500ml", "売れ筋の売上金額": 41100, "コメント": "売れ筋は緑茶 500mlで、274点売れました。売上金額は41,100円です。"}'

for 例 in (例_金額, 例_数量):
    結果 = WeeklySummaryPlain.model_validate_json(例)
    print("形はOK:", 結果.売れ筋商品, 結果.売れ筋の売上金額)
形はOK: 幕の内弁当 93000
形はOK: 緑茶 500ml 41100
model_validate_json(文字列) は、JSONの文字列を読み、クラスの形に合っているかを確かめたうえで、クラスのオブジェクト(実物)を作ります。2つとも、形の検証を通りました。 どちらもキーが3つそろい、値の種類も合っているからです。
形を決めただけでは、「売れ筋」をどちらの基準で選ぶかは生成AIに任されたままです。そして、どちらの基準で選ばれても、形の検証では気づけません。
選ぶ基準を description に書く
まず、基準を生成AIへ伝えます。Pydanticでは、Field(description=…) で、項目ごとに「何を書くか」の説明を付けられます。
from pydantic import Field

class WeeklySummary(BaseModel):
    売れ筋商品: str = Field(description="売上金額がいちばん大きい商品。入力の商品名を、1文字も変えずに書く")
    売れ筋の売上金額: int = Field(description="その商品の売上金額(円)。入力の数値をそのまま書く")
    コメント: str = Field(description="2文以内。金額を書くときは、入力にある売上金額だけを使う")
= Field(description="…") を足しただけで、項目の名前と種類は変わっていません。「売れ筋商品」は売上金額がいちばん大きい商品、と基準を書きました。この説明は、スキーマの一部として生成AIへ送られます。送られるスキーマを表示して、確かめます。
from openai.lib._pydantic import to_strict_json_schema

送るスキーマ = to_strict_json_schema(WeeklySummary)
for 項目, 中身 in 送るスキーマ["properties"].items():
    print(項目, "→", 中身["description"])
売れ筋商品 → 売上金額がいちばん大きい商品。入力の商品名を、1文字も変えずに書く
売れ筋の売上金額 → その商品の売上金額(円)。入力の数値をそのまま書く
コメント → 2文以内。金額を書くときは、入力にある売上金額だけを使う
to_strict_json_schema(クラス)は、OpenAIのSDKがクラスから作る「実際に送られるスキーマ」を返します。SDKの内部用の関数なので、確かめるためだけに使い、普段のコードには書きません送るスキーマ["properties"]は、項目ごとの定義が入った辞書です。.items()で、項目名と中身を1組ずつ取り出しています
3つの項目とも、説明がスキーマに入っています。
ただし、説明を書いたからといって、そのとおりの値が返る保証はありません。 Structured Outputs が保証するのは、キーと値の種類までです。description は、生成AIが読む「お願い」であって、破られないようにする仕組みではありません。だから、返ってきた値を自分で確かめます。
中身をPythonで検証する
確かめることは3つです。商品名がデータにあるか、基準どおりの商品か、金額がデータと合っているか。 どれも、Pythonで計算した値と比べれば分かります。
検証する関数を書く
import re

商品名の一覧 = set(商品別["商品名"])
金額の一覧 = set(int(v) for v in 商品別["売上金額"]) | {int(商品別["売上金額"].sum())}

def 検証する(結果):
    誤り = []
    if 結果.売れ筋商品 not in 商品名の一覧:
        誤り.append(f"売れ筋商品「{結果.売れ筋商品}」は、入力にない商品名です")
    elif 結果.売れ筋商品 != 金額1位["商品名"]:
        誤り.append(f"売上金額がいちばん大きい商品は「{金額1位['商品名']}」です(回答は「{結果.売れ筋商品}」)")
    if 結果.売れ筋の売上金額 != int(金額1位["売上金額"]):
        誤り.append(f"売れ筋の売上金額は {int(金額1位['売上金額'])} です(回答は {結果.売れ筋の売上金額})")
    for 字 in re.findall(r"([0-9][0-9,]*)円", 結果.コメント):
        if int(字.replace(",", "")) not in 金額の一覧:
            誤り.append(f"コメントの「{字}円」は、入力にない金額です")
    return 誤り
少し長いので、順に説明します。
set(商品別["商品名"])は、5つの商品名の集合(重複のない値の集まり)です。値 not in 集合で、「集合に含まれていない」ことを調べられます金額の一覧は、5商品の売上金額と、その合計(281,020円)の集合です。|は、2つの集合を合わせる書き方ですdef 検証する(結果):で関数を作ります。見つけた誤りを、文章として誤りというリストに足していき(append)、最後に返します。誤りが無ければ、空のリスト[]が返ります- 1つ目の
ifは、商品名がデータに無い場合です。elif(そうでなくて、もし)は、データにはあるが、売上金額の1位ではない場合です - 2つ目の
ifは、金額が、Pythonで出した1位の売上金額と違う場合です re.findall(r"([0-9][0-9,]*)円", 結果.コメント)は、コメントの中から「数字とカンマの並び+円」の部分を探し、数字の部分だけをすべて取り出します。reは正規表現(文字の並びのパターンを書く方法)を扱う、Pythonに最初から入っている道具ですint(字.replace(",", ""))は、"93,000"からカンマを取り除いて、整数の93000にします。それが金額の一覧に無ければ、誤りとして足します
f"…{結果.売れ筋商品}…" は、文字列の中の { } に値を埋め込む書き方(f文字列)です。誤りの文章は、あとでそのまま生成AIへ送ります。 そのため、「何が違っていて、正しくは何か」が読んで分かる文にしています。
4つの回答の例で試す
先ほどの2つに、商品名を書き換えた回答と、コメントの金額が違う回答を足して、4つを検証します。
例_書き換え = '{"売れ筋商品": "幕の内弁当(定番)", "売れ筋の売上金額": 93000, "コメント": "売れ筋は幕の内弁当でした。"}'
例_金額違い = '{"売れ筋商品": "幕の内弁当", "売れ筋の売上金額": 93000, "コメント": "幕の内弁当が95,000円を売り上げました。"}'

for 名前, 例 in [("金額", 例_金額), ("数量", 例_数量), ("書き換え", 例_書き換え), ("金額違い", 例_金額違い)]:
    結果 = WeeklySummary.model_validate_json(例)
    print(名前, "→", 検証する(結果))
金額 → []
数量 → ['売上金額がいちばん大きい商品は「幕の内弁当」です(回答は「緑茶 500ml」)', '売れ筋の売上金額は 93000 です(回答は 41100)']
書き換え → ['売れ筋商品「幕の内弁当(定番)」は、入力にない商品名です']
金額違い → ['コメントの「95,000円」は、入力にない金額です']
- 金額:誤りなし。空のリストが返っています
- 数量:販売数量で選んだ回答です。商品と金額の2つが、基準と違うと分かります
- 書き換え:商品名に「(定番)」が足されています。人が読めば同じ商品ですが、データの商品名とは一致しないので、あとで表と結び付けるときに困ります
- 金額違い:2つの項目は正しいのに、コメントの中の金額がデータにありません。項目の値だけを見ていると見逃す誤りです
4つとも、形の検証は通る回答です。形の検証を通ったあとに、もう1段、中身の検証が要ります。
この検証で拾えないもの
コメントの検証は、半角の数字とカンマで書かれた「〜円」だけを見ています。「95,000円」(全角の数字)や「約9.5万円」のような書き方は、拾えません。 販売数量(「274点」)や割合(「33.1%」)も見ていません。
文章の中の数値を、もれなく確かめるのは難しい作業です。そこで、ルールのほうで書き方をそろえます(あとの「ルールを書く」で、「金額は半角の数字とカンマで書く」と指示しています)。それでも、文章の検証は「見つけられる誤りを見つける」ものであって、「誤りが無いことの証明」にはならない点は、覚えておいてください。
誤りを添えて頼み直す
誤りが見つかったら、同じ依頼をただ繰り返すのではなく、何が誤りだったかを伝えて頼み直します。
頼み直すときの入力を作る
def 再依頼文(データ, 前回, 誤り):
    return (データ
            + "\n\n前回の回答:\n" + 前回
            + "\n\n前回の回答には、次の誤りがありました。誤りを直した回答を返してください。\n"
            + "\n".join(f"- {e}" for e in 誤り))

結果 = WeeklySummary.model_validate_json(例_数量)
print(再依頼文("(5商品ぶんのJSON)", 結果.model_dump_json(), 検証する(結果)))
(5商品ぶんのJSON)

前回の回答:
{"売れ筋商品":"緑茶 500ml","売れ筋の売上金額":41100,"コメント":"売れ筋は緑茶 500mlで、274点売れました。売上金額は41,100円です。"}

前回の回答には、次の誤りがありました。誤りを直した回答を返してください。
- 売上金額がいちばん大きい商品は「幕の内弁当」です(回答は「緑茶 500ml」)
- 売れ筋の売上金額は 93000 です(回答は 41100)
- 入力は、元のデータ・前回の回答・誤りの一覧の3つをつなげた文字列です。
"\n"は改行を表します "\n".join(f"- {e}" for e in 誤り)は、誤りを1つずつ「- 」で始まる行にして、改行でつなげます結果.model_dump_json()は、クラスのオブジェクトをJSONの文字列に戻します
表示を短くするため、ここではデータの部分を「(5商品ぶんのJSON)」という文字に置き換えています。実際には、5商品ぶんのJSONがそのまま入ります。元のデータを毎回入れ直すのは、APIが前回のやり取りを覚えていないためです。
回数の上限を置いて繰り返す
def 検証つきで受け取る(頼む, データ, 最大再依頼=2):
    入力 = データ
    for 回 in range(最大再依頼 + 1):
        結果 = 頼む(入力)                      # WeeklySummary のオブジェクトが返る
        誤り = 検証する(結果)
        print(f"{回 + 1}回目:", "OK" if not 誤り else f"誤り {len(誤り)}件")
        if not 誤り:
            return {"状態": "OK", "結果": 結果, "呼び出し回数": 回 + 1}
        入力 = 再依頼文(データ, 結果.model_dump_json(), 誤り)
    return {"状態": "検証に通らない", "結果": 結果, "誤り": 誤り, "呼び出し回数": 回 + 1}
- 1つ目の引数
頼むには、「入力を受け取り、WeeklySummaryのオブジェクトを返す関数」を渡します。関数を引数として渡せるので、あとで「回答の例を返す関数」と「APIを呼ぶ関数」を入れ替えられます for 回 in range(最大再依頼 + 1):は、最初の1回と、再依頼の2回を合わせて、最大3回繰り返しますif not 誤り:は、「誤りのリストが空なら」という意味です。空なら、そこでreturnして終わります- 誤りがあれば、
再依頼文()で次の入力を作り、繰り返しの先頭に戻ります - 繰り返しが最後まで終わった(3回とも誤りがあった)ときは、
"状態"を"検証に通らない"にして返します
上限を置くのは、終わらない繰り返しを防ぐためです。 頼み直すたびに料金がかかり、時間もかかります。何度頼んでも直らない回答は、頼み方かデータのほうに原因があることが多く、同じ再依頼を重ねても直りません。
回答の例で、流れを試す
APIを呼ぶ代わりに、用意した回答の例を順に返す関数を作って、流れを試します。
回答の例 = [例_数量, 例_金額]          # 1回目は数量で選んだ回答、2回目は正しい回答(説明用)

def 頼む_例(入力):
    return WeeklySummary.model_validate_json(回答の例.pop(0))

受取 = 検証つきで受け取る(頼む_例, データ)
print(受取["状態"], 受取["呼び出し回数"], 受取["結果"].売れ筋商品)
1回目: 誤り 2件
2回目: OK
OK 2 幕の内弁当
回答の例.pop(0)は、リストの先頭の1つを取り出します(取り出したぶん、リストは短くなります)。呼ばれるたびに、次の回答の例が返ります- 1回目は販売数量で選んだ回答なので、誤りが2件見つかります。2回目の回答は検証を通り、
"OK"で終わりました。呼び出しは2回です
次に、3回とも同じ誤りが返ってくる場合です。
回答の例 = [例_数量, 例_数量, 例_数量]   # 3回とも同じ誤り(説明用)

受取 = 検証つきで受け取る(頼む_例, データ)
print(受取["状態"], 受取["呼び出し回数"])
print(受取["誤り"][0])
1回目: 誤り 2件
2回目: 誤り 2件
3回目: 誤り 2件
検証に通らない 3
売上金額がいちばん大きい商品は「幕の内弁当」です(回答は「緑茶 500ml」)
3回で打ち切られ、状態は「検証に通らない」になりました。このとき、最後の回答をそのまま使ってはいけません。 状態が "OK" でない回答は、レポートや表には入れず、誤りの内容と一緒に「要確認」として残し、人が確かめます。
実際に呼び出す
ここでは、生成AIを実際に呼び出します。APIキーが必要です。
APIキーとモデルIDを環境変数に入れる
APIの利用は有料です(使った量に応じた従量課金。単価は OpenAIの料金ページ で確認できます)。ChatGPTの有料プランを契約していても、APIの利用料はその中に含まれません。APIキーは、OpenAIの開発者向けサイト(API keys のページ)で作ります。
APIを呼ぶには、APIキーとモデルID(使うモデルの名前)が要ります。どちらもコードには直接書かず、環境変数(パソコン側に置いておく設定値)から読みます。
- APIキーをコードに書くと、ノートブックを人に渡したときに、キーも一緒に渡ってしまいます。 漏れたキーは他人に使われ、料金が発生するおそれがあります
- モデルIDは、新しいモデルが出ると変わります。 Structured Outputs は、対応しているモデルでしか使えません。使えるモデルIDは、OpenAIの公式ドキュメントのモデル一覧で確認してください
Windowsなら、PowerShell(Windowsに入っているコマンド入力の画面)で次のように設定し、同じ画面から JupyterLab を起動します。"…" の中は、自分のAPIキーとモデルIDに置き換えてください。
$env:OPENAI_API_KEY = "ここにAPIキーを貼る"
$env:OPENAI_MODEL = "使うモデルのID"
jupyter lab
Anaconda Prompt(Anacondaに付いてくる、コマンドプロンプト形式の画面)を使っている場合は、書き方が変わります。値をダブルクォートで囲まないのがポイントです。囲むと、ダブルクォートまで値の一部になってしまいます。
set OPENAI_API_KEY=ここにAPIキーを貼る
set OPENAI_MODEL=使うモデルのID
jupyter lab
macOS・Linuxのターミナルでは、次のとおりです。
export OPENAI_API_KEY="ここにAPIキーを貼る"
export OPENAI_MODEL="使うモデルのID"
jupyter lab
いずれも、設定したウィンドウの中だけで有効です。別のウィンドウから起動した JupyterLab では読めないので、設定したのと同じウィンドウで jupyter lab を実行してください。すでに JupyterLab を開いている場合は、いったん閉じてから起動し直します。
参考までに、Google Colab を使う場合は、画面左側の鍵のアイコン(シークレット)に OPENAI_API_KEY という名前でAPIキーを登録し、セルで次のように読み込みます。
import os
from google.colab import userdata

os.environ["OPENAI_API_KEY"] = userdata.get("OPENAI_API_KEY")
os.environ["OPENAI_MODEL"] = "使うモデルのID"
ルールを書く
ルール = """あなたは小売店の売上を説明する担当者です。
入力はJSONで、5商品ぶんの売上金額・販売数量・売上構成比(全体に占める割合、%)が入っています。
1週間の売上をまとめてください。
金額は、半角の数字とカンマで「93,000円」のように書いてください。"""
""" で囲むと、改行を含む長い文字列を書けます。項目ごとの説明はクラスの description に書いたので、ルールには全体の役割と、金額の書き方だけを書いています。金額の書き方をそろえておくと、コメントの検証で拾いやすくなります。
APIを呼ぶ関数に入れ替える
import os
from openai import OpenAI

client = OpenAI()                      # OPENAI_API_KEY を環境変数から読む
MODEL = os.environ["OPENAI_MODEL"]     # モデルIDも環境変数から読む

def 頼む_API(入力):
    response = client.responses.parse(
        model=MODEL,
        instructions=ルール,
        input=入力,
        text_format=WeeklySummary,     # 形と、項目ごとの説明(description)を渡す
        max_output_tokens=600,         # 出力の上限(トークン数)
    )
    return response.output_parsed      # WeeklySummary のオブジェクト

受取 = 検証つきで受け取る(頼む_API, データ)
print(受取["状態"], 受取["呼び出し回数"])
OpenAI()は、環境変数OPENAI_API_KEYからAPIキーを読んで、APIを呼ぶ準備をしますclient.responses.parse(…)がAPIの呼び出しです。instructionsに毎回同じルールを、inputにその都度変わる入力を渡します。text_format=WeeklySummaryで、クラスそのものを渡しますresponse.output_parsedが、WeeklySummaryのオブジェクトになった回答です- 変えたのは、
検証つきで受け取る()に渡す関数だけです。 検証と再依頼の流れは、回答の例で試したものと同じコードが動きます
回答が出力の上限で途中で切れたとき(parse() が例外を出します)や、生成AIが回答を断ったとき(output_parsed が None になります)の扱いは、ここでは省いています。実際に使うときは、頼む_API の中でそれらを確かめてください。
検証できる値は、Pythonの値を使う
ここまで読んで、気づいた方もいるかもしれません。検証のコードが書けるということは、正解をPythonで出せるということです。 それなら、その項目は生成AIに書かせず、Pythonの値をそのまま使えば、誤りは起きません。
| 項目 | Pythonで出せるか | おすすめの扱い |
|---|---|---|
| 売れ筋商品 | 出せる | Pythonの値を使う(生成AIに頼まない) |
| 売れ筋の売上金額 | 出せる | Pythonの値を使う(生成AIに頼まない) |
| コメント | 出せない | 生成AIに頼み、中の金額をPythonで検証する |
この記事では、検証と再依頼の流れを見せるために、あえて商品名と金額も生成AIに答えさせました。実際に使うときは、生成AIに頼むのは、Pythonでは書けない部分(文章)だけにするのが安全です。検証と再依頼が本当に必要になるのは、その文章の中に出てくる商品名や数値に対してです。
Claude・Geminiではここが違う
検証する()・再依頼文()・検証つきで受け取る() は、3社とも同じものを使えます。 Pythonだけで書いてあり、どの会社のAPIにも依存していないからです。変わるのは、APIを呼ぶ関数の中だけです。
| OpenAI | Gemini | Claude | |
|---|---|---|---|
| 呼び出す関数 | responses.parse() |
models.generate_content() |
messages.parse() |
| クラスを渡す引数 | text_format= |
response_schema= |
output_format= |
| 受け取り方 | output_parsed |
parsed |
parsed_output |
description |
スキーマに入って送られる | スキーマに入って送られる | スキーマに入って送られる |
| 中身の検証 | どの会社でも、自分のPythonコードで行う | ||
APIキーは GEMINI_API_KEY・ANTHROPIC_API_KEY、モデルIDは GEMINI_MODEL・CLAUDE_MODEL という名前の環境変数に入れておく前提で書いています。設定のしかたは、OpenAIのときと同じです。
Gemini の場合
pip install google-genai で入れておきます。
from google import genai
from google.genai import types

gemini = genai.Client()                # GEMINI_API_KEY を環境変数から読む

def 頼む_Gemini(入力):
    response = gemini.models.generate_content(
        model=os.environ["GEMINI_MODEL"],
        contents=入力,
        config=types.GenerateContentConfig(
            system_instruction=ルール,
            response_mime_type="application/json",
            response_schema=WeeklySummary,
            max_output_tokens=600,
        ),
    )
    return response.parsed

受取 = 検証つきで受け取る(頼む_Gemini, データ)
Geminiでは、ルールは config の system_instruction に、クラスは response_schema に渡し、response.parsed で受け取ります。回答をクラスに読み込めなかったときは response.parsed が None になるので、実際に使うときは None かどうかを確かめます。
Claude の場合
pip install anthropic で入れておきます。
from anthropic import Anthropic

claude = Anthropic()                   # ANTHROPIC_API_KEY を環境変数から読む

def 頼む_Claude(入力):
    message = claude.messages.parse(
        model=os.environ["CLAUDE_MODEL"],
        max_tokens=600,                # 出力の上限(Claudeでは必須)
        system=ルール,
        messages=[{"role": "user", "content": 入力}],
        output_format=WeeklySummary,
    )
    return message.parsed_output

受取 = 検証つきで受け取る(頼む_Claude, データ)
Claudeでは、ルールは system に、クラスは output_format に渡し、message.parsed_output で受け取ります。出力の上限 max_tokens は必ず指定します。
まとめ
今回のポイントです。
| 覚えておくこと | |
|---|---|
| スキーマが守るもの | キーがそろっていること、値の種類。値が正しいかどうかは守らない |
| 基準の伝え方 | Field(description="…") に書く。スキーマに入って送られるが、守られる保証はない |
| 中身の検証 | Pythonで計算した値・データにある商品名と比べる。誤りは、読んで分かる文章のリストにする |
| 再依頼 | 元のデータ・前回の回答・誤りの一覧を送る。回数に上限を置く(この記事では2回) |
| 通らなかった回答 | 使わない。誤りの内容と一緒に残し、人が確かめる |
| 設計 | Pythonで出せる値は、生成AIに書かせない。頼むのは文章だけにする |