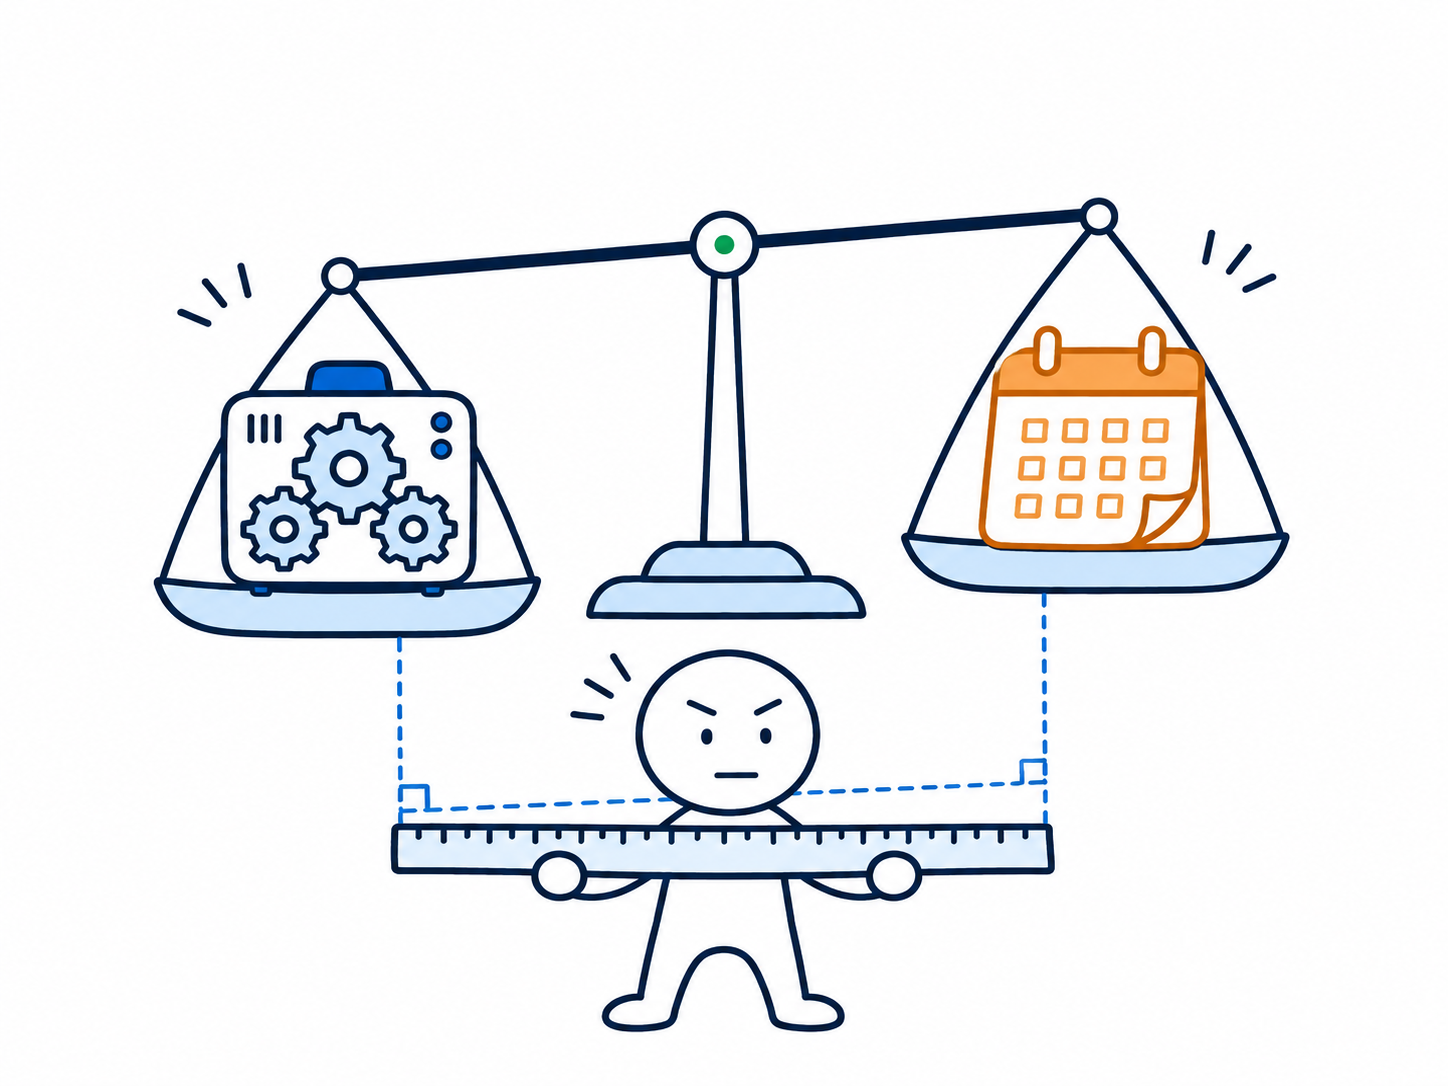
「この需要予測モデルの誤差は、平均で3.6個です」
こう報告されても、それが良いのか悪いのかは分かりません。
判断するには、比べる相手と、何で測るかの2つが必要です。
この記事では、数行で書ける単純な予測(ベースライン)を3つ作り、MAE・SMAPE・MAE比という3つの物差しで、予測モデルと比べます。
評価のしかた(時系列分割とバックテスト)は、前回の記事「需要予測の精度は『評価のしかた』で変わる」で扱いました。この記事は、その続きです。
この記事の概要です。
- 単純な予測と比べないと、モデルの価値は分からない。この記事の例では、モデルのMAEは 3.59。「同じ曜日の直近4回の平均」という単純な予測は 3.68 で、差は 0.09 個しかありませんでした。
- 物差しによって、答える問いが違う。MAE は「何個ずれるか」、SMAPE は「何%ずれるか」、MAE比は「単純な予測の何倍か」です。
- 物差しを変えると、「誤差の大きい商品」が入れ替わる。MAE で見ると、いちばん誤差が大きいのは、よく売れる弁当A。SMAPE で見ると、あまり売れないデザートC です。
ベースライン予測とは、予測モデルの比較相手にする、単純な予測のことです。「前の週の同じ曜日の実績を、そのまま来週の予測にする」のように、数行で計算できるものを使います。MAE比とは、モデルの MAE をベースラインの MAE で割った値で、1より小さければ、モデルは単純な予測より誤差が小さいことを表します。

【月1 特定テーマ講座(12月)】
需要予測エージェントを作る(需要予測 × PYTHON × 生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。読んでいて分からなくなったら、ここに戻ってください。
| 用語 | 意味 |
|---|---|
| ベースライン | 比べる相手にする、単純な予測 |
| 前週同曜日 | 7日前の実績を、そのまま予測にする方法 |
| 4週同曜日平均 | 同じ曜日の直近4回(7・14・21・28日前)の実績を平均する方法 |
| 直近28日平均 | 基準日までの28日間の実績を、曜日に関係なく平均する方法 |
| 基準日 | 「この日までのデータが手元にある」と決める日 |
| バックテスト | 基準日をずらしながら、過去の各時点で予測と実績を比べること |
| MAE | 平均絶対誤差。予測と実績の差(個数)の平均 |
| SMAPE | 対称平均絶対パーセント誤差。差を、予測と実績の平均で割って%にしたものの平均 |
| MAPE | 平均絶対パーセント誤差。差を実績で割る。実績が0の日は計算できない |
| バイアス | 予測から実績を引いた値の平均。プラスなら多め、マイナスなら少なめに予測している |
| MAE比 | モデルのMAE ÷ ベースラインのMAE |
比べる相手を決める:3つのベースライン
予測モデルを作ると、複雑な計算をしているぶん、良い予測が出ているように感じます。
しかし、日次の販売数量は「先週の同じ曜日と、だいたい同じ」ことが多いデータです。何も学習しなくても、そこそこ当たります。
モデルの価値は、この「そこそこ」をどれだけ上回ったかで測ります。
3つのベースラインには、それぞれ癖があります。
- 前週同曜日:曜日の癖をそのまま引き継げます。ただし、7日前がたまたま多かった・少なかった場合、そのぶれも引き継ぎます。
- 4週同曜日平均:4回ぶんを平均するので、たまたまのぶれがならされます。そのかわり、売れ方が変わったときの反応は遅くなります。
- 直近28日平均:28日ぶんを使うので、いちばん安定します。ただし曜日を見ないので、平日と週末で売れ方が違う商品では外れます。
何で測るかを決める:4つの物差し
MAE:何個ずれるか
予測と実績の差の、絶対値の平均です。予測が12個で実績が8個なら、差は4個。予測が3個で実績が1個なら、差は2個。
この2日のMAEは 3個です。単位が「個」なので、現場の感覚と結びつけやすい物差しです。
弱点は、よく売れる商品ほど大きくなることです。
1日に50個売れる商品の「4個のずれ」と、1日に3個しか売れない商品の「2個のずれ」は、個数では前者が大きくても、深刻なのは後者です。
SMAPE:何%ずれるか
差を、予測と実績の平均で割って、%にします。
予測12個・実績8個なら、差4個 ÷ 平均10個 = 40%。予測3個・実績1個なら、差2個 ÷ 平均2個 = 100%です。
割合なので、売れ方の違う商品どうしを比べられます。
似た物差しに MAPE(差を実績で割る)がありますが、実績が0個の日は割り算ができません。
日次の販売データには0個の日があるので、この記事では SMAPE を使います。
SMAPE は、予測も実績も0なら0%、片方だけが0なら200%(上限)になります。
弱点は、あまり売れない商品ほど大きくなることです。1個のずれでも、分母が小さいので、大きな%になります。
バイアス:どちら向きにずれるか
予測から実績を引いた値を、絶対値を取らずに平均します。プラスなら多めに、マイナスなら少なめに予測する癖がある、ということです。
多めの予測は売れ残りに、少なめの予測は欠品につながるので、向きは実務で大事な情報です。
ただし、多めの日と少なめの日が打ち消し合うと0に近づくので、バイアスが0でも誤差が小さいとは限りません。
MAE比:単純な予測の何倍か
モデルの MAE を、ベースラインの MAE で割ります。0.8 なら「単純な予測より誤差が2割小さい」、1.0 以上なら「単純な予測と同じか、それより悪い」です。
商品ごとの売れ方の違いが分母と分子で打ち消されるので、商品どうしを比べるのにも使えます。
Pythonで確かめる:3商品・4つの方式・4つの物差し
必要なライブラリは pandas、numpy、scikit-learn の3つです。コードは上から順につなげると、1本のスクリプトとしてそのまま実行できます。
練習用のデータと特徴量を作る
ふだんの売れ方が違う3つの商品(弁当A:1日に50個前後、おにぎりB:十数個、デザートC:数個)の、2年ぶんの日次の販売数量を作ります。
乱数の種を固定しているので、誰が実行しても同じ数字になります。特徴量は、曜日、日付の通し番号、7・14・21・28日前の販売数量です。
以下、コードです。
import numpy as np
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor

# 1. 練習用のデータを作る(3商品・2年分の日次の販売数量)
rng = np.random.default_rng(0)
dates = pd.date_range("2024-09-01", "2026-08-31", freq="D")
weekday_factor = np.array([1.0, 1.0, 1.0, 1.0, 1.1, 0.7, 0.6])[dates.dayofweek]   # 月〜日の曜日の癖
frames = []
for name, base in [("弁当A", 60), ("おにぎりB", 20), ("デザートC", 4)]:        # ふだんの売れ方が違う3商品
    level = base * np.exp(np.cumsum(rng.normal(0, 0.012, len(dates))))          # ゆっくり変わる水準
    frames.append(pd.DataFrame({"product": name, "date": dates, "qty": rng.poisson(level * weekday_factor)}))
df = pd.concat(frames, ignore_index=True)

# 2. 特徴量を作る(7日先までの予測に使える値だけ)
df["dow"] = df["date"].dt.dayofweek
df["day_no"] = (df["date"] - df["date"].min()).dt.days
for k in (7, 14, 21, 28):
    df[f"lag{k}"] = df.groupby("product")["qty"].shift(k)                       # k日前の販売数量(商品ごと)
df = df.dropna().reset_index(drop=True)
FEATURES = ["dow", "day_no", "lag7", "lag14", "lag21", "lag28"]
4つの方式で、同じ56日ぶんを予測する
基準日を7日ずつずらして8回、「基準日までのデータで、翌7日を予測する」ことをくり返します。
そのつど、3つのベースラインと、予測モデル(勾配ブースティング)の4つで予測します。
4つとも、同じ日を、同じ条件で予測していることが大事です。
以下、コードです。
# 3. バックテスト:4つの方式で、同じ56日ぶんを予測する
rows = []
last = df["date"].max()
for name, g in df.groupby("product", sort=False):
for i in range(8, 0, -1):
origin = last - pd.Timedelta(days=7 * i) # 基準日
train = g[g["date"] <= origin]
test = g[(g["date"] > origin) & (g["date"] <= origin + pd.Timedelta(days=7))].copy()
model = HistGradientBoostingRegressor(loss="poisson", random_state=0).fit(train[FEATURES], train["qty"])
test["前週同曜日"] = test["lag7"] # ベースライン1:7日前の実績をそのまま使う
test["4週同曜日平均"] = test[["lag7", "lag14", "lag21", "lag28"]].mean(axis=1) # ベースライン2:同じ曜日の直近4回の平均
test["直近28日平均"] = train["qty"].tail(28).mean() # ベースライン3:基準日までの28日の平均(曜日を見ない)
test["モデル"] = model.predict(test[FEATURES])
rows.append(test)
bt = pd.concat(rows, ignore_index=True)
METHODS = ["前週同曜日", "4週同曜日平均", "直近28日平均", "モデル"]
4つの物差しで測る
物差しは、どれも数行の関数です。方式別の表と、商品別の表を出します。
以下、コードです。
# 4. 3つの物差し(+バイアス)
def mae(pred, actual):                      # 平均絶対誤差(個)
    return float(np.mean(np.abs(pred - actual)))


def smape(pred, actual):                    # 対称平均絶対パーセント誤差(%)。予測も実績も0の日は0とする
    denom = np.abs(pred) + np.abs(actual)
    return float(np.mean(np.where(denom == 0, 0.0, 200.0 * np.abs(pred - actual) / np.where(denom == 0, 1, denom))))


def bias(pred, actual):                     # バイアス(個)。プラスなら多めに、マイナスなら少なめに予測している
    return float(np.mean(pred - actual))


print("■ 方式別(3商品をまとめて計算)")
overall = pd.DataFrame({m: {"MAE": mae(bt[m], bt["qty"]), "SMAPE": smape(bt[m], bt["qty"]), "バイアス": bias(bt[m], bt["qty"])} for m in METHODS}).T
overall["MAE比"] = overall["MAE"] / overall.loc["前週同曜日", "MAE"]
print(overall.round(2).to_string())

print()
print("■ 商品別(モデルと、前週同曜日)")
out = []
for name, g in bt.groupby("product", sort=False):
    m, b = mae(g["モデル"], g["qty"]), mae(g["前週同曜日"], g["qty"])
    out.append({"商品": name, "平均販売数量": g["qty"].mean(), "MAE": m, "SMAPE": smape(g["モデル"], g["qty"]),
                "バイアス": bias(g["モデル"], g["qty"]), "前週同曜日のMAE": b, "MAE比": m / b})
print(pd.DataFrame(out).round(2).to_string(index=False))
以下、実行結果です。
■ 方式別(3商品をまとめて計算)
          MAE  SMAPE  バイアス  MAE比
前週同曜日    4.99  32.64 -0.23  1.00
4週同曜日平均  3.68  25.83 -0.22  0.74
直近28日平均  4.65  29.24 -0.22  0.93
モデル      3.59  25.45 -0.32  0.72

■ 商品別(モデルと、前週同曜日)
   商品  平均販売数量  MAE  SMAPE  バイアス  前週同曜日のMAE  MAE比
  弁当A   47.52 6.21  13.92  0.08       9.21  0.67
おにぎりB   12.55 2.91  24.99 -0.97       3.71  0.78
デザートC    4.68 1.67  37.45 -0.09       2.04  0.82
結果を読む
方式別:モデルは、単純な予測にどれだけ勝ったか
| 方式 | MAE | SMAPE | バイアス | MAE比 |
|---|---|---|---|---|
| 前週同曜日 | 4.99 | 32.64 | -0.23 | 1.00 |
| 4週同曜日平均 | 3.68 | 25.83 | -0.22 | 0.74 |
| 直近28日平均 | 4.65 | 29.24 | -0.22 | 0.93 |
| モデル | 3.59 | 25.45 | -0.32 | 0.72 |
- モデルは、前週同曜日には大きく勝っている。MAE は 4.99 から 3.59 へ、MAE比は 0.72 です。「単純な予測より誤差が約3割小さい」と言えます。
- しかし、4週同曜日平均との差は 0.09 個しかない。3.68 と 3.59 です。4つの数字を平均するだけの計算が、機械学習のモデルとほぼ同じ精度を出しています。比べる相手に前週同曜日しか置いていなければ、「3割改善」という数字だけが残り、この事実には気づけません。
- 直近28日平均は、このデータでは弱い。平日と週末で売れ方が違うのに、曜日を見ていないからです。
- バイアスは、4つとも少しマイナス。どの方式も、わずかに少なめに予測しています。モデルが −0.32 でいちばん大きいので、MAE が小さくても、欠品の側に寄りやすい点は気に留めておきます。
この結果から「モデルは要らない」と言いたいのではありません。
販促や価格のように、過去の実績の平均では表せない情報を使えるのは、モデルの強みです。
言いたいのは、比べる相手を複数置いて初めて、モデルに何を期待してよいかが分かるということです。
商品別:物差しを変えると、順位が入れ替わる
| 商品 | 1日の平均 | MAE | SMAPE | バイアス | MAE比 |
|---|---|---|---|---|---|
| 弁当A | 47.52 | 6.21 | 13.92 | 0.08 | 0.67 |
| おにぎりB | 12.55 | 2.91 | 24.99 | -0.97 | 0.78 |
| デザートC | 4.68 | 1.67 | 37.45 | -0.09 | 0.82 |
- MAE がいちばん大きいのは弁当A(6.21個)、SMAPE がいちばん大きいのはデザートC(37.45%)。
「誤差の大きい商品はどれか」という問いの答えが、物差しで逆になります。
MAE だけを見ていると、よく売れる商品ばかりが「問題あり」に見えます。
- デザートCは、1.67個のずれでも、割合では4割近い。1日に5個弱しか売れないからです。発注が1個単位の商品では、この割合の大きさが効いてきます。
- おにぎりBは、バイアスが −0.97。1日の平均 12.55 個に対して、約8%少なめに予測しています。MAE や SMAPE では見えない癖です。
- MAE比は、3商品とも1より小さい。どの商品でも、モデルは前週同曜日に勝っています。ただし勝ち方は、弁当Aの 0.67 から、デザートCの 0.82 まで差があります。
全体の数字(MAE 3.59)は、3商品の56日ぶんをまとめた平均です。
よく売れる弁当Aの誤差に引っぱられるので、全体だけを見ていると、デザートCの「4割ずれる」や、おにぎりBの「少なめに外す」は見えません。
自分のデータで評価するときのチェックリスト
- ベースラインを2つ以上置いたか(前週同曜日と、同曜日の平均など)
- モデルとベースラインを、同じ日・同じ条件で比べたか
- 個数の物差し(MAE)と、割合の物差し(SMAPE)を両方見たか
- バイアスの向きを見たか(欠品が困るのか、売れ残りが困るのかで、許せる向きが変わる)
- 全体だけでなく、商品別に見たか
- MAE比が1に近い・1を超える商品を、「予測を信用しにくい商品」として扱うしくみがあるか
まとめ
今回のポイントです。
- 予測モデルは、単純な予測(ベースライン)と比べて初めて評価できる。ベースラインは複数置く
- MAE は個数、SMAPE は割合、バイアスは向き、MAE比は単純な予測との比。答える問いが違うので、組み合わせて見る
- 全体の数字だけでなく、商品別に見る。物差しを変えると、誤差の大きい商品は入れ替わる
よくある質問
Q. MAPE ではだめですか
実績が0個の日がなければ使えます。
日次の商品別データでは0個の日が出やすく、そのたびに計算できなくなるので、SMAPE のほうが扱いやすいです。
なお、SMAPE にも「販売数量の少ない商品で大きく出る」という癖があるので、MAE と一緒に見ます。
Q. MAE比が1を超えたら、どうすればよいですか
その商品では、モデルより単純な予測のほうが良い、ということです。
まず原因を確かめます(欠品や販促の記録漏れ、発売直後で履歴が短い、など)。
原因が分からないあいだは、その商品だけベースラインの予測を使う、あるいは「予測を信用しにくい商品」として担当者の確認に回す、という扱いが現実的です。
Q. バイアスは、どのくらいなら許せますか
決まった基準はありません。
目安の1つは、その商品のふだんの販売数量に対する割合です。この記事のおにぎりBは約8%でした。
たとえば「同じ向きのずれが何週も続き、ふだんの1割を超えたら確認する」のように、割合と続き方の両方で決めておくと、運用で迷いません。
Q. ベースラインは、どれを選べばよいですか
1つに決めず、複数置きます。
この記事のデータでは4週同曜日平均が、D店のデータでは直近28日平均が、いちばん手ごわい相手でした。
報告に使う MAE比の分母は、説明しやすい「前週同曜日」にそろえ、ほかのベースラインは表に並べておく、という使い方がおすすめです。