Pythonで売上を集計し、その結果を生成AIに渡して、コメント(説明の文章)を書いてもらう。このとき、集計結果をJSON(データを文字で表すための書き方の決まり)にして渡す方法がよく使われます。表の形をそのまま文字にできるので、生成AIが読み違えにくいからです。
JSONは、Pythonの json.dumps() という関数を1回呼べば作れます。ところが、pandasで集計した結果には、そのままではJSONにできない値が混ざります。しかも、そのうちの1つはエラーを出しません。気づかないまま、壊れたJSONを生成AIへ送ってしまいます。
この記事では、コンビニの売上データを使って、日別の売上と前日比(前の日と比べた増減の割合)をJSONにし、どこで壊れるのかを1つずつ確かめます。そのうえで、送る前に止める方法と、OpenAIのAPIへ渡すところまで進みます。
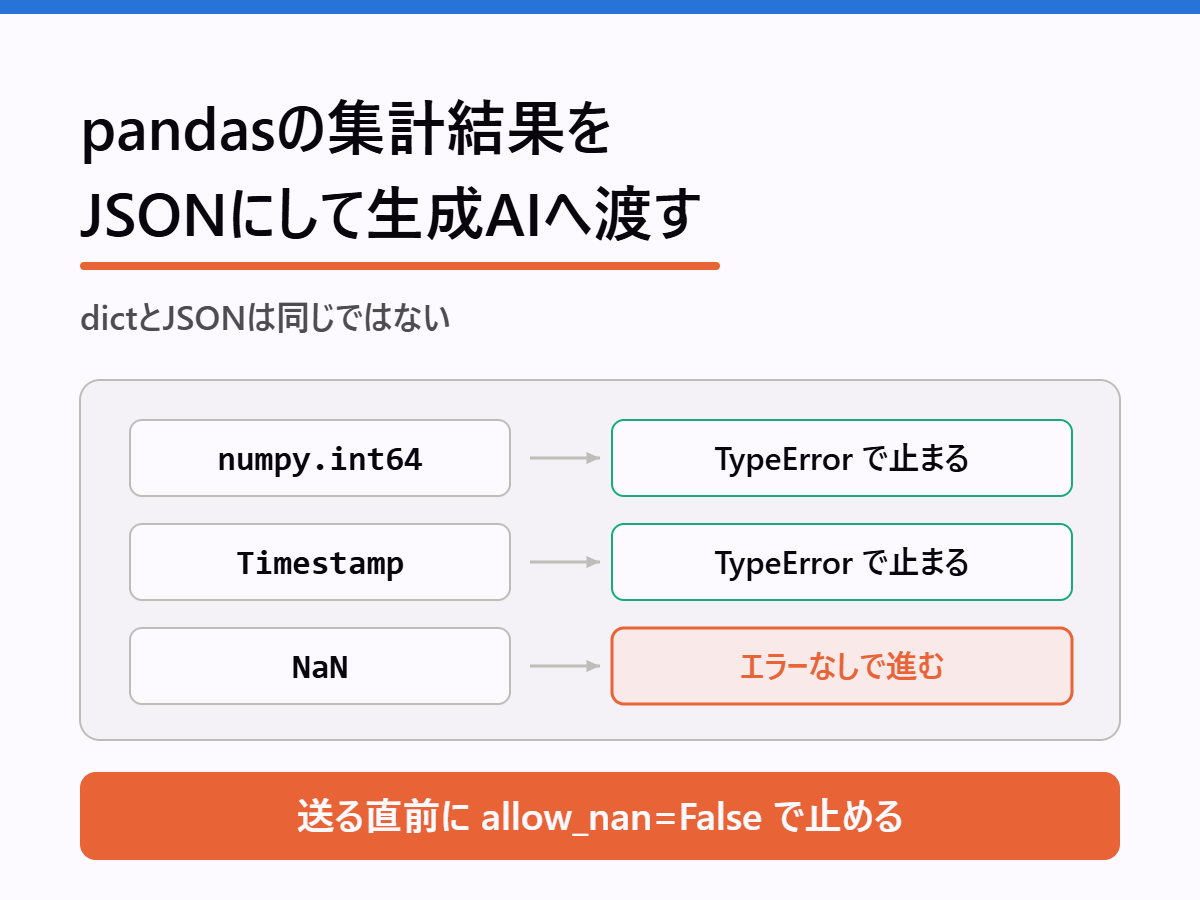
先に、この記事の結論を3つ書いておきます。
- 週の合計は
numpy.int64という型になり、エラーで止まります。 日付を日付型にした場合(Timestamp)も同じです。止まるので、気づけます - 前日比の初日は
NaNになり、エラーなしで不正なJSONができます。 Pythonのjson.loads()も読めてしまうので、確かめたつもりでも見逃します - 表は
to_json()でJSONにし、送る直前にallow_nan=Falseで確かめます。 この2か所で、止まらない壊れ方を止まるようにできます
この記事を読み終えると、次のことができるようになります。
json.dumps()で、Pythonの辞書をJSONの文字列にできる- pandasで、日別の売上と前日比を計算できる
numpy.int64・Timestamp・NaNがJSONで問題になる理由を説明できる- エラーが出ないまま不正なJSONができる場面に気づける
to_json()とallow_nan=Falseで、送る前に止められる- 作ったJSONを、OpenAI(あわせてGemini・Claude)のAPIへ渡せる

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| JSON | データを文字で表すための書き方の決まり。{"商品名": "幕の内弁当"} のように書く |
| 辞書(dict) | 「キー(名前)と値」の組を集めた、Pythonのデータの形。見た目はJSONに似ているが、別物 |
| json.dumps() | Pythonの辞書やリストを、JSONの文字列に変換する関数 |
| json.loads() | JSONの文字列を読んで、Pythonの辞書やリストに戻す関数 |
| pandas / DataFrame | pandasは表形式のデータを扱うPythonのライブラリ。DataFrameはpandasで扱う表 |
| 型 | 値の種類。整数なら int、小数なら float、文字列なら str など |
| numpy.int64 | pandasが整数を持つときの型。見た目は整数だが、Pythonの int とは別の型 |
| Timestamp | pandasの日時の型 |
| NaN | 「数値ではない」ことを表す特別な値。pandasでは、値が無いことを表すのにも使う |
| null | JSONで「値が無い」ことを表す書き方。Pythonに読み戻すと None になる |
| エスケープ | 文字を別の書き方に置き換えること。ここでは、日本語が \u5e55 のような形になること |
| API | プログラムから別のサービスを呼び出すための窓口。ここでは、Pythonから生成AIを呼び出す窓口 |
| instructions / input | OpenAIのAPIに渡す引数。instructions は毎回同じルール、input はその都度変わるデータ |
| 環境変数 | パソコン側に置いておく設定値。APIキーをコードに直接書かないために使う |
使うものと準備
この記事のコードは、JupyterLab(ブラウザの中でPythonを少しずつ実行できる開発環境)で動かす前提で書いています。
JupyterLabでは、ノートブック(拡張子が .ipynb のファイル)を開き、コードをセル(コードを入力して実行する枠)に貼って、Shift + Enter で1つずつ実行します。
ライブラリを入れる
次のコマンドで、pandas(表の集計に使う)と openai(OpenAIのAPIを呼ぶのに使う)を入れます。pip は、Pythonのライブラリを入れるためのコマンドです。
pip install pandas openai
このコマンドは、ターミナル(WindowsならPowerShell)で実行します。JupyterLabのセルで実行するときは、先頭に % を付けて %pip install pandas openai とします。
JupyterLab自体がまだ入っていない場合は、ターミナルで pip install jupyterlab を実行して入れ、jupyter lab で起動します。ブラウザが開き、JupyterLabの画面が表示されます。
売上CSVを読む
使うのは、以下の売上CSVです。7日 × 5商品で35行あります。
ファイル名:sample_sales_202607.csv
import json
import pandas as pd

df = pd.read_csv("sample_sales_202607.csv")
print(df.head())
           日付 曜日       商品名 カテゴリ  単価(円)  数量  売上金額(円)
0  2026-07-06  月   おにぎり(鮭)   主食    160  29     4640
1  2026-07-06  月   アイスコーヒー   飲料    180  28     5040
2  2026-07-06  月    サンドイッチ   軽食    380  26     9880
3  2026-07-06  月     幕の内弁当   弁当    620  19    11780
4  2026-07-06  月  緑茶 500ml   飲料    150  36     5400
import jsonは、JSONを扱うための道具を読み込みます。Pythonに最初から入っているので、インストールは要りませんimport pandas as pdは、pandasをpdという短い名前で使えるようにしますpd.read_csv()はCSVファイルを読み込み、表(DataFrame)にします。df.head()は先頭の5行だけを表示します
列は、日付・曜日・商品名・カテゴリ・単価(円)・数量・売上金額(円) の7つです。左端の 0〜4 は、pandasが行に付ける番号です。
この記事で使うJSONの基本
JSONは、データを文字で表すための書き方の決まりです。キーと値の組を { } で囲み、キーや文字列はダブルクォート " で囲みます。値が無いことは null と書きます。
Pythonの辞書をJSONの文字列にするのが json.dumps() です。
例 = {"商品名": "幕の内弁当", "売上金額": 93000}

print(json.dumps(例))
print(json.dumps(例, ensure_ascii=False))
{"\u5546\u54c1\u540d": "\u5e55\u306e\u5185\u5f01\u5f53", "\u58f2\u4e0a\u91d1\u984d": 93000}
{"商品名": "幕の内弁当", "売上金額": 93000}
- 1行目は、何も指定せずに変換した結果です。日本語が
\u5546のような記号の列に置き換わっています(エスケープ)。json.dumps()は、何も指定しないと、半角の英数字と記号以外の文字をこの形にします - 2行目は
ensure_ascii=Falseを付けた結果です。日本語がそのまま出ます
日本語を含むデータをJSONにするときは、ensure_ascii=False を付けます。 この記事のコードでも、すべて付けています。
見てのとおり、json.dumps() が作るのはただの文字列です。だから、生成AIのAPIに文字列として渡せます。
1列足すと壊れる
ここからが本題です。日別の売上と前日比を、週の合計と一緒に1つのJSONにして、生成AIへ渡すとします。前日比があれば、「金曜に伸びた」のような説明を書いてもらえるからです。この作業の途中で、壊れ方が3つ出てきます。
日別の売上と前日比を作る
日別 = df.groupby("日付", as_index=False)["売上金額(円)"].sum()
日別["前日比"] = 日別["売上金額(円)"].pct_change().round(3)

print(日別)
           日付  売上金額(円)    前日比
0  2026-07-06    36740    NaN
1  2026-07-07    40310  0.097
2  2026-07-08    38960 -0.033
3  2026-07-09    37220 -0.045
4  2026-07-10    44310  0.190
5  2026-07-11    39990 -0.097
6  2026-07-12    43490  0.088
df.groupby("日付", as_index=False)["売上金額(円)"].sum() は、日付が同じ行をまとめて、売上金額を合計します。as_index=False は、日付を普通の列として残す指定です。35行(7日 × 5商品)が、7日分・7行になりました。
pct_change() は、1つ前の行からの変化率を計算し、round(3) で小数第3位までに丸めています。0.097 は、前日より9.7%増えたという意味です。初日(7月6日)は前の行が無いので、NaN になります。
この表と週の合計を、1つのJSONにまとめます。表をJSONにするには、まず to_dict("records") で、表の1行を1つの辞書にしたリストへ変えます。
週の合計で止まる:numpy.int64
データ = {
    "週計": 日別["売上金額(円)"].sum(),
    "日別": 日別.to_dict("records"),
}
json.dumps(データ, ensure_ascii=False)
TypeError: Object of type int64 is not JSON serializable
「int64 という型のデータは、JSONにできない(not JSON serializable)」というエラーです。原因は、週の合計を計算した .sum() の結果です。型を表示して確かめます。type() は、値の型を調べる関数です。
print(type(日別.to_dict("records")[0]["売上金額(円)"]))
print(type(日別["売上金額(円)"].sum()))
<class 'int'>
<class 'numpy.int64'>
1行目は、to_dict("records") で作った辞書の中の売上金額です。Pythonの int(整数)になっています。to_dict("records") は、値をPythonの型に変換してくれるからです。
2行目は、同じ列を .sum() で合計した値です。numpy.int64(pandasが内部で使っている、numpyというライブラリの型)のままです。見た目はただの整数ですが、Pythonの int とは別物です。json.dumps() がJSONにできるのは、Pythonの標準の型(dict・list・str・int・float・True/False・None など)だけなので、ここで止まります。
int(日別["売上金額(円)"].sum()) のように int() で囲めば、Pythonの int になって通ります。
エラーで止まってくれるので、これは気づけます。
少しややこしいのは、同じ列でも平均ならエラーにならないことです。
print(json.dumps({"日平均": 日別["売上金額(円)"].mean()}, ensure_ascii=False))
print(isinstance(日別["売上金額(円)"].mean(), float))
print(isinstance(日別["売上金額(円)"].sum(), int))
{"日平均": 40145.71428571428}
True
False
isinstance(値, 型) は、値がその型として扱われるかを True(はい)か False(いいえ)で返す関数です。平均の型 numpy.float64 は、Pythonの float(小数)を元に作られた型なので True になり、そのまま通ります。numpy.int64 は int として扱われないので止まります。合計や件数のように、整数になる集計で止まると覚えておいてください。
日付を日付型にすると止まる:Timestamp
このCSVの日付は、文字列のまま読み込まれています。時系列を扱うときは、pd.to_datetime() で日付型に変えることがよくあります。
日付型 = pd.to_datetime(日別["日付"])
json.dumps({"初日": 日付型[0]})
TypeError: Object of type Timestamp is not JSON serializable
pd.to_datetime() は、文字列の日付を日付型(Timestamp)に変える関数です。日付型[0] は、その1つ目(7月6日)です。これも json.dumps() はJSONにできず、エラーで止まります。止まるので、気づけます。
前日比の初日は、エラーなしで NaN になる
週の合計を int() で囲み、日付は文字列のままにして、もう一度JSONにします。
データ = {
    "週計": int(日別["売上金額(円)"].sum()),
    "日別": 日別.to_dict("records"),
}
文字列 = json.dumps(データ, ensure_ascii=False)   # エラーは出ない
print(文字列[:72])
{"週計": 281020, "日別": [{"日付": "2026-07-06", "売上金額(円)": 36740, "前日比": NaN}
エラーは出ませんでした。 長いので、文字列[:72](先頭の72文字だけを取り出す書き方)で先頭だけ表示していますが、初日の前日比に NaN と書かれています。3つの中で、これがいちばん困る壊れ方です。
NaN はJSONでは書けない
JSONの仕様を定めた文書(RFC 8259)は、NaN を数値として認めていません。
Numeric values that cannot be represented in the grammar below (such as Infinity and NaN) are not permitted.
(文法で表せない数値、たとえば Infinity や NaN は許されない)
それでもPythonの json.dumps() が書き出すのは、既定で allow_nan=True になっているからです。Pythonの公式ドキュメントも、「RFCは NaN を認めていないが、このモジュールは既定で、NaN を有効な数値のように読み書きする」と明記しています。
json.loads() でも気づけない
送る前に「JSONとして読めるか」を確かめても、この問題は見つかりません。
print(json.loads(文字列)["日別"][0])
{'日付': '2026-07-06', '売上金額(円)': 36740, '前日比': nan}
Pythonの json.loads() は、NaN を含む文字列も読めてしまいます。Pythonで書いて、Pythonで読み直す限り、どこでも止まりません。
そのまま生成AIへ送るとどうなるか
OpenAIのAPIも止まりません。APIにとって input はただの文字列で、それがJSONとして正しいかは確かめないからです。
問題は、受け取った側で起きます。
- 生成AIが NaN をどう読むかは、決まっていません。 0なのか、データが無いのか、計算できないのか。こちらの意図は伝わっていません
- JSONを厳密に読む相手では止まります。 たとえばJavaScriptの
JSON.parse()はエラーを出します(Node.js や Chrome ではUnexpected token 'N') - 同じ文字列を、あとで別の場所に使うと止まります。 ログに書いて別のツールで読む、Webの画面(JavaScript)に渡す、生成AIに関数を実行させた結果として返す、といった場面です
エラーが出る壊れ方は、その場で直せます。エラーが出ない壊れ方は、送る前に自分で止めるしかありません。
to_json() で変換し、allow_nan=False で確かめる
直す場所は2つです。表は to_json() でJSONにする。送る直前に allow_nan=False で確かめる。
表は to_json() でJSONにする
pandasの to_json() は、DataFrameを直接JSONの文字列にします。json.dumps() と違い、numpyの型も NaN も、JSONで書ける形に変換してくれます。
表 = json.loads(日別.to_json(orient="records", force_ascii=False))
print(表[0])
{'日付': '2026-07-06', '売上金額(円)': 36740, '前日比': None}
NaN が None になっています。to_json() が NaN をJSONの null にし、それを json.loads() で読み戻したので、Pythonの None になりました。
| 引数 | 意味 |
|---|---|
orient="records" |
1行を1つのオブジェクトにして、配列に並べる。to_dict("records") と同じ形 |
force_ascii=False |
日本語をそのまま出す。json.dumps() の ensure_ascii=False に当たる。既定は True |
to_json() の結果をわざわざ json.loads() で読み戻しているのは、このあと週の合計などと1つにまとめるためです。文字列のままでは、辞書に組み込めません。
日付は文字列にしてから渡す
日付型の列を to_json() に渡すと、エラーにはなりませんが、別の形で困ります。
print(日付型.to_frame().head(2).to_json(orient="records", force_ascii=False))
[{"日付":1783296000000},{"日付":1783382400000}]
to_frame() は1列だけのデータを表(DataFrame)に変える関数、head(2) は先頭の2行だけを取り出す関数です。
13桁の数字は、1970年1月1日からの経過ミリ秒です。orient="records" のときの既定の形式で、生成AIには日付だと伝わりません。 pandas 3.0 では、この既定の形式が非推奨になり、Pandas4Warning という警告が出ます(pandas 2.2 では警告も出ません)。
| 書き方 | 初日の日付 |
|---|---|
| 指定なし | 1783296000000 |
date_format="iso" |
"2026-07-06T00:00:00.000" |
.dt.strftime("%Y-%m-%d") で文字列にしてから |
"2026-07-06" |
日付だけを渡したいなら、strftime() で文字列にしてから渡すのが確実です。date_format="iso" では時刻まで付きます。この記事のCSVは日付が最初から文字列なので、このままで大丈夫です。
1つにまとめて、allow_nan=False で確かめる
送るデータ = {
    "期間": "2026-07-06〜2026-07-12",
    "週計": int(日別["売上金額(円)"].sum()),
    "日別": 表,
}
送るJSON = json.dumps(送るデータ, ensure_ascii=False, allow_nan=False)
print(送るJSON[:104])
{"期間": "2026-07-06〜2026-07-12", "週計": 281020, "日別": [{"日付": "2026-07-06", "売上金額(円)": 36740, "前日比": null}
ここでも長いので、先頭の104文字だけを表示しています。前日比が null になりました。これがJSONの仕様どおりの形です。
allow_nan=False は、NaN が1つでも残っていたらエラーで止める指定です。to_json() を通さずに作った、先ほどの データ で試すとこうなります。
json.dumps(データ, ensure_ascii=False, allow_nan=False)
ValueError: Out of range float values are not JSON compliant: nan
エラーが出ない壊れ方を、エラーが出る壊れ方に変える。 それが、この引数1つの役目です。送る直前に必ず付けておきます。
エラーの文面の末尾にある
: nanは、Python 3.12 以降で付くようになったものです。3.11 以前では付きません。
OpenAIへ渡す
ここからは、作ったJSONを実際に生成AIへ渡します。APIキーが必要です。
APIを使う前に知っておくこと
- APIの利用は有料です(使った量に応じた従量課金)。 料金は、送った文字と返ってきた文字の量(トークン数)で決まります。単価は OpenAIの料金ページ で確認できます
- ChatGPTの有料プランを契約していても、APIの利用料はその中に含まれません。 APIは別に利用設定をして、別に支払います
- APIキーは、OpenAIの開発者向けサイト(API keys のページ)で作ります。 パスワードと同じ扱いで、人に見せたり、コードに直接書いたりしません
APIキーとモデルIDを環境変数に入れる
OpenAIのAPIを呼ぶには、APIキー(利用者を確かめるための文字列)と、モデルID(使うモデルの名前)が要ります。どちらもコードには直接書かず、環境変数から読みます。
- APIキーをコードに書くと、ノートブックを人に渡したときにキーも一緒に渡ります。 漏れたキーは、他人に使われて料金が発生するおそれがあります
- モデルIDは、新しいモデルが出ると変わります。 コードに書かず設定に置いておけば、設定だけ差し替えれば済みます。使えるモデルIDは、OpenAIの公式ドキュメントのモデル一覧で確認してください
Windowsなら、PowerShell(Windowsに入っているコマンド入力の画面)で次のように設定し、同じ画面から JupyterLab を起動します。"…" の中は、自分のAPIキーとモデルIDに置き換えてください。
$env:OPENAI_API_KEY = "ここにAPIキーを貼る"
$env:OPENAI_MODEL = "使うモデルのID"
jupyter lab
Anaconda Prompt(Anacondaに付いてくる、コマンドプロンプト形式の画面)を使っている場合は、書き方が変わります。値をダブルクォートで囲まないのがポイントです。囲むと、ダブルクォートまで値の一部になってしまいます。
set OPENAI_API_KEY=ここにAPIキーを貼る
set OPENAI_MODEL=使うモデルのID
jupyter lab
macOS・Linuxのターミナルでは、次のとおりです。
export OPENAI_API_KEY="ここにAPIキーを貼る"
export OPENAI_MODEL="使うモデルのID"
jupyter lab
いずれも、設定したウィンドウの中だけで有効です。別のウィンドウから起動した JupyterLab では読めないので、設定したのと同じウィンドウで jupyter lab を実行してください。すでに JupyterLab を開いている場合は、いったん閉じてから起動し直します。
参考までに、Google Colab を使う場合は、画面左側の鍵のアイコン(シークレット)に OPENAI_API_KEY という名前でキーを登録し、セルで次のように読み込みます。
import os
from google.colab import userdata

os.environ["OPENAI_API_KEY"] = userdata.get("OPENAI_API_KEY")
os.environ["OPENAI_MODEL"] = "使うモデルのID"
ルールとデータを分けて渡す
OpenAIのAPI(Responses API)では、生成AIへの指示を2つの引数に分けて渡せます。
| 引数 | 入れるもの | この記事では |
|---|---|---|
instructions |
毎回同じルール(役割、守ってほしいこと) | 下で作る ルール |
input |
その都度変わるデータ | to_json() で作った 送るJSON |
ルールを分けておくと、データだけを差し替えて何度でも呼べます。f文字列で文章にして渡す場合も、JSONで渡す場合も、この分け方は同じです。変わるのは input の中身だけです。
null の意味をルールに書く
null が表すのは「値が無い」ことだけです。なぜ無いのかまでは伝わりません。 JSONは値を渡せても、単位や意味までは渡せないので、それはルールに書きます。
ルール = """あなたは小売店の売上を説明する担当者です。
- 入力はJSONです。書かれている数値だけを使い、書き換えない
- 前日比は小数で表す。0.097 は前日より9.7%多いという意味
- 前日比が null の日は、前日のデータが無いため比較できない。0とみなさない
- 3文以内で書く"""
ルールの中で押さえておきたいのは、次の2行です。
- 前日比の読み方(0.097 は9.7%増)を書いています。書かなければ、0.097 を「0.097%」と読まれても文句は言えません
- null の扱い(0とみなさない)を書いています。書かなければ、初日をどう説明するかはモデル任せになります
呼び出す
import os
from openai import OpenAI

client = OpenAI()                      # OPENAI_API_KEY を環境変数から読む
MODEL = os.environ["OPENAI_MODEL"]     # モデルIDも環境変数に置く

response = client.responses.create(
    model=MODEL,
    instructions=ルール,
    input=送るJSON,
)
print(response.output_text)          # 回答の文章
print(response.usage.input_tokens)   # 送った入力のトークン数
OpenAI() は、環境変数 OPENAI_API_KEY からAPIキーを読みます。output_text は回答の文章、usage.input_tokens は送った入力のトークン数(文章を区切った単位の数。料金はこの数で決まります)です。
エスケープでトークンが増えるかを確かめるには、
送るJSONを作るときのensure_ascii=Falseを外して、もう一度呼んでみてください。input_tokensの差が、エスケープで増えたぶんです。
回答の文面はモデルや実行のたびに変わるので、ここには載せていません。
Claude・Geminiではここが違う
JSONを作る部分と、ルール は3社とも同じです。 変わるのは、最後の呼び出しだけです。
| 項目 | OpenAI | Gemini | Claude |
|---|---|---|---|
| 入れるライブラリ | openai |
google-genai |
anthropic |
| APIキーの環境変数 | OPENAI_API_KEY |
GEMINI_API_KEY(GOOGLE_API_KEY もあると、そちらが優先) |
ANTHROPIC_API_KEY |
| データを渡す場所 | input= |
contents= |
messages= の user の content |
| ルールを渡す場所 | instructions= |
config= の system_instruction |
system= |
| 回答の取り出し | response.output_text |
response.text |
content のテキスト部分をつなげる |
モデルIDは、それぞれ GEMINI_MODEL・CLAUDE_MODEL という名前の環境変数に入れておく前提で書いています。設定のしかたは、OpenAIのときと同じです。
Gemini の場合
pip install google-genai で入れておきます。
import os
from google import genai
from google.genai import types

client = genai.Client()                # GEMINI_API_KEY を環境変数から読む
response = client.models.generate_content(
    model=os.environ["GEMINI_MODEL"],
    contents=送るJSON,
    config=types.GenerateContentConfig(system_instruction=ルール),
)
print(response.text)
Claude の場合
pip install anthropic で入れておきます。
import os
from anthropic import Anthropic

client = Anthropic()                   # ANTHROPIC_API_KEY を環境変数から読む
message = client.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,                   # Claudeでは必須
    system=ルール,
    messages=[{"role": "user", "content": 送るJSON}],
)
print("".join(b.text for b in message.content if b.type == "text"))
Claudeでは、出力の上限 max_tokens を必ず指定します。回答は content にブロックのリストとして入っているので、テキストのブロックだけをつなげて取り出します。
まとめ
今回、覚えておいた方がいいことです。
| 日本語 | ensure_ascii=False(to_json() なら force_ascii=False) |
| 合計・件数 | numpy.int64 は int() で囲む。平均は通るので油断しない |
| 日付 | 文字列にしてから渡す。to_json() の既定は13桁の数字 |
| NaN | json.dumps() は止まらずに NaN と書く。json.loads() も読めてしまう |
| 表 | to_json(orient="records", force_ascii=False) → json.loads() |
| 送る直前 | allow_nan=False で、NaN が残っていたら止める |
| 意味 | null や小数の意味は、ルールに書く |
3つの壊れ方のうち、2つはエラーで止まります。止まらない1つを、止まるようにする。 それがこの記事でいちばん大事なところです。
