- 問題
- 答え
- 解説
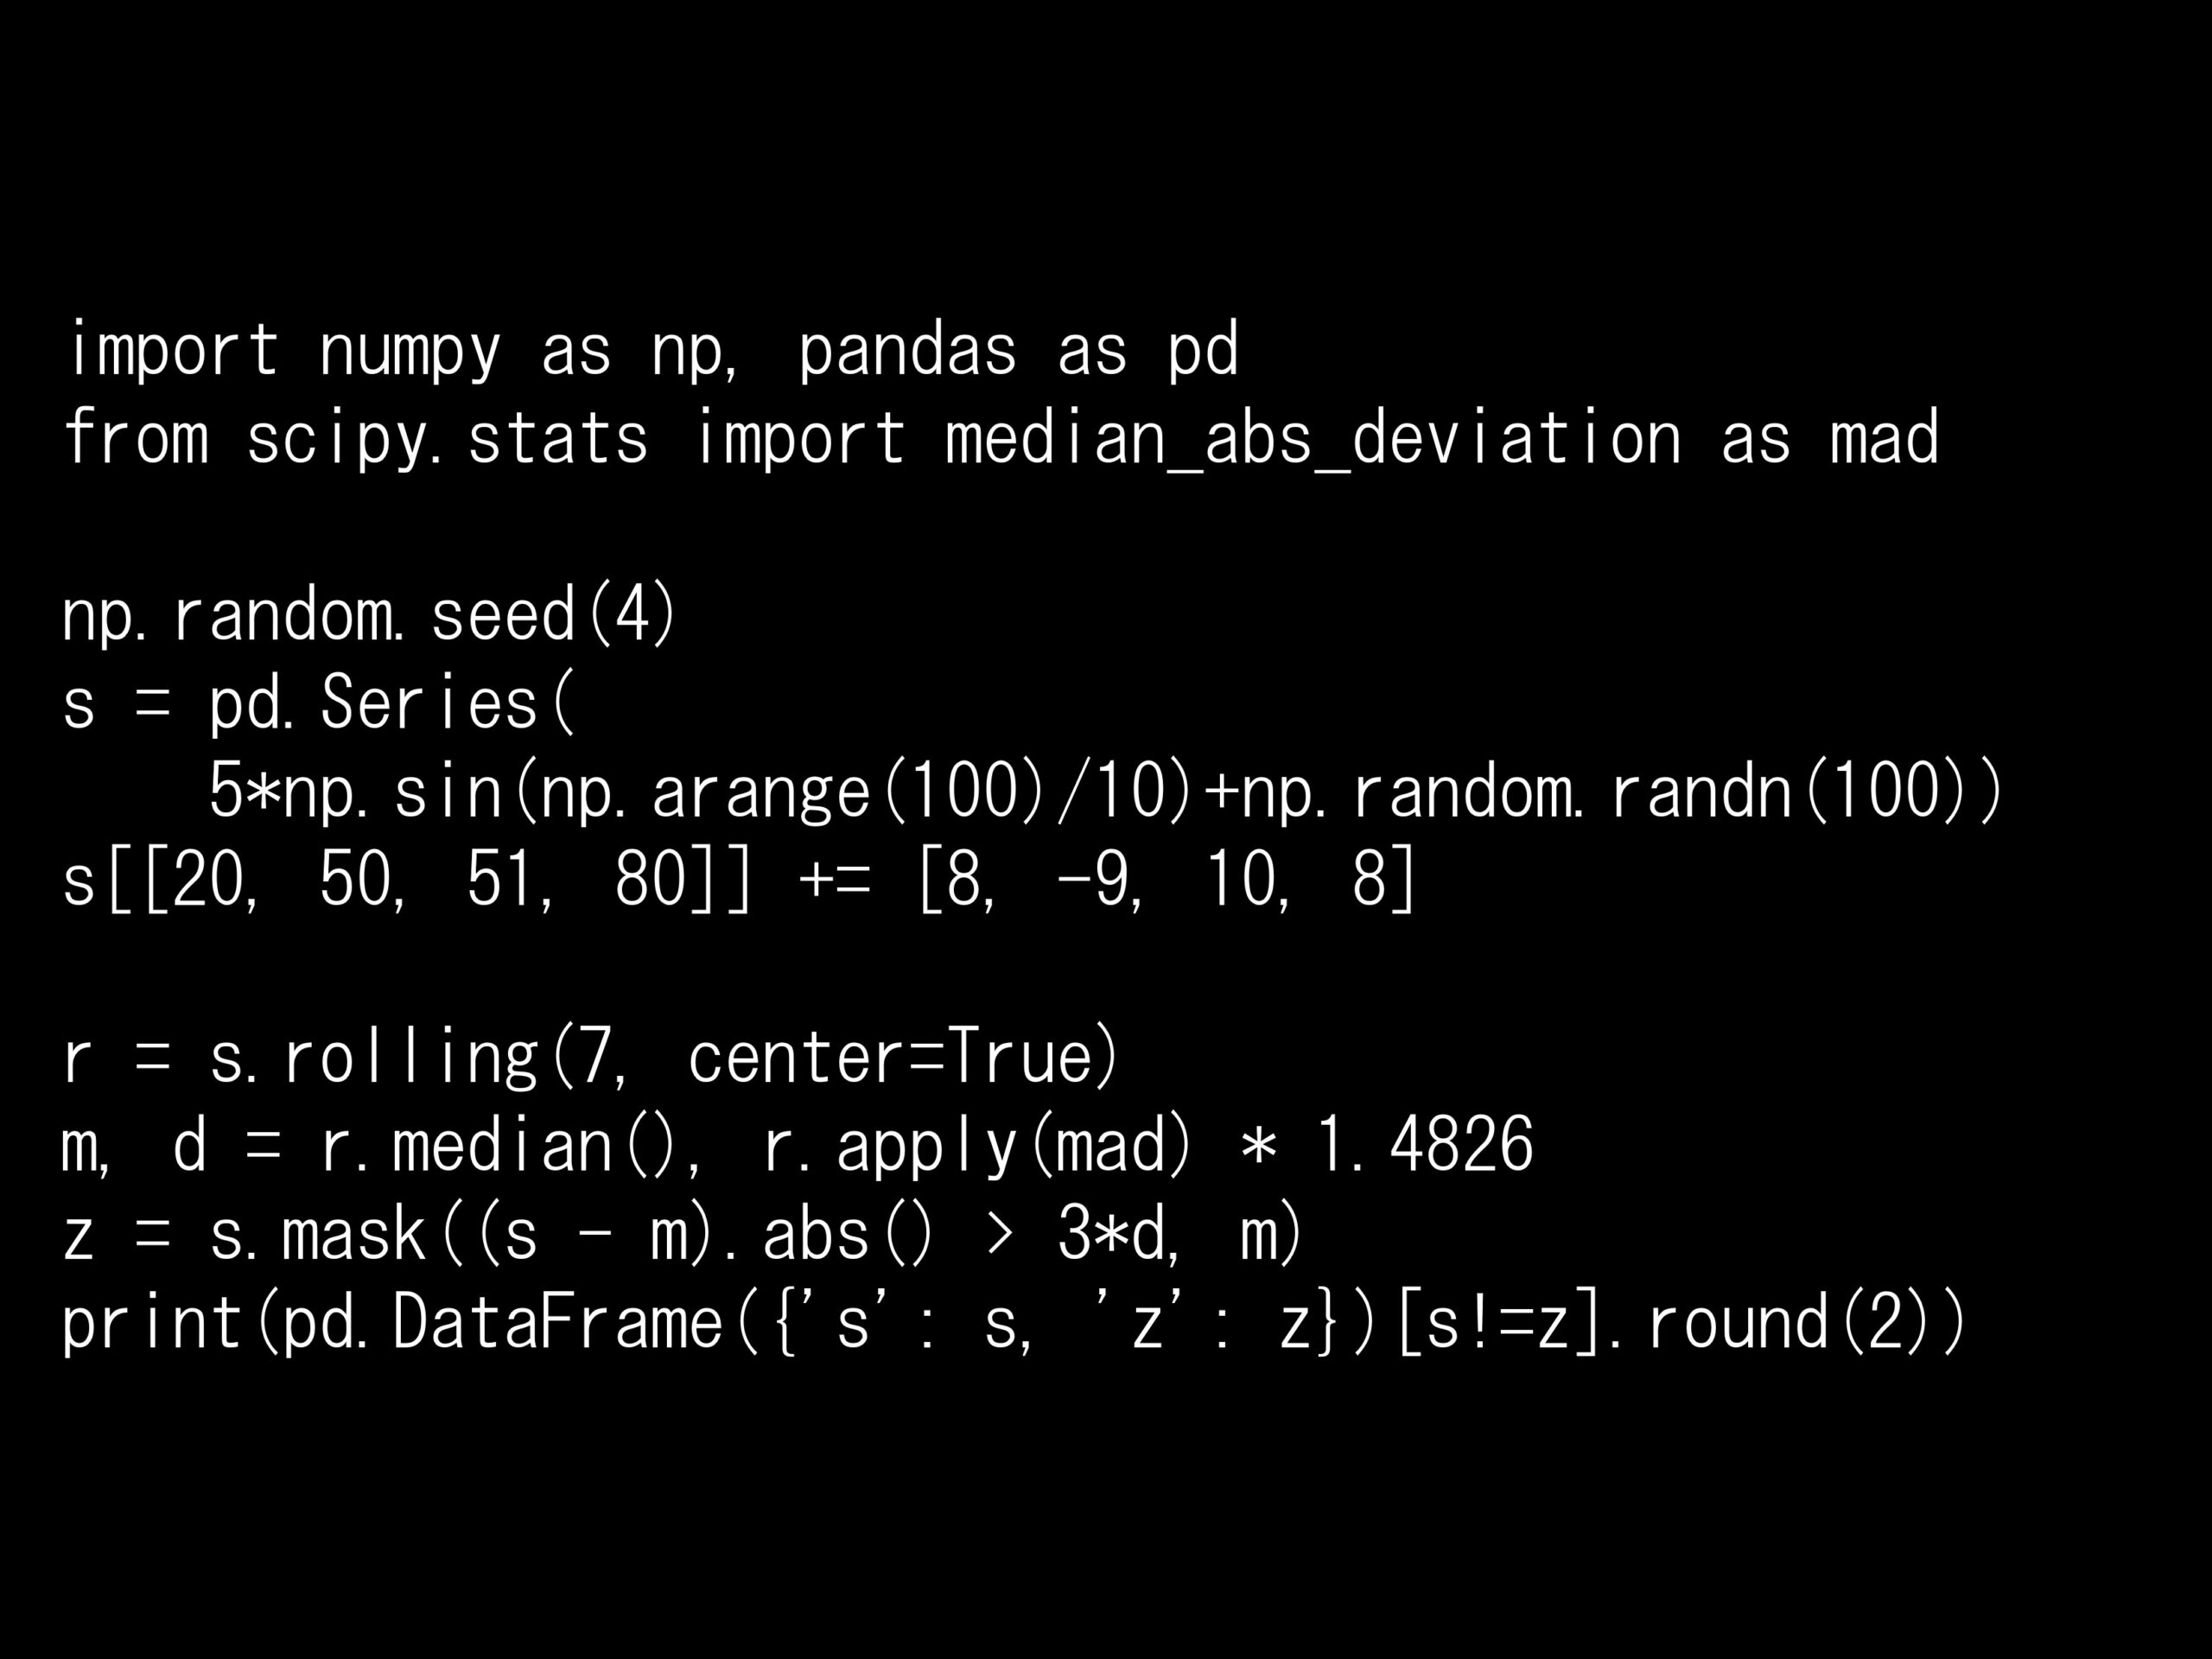
s から系列 z を作っています。このコードは何をしていますか?
Python コード:
import numpy as np, pandas as pd
from scipy.stats import median_abs_deviation as mad

np.random.seed(4)
s = pd.Series(5*np.sin(np.arange(100)/10) + np.random.randn(100))
s[[20, 50, 51, 80]] += [8, -9, 10, 8]

r = s.rolling(7, center=True)
m, d = r.median(), r.apply(mad) * 1.4826
z = s.mask((s - m).abs() > 3*d, m)
print(pd.DataFrame({'s': s, 'z': z})[s != z].round(2))
回答の選択肢:
(A) 局所的な中央値から大きく離れた点だけを見つけ、その点を局所的な中央値で置き換えている
(B) 系列全体の平均と標準偏差から3σを超える点を見つけ、平均値で置き換えている
(C) 移動中央値で系列全体をなめらかにし、細かなノイズを取り除いている
(D) 系列の欠損値を、前後7点の中央値で補完している
        s     z
20  11.56  4.78
50 -13.01 -4.13
51   3.53 -4.38
80  11.85  4.65
正解: (A)
このコードはHampelフィルタによる外れ値の検出と補正を行っています。各時点を中心とする7点の窓で、中央値mと、ばらつきの指標であるMAD(中央絶対偏差)を計算します。MADに1.4826を掛けたものは、正規分布のもとで標準偏差に相当する頑健な推定値dです。そのうえで、中央値からのずれが3*dを超える点だけを外れ値とみなし、その点の値を局所的な中央値に置き換えます。
出力は、sとzで値が変わった行だけを表示したものです。データ生成時にスパイクを加えた4点(20、50、51、80)がちょうど検出され、周囲の水準に近い値に補正されています。それ以外の96点は元の値のまま変わっていません。連続する2点(50と51)のスパイクも、中央値を使っているため正しく検出できています。
回答の選択肢:
(A) 局所的な中央値から大きく離れた点だけを見つけ、その点を局所的な中央値で置き換えている
(B) 系列全体の平均と標準偏差から3σを超える点を見つけ、平均値で置き換えている
(C) 移動中央値で系列全体をなめらかにし、細かなノイズを取り除いている
(D) 系列の欠損値を、前後7点の中央値で補完している
- コードの解説
-
このコードは、ゆるやかに変動する系列に突発的なスパイクを加え、移動窓の中央値とMADを使ってスパイクだけを補正しています。
import numpy as np, pandas as pd
from scipy.stats import median_abs_deviation as mad

np.random.seed(4)
s = pd.Series(5*np.sin(np.arange(100)/10) + np.random.randn(100))
s[[20, 50, 51, 80]] += [8, -9, 10, 8]

r = s.rolling(7, center=True)
m, d = r.median(), r.apply(mad) * 1.4826
z = s.mask((s - m).abs() > 3*d, m)
print(pd.DataFrame({'s': s, 'z': z})[s != z].round(2))
詳しく説明します。
ライブラリのインポート
numpy:数値計算を行うためのライブラリです。ここでは乱数生成と正弦波の作成に使用しています。pandas:移動窓の計算(rolling)と値の置き換え(mask)に使用しています。scipy.stats.median_abs_deviation:MAD(中央絶対偏差)を計算する関数です。
データの生成
5*np.sin(np.arange(100)/10):振幅5でゆるやかに上下する波です。季節変動などをイメージしてください。np.random.randn(100):標準偏差1のノイズです。s[[20, 50, 51, 80]] += [8, -9, 10, 8]:4つの時点に大きなずれを加えています。センサーの誤作動や入力ミスによる突発的な異常値を想定しています。50と51は連続した2点です。
処理のステップ
s.rolling(7, center=True):各時点を中心とする前後3点ずつ、計7点の移動窓を作ります。r.median():窓ごとの中央値mです。その時点の「本来の水準」の推定値になります。r.apply(mad) * 1.4826:窓ごとのMADに1.4826を掛け、標準偏差に相当するばらつきの推定値dを求めます。(s - m).abs() > 3*d:中央値からのずれがdの3倍を超える点をTrueとする条件です。s.mask(条件, m):条件がTrueの点だけをmの値に置き換え、それ以外は元の値を残します。[s != z]:置き換えが起きた行だけを抽出して表示しています。
端の扱い
窓が7点そろわない先頭と末尾の3点ずつは、mとdが欠損値(NaN)になります。NaNとの比較はFalseになるため、maskでは置き換えが起きず、元の値がそのまま残ります。 - 選択肢の解説
-
(A) 局所的な中央値から大きく離れた点だけを見つけ、その点を局所的な中央値で置き換えている → ○
正解です。これがHampelフィルタの仕組みです。判定も置き換えも「局所的な中央値」を基準にしており、変更されるのは外れ値と判定された点だけです。(B) 系列全体の平均と標準偏差から3σを超える点を見つけ、平均値で置き換えている → ×
コードでは、系列全体ではなく7点の移動窓を使っています。また、使っているのは平均と標準偏差ではなく、中央値とMADです。実際に系列全体の平均(1.14)と標準偏差(3.92)で3σ判定をすると、検出されるのは50の1点だけです。系列全体の波(振幅5)が標準偏差を押し上げ、局所的なスパイクが埋もれてしまうためです。(C) 移動中央値で系列全体をなめらかにし、細かなノイズを取り除いている → ×
系列全体を移動中央値で置き換えるのであれば、ほぼすべての点の値が変わるはずです。このコードではmaskによって条件を満たす点だけを置き換えており、変わったのは100点中4点だけです。「平滑化」と「外れ値の補正」の違いがポイントです。(D) 系列の欠損値を、前後7点の中央値で補完している → ×
sには欠損値はありません。置き換えの対象は欠損ではなく、周囲から大きく外れた観測値です。 - Hampelフィルタの式とMAD
-
時点tを中心とする半幅kの窓W_t = \{x_{t-k}, \ldots, x_{t+k}\}について、次のように判定します(今回はk=3、窓幅7)。
$$
m_t = \mathrm{median}(W_t)
$$$$
\mathrm{MAD}_t = \mathrm{median}\left(|x_j – m_t|\right), \quad x_j \in W_t
$$$$
cは閾値で、3がよく使われます(今回のコードの
|x_t – m_t| > c \times 1.4826 \times \mathrm{MAD}_t \;\Rightarrow\; x_t \text{ を } m_t \text{ に置き換える}
$$3*d)。1.4826という定数の意味
データが正規分布に従うとき、MADは標準偏差\sigmaの約0.6745倍になります。その逆数1/0.6745 \approx 1.4826を掛けることで、MADを標準偏差と同じ尺度にそろえています。そのため、「3σルール」と同じ感覚で閾値3を使えます。なお、mad(x, scale='normal')と指定すると、この換算を関数内で行えます。今回の検出点の数値
時点 元の値 s 窓の中央値 m d(1.4826×MAD) 真の水準(ノイズなし) 20 11.56 4.78 1.21 4.55 50 -13.01 -4.13 0.49 -4.79 51 3.53 -4.38 0.45 -4.63 80 11.85 4.65 1.11 4.95 補正後の値(窓の中央値)は、スパイクを加える前の真の水準に近い値になっています。
- なぜ平均と標準偏差ではなく中央値とMADなのか
-
移動窓で「平均±3×標準偏差」を使う方法(移動平均+3σ)も考えられます。しかし、今回のデータで7点の移動平均と移動標準偏差を使って3σ判定をすると、1点も検出されません。理由は2つあります。
1. 外れ値自身が基準をゆがめる(マスキング)
平均と標準偏差は外れ値の影響を強く受けます。窓の中にスパイクがあると、平均はスパイクの方向に引っぱられ、標準偏差も大きくなります。その結果、スパイクの「ずれ」が小さく見積もられ、検出できなくなります。中央値とMADは、窓の半分近くが外れ値でも大きくは動かない、頑健(ロバスト)な指標です。連続する2点のスパイク(50と51)を検出できたのも、このためです。2. 小さな窓では3σを超えられない
窓内のn個の値から計算した平均と標本標準偏差で標準化すると、その絶対値は理論上次の上限を超えません。$$
n=7では上限が約2.27です。つまり、窓幅7の移動平均+3σでは、どれほど大きな外れ値でも原理的に検出できません。
\frac{|x_i – \bar{x}|}{s} \le \frac{n-1}{\sqrt{n}}
$$方法 今回のデータで検出された点 Hampelフィルタ(窓7・中央値+MAD・閾値3) 20, 50, 51, 80(すべて正しく検出) 系列全体の平均+3σ 50のみ 移動平均+3σ(窓7) なし - 外れ値の補正と平滑化の違い
-
Hampelフィルタは、移動中央値による平滑化とよく似た計算を使いますが、目的が異なります。
平滑化(移動平均・移動中央値) Hampelフィルタ 変更される点 すべての点 外れ値と判定された点だけ 目的 細かなノイズを除き、大きな流れを見る 異常値だけを取り除き、元のデータを保つ 正常な変動への影響 ピークや急な変化もなまる ほぼ影響なし 外れ値の影響 移動平均では周囲の点にも広がる その点だけで完結する たとえば今回のデータに7点の移動平均をかけると、端を除くすべての点の値が変わります。さらに、スパイクの影響が前後の点にも広がり、時点19〜21の値が本来の水準より1程度押し上げられます。Hampelフィルタは、正常な点には手を加えずに外れ値だけを取り除けるのが長所です。
- 実務での注意点
-
窓幅の選び方
窓が狭すぎると、局所的なばらつきが不安定に推定され、正常な点まで外れ値と判定されやすくなります。逆に広すぎると、トレンドや季節変動による変化までばらつきに含まれ、外れ値を見逃しやすくなります。また、連続する外れ値は窓幅の半分未満でないと検出できません(窓幅7なら連続3点まで)。データの変化の速さと、想定される外れ値の長さに合わせて調整しましょう。閾値の選び方
閾値3が標準的ですが、外れ値を見逃したくない場合は2〜2.5程度に下げ、正常な点を誤って補正したくない場合は3.5〜4程度に上げます。どの点が補正されたかを必ず確認し、実データで妥当性を検証しましょう。「外れ値」が本当の異常とは限らない
セール日の売上急増や、設備トラブルによる計測値の急変は、統計的には外れ値でも、ビジネス上は重要な事実です。機械的に補正する前に、原因を確認しましょう。補正するかどうかは、分析の目的(平常時のパターンを学習したいのか、異常を検知したいのか)によって決まります。MADが0になるケース
窓内の半数以上が同じ値(例:0が続く売上データ、量子化されたセンサー値)だと、MADが0になります。このとき、中央値と少しでも異なる点がすべて外れ値と判定されてしまいます。MADに下限を設ける、あるいは別の方法と併用するなどの対策が必要です。補正の記録を残す
補正した値は実際の観測値ではありません。補正した点のフラグ(今回のs != z)を残しておくと、後から影響を確認でき、異常検知のラベルとしても活用できます。
