前回の記事では、API呼び出しの結果をログへ残しました。最後に「100件流したうちの3件が失敗したとき、その3件だけを再処理する」と書いたところで終わっています。今回はそこへ進みます。
題材は、これまでと同じPOS売上CSVです。35行の売上明細をPythonで商品別に集計すると5商品になります。その5商品を1件ずつAPIへ送り、それぞれの短いコメントを作ります。
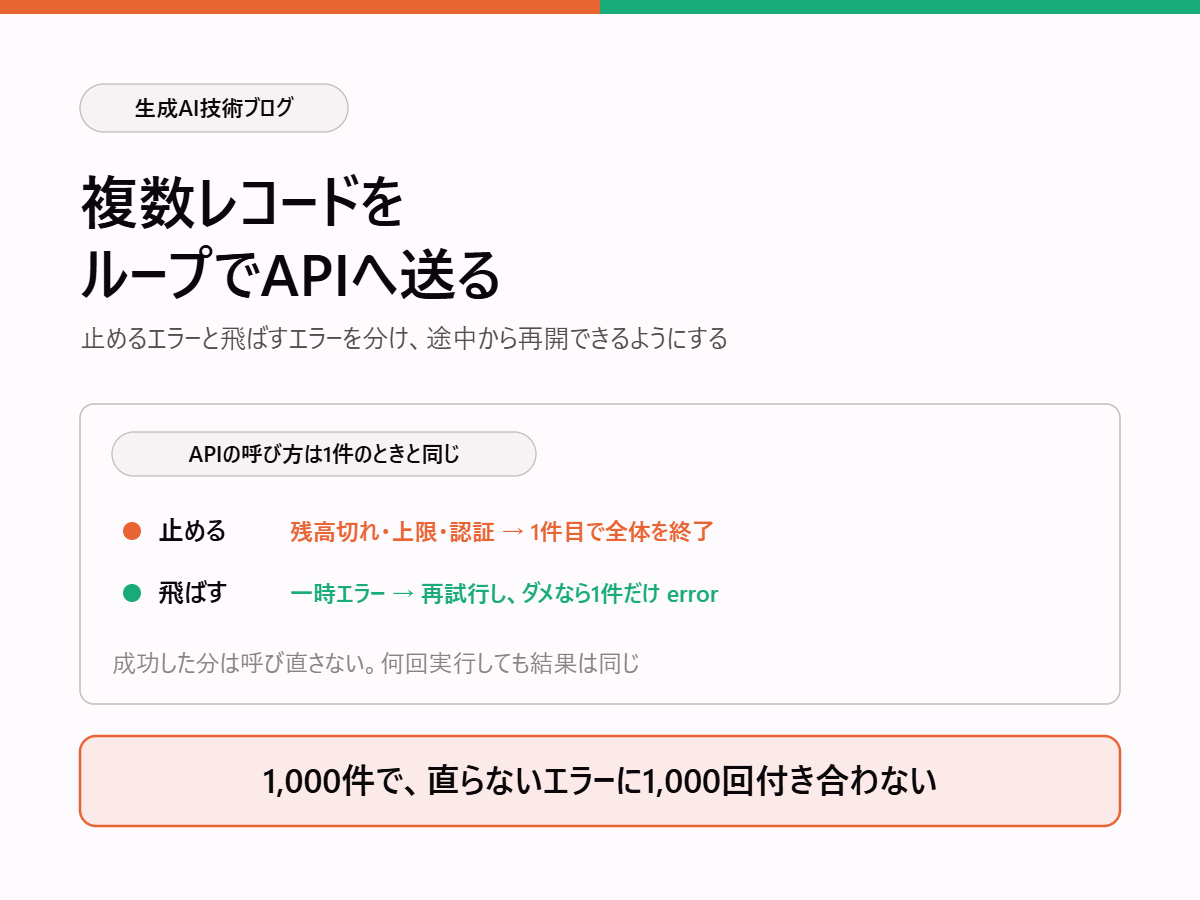
APIの呼び方そのものは、1件のときと何も変わりません。 変わるのは、その周りです。
先に、この記事の結論を3つ書いておきます。
- エラーを2種類に分けます。 「この1件だけ飛ばす」のか「バッチ全体を止める」のか。残高切れなら、1件目で全部止めるのが正解です
- 成果物と運用ログは、別のファイルにします。 生成した文章は成果物には入りますが、ログには入れません
- 途中から再開できるようにします。 5件なら気になりませんが、1,000件で900件目に落ちたときに効いてきます
この記事を読み終えると、次のことができるようになります。
- pandasの集計結果を
to_dict("records")でレコードのリストにできる forループで1件ずつAPIへ送れる- 固定のルールと、レコードごとに変わるデータを分けて渡せる
- 「1件だけ飛ばすエラー」と「バッチ全体を止めるエラー」を分けられる
- 成果物CSVと運用ログを別々に書き出せる
- 途中で止まっても、済みの分を呼び直さずに再開できる
- 生成された文章の数値が書き換えられていないか、機械的に確かめられる
- 最初から並列化しないほうがよい理由を説明できる

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| レコード | 処理の1単位。ここでは1商品ぶんの集計結果 |
| バッチ | まとめて流す処理のかたまり。ここでは5商品ぶんの1回の実行 |
| 逐次処理 | 1件ずつ順番に処理すること。同時に投げるのが並列処理 |
| 成果物 | 業務で使うほうの出力。ここでは商品コメント入りのCSV |
| 運用ログ | 動いたかどうかを後から調べるための記録。前回の記事で作ったもの |
| 冪等(べきとう) | 同じ処理を2回やっても結果が1回分と同じになること |
| 再開 | 途中で止まった処理を、済みの分を飛ばして続きから流すこと |
| instructions | 毎回同じルールを渡す引数。以前の記事で扱ったもの |
| input | その都度変わるデータを渡す引数 |
| レート制限 | 一定時間内に送れるリクエスト数・トークン数の上限 |
変わるのはループの外側だけ
これまでは、1回呼んで終わりでした。
response = client.responses.create(
    model="gpt-5.6-luna",
    instructions=ルール,
    input="幕の内弁当の集計結果…",
)
今回は、これを for で囲みます。
for r in レコード:
    response = client.responses.create(
        model="gpt-5.6-luna",
        instructions=ルール,
        input=データ文(r),
    )
APIの使い方は1行も変わっていません。 しかし、繰り返すようになった瞬間に、1件のときは考えなくてよかったことが出てきます。
| 1件のとき | 複数件になると |
|---|---|
| 失敗したら、もう一度実行すればよい | どこまで済んだのかが分からなくなる |
| 結果は目で見れば分かる | 全部は見ていられない |
| エラーが出たら止まる | 止めるべきか、飛ばすべきか判断が要る |
| 料金は1回ぶん | 件数ぶん掛け算になる |
この記事は、この右側の列を1つずつ埋めていく回です。
今回の流れ
大事なのは、真ん中の分かれ目です。
35行のCSVを5回そのまま送るのではありません。 Pythonで商品別に集計してから、確定した数値だけを送ります。
売上の合計や構成比は、Pythonなら確実に計算できます。生成AIに計算させる理由がありません。計算はPython、説明は生成AIという分担は、これまでの記事と同じです。
Pythonで集計する
売上CSVを読む
使うのは、以下の売上CSVです。7日 × 5商品で35行あります。
ファイル名:sample_sales_202607.csv
import pandas as pd

df = pd.read_csv("sample_sales_202607.csv")
print(df.shape)
(35, 7)
列は 日付 曜日 商品名 カテゴリ 単価(円) 数量 売上金額(円) の7つです。
商品別に集計する
商品別 = (
    df.groupby(["商品名", "カテゴリ"], as_index=False)
      .agg(売上金額=("売上金額(円)", "sum"),
           販売数量=("数量", "sum"))
      .sort_values("売上金額", ascending=False)
      .reset_index(drop=True)
)

商品別["売上順位"] = 商品別.index + 1
商品別["売上構成比"] = (
    商品別["売上金額"] / 商品別["売上金額"].sum() * 100
).round(1)
| 順位 | 商品名 | カテゴリ | 売上金額 | 販売数量 | 構成比 |
|---|---|---|---|---|---|
| 1 | 幕の内弁当 | 弁当 | 93,000円 | 150点 | 33.1% |
| 2 | サンドイッチ | 軽食 | 64,220円 | 169点 | 22.9% |
| 3 | アイスコーヒー | 飲料 | 41,580円 | 231点 | 14.8% |
| 4 | おにぎり(鮭) | 主食 | 41,120円 | 257点 | 14.6% |
| 5 | 緑茶 500ml | 飲料 | 41,100円 | 274点 | 14.6% |
売上合計は281,020円です。ここまで生成AIは1回も使っていません。
レコードのリストにする
ループで扱いやすいよう、DataFrameを辞書のリストに変えます。
レコード = 商品別.to_dict("records")

print(レコード[0])
{'商品名': '幕の内弁当', 'カテゴリ': '弁当', '売上金額': 93000,
 '販売数量': 150, '売上順位': 1, '売上構成比': 33.1}
to_dict("records") は、1行を1つの辞書にします。これで r["商品名"] のように書けます。
iterrows()でも同じことはできますが、返ってくるのがSeriesなので型が分かりにくくなります。APIへ渡す値を組み立てるだけなら、素の辞書のほうが扱いやすいです。
ルールとデータを分けて渡す
ここは、以前の記事で決めた分け方をそのまま使います。
| 引数 | 入れるもの | この記事では |
|---|---|---|
instructions |
毎回同じルール | 5商品ぶんすべてで同じ文字列 |
input |
その都度変わるデータ | 商品ごとの集計結果 |
ルール(全商品で共通)
ルール = """あなたは商品別の売上コメントを作る担当者です。

- 与えられた数値だけを使い、書き換えない
- 与えられていない原因は推測しない
- 2文以内、80字以内"""
データ(商品ごとに変わる)
商品数 = len(商品別)
売上合計 = int(商品別["売上金額"].sum())


def データ文(r):
    return (f"商品名:{r['商品名']}\n"
            f"カテゴリ:{r['カテゴリ']}\n"
            f"売上金額:{r['売上金額']:,}円\n"
            f"販売数量:{r['販売数量']:,}点\n"
            f"売上順位:{r['売上順位']}位(全{商品数}商品)\n"
            f"売上構成比:{r['売上構成比']}%(全体 {売上合計:,}円)")
1商品目だと、こうなります。
商品名:幕の内弁当
カテゴリ:弁当
売上金額:93,000円
販売数量:150点
売上順位:1位(全5商品)
売上構成比:33.1%(全体 281,020円)
「全5商品」「全体 281,020円」も渡しているのがポイントです。 これがないと、モデルは「5商品中1位」と書きたくても数を知りません。知らないまま書けば、それは推測です。使ってよい数値は、こちらから全部渡しておきます。
ルールを
instructionsへ出す利点は、読みやすさだけではありません。変わらない部分を先頭にまとめる形になるので、プロンプトキャッシュが効く条件にも合います。ただしキャッシュは1,024トークン以上のプロンプトが対象なので、この記事の短いルールでは効きません。 ルールが長くなったときに効いてくる、という理解で十分です。
エラーを2種類に分ける
ここが、この記事でいちばん考えるところです。
1件のときは「失敗したら、もう一度実行する」で済みました。5件、100件となると、途中で1件落ちたときにどうするかを決めなければなりません。
全部飛ばすと、無駄に呼び続ける
よくある書き方はこうです。
for r in レコード:
    try:
        response = client.responses.create(...)
        結果.append({**r, "status": "success", ...})
    except openai.APIError as exc:
        結果.append({**r, "status": "error", ...})   # 記録して次へ
一見よさそうですが、残高が尽きている場合を考えてください。
1商品目 → 429 credit_balance_exhausted → 記録して次へ
2商品目 → 429 credit_balance_exhausted → 記録して次へ
3商品目 → 429 credit_balance_exhausted → 記録して次へ
4商品目 → 429 credit_balance_exhausted → 記録して次へ
5商品目 → 429 credit_balance_exhausted → 記録して次へ

結果:5回呼んで、5件ともエラーのCSVができる
前回までの記事で確認したとおり、この429は支払い設定を変えない限り直りません。2商品目以降を呼ぶ意味はありません。5件なら5回で済みますが、1,000商品なら1,000回です。しかも失敗したリクエストもレート制限にカウントされます。
止めるか、飛ばすか
| 止める(バッチ全体) | 飛ばす(その1件だけ) | |
|---|---|---|
| 判断の基準 | 他のレコードも必ず失敗する | このレコード固有の問題 |
| 例 | 残高切れ・支出上限・認証エラー・権限エラー | 一時的な混雑・接続エラー・入力が不正 |
| 対処 | すぐ止めて通知する | 記録して次へ進む |
| あとで | 設定を直してから流し直す | 失敗した分だけ再処理する |
前回までの記事で作った「待っても直らない429」の集合が、そのまま使えます。
止めるべき = {
    "credit_balance_exhausted",
    "organization_spend_limit_exceeded",
    "project_spend_limit_exceeded",
    "organization_usage_limit_exceeded",
}


class バッチ中止(Exception):
    """このバッチを続けても意味がない、と判断したときに投げる"""
専用の例外クラスを1つ作っておくと、呼ぶ側で「止める」と「飛ばす」を except だけで書き分けられます。
1件を送る関数
前回までの記事で作った再試行ラッパーに、この判断を足します。
def 送る(r, 制限秒=60.0):
    開始 = time.perf_counter()
    期限 = time.monotonic() + 制限秒
    待ち, 試行 = 2.0, 0

    while True:
        試行 += 1
        try:
            res = client.responses.create(
                model=MODEL,
                instructions=ルール,
                input=データ文(r),
            )
            経過 = round((time.perf_counter() - 開始) * 1000)
            return res, 試行, 経過

        except openai.APIStatusError as exc:
            # ① バッチ全体を止めるもの
            if exc.code in 止めるべき or isinstance(
                    exc, (openai.AuthenticationError,
                          openai.PermissionDeniedError)):
                raise バッチ中止(type(exc).__name__) from exc

            # ② 待っても直らないが、この1件だけの問題(400 など)
            if not isinstance(exc, (openai.RateLimitError,
                                    openai.InternalServerError,
                                    openai.ConflictError)):
                raise

            直前 = exc          # ③ 待てば直るかもしれないもの

        except openai.APIConnectionError as exc:
            直前 = exc          # 接続エラーも ③

        if 期限 - time.monotonic() <= 待ち:
            raise 直前
        time.sleep(待ち)
        待ち = min(待ち * 2, 30.0)
分岐は3つです。
- バッチ中止 — 残高・上限・認証・権限。他のレコードでも必ず同じになります
- そのまま上げる — 400のような入力の問題。このレコードだけの話なので、呼ぶ側で「飛ばす」に回します
- 再試行する — 429・5xx・接続エラー。締切まで待って粘り、それでもダメなら上げます
raise バッチ中止(...) from excのfrom excは、元の例外を原因として残す書き方です。こうしておくと、あとでstop.__cause__から本来のエラーを取り出せます。ログにerror_codeを残すときに使います。
成果物と運用ログを分ける
もう1つ、複数件になると決めておきたいことがあります。何を、どこへ書くかです。
下書きの段階でよくあるのが、全部を1つのリストに入れて1つのCSVにすることです。しかし、この2つは目的も読む人も保存期間も違います。
| 成果物 CSV | 運用ログ JSONL | |
|---|---|---|
| 目的 | 業務で使う | 動いたかを後から調べる |
| 中身 | 集計値+生成したコメント | request_id・トークン数・料金・所要時間 |
| 生成した文章 | 入る(それが成果物なので) | 入れない |
| 読む人 | 業務の担当者 | 運用・開発 |
| 保存期間 | 業務のルールによる | 90日など |
3行目が要点です。 前回の記事で「回答本文はログに入れない」と決めました。しかし今回、生成した文章は成果物そのものです。矛盾しているようですが、分けて考えれば矛盾しません。
コメントは業務で使うファイルに入れ、運用ログには入れません。ログは広く共有されがちだからです。 成果物のほうは、元の売上データと同じ扱いにします。
ログを書く関数は、前回の記事のものをそのまま使います。許可リストに comment を入れていないので、うっかり渡しても書き込みの前に止まります。
途中から再開できるようにする
5商品なら、失敗しても最初から流し直せばよさそうです。しかし1,000商品で900件目に落ちたら、899件ぶんをもう一度呼ぶことになります。時間も料金も、もう一度かかります。
済みの分を飛ばす
やり方は単純です。成果物CSVを見て、成功している商品を飛ばします。
from pathlib import Path

成果物 = Path("product_comments.csv")


def 済みの商品名():
    if not 成果物.exists():
        return set()
    済み = pd.read_csv(成果物)
    return set(済み.loc[済み["status"] == "success", "商品名"])
status == "success" の行だけを見ているのがポイントです。失敗した行は「済み」に入れません。 だから次に流したとき、失敗した分だけがもう一度呼ばれます。
書き戻すときに重複を消す
def 書き出す(結果):
    新 = pd.DataFrame(結果)
    if 成果物.exists():
        既存 = pd.read_csv(成果物)
        新 = (pd.concat([既存, 新], ignore_index=True)
                .drop_duplicates(subset=["商品名"], keep="last")
                .sort_values("売上順位")
                .reset_index(drop=True))
    新.to_csv(成果物, index=False, encoding="utf-8-sig")
    return 新
keep="last" にしているので、同じ商品が2回あれば新しいほうが残ります。前回 error だった行が、今回の success で置き換わる形です。
encoding="utf-8-sig" は、ExcelでそのままCSVを開いても文字化けしないようにするための指定です。
これで、この処理は何回実行しても結果が同じになりました。こういう性質を冪等(べきとう)と言います。途中で止まっても、怖がらずにもう一度実行できます。
ループ本体
ここまでをつなぎます。
def 走らせる(レコード, 制限秒=60.0):
    済み = 済みの商品名()
    結果 = []

    for r in レコード:
        if r["商品名"] in 済み:
            continue                       # もう成功している

        いま = datetime.now(timezone.utc).isoformat(timespec="seconds")

        try:
            res, 試行, ms = 送る(r, 制限秒)

        except バッチ中止 as stop:
            原因 = stop.__cause__
            ログを書く({
                "timestamp": いま, "job": "product_comment", "model": MODEL,
                "status": "aborted",
                "error_type": type(原因).__name__,
                "error_code": getattr(原因, "code", None),
            })
            print(f"[中止] {r['商品名']} で {stop} → 残りは呼びません")
            return 結果, str(stop)          # ← ここで抜ける

        except Exception as exc:
            結果.append({**r, "status": "error", "comment": None})
            ログを書く({
                "timestamp": いま, "job": "product_comment", "model": MODEL,
                "status": "error",
                "error_type": type(exc).__name__,
                "error_code": getattr(exc, "code", None),
                "request_id": getattr(exc, "request_id", None),
            })
            print(f"[失敗] {r['商品名']}: {type(exc).__name__}")
            continue                        # ← この1件だけ飛ばす

        u = res.usage
        結果.append({**r, "status": "success", "comment": res.output_text})
        ログを書く({
            "timestamp": いま, "job": "product_comment", "model": MODEL,
            "request_id": res._request_id, "status": "success",
            "attempts": 試行, "latency_ms": ms,
            "input_tokens": u.input_tokens,
            "output_tokens": u.output_tokens,
            "reasoning_tokens": u.output_tokens_details.reasoning_tokens or 0,
            "total_tokens": u.total_tokens,
            "cost_usd": 概算料金(u),
        })
        print(f"[成功] {r['商品名']}({試行}回目)")

    return 結果, None
バッチ中止はreturnで抜けます。 残りのレコードは呼びません- それ以外の例外は
continueで次へ進みます。 その1件だけがerrorとして残ります - ログは3種類とも書きます。 中止・失敗・成功。中止のときも記録が残るので、朝に「なぜ途中で終わったのか」が分かります
getattr(exc, "request_id", None)を使っています。 接続エラーにはこの属性が無いので、直接exc.request_idと書くと落ちます
except Exceptionは広すぎるように見えますが、ここでは意図的です。1件のレコードで何が起きても、バッチ全体は止めないためです。ただしバッチ中止を先に書いてあるので、止めるべきものはここへ落ちてきません。
動かして確かめる
本物のエラーを待たずに、3つの場面を確かめます。決めた順番で例外を投げるだけの偽のクライアントを作って差し替えます(前回の記事と同じやり方です)。
場面1:残高切れ
[中止] 幕の内弁当 で RateLimitError → 残りは呼びません
→ API送信 1 回 / 成果物 0 件
1回で止まりました。 全部飛ばす書き方なら5回です。1,000商品なら1,000回の差になります。
場面2:一時エラーと、直らないエラーが混ざる
サンドイッチで429(すぐ回復する種類)、アイスコーヒーで503が続く、という台本にします。
[成功] 幕の内弁当(1回目)
[成功] サンドイッチ(2回目)
[失敗] アイスコーヒー: InternalServerError
[成功] おにぎり(鮭)(1回目)
[成功] 緑茶 500ml(1回目)
→ API送信 9 回 / 成果物 5 件
サンドイッチは2回目で成功しています。再試行が効いた証拠です。アイスコーヒーは締切まで粘って諦め、その1件だけが error になりました。4商品目と5商品目はきちんと処理されています。
場面3:もう一度実行する
(済み 4 件をとばします)
[成功] アイスコーヒー(1回目)
→ API送信 1 回(失敗していた1件だけ)
→ 成果物 5 件 / status: {'success': 5}
成功していた4件は1回も呼んでいません。 失敗していた1件だけが処理され、成果物が5件そろいました。
数値が書き換えられていないか確かめる
5件でも、生成された文章を全部読んで数値を照合するのは面倒です。1,000件なら不可能です。
そこで、コメントに出てくる数値が、渡した集計値の中にあるかどうかを機械的に見ます。以前の記事で作った検査を、ループ向けに広げたものです。
検査のコード
import re


def 数値(text):
    return set(re.findall(r"\d[\d,]*(?:\.\d+)?", str(text)))


def 許可された数値(r):
    元 = {f"{r['売上金額']:,}", str(r['売上金額']),
          f"{r['販売数量']:,}", str(r['販売数量']),
          str(r['売上順位']), str(r['売上構成比']),
          str(商品数), f"{売上合計:,}", str(売上合計)}
    元 |= 数値(r["商品名"])          # 「緑茶 500ml」の 500 など
    return {s.replace(",", "") for s in 元}


def 検査(行):
    許可 = 許可された数値(行)
    return sorted(s for s in 数値(行["comment"])
                  if s.replace(",", "") not in 許可)
書き方のポイントが3つあります。
- カンマの有無を両方許しています。
93,000と書かれても93000と書かれても、同じ数値として扱います - 小数も拾えるようにしています。
(?:\.\d+)?がないと33.1が33と1に分かれてしまいます - 商品名に入っている数字も許可しています。 「緑茶 500ml」の
500を毎回ひっかけても意味がありません
流してみる
5件のうち1件だけ、わざと数量を書き換えたコメントを混ぜてあります。
OK 幕の内弁当
OK サンドイッチ
OK アイスコーヒー
OK おにぎり(鮭)
NG 緑茶 500ml       ['290']
     → 売上金額は41,100円で5位ですが、販売数量は290点と最多です。

検査 5 件 / 要確認 1 件
渡していない「290」だけが引っかかりました。 正しい値は274点です。目で5件を読み比べなくても、ここだけ見ればよいと分かります。
この検査が出すのは「候補」であって「判定」ではありません。 たとえば「前年比」のような、渡した数値から計算された値を書かれると引っかかります。逆に、数値ではない事実の間違い(カテゴリを取り違えるなど)は見つけられません。件数を絞るための道具として使ってください。
使った量と料金
運用ログを集計すると、この5件でどれだけ使ったかが出ます。
| 項目 | 値 |
|---|---|
| ログの行数 | 6行(成功5 / 失敗1) |
| 入力トークン合計 | 1,003 |
| 出力トークン合計 | 604 |
| 概算料金 合計 | $0.000925 |
| 1件あたり | $0.000185 |
5商品を毎日処理しても月$0.03程度です。しかし、これが100店舗 × 50商品になれば5,000件です。 1件あたりの料金を先に測っておけば、その掛け算はすぐ出せます。
上の数値は、この記事の検証で使った偽のクライアントが返したトークン数から計算したものです。実際のモデルのトークン数とは異なります。手元で測り直してください。
並列化を急がない
5件を順番に処理していると、「まとめて同時に投げれば速いのでは」と考えたくなります。技術的にはできますが、最初は1件ずつにしてください。
| 逐次処理だとやりやすいこと | 並列化すると |
|---|---|
| どのレコードで失敗したか分かる | ログの順序が入り混じる |
| 再試行の待ち時間が読める | 何本が同時に待っているか分からない |
| レート制限に当たりにくい | 一気に上限へ届く |
| 「止める」判断がそのまま効く | 止めると決めた時点で、他の便が飛んでいる |
最後の行が、この記事の内容と直接ぶつかります。残高切れで止めると決めても、並列で5本投げていたら、止める頃には5本とも飛んでいます。 逐次処理なら1回で止まります。
time.sleep(1) は解決になっていません。
ループの例で、こう書いてあるコードを見かけます。
for r in レコード:
    response = client.responses.create(...)
    time.sleep(1)          # レート制限対策のつもり
しかし1秒が正しい根拠はどこにもありません。レート制限はモデルと利用状況で変わります。1秒では足りないこともあれば、まったく不要なこともあります。不要なときは、5,000件で5,000秒(約83分)を何もせずに捨てることになります。
固定で待つのではなく、429が出たときだけ、必要なぶん待つ。それが前回までの記事で作った再試行です。今回のループにはすでに入っています。
この記事で扱っていないこと
数万件をまとめて処理する場合
5件や数十件なら for ループで十分です。数万件を「急ぎではないがまとめて処理したい」場合は、Batchという選択肢があります。料金がちょうど半額になるかわりに、結果はすぐには返りません。
ただし、いきなりそこへ行かないでください。 1件で動かし、5件を逐次で流し、エラーと料金を確認してから移るほうが、結局は早く着きます。
レコードの分割
今回は「1商品 = 1レコード = 1回の呼び出し」です。商品数が増えると、この対応が最適とは限りません。 5商品をまとめて1回で送るほうが、料金も時間も少なくて済む場合があります。かわりに、1件失敗すると5件ぶんやり直しになります。
まとめ
APIの呼び方は、1件のときと変わりません。変わるのはループの外側です。
| 覚えておくこと | |
|---|---|
| 集計 | Pythonで確定させてから渡す。 CSV全文は送らない |
| 渡し方 | instructions にルール、input にデータ。使ってよい数値は全部渡す |
| エラー | 止めるか、飛ばすか。 残高切れは1件目で全体を止める |
| 出力先 | 成果物CSVと運用ログは別。 生成した文章はログに入れない |
| 再実行 | 成功した分は呼び直さない。 何回実行しても結果が同じになる |
| 確かめ方 | コメントの数値が渡した値の中にあるかを機械的に見る |
| 速度 | まず逐次。 time.sleep(1) は根拠のない待ち時間 |
下書きの段階でよくあるのが、except ひとつで全部を受けて記録し、次へ進む形です。5件なら動きます。1,000件になったとき、直らないエラーに1,000回付き合うことになります。
