5月の1か月間、自店舗で販促キャンペーンを打った。キャンペーン中の1日あたり売上は、前の月より14.7%多かった。
この数字を見て「キャンペーンで売上が14.7%伸びた」と報告する。
よくある報告ですが、この14.7%にはキャンペーンがなくても増えていた分が混ざっています。
結論を先に3行で書きます。
- CausalImpact(コーザルインパクト)は、「キャンペーンがなかったら」の売上を予測し、実際の売上との差を効果とみなす手法です。Googleの研究者が2015年に発表しました。
- 正解(売上+10%)を仕込んだ練習用データで動かすと、推定値は9.6%(95%区間 8.17〜11.13%)。前後比較の14.7%と違い、正解を区間の中に捉えます。
- ただし結果が正しいかは、比較に使う店舗(対照系列)の選び方と、前提の確認で決まります。
この記事を読み終えると、次のことができるようになります。
- CausalImpactが「何を」「どうやって」測る手法か、人に説明できる
- 前後比較の数字が、そのまま効果にならない理由が分かる
- Python(tfcausalimpact)の出力から、効果の大きさと確からしさを拾える
- 連載全11回のうち、自分がどこから読めばよいかが分かる
この記事と連載で使うのは、架空の店舗の日次売上データ campaign_sales.csv です。自店舗の売上(sales_own)と、キャンペーンをしていない近隣2店舗の売上(store_a、store_b)が入っています。キャンペーン期間(2026年5月1日〜31日)の自店舗の売上には、効果として+10%を仕込んであります。正解が分かっているので、手法の答え合わせができます。
以下からダウンロードできます。
まず、単純に比べてみる
キャンペーンをした5月と、その前の4月の売上を比べてみます。
以下、コードです。
import pandas as pd

data = pd.read_csv(
    "campaign_sales.csv",
    index_col="date",
    parse_dates=True
)

april = data.loc["2026-04", "sales_own"].mean()
may = data.loc["2026-05", "sales_own"].mean()

print(f"4月の平均売上:{april:.1f}千円")
print(f"5月の平均売上:{may:.1f}千円")
print(f"前後比較の伸び率:{may / april - 1:.1%}")
以下、実行結果です。
4月の平均売上:458.8千円
5月の平均売上:526.3千円
前後比較の伸び率:14.7%
1日あたりの売上は458.8千円から526.3千円へ。14.7%の増加です。
ただ、この14.7%には、キャンペーンと関係なく売上を動かすものが混ざっています。
- 祝日と曜日:5月にはゴールデンウィーク(GW)があり、土日も4月より2日多い
- トレンド:この店の売上は、もともと少しずつ伸びている
- 偶然のゆらぎ:たまたま良い日・悪い日が続くことがある
では、キャンペーンがなかったら、5月の売上はいくらだったのか。前後比較では、ここが分かりません。これを予測するのが、CausalImpactです。
CausalImpact(コーザルインパクト)とは何か
CausalImpactは、施策の効果を時系列データから推定する手法です。Googleの研究者Brodersenらが2015年に論文で発表し、R言語のパッケージとして公開しました(公式ページ、論文)。
考え方は1行で書けます。
効果 = 実際の売上 − 「キャンペーンがなかったら」の売上(予測)
「キャンペーンがなかったら」の世界は、現実には観測できません。この仮想の世界を反実仮想(はんじつかそう、counterfactual)と呼びます。CausalImpactは、反実仮想を予測で作り出す手法だ、と言い換えられます。
手順は4つです。
- 介入前期間で「ふだんの動き」を学ぶ:キャンペーン前の期間(介入前期間)で、自店舗の売上の傾向と、他店舗の売上との連動を学ぶ
- 介入後期間を予測する:キャンペーン中の期間(介入後期間)の他店舗の売上から、「キャンペーンがなかった自店舗」の売上を予測する
- 実測値と予測値の差を取る:この差が効果
- 差の「幅」と「確からしさ」を出す:予測には誤差があるので、効果を1つの数字ではなく、95%区間と確率つきで示す
図にすると、次のようになります。
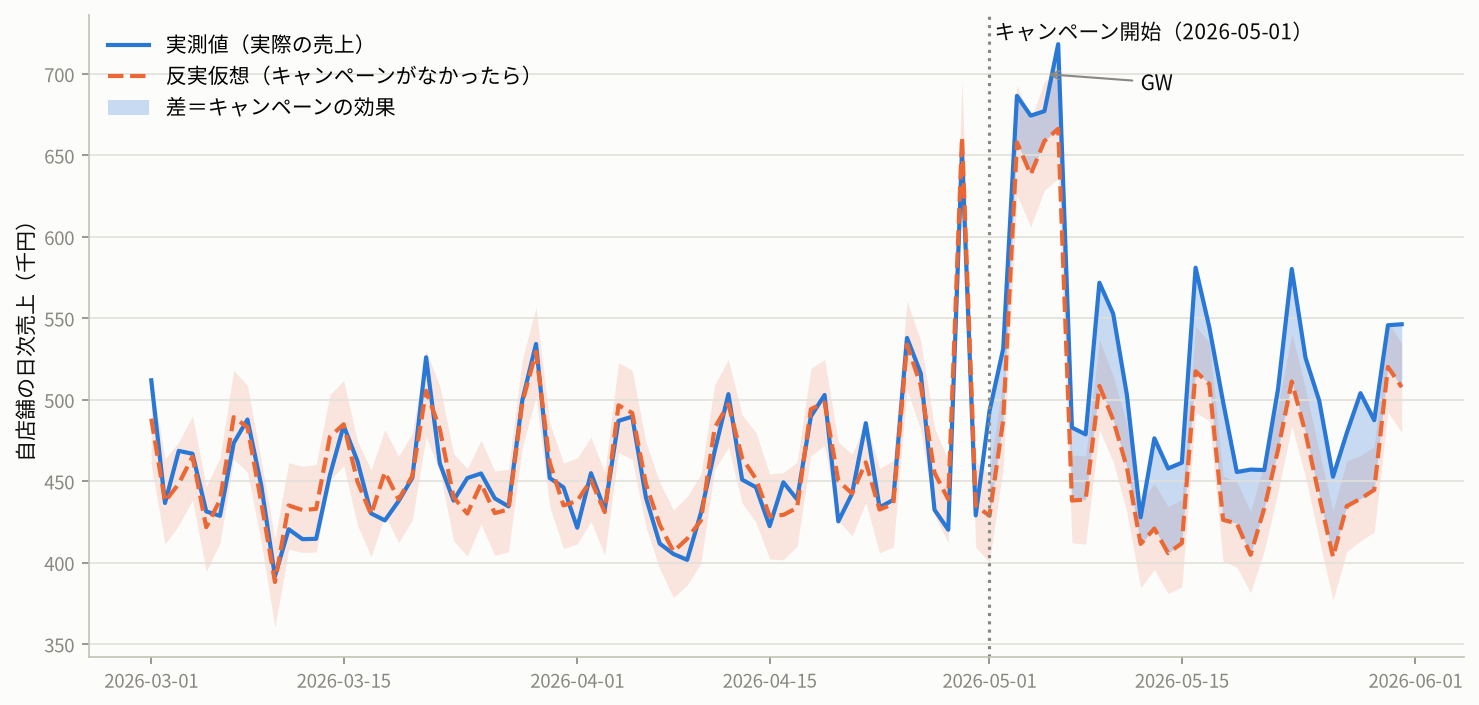
ここで効いているのが、キャンペーンをしていない他店舗の売上です。これを対照系列と呼びます。
他店舗も、GWや土日には売上が増えます。介入前期間で「自店舗の売上は、他店舗の売上とこう連動する」と学んでおけば、5月の他店舗の売上から、GWの分も含めて「キャンペーンがなかった自店舗の売上」を予測できます。
A/Bテストのように「施策をする店」と「しない店」をランダムに分けられないときに使える手法です。たとえば、1店舗だけでキャンペーンをした、特定の地域だけでテレビCMを流した、自社サイトをリニューアルした、といった場面です。
まず、動かしてみる
Python版のCausalImpactの1つ、tfcausalimpactで動かします(ライブラリの選び方は後述)。データと2つの期間を渡すだけです。
以下、コードです。
import pandas as pd
import tensorflow as tf
from causalimpact import CausalImpact

tf.random.set_seed(42)  # 推定に使う乱数を固定する

# 1列目が目的変数(自店舗の売上)、2列目以降が対照系列(他店舗の売上)
data = pd.read_csv(
    "campaign_sales.csv",
    index_col="date",
    parse_dates=True
)
data = data.sort_index()
data = data.asfreq("D")

pre_period = ["2025-01-01", "2026-04-30"]   # 介入前期間
post_period = ["2026-05-01", "2026-05-31"]  # 介入後期間(キャンペーン中)

ci = CausalImpact(data, pre_period, post_period)
print(ci.summary())
ci.plot()
読み込むCSVは、1列目が効果を測りたい数値(目的変数、ここでは自店舗の売上)、2列目以降が対照系列(他店舗の売上)という並びにしておきます。
tf.random.set_seed(42) は、推定に使う乱数を固定する1行です。CausalImpactは推定の途中で乱数を使うため、これがないと実行のたびに数値が少し変わります。実行にはこの記事の環境で約1分かかりました。
以下、実行結果です。
Posterior Inference {Causal Impact}
                          Average            Cumulative
Actual                    526.35             16316.8
Prediction (s.d.)         480.25 (3.63)      14887.88 (112.39)
95% CI                    [472.92, 487.13]   [14660.48, 15101.05]

Absolute effect (s.d.)    46.09 (3.63)       1428.92 (112.39)
95% CI                    [39.22, 53.43]     [1215.75, 1656.32]

Relative effect (s.d.)    9.6% (0.75%)       9.6% (0.75%)
95% CI                    [8.17%, 11.13%]    [8.17%, 11.13%]

Posterior tail-area probability p: 0.0
Posterior prob. of a causal effect: 100.0%

For more details run the command: print(impact.summary('report'))
英語の表が出てきました。1行ずつの読み方は第5回で扱います。ここでは3か所だけ拾います。
| 出力の行 | 値 | 意味 |
|---|---|---|
| Relative effect | 9.6%(95%区間 8.17%〜11.13%) | 売上は、キャンペーンがなかった場合より約9.6%多かった |
| Absolute effect(Cumulativeの列) | 1428.92(95%区間 1215.75〜1656.32) | キャンペーン期間の合計で約143万円の上乗せ(単位は千円) |
| Posterior prob. of a causal effect | 100.0% | 効果があったと言える確からしさ |
パソコンの環境(OSやライブラリのバージョン)が違うと、小数点以下の数値が少し変わることがあります。
答え合わせ:仕込んだ10%を捉えたか
3つの数字を並べます。
| 方法 | 効果の推定値 |
|---|---|
| 前後比較(4月→5月) | 14.7% |
| CausalImpact | 9.6%(95%区間 8.17%〜11.13%) |
| 正解(データに仕込んだ値) | 10% |
CausalImpactの95%区間は、正解の10%を含んでいます。前後比較の14.7%は、区間の外です。
差の正体も、出力から読めます。キャンペーンがなかった場合の5月の予測は、1日あたり480.25千円(Predictionの行)。4月の実績458.8千円より約4.7%多い値です。
つまりCausalImpactは「GWや土日の多さ、伸びのトレンドで、5月はキャンペーンがなくても4.7%ほど増えていたはず」と見ています。前後比較の14.7%から、この分を取り除いたのが9.6%です。
金額でも確かめます。5月の実際の売上合計16316.8千円のうち、仕込んだ10%の上乗せ分は約1483千円です。CausalImpactの推定1428.92千円の95%区間(1215.75〜1656.32)に入っています。
グラフで見る:3段のパネルが示すもの
ci.plot() は、次の3段のグラフを出します。
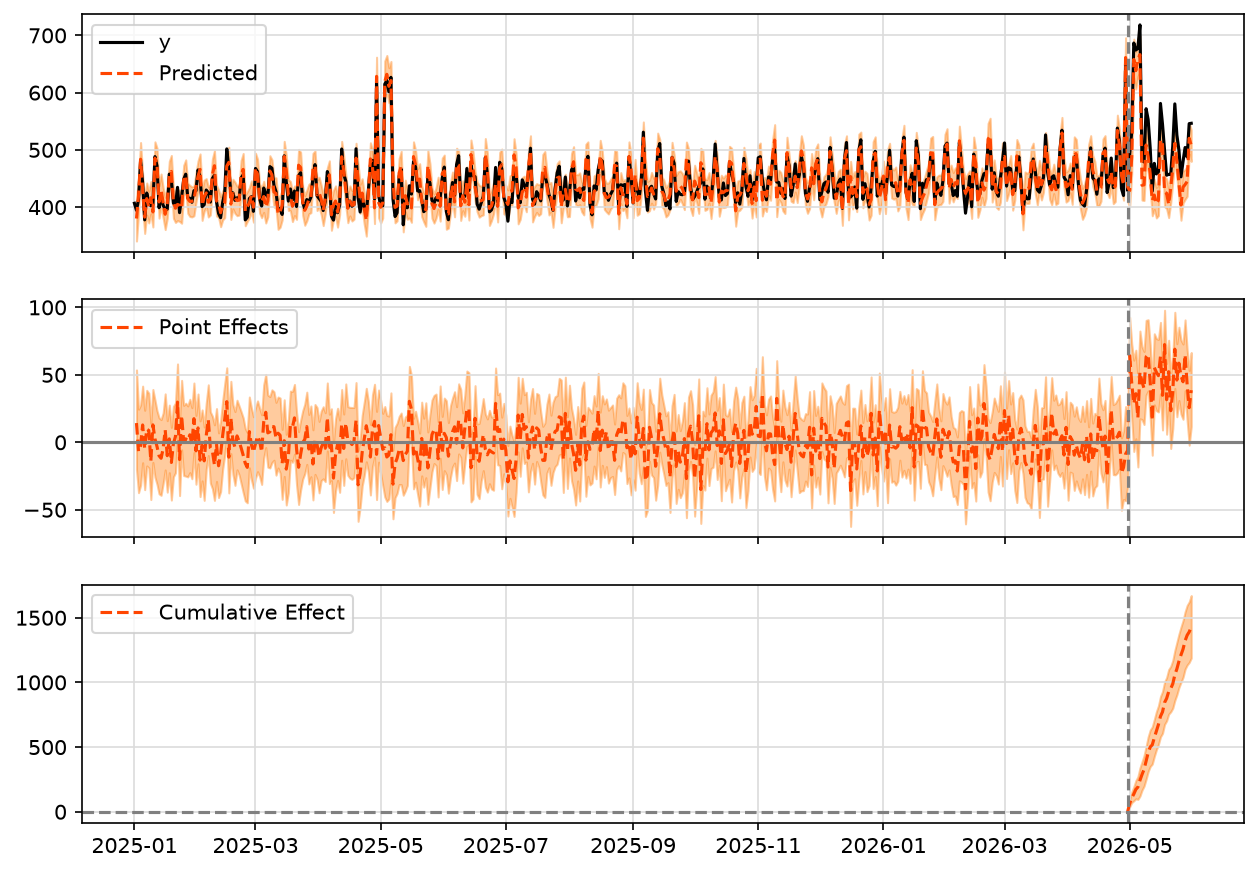
- 上段(original):実測値(y、黒線)と予測(Predicted、オレンジの点線)。帯は予測の95%区間
- 中段(pointwise):日ごとの効果。実測値から予測を引いたもの
- 下段(cumulative):日ごとの効果を足し上げたもの。右端の値が、期間全体の効果の合計
読みどころは2つ。
1つ目は、キャンペーン前は中段が0のまわりにあること。予測がふだんの売上をよく再現できている証拠です。2025年のGWの山でも、中段は0のまわりから外れていません。
2つ目は、キャンペーン開始後に中段が0より上に張り付くこと。効果が一時的なものではなく、期間中ずっと続いていたと読めます。
CausalImpactが向いている場面・向いていない場面
| 向いている | 向いていない |
|---|---|
| 施策の開始日がはっきりしている | 施策が徐々に浸透し、いつ始まったか曖昧 |
| 介入前のデータが十分にある(季節の周期1回分以上) | 介入前のデータが数週間しかない |
| 施策の影響を受けていない対照系列がある(なくても動く) | 対照系列も施策の影響を受けている |
| 施策以外に大きな変化がなかった | 施策と同時に値上げや改装など、別の変化があった |
| A/Bテストができない(施策をした対象が1つしかない) | A/Bテストができる(それならA/Bテストのほうが確実) |
「向いていない」に当てはまるときの対処や、結果を信じてよいかを確かめる方法(プラセボテスト)は、連載の後半で扱います。
PythonでCausalImpactを使うなら、どのライブラリか
CausalImpactの本家はR版です。Python版は複数あり、中身と更新状況が違います。
| 名前 | 言語 | 開発元 | 状況(2026年9月26日時点) |
|---|---|---|---|
| CausalImpact | R | 本家。論文のアルゴリズムをそのまま実装 | |
| tfcausalimpact | Python | WillianFuks氏(個人) | R版に近い実装。0.0.19(2026年9月20日公開)でPython 3.8〜3.13に対応 |
| tfp-causalimpact | Python | GoogleのTensorFlow Probabilityチーム | 0.2.0(2023年5月)以降、更新なし。Googleの公式サポート製品ではない旨の注記あり |
| pycausalimpact | Python | WillianFuks氏ら | 0.1.1(2020年5月)で更新停止。Python 3.8まで |
この連載ではtfcausalimpactを使います。理由は3つです。
- R版と同じく、ベイズ推定でモデルを当てはめる実装である
- 2026年9月にも新しい版が出ており、更新が続いている
pip install tfcausalimpactの1行で、必要なもの(TensorFlow、TensorFlow Probability、tf-keras)がそろう
なお、tfcausalimpact 0.0.19は pandas の版を2.2.3以下に制限しています。新しいpandas(3.x)が入った環境にインストールすると、pandasが入れ替わります。仮想環境を作ってからインストールするのがおすすめです。手順は第2回でまとめます。
ありがちな失敗:キャンペーンの影響を受けた店を比較相手にする
CausalImpactの予測は、対照系列(他店舗の売上)を頼りにしています。その対照系列が、キャンペーンの影響を受けていたらどうなるか。
たとえば、キャンペーンにつられて、近くの店舗Aのお客さんが自店舗に流れたとします。店舗Aの売上は下がり、それを手がかりにした予測も下がります。実測値と予測の差、つまり効果は本当より大きく出ます。
逆に、キャンペーンの告知を見たお客さんが、同じチェーンの店舗Aにも来ていたらどうか。店舗Aの売上が伸びて予測も上がり、効果は本当より小さく出ます。
どちらの場合も、出力は何事もなかったように数字を返します。対照系列が施策の影響を受けていないかは、データではなく現場の事情で確かめる必要があります。対照系列の選び方は第8回、結果を検証する方法(プラセボテスト)は第10回で扱います。
この連載で学ぶこと(全11回)
| 回 | タイトル | 学べること |
|---|---|---|
| 第1回 | 施策の効果測定で「前後比較」が危ない理由と反実仮想の考え方 | 前後比較が誤る3つのパターンを図で確かめる |
| 第2回 | tfcausalimpactのインストール手順(Windows)とtf-kerasエラーの直し方 | 環境をつまずかずに作る |
| 第3回 | CausalImpactの練習用データをPythonで作る(正解の効果を仕込む) | この記事で使った売上データを自分で作る |
| 第4回 | PythonでCausalImpactを動かす最小コード(pre_period・post_periodの指定) | データの形と期間の指定方法 |
| 第5回 | CausalImpactのsummary()の見方(相対効果・95%区間・事後確率) | 出力の数字を1行ずつ読めるようになる |
| 第6回 | CausalImpactのplot()の見方(original・pointwise・cumulative) | 3段グラフの意味と使い方 |
| 第7回 | CausalImpactの仕組み:ベイズ構造時系列モデルをやさしく解説 | 「予測」の中で何が起きているか |
| 第8回 | CausalImpactの共変量(対照系列)の選び方と入れてはいけない系列 | 精度を上げる系列、結果を壊す系列 |
| 第9回 | CausalImpactのmodel_args設定:季節性(nseasons)と介入前期間で結果はどう変わる? | 設定による結果の違い |
| 第10回 | CausalImpactの前提条件と注意点:プラセボテストで結果を検証する | 出た結果を信じてよいかの確かめ方 |
| 第11回 | CausalImpactの結果をビジネスレポートにまとめる方法(効果額・区間・確率の伝え方) | 上司やクライアントへの伝え方 |
読む順番の目安です。
- まず自分のPCで動かしたい:第2回 → 第3回 → 第4回 → 第5回
- 考え方から順に理解したい:第1回から順番に
- すでに動かしていて、結果を信じてよいか不安:第8回 → 第10回
まとめ
今回のポイントです。
- 前後比較の14.7%には、GW・土日の多さ・伸びのトレンドなど、キャンペーンがなくても増えた分が混ざる
- CausalImpactは「キャンペーンがなかったら」の売上を予測し、実測値との差を効果とみなす
- 練習用データでは推定9.6%(95%区間 8.17〜11.13%)。仕込んだ正解の10%を区間の中に捉えた
- 予測の精度を支えるのは、施策の影響を受けていない対照系列(他店舗の売上)
- 対照系列が施策の影響を受けると、効果を大きくも小さくも見誤る。出力は何も警告しない
よくある質問
対照系列(他店舗のデータ)がなくても使えますか?
使えます。自店舗の過去の売上だけで「ふだんの動き」を学び、予測します。
ただし、GWのような特別な日を予測に反映しにくくなり、予測の精度が落ちやすくなります。
対照系列あり・なしの比較は第8回で行います。
A/Bテストと何が違いますか?
A/Bテストは、同じ期間に「施策あり」と「施策なし」のグループをランダムに分けて比べます。
CausalImpactは、施策をした対象が1つしかなく、ランダムに分けられなかった施策を、施策前の動きと対照系列から評価します。
A/Bテストができるなら、そちらのほうが確実です。
「Posterior prob. of a causal effect」は、p値と同じものですか?
同じではありません。
1行上の「Posterior tail-area probability p」は、この大きさの効果が偶然だけで生じる確率を表し、p値と似た読み方をします。
ただし、ベイズ統計の考え方で計算した値です。「Posterior prob. of a causal effect」は、1からこのpを引いて%で表したものです。詳しくは第5回で扱います。
日次以外(週次・月次)のデータでも使えますか?
使えます。ただし、データの点数が減るので、介入前期間を長めに取る必要があります。
目安は季節の周期1回分以上です。たとえば、年ごとの季節性がある月次データなら、2年分以上あると安心です。
