- 問題
- 答え
- 解説
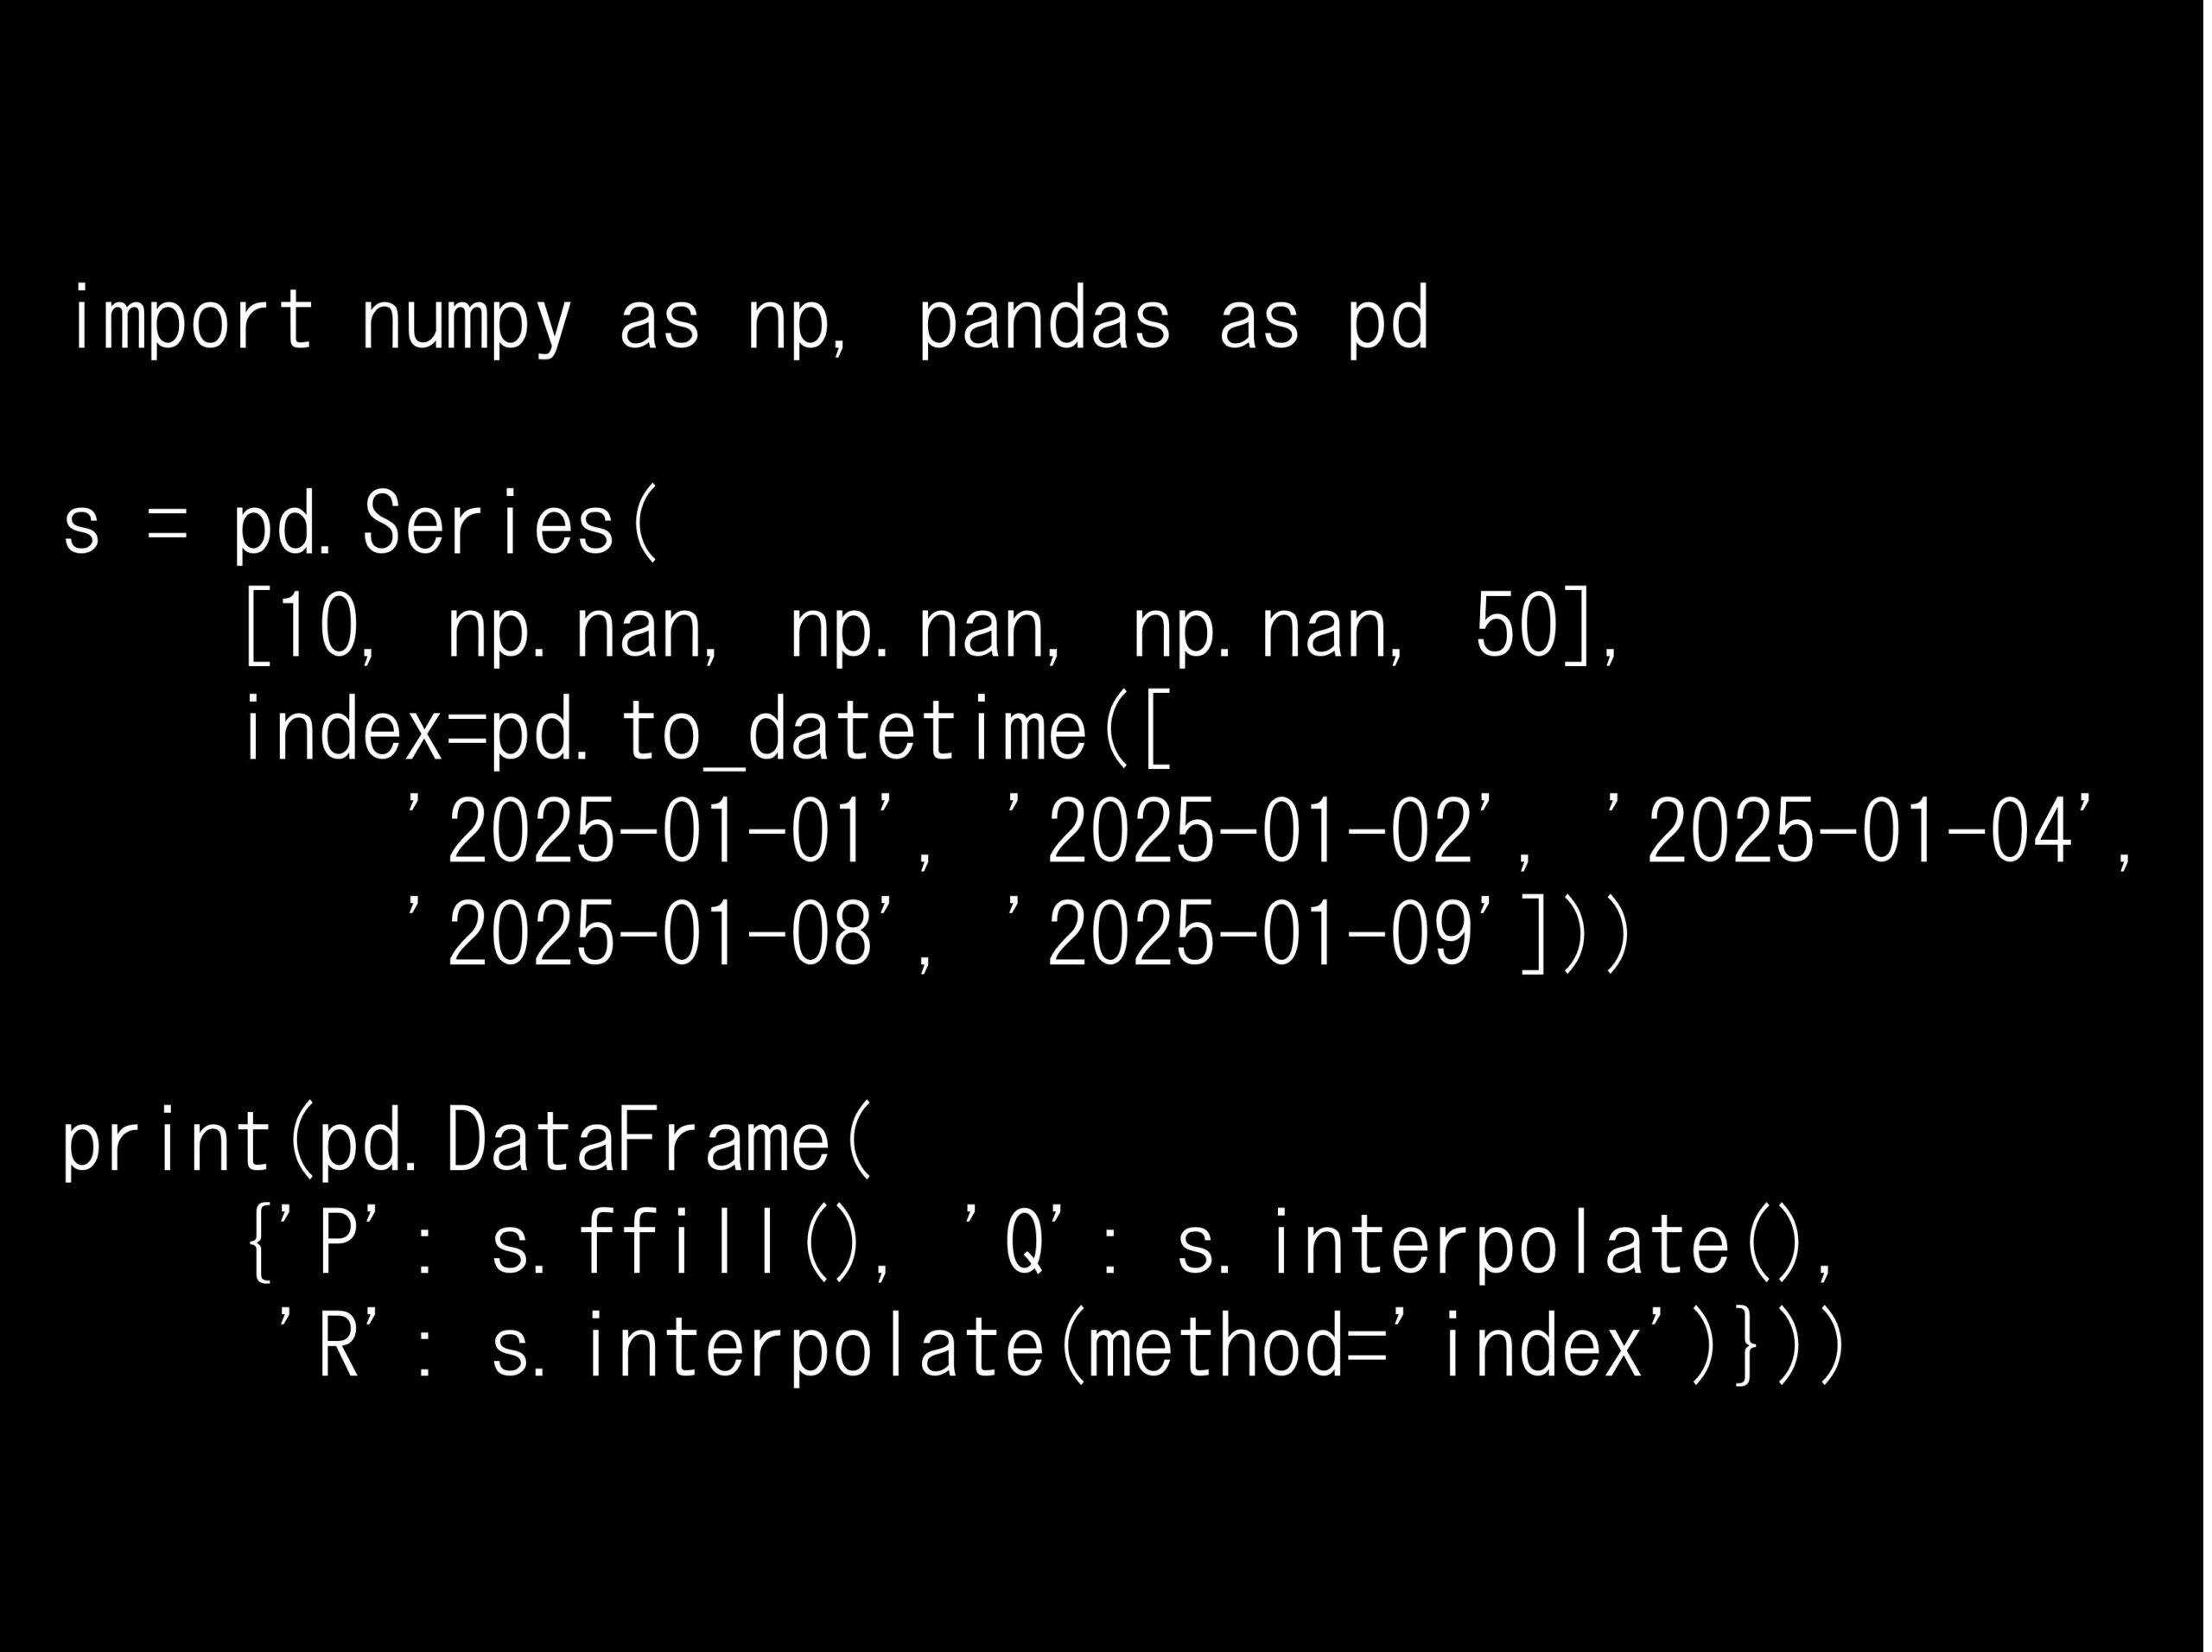
Python コード:
import numpy as np, pandas as pd

s = pd.Series(
    [10, np.nan, np.nan, np.nan, 50],
    index=pd.to_datetime([
        '2025-01-01', '2025-01-02', '2025-01-04',
        '2025-01-08', '2025-01-09']))

print(pd.DataFrame(
    {'P': s.ffill(), 'Q': s.interpolate(),
     'R': s.interpolate(method='index')}))
回答の選択肢:
(A) Rは、欠損の直前と直後の値の平均で、すべての欠損を一律に埋めている
(B) Rは、欠損の直後の値をさかのぼって、そのまま使っている
(C) Rは、日付の間隔に応じて、前後の値を結ぶ直線上の値で埋めている
(D) Rは、前後の値をなめらかな曲線(スプライン)でつないで埋めている
               P     Q     R
2025-01-01  10.0  10.0  10.0
2025-01-02  10.0  20.0  15.0
2025-01-04  10.0  30.0  25.0
2025-01-08  10.0  40.0  45.0
2025-01-09  50.0  50.0  50.0
正解: (C)
Q列とR列は、どちらも前後の観測値を直線で結ぶ線形補間です。違いは「横軸に何を使うか」にあります。
interpolate()の既定(method='linear')は、インデックスの値を無視し、行が等間隔に並んでいるとみなして補間します。10から50までの4区間を均等に分けるため、20、30、40となります。
一方、method='index'は、インデックスの値(ここでは日付)を横軸として補間します。1月1日から1月9日までの8日間で40増えるため、1日あたり5ずつ増える直線になり、1月2日は15、1月4日は25、1月8日は45となります。日付の間隔が不揃いなデータでは、R列のほうが実際の時間の流れに沿った補完値になります。
なお、P列のffill()(前方補完)は、欠損の直前の観測値(10)をそのまま繰り返して埋めています。
回答の選択肢:
(A) Rは、欠損の直前と直後の値の平均で、すべての欠損を一律に埋めている
(B) Rは、欠損の直後の値をさかのぼって、そのまま使っている
(C) Rは、日付の間隔に応じて、前後の値を結ぶ直線上の値で埋めている
(D) Rは、前後の値をなめらかな曲線(スプライン)でつないで埋めている
- コードの解説
-
このコードは、日付の間隔が不揃いな時系列の欠損値を、3つの方法で補完して比較しています。
import numpy as np, pandas as pd

s = pd.Series(
    [10, np.nan, np.nan, np.nan, 50],
    index=pd.to_datetime([
        '2025-01-01', '2025-01-02', '2025-01-04',
        '2025-01-08', '2025-01-09']))

print(pd.DataFrame(
    {'P': s.ffill(), 'Q': s.interpolate(),
     'R': s.interpolate(method='index')}))
詳しく説明します。
ライブラリのインポート
numpy:欠損値を表すnp.nanを使うためにインポートしています。pandas:時系列データの作成と欠損値の補完に使用しています。
データの作成
pd.Series([10, np.nan, np.nan, np.nan, 50], ...):最初と最後だけ値があり、間の3点が欠損した系列です。pd.to_datetime([...]):日付のインデックスです。1月1日→2日→4日→8日→9日と、間隔が1日、2日、4日、1日と不揃いになっています。センサーの記録が不定期な場合や、営業日だけ記録されたデータなどをイメージしてください。
3つの補完方法
s.ffill()(P列):前方補完(forward fill)です。欠損を、直前の観測値で埋めます。s.interpolate()(Q列):既定のmethod='linear'による線形補間です。行を等間隔とみなして、前後の値を直線で結びます。s.interpolate(method='index')(R列):インデックスの値を横軸として線形補間します。日付インデックスの場合は、日付の間隔が反映されます。
出力の読み方
- P列:欠損の3点がすべて10になっています。
- Q列:20、30、40と、行ごとに10ずつ均等に増えています。
- R列:15、25、45と、日付の間隔に比例して増えています(1日あたり5)。
- 選択肢の解説
-
(A) Rは、欠損の直前と直後の値の平均で、すべての欠損を一律に埋めている → ×
前後の平均((10+50)/2=30)で一律に埋めると、3点すべてが30になるはずです。R列の値は15、25、45と時点ごとに異なっています。(B) Rは、欠損の直後の値をさかのぼって、そのまま使っている → ×
これは後方補完(bfill())の説明です。後方補完であれば、3点すべてが直後の観測値50になります。P列の前方補完(ffill())とは、使う値の向きが逆です。(C) Rは、日付の間隔に応じて、前後の値を結ぶ直線上の値で埋めている → ○
正解です。method='index'は、日付を横軸とした直線上の値で補完します。1月1日(10)と1月9日(50)を結ぶ直線は1日あたり5増えるため、1月2日は15、1月4日は25、1月8日は45になります。(D) Rは、前後の値をなめらかな曲線(スプライン)でつないで埋めている → ×
スプライン補間はmethod='spline'と次数orderで指定します(SciPyが必要)。R列の値は完全に一直線上に並んでおり、曲線による補間ではありません。 - 補完方法の比較
-
pandasでよく使う補完方法をまとめます。
方法 コード 今回の補完値 向いているデータ 前方補完 s.ffill()10, 10, 10 次の変化まで値が保たれるもの(在庫残高、価格、設定値など) 後方補完 s.bfill()50, 50, 50 先頭の欠損を埋める補助的な用途 線形補間(行基準) s.interpolate()20, 30, 40 等間隔で記録された連続的な量 線形補間(時間基準) s.interpolate(method='index')15, 25, 45 間隔が不揃いな連続的な量(気温、センサー値など) スプライン補間 s.interpolate(method='spline', order=3)- なめらかに変化する量(観測点が十分にある場合) 日付インデックスの場合、
method='time'を指定してもmethod='index'と同じ結果(15, 25, 45)になります。等間隔に直してから補間する方法
不揃いな日付を日次の等間隔に直してから補間しても、同じ結果が得られます。s.resample('D').asfreq().interpolate()resample('D').asfreq()で1月1日〜9日の9行に広げ(記録のない日は欠損)、行が等間隔になったところで線形補間します。補完値は1日ごとに10, 15, 20, …, 50となり、1月2日・4日・8日の値はR列と一致します。 - 線形補間の式
-
時点t_0の値y_0と時点t_1の値y_1の間にある時点tの補完値は、次の式で求められます。
$$
\hat{y}(t) = y_0 + (y_1 – y_0)\,\frac{t – t_0}{t_1 – t_0}
$$Q列とR列の違いは、この式のtに何を使うかだけです。
- Q列(
method='linear'):tは行番号(0, 1, 2, 3, 4)です。1月2日は10+40\times\frac{1}{4}=20になります。 - R列(
method='index'):tは日付(1月1日からの日数:0, 1, 3, 7, 8)です。1月2日は10+40\times\frac{1}{8}=15になります。
日付が等間隔に並んでいれば、両者は同じ結果になります。違いが出るのは、今回のように間隔が不揃いなときだけです。そのため、普段は等間隔のデータで処理していると気づきにくい落とし穴です。 - Q列(
- 補完とデータリーク
-
予測モデルを作る場面では、補完方法によって未来の情報の混入(データリーク)が起きるかどうかが変わります。
方法 使う情報 リークの危険 前方補完( ffill)過去の値のみ なし 後方補完( bfill)未来の値 あり 線形補間( interpolate)過去と未来の値 あり 線形補間は、欠損の後にある観測値(今回の50)を使って補完値を決めます。過去データの分析や可視化では問題ありませんが、「その時点で予測していたら」という条件でバックテストを行う場合、補完値に未来の情報が入り込みます。その結果、検証での精度が実運用より良く見えてしまいます。
予測の検証では、前方補完のように過去の情報だけで補完するか、学習データの範囲内で補完処理を完結させることが重要です。
- 実務での注意点
-
欠損の意味を確認する
補完方法を選ぶ前に、「なぜ欠損しているのか」を確認しましょう。たとえば売上データの欠損が「販売がなかった日」であれば、正しい値は0であり、補間で埋めるのは誤りです。一方、センサーの通信エラーによる欠損であれば、前後の値からの補間が妥当です。データの性質に合わせて選ぶ
在庫残高や商品価格のように、次に更新されるまで値が保たれるものは前方補完が自然です。気温や流量のように連続的に変化するものは線形補間が向いています。日付の間隔が不揃いなら、method='index'(または'time')を使いましょう。先頭・末尾の欠損の扱い
interpolate()は、既定では先頭の欠損を埋めませんが、末尾の欠損は直前の値で埋めます(前方補完と同じ動き)。前後を観測値で挟まれた欠損だけを補間したい場合は、limit_area='inside'を指定します。長い欠損区間には注意
欠損が長く続く区間を直線や同じ値で埋めると、本来あったはずの変動(季節性や曜日パターン)が消えてしまいます。limit引数で連続して補完する個数に上限を設ける、あるいは季節成分を考慮した補完(季節分解してから補間する、モデルで予測した値で埋めるなど)を検討しましょう。補完したことを記録する
補完した値は実際の観測値ではありません。補完の有無を示すフラグ列を残しておくと、後の分析で補完値の影響を確認したり、モデルの特徴量として使ったりできます。
