生成AIの回答をJSON(データを文字で表すための書き方の決まり)で受け取るとき、OpenAIのAPIには Structured Outputs(構造化出力)という仕組みがあります。返してほしい形をスキーマ(形の定義)として渡すと、生成AIはその形どおりのJSONを返します。スキーマは、Pythonの辞書で書けます。
スキーマ = {
    "type": "object",
    "properties": {
        "商品名": {"type": "string"},
        "評価": {"type": "string", "enum": ["好調", "ふつう", "低調"]},
        "見出し": {"type": "string"},
        "コメント": {"type": "string"},
    },
    "required": ["商品名", "評価", "見出し", "コメント"],
    "additionalProperties": False,
}
「キーは4つで、評価は3つの言葉のどれか」という形です。同じ形を、Pydantic(パイダンティック。データの形をクラスとして書き、その形に合っているかを確かめるPythonのライブラリ)を使うと、次のように書けます。
class ProductComment(BaseModel):
    商品名: str
    評価: Literal["好調", "ふつう", "低調"]
    見出し: str
    コメント: str
短くなるだけではありません。受け取った回答も、辞書ではなくこのクラスのオブジェクトとして手に入り、結果.評価 のように取り出せます。
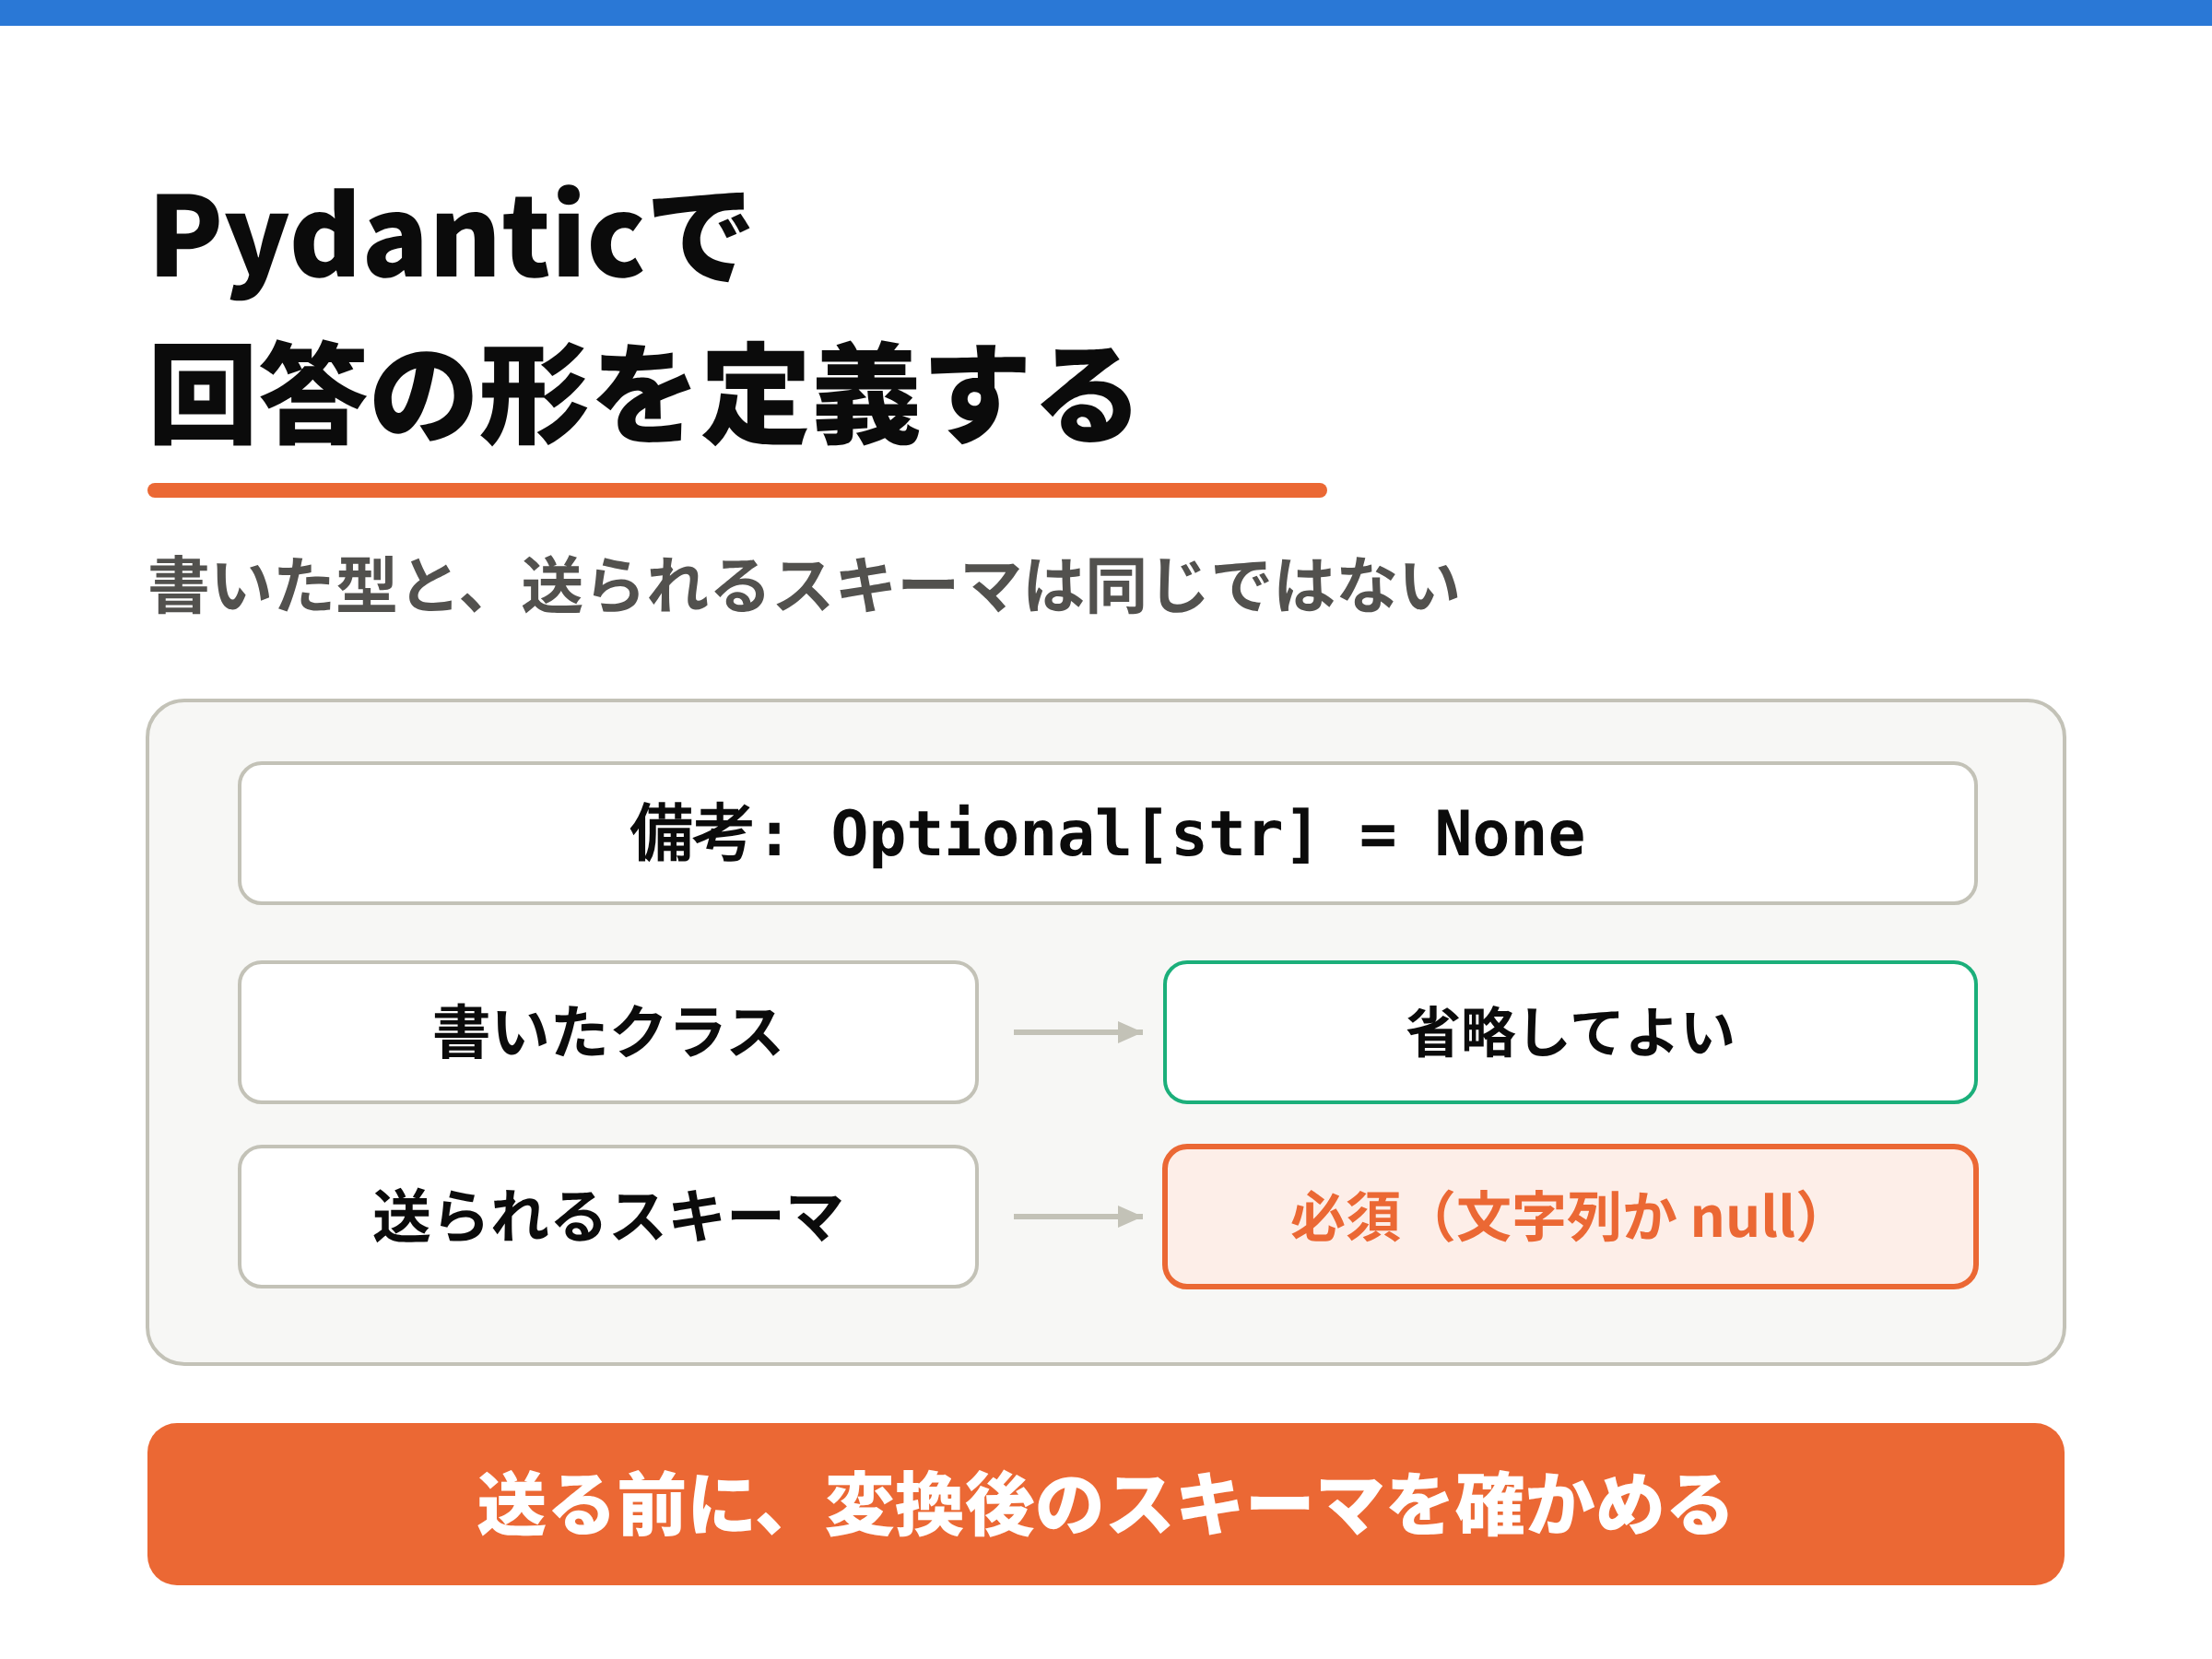
ただし、気をつけることがあります。書いたクラスが、そのまま生成AIへ送られるわけではありません。 OpenAIのライブラリ(SDK)が、クラスをスキーマに変換してから送ります。その変換を知らないと、「無ければ省略してよい」つもりで書いた項目に、生成AIが必ず何かを書いてくる、といった意図と違う動きになります。この記事では、Pydanticで形を書いて受け取る方法と、書いたクラスがどんなスキーマとして送られるかを、Pythonで確かめます。
先に、この記事の結論を3つ書いておきます。
- Pydanticのクラスを
responses.parse(text_format=クラス)に渡すと、回答がoutput_parsedにそのクラスのオブジェクトとして入ります。結果.評価のように取り出せ、受け取るときに手元でも形が確かめられます - 送られるスキーマは、書いたクラスと同じではありません。 SDKが、すべての項目を必須にします。既定値(値が無いときに使う値)を置いた項目も必須になるので、生成AIは必ず何かを書きます
- 送る前に、変換後のスキーマを表示して確かめます。 既定値は置かず、「無い」を表したい項目は
Optionalにして、Noneが来る前提で受け取ります
この記事を読み終えると、次のことができるようになります。
- Pydanticのクラスで、返してほしいJSONの形を書ける
responses.parse()で呼び出し、output_parsedでクラスのオブジェクトとして受け取れる- 書いたクラスが、どんなスキーマとして送られるかを表示して確かめられる
- 既定値を置いた項目が、送られるスキーマでどう変わるか説明できる
parse()が例外を出すときと、Noneを返すときを区別して受け取れる

【月1 特定テーマ講座(12月)】
需要予測エージェントを作る(需要予測 × PYTHON × 生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| JSON | データを文字で表すための書き方の決まり。{"商品名": "幕の内弁当"} のように書く |
| スキーマ | JSONの形(キーの名前・値の種類・選択肢)の定義。JSON Schema という決まりで書く |
| Structured Outputs | OpenAIのAPIにスキーマを渡し、その形どおりのJSONを返させる仕組み。日本語では「構造化出力」 |
| Pydantic | データの形をクラスとして書き、その形に合っているかを確かめるPythonのライブラリ |
| クラス/BaseModel | クラスは、データの形(どんな項目があり、それぞれどんな種類か)を定義するPythonの書き方。BaseModel はPydanticのクラスの土台 |
| 型ヒント | 商品名: str のように、項目の種類を書くPythonの書き方。str は文字列 |
| Literal | 「値はこの中のどれか」と選択肢を決める型 |
| Optional | 「その型か、None」を表す型。Optional[str] は「文字列か None」 |
| None/null | 「何もない」を表す値。Pythonでは None、JSONでは null と書く |
| 既定値(デフォルト値) | 値が渡されなかったときに使われる値。備考: Optional[str] = None の = None の部分 |
| オブジェクト/属性 | クラスから作った実物がオブジェクト。結果.評価 のように . で取り出す中身が属性 |
| 検証/ValidationError | データが決めた形に合っているかを確かめること。合わないと、Pydanticは ValidationError という例外を出す |
| responses.parse() | OpenAI Python SDK の関数。クラスを渡すと、回答をそのクラスのオブジェクトにして返す |
| output_parsed | parse() の応答のうち、クラスのオブジェクトになった回答が入っている場所 |
| required | スキーマで「このキーは必ずある」と決める書き方 |
| 環境変数 | パソコン側に置いておく設定値。APIキーをコードに直接書かないために使う |
使うものと準備
この記事のコードは、JupyterLab(ブラウザの中でPythonを少しずつ実行できる開発環境)で動かす前提で書いています。JupyterLabでは、ノートブック(拡張子が .ipynb のファイル)を開き、コードをセル(コードを入力して実行する枠)に貼って、Shift + Enter で1つずつ実行します。この記事のコードも、上から順にセルへ貼って実行してください。
APIキーが必要なのは、生成AIを実際に呼び出すセルだけです。 クラスを書く部分、送られるスキーマを確かめる部分は、APIキーがなくても試せます。
ライブラリを入れる
次のコマンドで、pandas(表の集計に使う)と openai(OpenAIのAPIを呼ぶのに使う)を入れます。pip は、Pythonのライブラリを入れるためのコマンドです。
pip install pandas openai
このコマンドは、ターミナル(WindowsならPowerShell)で実行します。JupyterLabのセルで実行するときは、先頭に % を付けて %pip install pandas openai とします。JupyterLab自体がまだ入っていない場合は、ターミナルで pip install jupyterlab を実行して入れ、jupyter lab で起動します。
Pydanticは、openai を入れると一緒に入ります(openai が内部で使っているためです)。この記事のコードは、Pydantic の 2 系(バージョン番号が 2 で始まるもの)が前提です。次のセルで確かめられます。
import pydantic

print(pydantic.VERSION)
2.14.3
売上CSVを読む
使うのは、コンビニの売上を想定した学習用のCSVファイル sample_sales_202607.csv です。CSVは、値をカンマで区切って並べた表のファイルで、Excelでも開けます。2026年7月6日(月)〜12日(日)の7日間について、5商品の売上が1日1行ずつ、計35行入っています。この記事からダウンロードして、ノートブック(.ipynb ファイル)と同じフォルダに置いてください。
import json
import pandas as pd

df = pd.read_csv("sample_sales_202607.csv")
print(df.head())
           日付 曜日       商品名 カテゴリ  単価(円)  数量  売上金額(円)
0  2026-07-06  月   おにぎり(鮭)   主食    160  29     4640
1  2026-07-06  月   アイスコーヒー   飲料    180  28     5040
2  2026-07-06  月    サンドイッチ   軽食    380  26     9880
3  2026-07-06  月     幕の内弁当   弁当    620  19    11780
4  2026-07-06  月  緑茶 500ml   飲料    150  36     5400
import jsonは、JSONを扱うための道具を読み込みます。Pythonに最初から入っているので、インストールは要りませんimport pandas as pdは、pandasをpdという短い名前で使えるようにしますpd.read_csv()はCSVファイルを読み込み、表(DataFrame)にします。df.head()は先頭の5行だけを表示します
生成AIに渡すデータを作る
計算はPythonで済ませ、生成AIには文章を書く役だけを頼みます。生成AIは文章を作るのは得意ですが、たくさんの数字から合計を正確に計算するのは得意ではないからです。
商品別に集計する
商品別 = (
    df.groupby(["商品名", "カテゴリ"], as_index=False)
      .agg(売上金額=("売上金額(円)", "sum"), 販売数量=("数量", "sum"))
      .sort_values("売上金額", ascending=False)
      .reset_index(drop=True)
)
商品別["売上構成比"] = (商品別["売上金額"] / 商品別["売上金額"].sum() * 100).round(1)

print(商品別)
        商品名 カテゴリ   売上金額  販売数量  売上構成比
0     幕の内弁当   弁当  93000   150   33.1
1    サンドイッチ   軽食  64220   169   22.9
2   アイスコーヒー   飲料  41580   231   14.8
3   おにぎり(鮭)   主食  41120   257   14.6
4  緑茶 500ml   飲料  41100   274   14.6
groupby(["商品名", "カテゴリ"], as_index=False)は、商品名(とカテゴリ)が同じ行を1つのグループにまとめますagg(売上金額=("売上金額(円)", "sum"), …)は、グループごとに合計(sum)し、売上金額という名前の列にしますsort_values("売上金額", ascending=False)は売上金額の大きい順に並べ、reset_index(drop=True)は行番号を0から振り直します- 最後の行で、売上金額を合計で割って100を掛け、
round(1)で小数第1位までに丸めた 売上構成比(全体の売上に占める割合、%)の列を足しています
1商品ずつJSONにする
生成AIには、1商品ずつ頼みます。そのために、表の1行を1つの辞書にし、それをJSONの文字列にします。
レコード = 商品別.to_dict("records")

print(json.dumps(レコード[3], ensure_ascii=False))
{"商品名": "おにぎり(鮭)", "カテゴリ": "主食", "売上金額": 41120, "販売数量": 257, "売上構成比": 14.6}
to_dict("records") は、表の1行を1つの辞書にして、リスト(順番に並べたもの)にまとめます。レコード[3] はその4つ目(おにぎり(鮭))です。json.dumps() で辞書をJSONの文字列にし、ensure_ascii=False で日本語をそのまま出しています(付けないと、日本語が \u304a のような記号の列になります)。このあと、回答の例はこのおにぎり(鮭)のものを使います。
Pydanticのクラスで形を書く
ここは、APIキーがなくても試せます。
クラスを書く
from typing import Literal
from pydantic import BaseModel

class ProductComment(BaseModel):
    商品名: str
    評価: Literal["好調", "ふつう", "低調"]
    見出し: str
    コメント: str
class ProductComment(BaseModel):で、ProductCommentという名前のクラスを作ります。(BaseModel)は「PydanticのBaseModelを土台にする」という意味で、これを付けると、形を確かめる機能やスキーマを作る機能がクラスに備わります商品名: strは、「商品名という項目があり、値は文字列(str)」という意味です。この名前: 種類の書き方を型ヒントと呼びますLiteral["好調", "ふつう", "低調"]は、「値はこの3つのどれか」という意味です。辞書のスキーマの"enum"に当たります- クラス名は半角英数字にします。 理由は、あとの「名前はクラス名になる」で説明します。項目名(
商品名など)は、JSONのキーになるので日本語でかまいません
クラスにJSONを読ませる
クラスに、生成AIの回答に当たるJSONの文字列を読ませてみます。
完全なJSON = '{"商品名": "おにぎり(鮭)", "評価": "ふつう", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。売上金額は41,120円で、全体の14.6%です。"}'

結果 = ProductComment.model_validate_json(完全なJSON)

print(type(結果).__name__)
print(結果.評価)
print(結果.見出し)
ProductComment
ふつう
販売数量が多い主食
ProductComment.model_validate_json(文字列)は、JSONの文字列を読み、クラスの形に合っているかを確かめたうえで、クラスのオブジェクト(実物)を作りますtype(結果).__name__は、結果の種類の名前です。ProductCommentのオブジェクトになっています結果.評価のように、.(ドット)に続けて項目名を書くと、値を取り出せます。辞書の結果["評価"]に当たる書き方です
辞書に戻したいときは、model_dump() を使います。表(DataFrame)にするときに便利です。
print(結果.model_dump())
{'商品名': 'おにぎり(鮭)', '評価': 'ふつう', '見出し': '販売数量が多い主食', 'コメント': '販売数量は257点です。売上金額は41,120円で、全体の14.6%です。'}
形に合わないJSONは、読む時点で止まる
評価が選択肢になく、コメントが欠けているJSONを読ませてみます。
from pydantic import ValidationError

崩れたJSON = '{"商品名": "おにぎり(鮭)", "評価": "まずまず", "見出し": "販売数量が多い主食"}'

try:
    ProductComment.model_validate_json(崩れたJSON)
except ValidationError as e:
    for err in e.errors():
        print(err["loc"], err["msg"])
('評価',) Input should be '好調', 'ふつう' or '低調'
('コメント',) Field required
- 形に合わないと、Pydanticは
ValidationErrorという例外(実行中に起きた問題)を出します。try/exceptは、例外が起きても止まらずに、決めておいた処理へ進ませる書き方です e.errors()は、合わなかった点のリストです。err["loc"]がどの項目か、err["msg"]が何が合わないかを表します
「評価は、好調・ふつう・低調のどれかであるべき」「コメントは必須」と、2つとも見つけています。クラスは、形を書くものであると同時に、形を確かめるものでもあります。
responses.parse() で呼び出す
ここでは、生成AIを実際に呼び出します。APIキーが必要です。APIキーがない場合は読み飛ばして、「送られるスキーマを確かめる」から試してください。
APIキーとモデルIDを環境変数に入れる
APIの利用は有料です(使った量に応じた従量課金。単価は OpenAIの料金ページ で確認できます)。ChatGPTの有料プランを契約していても、APIの利用料はその中に含まれません。APIキーは、OpenAIの開発者向けサイト(API keys のページ)で作ります。
APIを呼ぶには、APIキーとモデルID(使うモデルの名前)が要ります。どちらもコードには直接書かず、環境変数(パソコン側に置いておく設定値)から読みます。
- APIキーをコードに書くと、ノートブックを人に渡したときに、キーも一緒に渡ってしまいます。 漏れたキーは他人に使われ、料金が発生するおそれがあります
- モデルIDは、新しいモデルが出ると変わります。 Structured Outputs は、対応しているモデルでしか使えません。使えるモデルIDは、OpenAIの公式ドキュメントのモデル一覧で確認してください
Windowsなら、PowerShell(Windowsに入っているコマンド入力の画面)で次のように設定し、同じ画面から JupyterLab を起動します。"…" の中は、自分のAPIキーとモデルIDに置き換えてください。
$env:OPENAI_API_KEY = "ここにAPIキーを貼る"
$env:OPENAI_MODEL = "使うモデルのID"
jupyter lab
Anaconda Prompt(Anacondaに付いてくる、コマンドプロンプト形式の画面)を使っている場合は、書き方が変わります。値をダブルクォートで囲まないのがポイントです。囲むと、ダブルクォートまで値の一部になってしまいます。
set OPENAI_API_KEY=ここにAPIキーを貼る
set OPENAI_MODEL=使うモデルのID
jupyter lab
macOS・Linuxのターミナルでは、次のとおりです。
export OPENAI_API_KEY="ここにAPIキーを貼る"
export OPENAI_MODEL="使うモデルのID"
jupyter lab
いずれも、設定したウィンドウの中だけで有効です。別のウィンドウから起動した JupyterLab では読めないので、設定したのと同じウィンドウで jupyter lab を実行してください。すでに JupyterLab を開いている場合は、いったん閉じてから起動し直します。
参考までに、Google Colab を使う場合は、画面左側の鍵のアイコン(シークレット)に OPENAI_API_KEY という名前でAPIキーを登録し、セルで次のように読み込みます。
import os
from google.colab import userdata

os.environ["OPENAI_API_KEY"] = userdata.get("OPENAI_API_KEY")
os.environ["OPENAI_MODEL"] = "使うモデルのID"
ルールを書く
OpenAIのAPIでは、生成AIへの指示を2つの引数に分けて渡せます。instructions には毎回同じルールを、input にはその都度変わるデータ(ここでは1商品ぶんのJSON)を入れます。
ルール = """あなたは小売店の売上を説明する担当者です。
入力はJSONで、1商品ぶんの売上金額・販売数量・売上構成比(全体に占める割合、%)が入っています。
各項目には、次の内容を書いてください。
- 商品名:入力の商品名を、1文字も変えずにそのまま書く
- 評価:売上構成比が20以上なら「好調」、10未満なら「低調」、それ以外は「ふつう」
- 見出し:20字以内
- コメント:2文以内。入力にある数値だけを使う"""
""" で囲むと、改行を含む長い文字列を書けます。どんな項目があるかはクラスで渡すので、ルールには「各項目に何を書くか」だけを書いています。 評価の基準(売上構成比が20以上なら「好調」など)や、見出しとコメントの長さです。
呼び出す
import os
from openai import OpenAI

client = OpenAI()                      # OPENAI_API_KEY を環境変数から読む
MODEL = os.environ["OPENAI_MODEL"]     # モデルIDも環境変数から読む

response = client.responses.parse(
    model=MODEL,
    instructions=ルール,
    input=json.dumps(レコード[3], ensure_ascii=False),
    text_format=ProductComment,        # ← 形はクラスで渡す
    max_output_tokens=400,             # 出力の上限(トークン数)
)

結果 = response.output_parsed            # ← クラスのオブジェクトで受け取る
print(type(結果).__name__)
print(結果.評価)
print(結果.見出し)
OpenAI()は、環境変数OPENAI_API_KEYからAPIキーを読んで、APIを呼ぶ準備をします。os.environ["OPENAI_MODEL"]は、環境変数からモデルIDを読みますclient.responses.parse(…)がAPIの呼び出しです。text_format=ProductCommentで、クラスそのものを渡します。 SDKがクラスをスキーマに変換して送り、返ってきたJSONをクラスのオブジェクトにしてくれますmax_output_tokens=400は、出力の上限です。1回の応答で生成してよいトークン数(生成AIが文章を数える単位)を400までに制限していますresponse.output_parsedが、ProductCommentのオブジェクトになった回答です。結果.評価・結果.見出しのように取り出せます
辞書でスキーマを渡す書き方と比べると、変わるのは3か所です。
| 項目 | 辞書でスキーマを渡す | Pydanticのクラスを渡す |
|---|---|---|
| 呼び出す関数 | client.responses.create() |
client.responses.parse() |
| 形の渡し方 | text={"format": {"type": "json_schema", "name": …, "schema": スキーマ, "strict": True}} |
text_format=ProductComment |
| 受け取り方 | json.loads(response.output_text)(辞書) |
response.output_parsed(クラスのオブジェクト) |
parse() の応答でも、response.output_text(回答の文字列そのもの)は使えます。回答をそのまま記録に残したいときは、こちらを保存します。
送られるスキーマを確かめる
ここからは、APIキーがなくても試せます。text_format=ProductComment と書いたとき、実際には何が送られているのかを表示します。
SDKが作るスキーマを表示する
from openai.lib._pydantic import to_strict_json_schema

送るスキーマ = to_strict_json_schema(ProductComment)
print(json.dumps(送るスキーマ, ensure_ascii=False, indent=2))
{
  "properties": {
    "商品名": {
      "title": "商品名",
      "type": "string"
    },
    "評価": {
      "enum": [
        "好調",
        "ふつう",
        "低調"
      ],
      "title": "評価",
      "type": "string"
    },
    "見出し": {
      "title": "見出し",
      "type": "string"
    },
    "コメント": {
      "title": "コメント",
      "type": "string"
    }
  },
  "required": [
    "商品名",
    "評価",
    "見出し",
    "コメント"
  ],
  "title": "ProductComment",
  "type": "object",
  "additionalProperties": false
}
to_strict_json_schema() は、OpenAI Python SDK がクラスをスキーマに変換するときに使っている関数です(responses.parse() の中で呼ばれています)。json.dumps() の indent=2 は、読みやすいように字下げして表示する指定です。
openai.lib._pydanticのように、名前がアンダースコア(_)で始まるものは、SDKの内部用です。将来のバージョンで名前や場所が変わることがあります。この関数は「何が送られるかを確かめる」ためだけに使い、普段の処理のコードには書かないでください。
冒頭の辞書のスキーマと見比べてください。"properties"(項目の一覧)、"enum"(評価の選択肢)、"required"(必ずあるキー)、"additionalProperties": false(決めたキー以外は禁止)がそろっています。"title" は、Pydanticが付ける表示用の名前で、項目名とクラス名がそのまま入っています。
Pydantic自身のスキーマと比べる
Pydanticにも、クラスからスキーマを作る機能(model_json_schema())があります。SDKは、これを元にして、Structured Outputs の決まりに合うように書き換えています。どこが変わったかを比べます。
手元のスキーマ = ProductComment.model_json_schema()

print("Pydantic:", 手元のスキーマ["required"], 手元のスキーマ.get("additionalProperties"))
print("送られる:", 送るスキーマ["required"], 送るスキーマ.get("additionalProperties"))
Pydantic: ['商品名', '評価', '見出し', 'コメント'] None
送られる: ['商品名', '評価', '見出し', 'コメント'] False
.get("additionalProperties") は、辞書からその項目を取り出し、無ければ None を返す書き方です。Pydantic自身のスキーマには additionalProperties がなく(None)、SDKが False を足しています。この基本のクラスでは、SDKが変えたのはこの1点だけです。
Structured Outputs で形を厳密に守らせる(strict)ときは、スキーマに2つの決まりがあります。required にすべての項目を入れることと、additionalProperties を False にすることです。SDKは、この2つを自動で満たすようにスキーマを書き換えます。いまのクラスは4項目とも最初から必須だったので、1つ目の書き換えは目に見えませんでした。それが見えるのが、次の章です。
名前はクラス名になる
スキーマには名前を付けて送る決まりがあり、SDKはクラス名をそのまま名前として送ります。
print(ProductComment.__name__)
ProductComment
__name__ は、クラスの名前を表す文字列です。OpenAI Python SDK の説明では、この名前は「Must be a-z, A-Z, 0-9, or contain underscores and dashes, with a maximum length of 64(a〜z・A〜Z・0〜9・アンダースコア・ハイフンで、64文字以内)」とされています。クラス名を 商品コメント のように日本語にすると、その日本語が名前として送られ、この決まりに合いません。クラス名を半角英数字にしたのは、このためです。
既定値を置いた項目は、必須になる
ここが、この記事でいちばん伝えたいところです。「備考」という項目を足します。書くことが無ければ省略してよい、というつもりです。
「無ければ省略」のつもりで書く
from typing import Optional

class ProductCommentDefault(BaseModel):
    商品名: str
    評価: Literal["好調", "ふつう", "低調"]
    見出し: str
    コメント: str
    備考: Optional[str] = None           # 無ければ省略、のつもり

結果 = ProductCommentDefault.model_validate_json(完全なJSON)   # 備考が入っていないJSON
print(repr(結果.備考))
None
Optional[str]は、「文字列か、None(何もない)」という意味です。Python 3.10 以降ではstr | Noneとも書けます= Noneが既定値です。値が渡されなかったときは、Noneが入りますrepr()は、値をそのままの形で表示する関数で、Noneが入っていることが分かるようにしています
備考が入っていないJSONを読ませても、エラーになりませんでした。既定値の None が入っています。手元のPydanticでは、「無ければ省略してよい」が、書いたとおりに働いています。
送られるスキーマでは、必須になっている
では、このクラスはどんなスキーマとして送られるでしょうか。
手元 = ProductCommentDefault.model_json_schema()
送る = to_strict_json_schema(ProductCommentDefault)

print("Pydantic:", 手元["required"])
print("送られる:", 送る["required"])
print("Pydantic:", 手元["properties"]["備考"])
print("送られる:", 送る["properties"]["備考"])
Pydantic: ['商品名', '評価', '見出し', 'コメント']
送られる: ['商品名', '評価', '見出し', 'コメント', '備考']
Pydantic: {'anyOf': [{'type': 'string'}, {'type': 'null'}], 'default': None, 'title': '備考'}
送られる: {'anyOf': [{'type': 'string'}, {'type': 'null'}], 'title': '備考'}
2つの違いがあります。
requiredに備考が入りました。 Pydantic自身のスキーマでは必須は4つですが、送られるスキーマでは5つです- 既定値(
'default': None)が消えました。 残っているのは「文字列か null のどちらか」(anyOf)という指定だけです
SDKは、strict の決まり(すべての項目を必須にする)に合わせるため、既定値があってもなくても、全項目を required に入れます。既定値を消している箇所には、SDKのソースに次のコメントがあります。
strip `None` defaults as there’s no meaningful distinction here
the schema will still be `nullable` and the model will default
to using `None` anyway(訳:既定値の None は取り除く。ここでは意味のある区別にならないため。スキーマは null を許したままで、モデルはどのみち None を使う)
つまり、書いたクラスは「備考は省略してよい」と言っているのに、送られるスキーマは「備考を必ず書く。中身は文字列か null」と言っています。
生成AIは、必ず何かを書く
必須なので、生成AIは備考を省略できません。スキーマが許しているのは「文字列か null」です。どちらが書かれるかは、スキーマでは決まりません。 次の2つは、どちらもスキーマどおりの回答です。
次の2つは、説明のために作った「回答の例」で、実際のモデルの回答ではありません。
例_null = '{"商品名": "おにぎり(鮭)", "評価": "ふつう", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。", "備考": null}'
例_文 = '{"商品名": "おにぎり(鮭)", "評価": "ふつう", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。", "備考": "特になし"}'

for 例 in (例_null, 例_文):
    結果 = ProductCommentDefault.model_validate_json(例)
    if 結果.備考 is None:
        print("備考なし")
    else:
        print("備考あり:", 結果.備考)
備考なし
備考あり: 特になし
is None は、「None である」ことを確かめる書き方です。1つ目の例は備考が null なので「備考なし」になりました。2つ目の例は「特になし」という文字列なので、「備考あり」として扱われます。「無ければ None のはず」と考えて書いた処理では、「特になし」が本物の備考として表やレポートに出てしまいます。
既定値を None 以外にした場合(たとえば 注意: str = "なし")も、必須になる点は同じです。生成AIが必ず何かを書くので、既定値の「なし」が使われることはありません。
既定値を置かずに、None が来る前提で書く
対策は3つです。
- 既定値を置かない。 「無い」を表したい項目は
Optional[str]だけにします。こうすると、書いたクラスと送られるスキーマがそろいます - ルールに、無いときの書き方を書く。 「無ければ null にする」と頼みます
- 受け取る側は、
Noneが来る前提で書く。is Noneで分けます
1つ目から確かめます。
class ProductCommentNullable(BaseModel):
    商品名: str
    評価: Literal["好調", "ふつう", "低調"]
    見出し: str
    コメント: str
    備考: Optional[str]                  # 既定値は置かない。文字列か None

手元 = ProductCommentNullable.model_json_schema()
送る = to_strict_json_schema(ProductCommentNullable)

print("Pydantic:", 手元["required"])
print("送られる:", 送る["required"])
Pydantic: ['商品名', '評価', '見出し', 'コメント', '備考']
送られる: ['商品名', '評価', '見出し', 'コメント', '備考']
既定値を外すと、Pydantic自身のスキーマでも備考が必須になり、書いたクラスと送られるスキーマの required が同じになりました。クラスを読めば、送られる形がそのまま分かります。
2つ目と3つ目は、呼び出しのコードで行います(APIキーが必要です)。
ルール備考つき = ルール + "\n- 備考:注意して見たい点があれば1文で書く。無ければ null にする"

response = client.responses.parse(
    model=MODEL,
    instructions=ルール備考つき,
    input=json.dumps(レコード[3], ensure_ascii=False),
    text_format=ProductCommentNullable,
    max_output_tokens=400,
)

結果 = response.output_parsed
if 結果.備考 is None:
    print("備考なし")
else:
    print("備考あり:", 結果.備考)
ルール + "\n- 備考:…"は、元のルールの最後に1行足しています。\nは改行を表す記号ですtext_format=ProductCommentNullableで、既定値を置かないクラスを渡します- 受け取ったあとは、
結果.備考 is Noneで「備考なし」と「備考あり」を分けます
ルールに書いても、生成AIが必ず null を選ぶとは限りません。ただ、何も書かないときよりは、意図が伝わります。スキーマで決まるのは形まで、という点は変わりません。
parse() が例外を出すとき、None を返すとき
responses.parse() は、返ってきた回答の文字列を、ProductComment.model_validate_json() と同じ方法でクラスに読み込みます。そのため、回答がクラスの形に合わないと、parse() の呼び出しそのものが ValidationError になります。 Structured Outputs が形を保証しているので、普段はここで止まりません。止まるのは、回答が途中で切れたときです。
途中で切れた回答は、ValidationError になる
出力の上限(max_output_tokens)に達すると、生成AIはJSONの途中でも書くのをやめます。そのとき何が起きるかを、手元で再現します。完全なJSONを先頭の76文字で切って、クラスに読ませます。
切れたJSON = 完全なJSON[:76]            # 先頭の76文字で切る
print(切れたJSON)

try:
    ProductComment.model_validate_json(切れたJSON)
except ValidationError as e:
    print(e.errors()[0]["type"])
    print(e.errors()[0]["msg"])
{"商品名": "おにぎり(鮭)", "評価": "ふつう", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。売上金
json_invalid
Invalid JSON: EOF while parsing a string at line 1 column 162
完全なJSON[:76]は、文字列の先頭から76文字を取り出す書き方ですe.errors()[0]は、合わなかった点の1つ目です。"type"が種類、"msg"が説明です
json_invalid は「JSONとして読めない」、EOF while parsing a string は「文字列を読んでいる途中で、終わりに達した」という意味です(column 162 は、文字数ではなくバイト数で数えた位置です。日本語は1文字が3バイトなので、76文字が162バイトになっています)。
responses.parse() でも、同じことが起こります。しかも、例外になると応答そのものが手に入らないので、「上限で切れた」ことを示す response.status を確かめられません。 エラーの文面(Invalid JSON: EOF while parsing …)から、途中で切れたと判断することになります。
拒否されたときは、None が返る
生成AIが安全上の理由で回答を断ったときは、例外にはなりません。回答の文字列が無いので、response.output_parsed が None になります。結果.評価 と書いた時点で、「None には 評価 という属性が無い」というエラー(AttributeError)になるので、取り出す前に None かどうかを確かめます。
受け取る側の関数にまとめる
ここまでを、1商品ぶんを呼び出して受け取る関数にまとめます(APIキーが必要です)。
def 受け取る(r, 上限=400):
    try:
        response = client.responses.parse(
            model=MODEL,
            instructions=ルール,
            input=json.dumps(r, ensure_ascii=False),
            text_format=ProductComment,
            max_output_tokens=上限,
        )
    except ValidationError as e:
        return {"状態": f"形に合わない: {e.errors()[0]['msg']}", "結果": None}
    if response.status != "completed":
        return {"状態": f"完了していない: {response.status}", "結果": None}
    if response.output_parsed is None:
        return {"状態": "回答がない(拒否など)", "結果": None}
    return {"状態": "OK", "結果": response.output_parsed}
def 受け取る(r, 上限=400):は、この処理に名前を付けて関数にしています。上限=400は、指定しなければ400を使うという意味ですtryの中でparse()を呼び、ValidationErrorが起きたら「形に合わない」と、その説明を返します。途中で切れたときは、ここに来ますresponse.status != "completed"は、「完了していない」ことの確かめ方です。回答が1文字も出ないまま上限に達した場合などは、例外にならず、statusが"incomplete"になりますresponse.output_parsed is Noneなら、回答が無い(拒否など)と返します- どれにも当てはまらなければ、
"状態"を"OK"にして、クラスのオブジェクトを返します
この関数で、5商品ぶんを受け取って表にします。
行 = []
for r in レコード:
    受取 = 受け取る(r)
    if 受取["状態"] == "OK":
        行.append(受取["結果"].model_dump())
    else:
        print(r["商品名"], "→", 受取["状態"])

コメント表 = pd.DataFrame(行)
print(コメント表[["商品名", "評価", "見出し"]])
受取["状態"] == "OK"のものだけ、model_dump()で辞書にして行に足します。それ以外は、商品名と状態を表示しますpd.DataFrame(行)は、辞書のリストから表を作ります。項目名がそのまま列名になります
状態に「形に合わない: Invalid JSON: EOF while parsing …」と出た商品は、出力の上限で切れた可能性が高いので、受け取る(r, 上限=800) のように上限を上げて呼び直します。
Claude・Geminiではここが違う
Pydanticのクラスは、3社とも同じものを使えます。 変わるのは、クラスの渡し方と受け取り方です。そして、同じクラスでも、送られるスキーマは社ごとに違います。
| 項目 | OpenAI | Gemini | Claude |
|---|---|---|---|
| 呼び出す関数 | responses.parse() |
models.generate_content() |
messages.parse() |
| クラスを渡す引数 | text_format= |
config= の response_schema=( response_mime_type も必要) |
output_format= |
| 受け取り方 | response.output_parsed |
response.parsed |
message.parsed_output |
| 既定値を置いた項目 | 必須になる | 必須にならない | 必須にならない |
| 途中で切れたとき | ValidationError になる |
例外は出ず、parsed が None |
ValidationError になる |
「既定値を置いた項目」の行が大事です。GeminiとClaudeのSDKは、既定値のある項目を必須にしません。そのため、OpenAIでは必ず書かれていた備考が、GeminiやClaudeでは省略されることがあります。 既定値を置かないクラス(ProductCommentNullable の書き方)にしておけば、3社とも「必須」でそろいます。
APIキーは GEMINI_API_KEY・ANTHROPIC_API_KEY、モデルIDは GEMINI_MODEL・CLAUDE_MODEL という名前の環境変数に入れておく前提で書いています。設定のしかたは、OpenAIのときと同じです。
Gemini の場合
pip install google-genai で入れておきます。
import os
from google import genai
from google.genai import types

client = genai.Client()                # GEMINI_API_KEY を環境変数から読む

response = client.models.generate_content(
    model=os.environ["GEMINI_MODEL"],
    contents=json.dumps(レコード[3], ensure_ascii=False),
    config=types.GenerateContentConfig(
        system_instruction=ルール,
        response_mime_type="application/json",
        response_schema=ProductComment,        # ← クラスを渡す
        max_output_tokens=400,
    ),
)

結果 = response.parsed                   # クラスに読み込めなかったときは None
if 結果 is None:
    print("読み込めない:", response.candidates[0].finish_reason)
else:
    print(結果.評価, 結果.見出し)
Geminiでは、response_schema にクラスを渡し、response.parsed で受け取ります。クラスに読み込めなかったとき(途中で切れたときなど)は、例外を出さずに None になるので、None なら終了理由(finish_reason)を表示しています。
google-genai 2.25.0 では、最初の呼び出しで「Direct use of automatic function calling (AFC) …」という注意が1度表示されることがあります。関数の自動実行についての注意で、この記事のコードの動作には影響しません。
Claude の場合
pip install anthropic で入れておきます。
import os
from anthropic import Anthropic

client = Anthropic()                   # ANTHROPIC_API_KEY を環境変数から読む

message = client.messages.parse(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=400,                    # 出力の上限(Claudeでは必須)
    system=ルール,
    messages=[{"role": "user", "content": json.dumps(レコード[3], ensure_ascii=False)}],
    output_format=ProductComment,      # ← クラスを渡す
)

結果 = message.parsed_output
print(結果.評価, 結果.見出し)
Claudeでは、messages.parse() の output_format にクラスを渡し、message.parsed_output で受け取ります。出力の上限 max_tokens は必ず指定します。途中で切れたときは、OpenAIと同じく parse() が ValidationError を出すので、実際に使うときは try / except で囲みます。
まとめ
今回のポイントです。
| 覚えておくこと | |
|---|---|
| 形の書き方 | BaseModel を土台にしたクラスに、項目名: 種類 を並べる。選択肢は Literal。クラス名は半角英数字(スキーマの名前として送られる) |
| 呼び出し方 | responses.parse(text_format=クラス) → response.output_parsed がクラスのオブジェクト |
| 送られるスキーマ | SDKがクラスを変換して送る。全項目を required に入れ、additionalProperties を False にする |
| 既定値を置いた項目 | 送られるスキーマでは必須になり、既定値は使われない。既定値は置かず、「無い」は Optional と None で表す |
| 確かめ方 | to_strict_json_schema(クラス) で、送られるスキーマを表示する(確かめるためだけに使う) |
parse() の結果 |
途中で切れた回答は ValidationError、拒否は output_parsed が None。try / except と is None で受ける |