生成AIの回答をJSON(データを文字で表すための書き方の決まり)で受け取るとき、OpenAIのAPIには Structured Outputs(構造化出力)という仕組みがあります。返してほしい形をスキーマ(形の定義)として渡すと、生成AIはその形どおりのJSONを返します。キーが欠けたり、名前が変わったりする心配がなくなるので、回答をプログラムで処理する場面ではこれを使います。
ところが、Structured Outputs を使っていても、スキーマどおりのJSONが返ってこないことが2つあります。
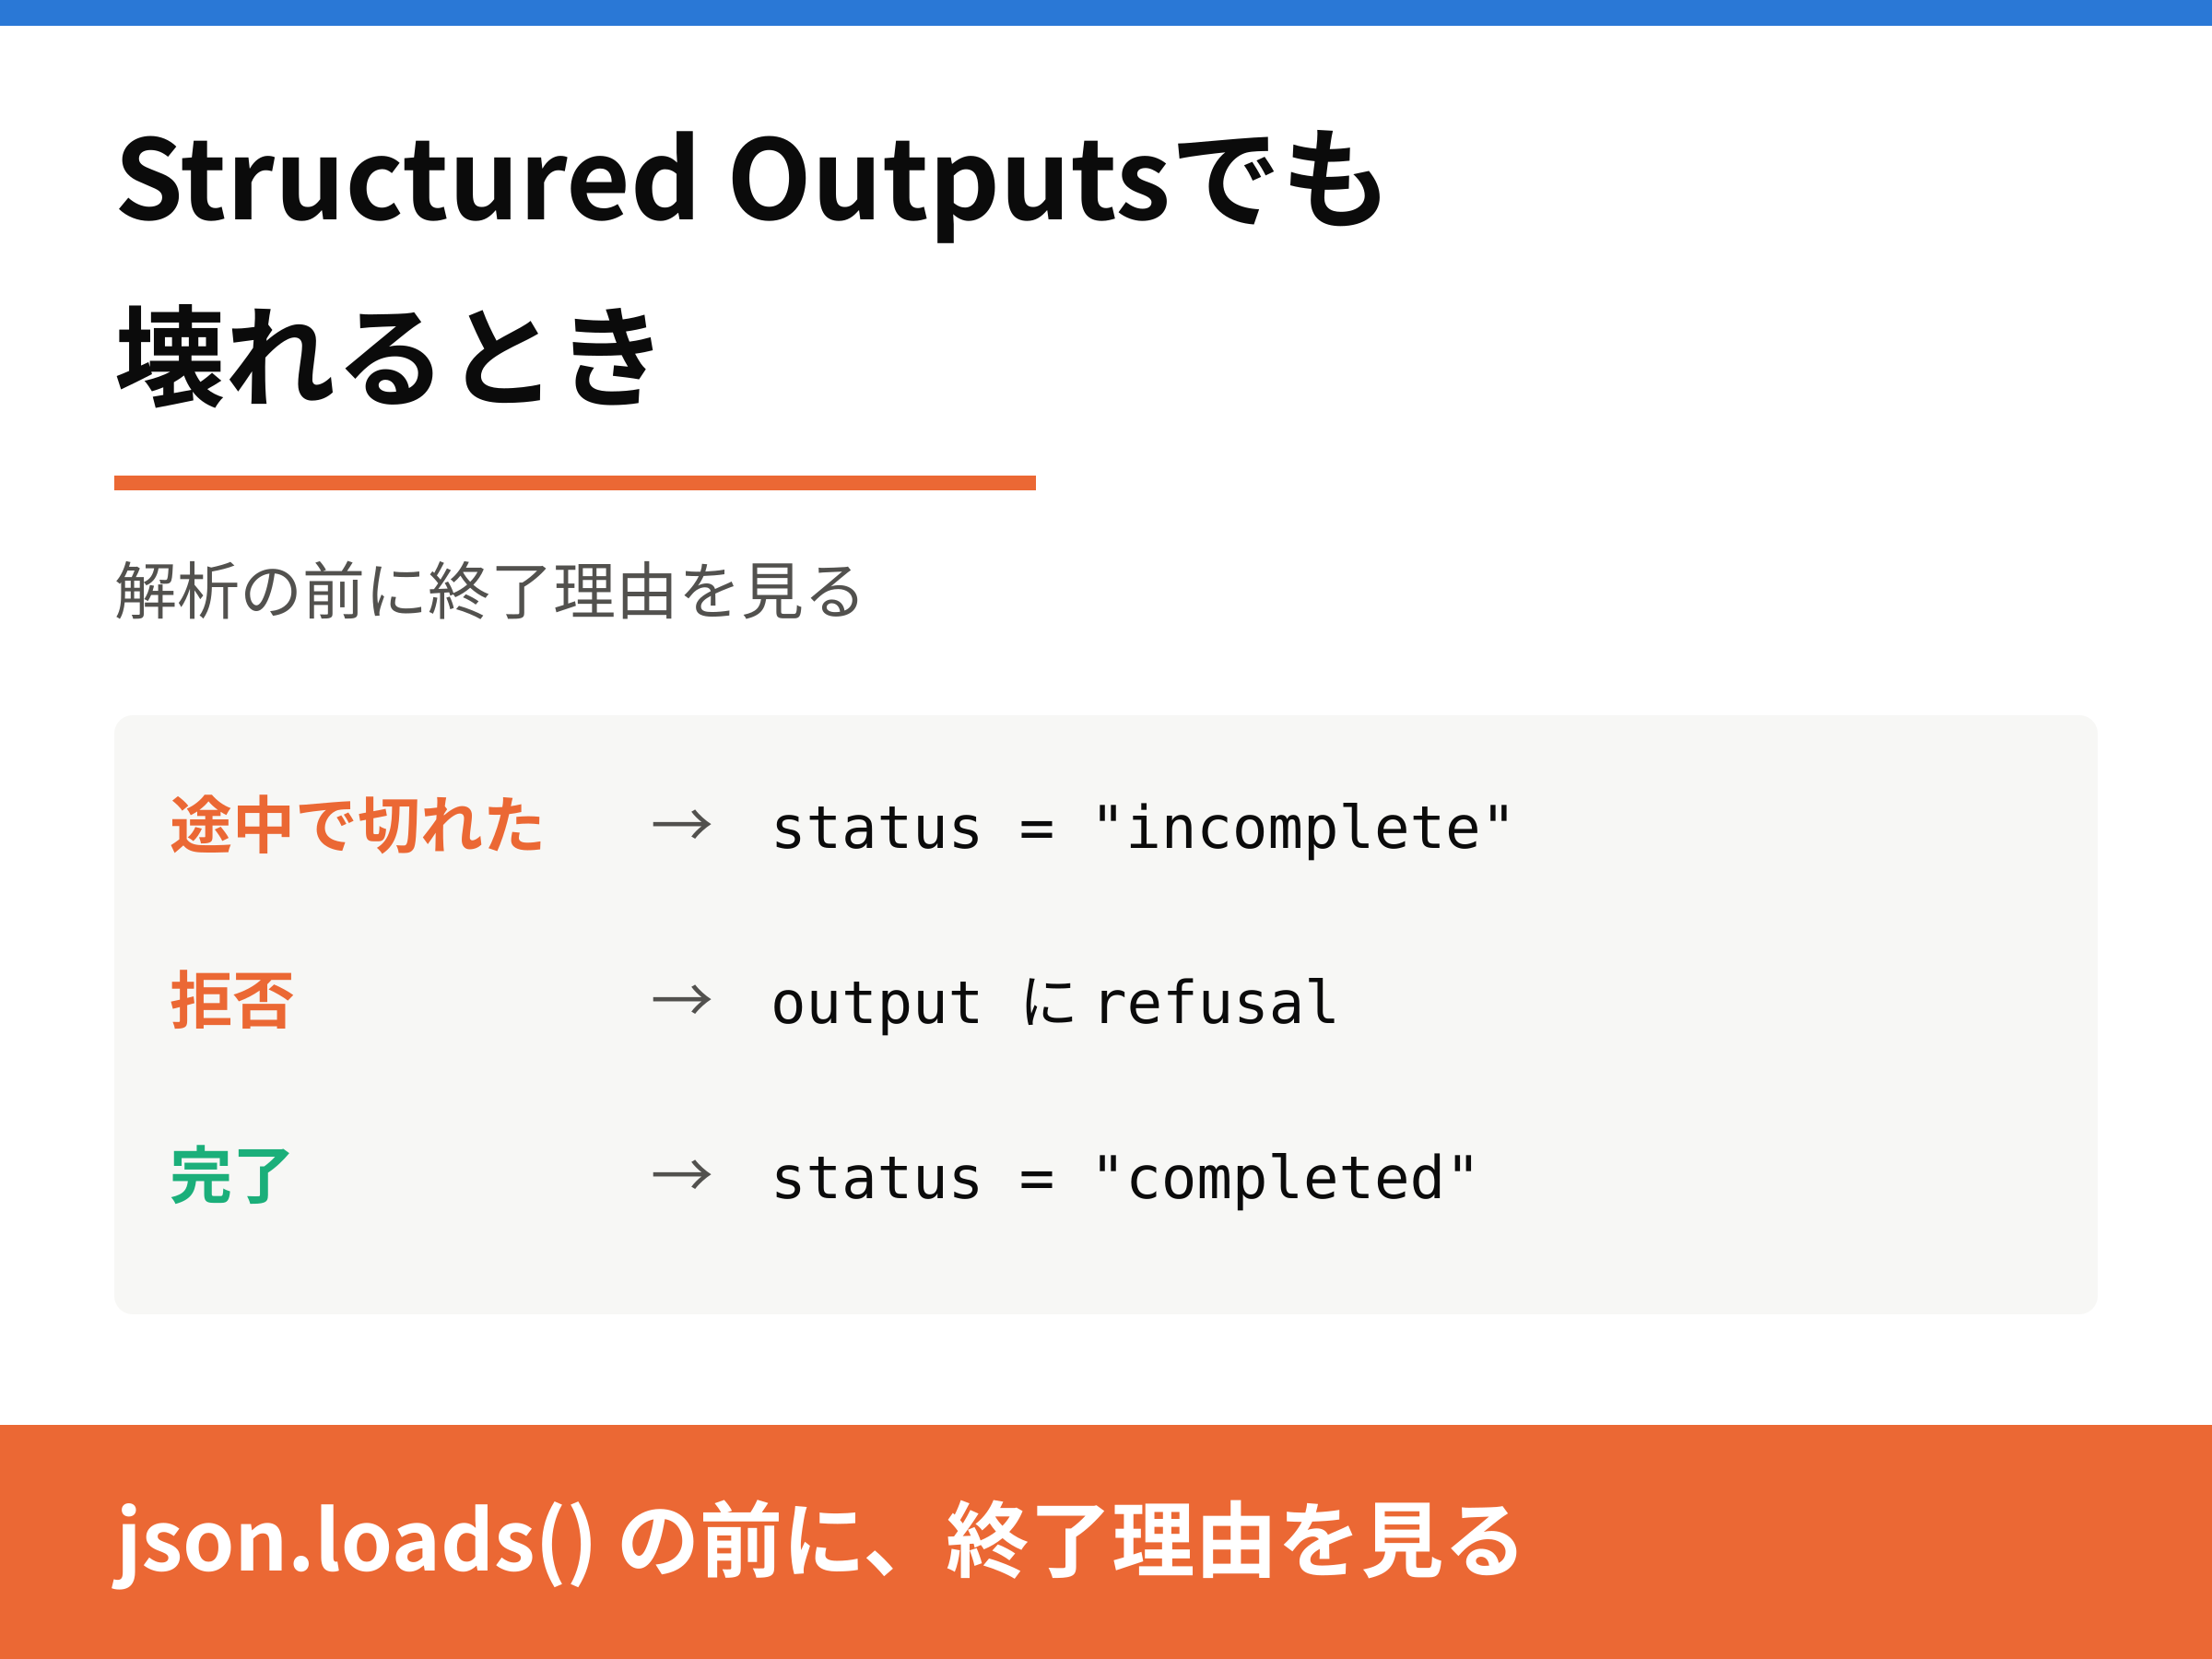
- 回答が途中で切れたとき。 出力の長さの上限に達すると、JSONは書きかけのまま終わります
- 生成AIが回答を断ったとき。 安全上の理由で断ると、JSONの代わりに「お応えできません」という文が返ります
どちらの場合も、回答の文字列を json.loads()(JSONの文字列をPythonの辞書に変える関数)に渡すとエラーになります。しかし、エラーの文面を見ても、なぜそうなったのかは分かりません。 この記事では、2つの壊れ方をPythonで1つずつ確かめ、json.loads() の前に見るべきもの(応答の終了理由)と、途中で切れないための出力上限の決め方を説明します。
先に、この記事の結論を3つ書いておきます。
- 回答を
json.loads()する前に、応答のstatusを見ます。"incomplete"なら途中で終わっていて、incomplete_details.reasonに理由(出力上限なら"max_output_tokens")が入っています - 断られた回答は、文字列の回答(
output_text)ではなくrefusal(拒否)として返ります。output_textは空の文字列になるので、json.loads()は「何もない」というエラーになります - 出力上限
max_output_tokensは、普段の回答の長さを測って、その2倍以上にします。 上限は回答を切り詰めるための値ではなく、止まらなくなったときの安全装置です
この記事を読み終えると、次のことができるようになります。
- Structured Outputs を使っても、スキーマどおりのJSONが返らない2つの場合を説明できる
- 応答の
status・incomplete_details・outputを見て、終了理由を調べられる json.loads()の前に終了理由を確かめる、受け取り側の関数を書ける- 出力上限
max_output_tokensを、普段の出力トークン数から決められる - 途中で切れたときに、上限を上げて頼み直せる

【月1 特定テーマ講座(12月)】
需要予測エージェントを作る(需要予測 × PYTHON × 生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| JSON | データを文字で表すための書き方の決まり。{"商品名": "幕の内弁当"} のように書く |
| json.loads() | JSONの文字列を読んで、Pythonの辞書に戻す関数。読めない文字列なら JSONDecodeError になる |
| スキーマ | JSONの形(キーの名前・値の種類・選択肢)の定義。JSON Schema という決まりで書く |
| Structured Outputs | OpenAIのAPIにスキーマを渡し、その形どおりのJSONを返させる仕組み。日本語では「構造化出力」 |
| 応答(response) | APIから返ってくるもの全体。回答の文字列だけでなく、状態や使用量などの情報も入っている |
| status | 応答の状態。"completed"(完了)や "incomplete"(途中で終わった)など |
| incomplete_details | 途中で終わった理由。reason に "max_output_tokens" などが入る |
| トークン | 生成AIが文章を数える単位。日本語ではおおむね1〜2文字で1トークン。料金も上限もトークン数で決まる |
| max_output_tokens | 1回の応答で生成してよいトークン数の上限。達すると回答が途中で終わる |
| usage | 応答に含まれる使用量の情報。output_tokens が出力に使ったトークン数 |
| 拒否(refusal) | 生成AIが安全上の理由で回答を断ること。応答の中に refusal という種類の項目として入る |
| output / output_text | output は応答の中身の一覧、output_text はそのうち文字列の回答だけをつなげたもの |
| SimpleNamespace | 「名前と値」を入れておける、Pythonの簡単な入れ物。この記事では応答の例を作るのに使う |
| API | プログラムから別のサービスを呼び出すための窓口。ここでは、Pythonから生成AIを呼び出す窓口 |
| 環境変数 | パソコン側に置いておく設定値。APIキーをコードに直接書かないために使う |
使うものと準備
この記事のコードは、JupyterLab(ブラウザの中でPythonを少しずつ実行できる開発環境)で動かす前提で書いています。JupyterLabでは、ノートブック(拡張子が .ipynb のファイル)を開き、コードをセル(コードを入力して実行する枠)に貼って、Shift + Enter で1つずつ実行します。この記事のコードも、上から順にセルへ貼って実行してください。
APIキーが必要なのは、生成AIを実際に呼び出すセルだけです。 壊れ方を確かめる部分は、この記事で用意した「回答の例」を使うので、APIキーがなくても試せます。
ライブラリを入れる
次のコマンドで、pandas(表の集計に使う)と openai(OpenAIのAPIを呼ぶのに使う)を入れます。pip は、Pythonのライブラリを入れるためのコマンドです。
pip install pandas openai
このコマンドは、ターミナル(WindowsならPowerShell)で実行します。JupyterLabのセルで実行するときは、先頭に % を付けて %pip install pandas openai とします。
JupyterLab自体がまだ入っていない場合は、ターミナルで pip install jupyterlab を実行して入れ、jupyter lab で起動します。ブラウザが開き、JupyterLabの画面が表示されます。
売上CSVを読む
使うのは、コンビニの売上を想定した学習用のCSVファイル sample_sales_202607.csv です。CSVは、値をカンマで区切って並べた表のファイルで、Excelでも開けます。2026年7月6日(月)〜12日(日)の7日間について、5商品の売上が1日1行ずつ、計35行入っています。この記事からダウンロードして、ノートブック(.ipynb ファイル)と同じフォルダに置いてください。
以下からダウンロードできます。
import json
import pandas as pd

df = pd.read_csv("sample_sales_202607.csv")
print(df.head())
           日付 曜日       商品名 カテゴリ  単価(円)  数量  売上金額(円)
0  2026-07-06  月   おにぎり(鮭)   主食    160  29     4640
1  2026-07-06  月   アイスコーヒー   飲料    180  28     5040
2  2026-07-06  月    サンドイッチ   軽食    380  26     9880
3  2026-07-06  月     幕の内弁当   弁当    620  19    11780
4  2026-07-06  月  緑茶 500ml   飲料    150  36     5400
import jsonは、JSONを扱うための道具を読み込みます。Pythonに最初から入っているので、インストールは要りませんimport pandas as pdは、pandasをpdという短い名前で使えるようにしますpd.read_csv()はCSVファイルを読み込み、表(DataFrame)にします。df.head()は先頭の5行だけを表示します
生成AIに渡すデータを作る
計算はPythonで済ませ、生成AIには文章を書く役だけを頼みます。生成AIは文章を作るのは得意ですが、たくさんの数字から合計を正確に計算するのは得意ではないからです。
商品別に集計する
商品別 = (
    df.groupby(["商品名", "カテゴリ"], as_index=False)
      .agg(売上金額=("売上金額(円)", "sum"), 販売数量=("数量", "sum"))
      .sort_values("売上金額", ascending=False)
      .reset_index(drop=True)
)
商品別["売上構成比"] = (商品別["売上金額"] / 商品別["売上金額"].sum() * 100).round(1)

print(商品別)
        商品名 カテゴリ   売上金額  販売数量  売上構成比
0     幕の内弁当   弁当  93000   150   33.1
1    サンドイッチ   軽食  64220   169   22.9
2   アイスコーヒー   飲料  41580   231   14.8
3   おにぎり(鮭)   主食  41120   257   14.6
4  緑茶 500ml   飲料  41100   274   14.6
groupby(["商品名", "カテゴリ"], as_index=False)は、商品名(とカテゴリ)が同じ行を1つのグループにまとめますagg(売上金額=("売上金額(円)", "sum"), …)は、グループごとに合計(sum)し、売上金額という名前の列にしますsort_values("売上金額", ascending=False)は売上金額の大きい順に並べ、reset_index(drop=True)は行番号を0から振り直します- 最後の行で、売上金額を合計で割って100を掛け、
round(1)で小数第1位までに丸めた 売上構成比(全体の売上に占める割合、%)の列を足しています
1商品ずつJSONにする
生成AIには、1商品ずつ、5回に分けて頼みます。そのために、表の1行を1つの辞書にし、それをJSONの文字列にします。
レコード = 商品別.to_dict("records")

print(json.dumps(レコード[3], ensure_ascii=False))
{"商品名": "おにぎり(鮭)", "カテゴリ": "主食", "売上金額": 41120, "販売数量": 257, "売上構成比": 14.6}
to_dict("records") は、表の1行を1つの辞書にして、リスト(順番に並べたもの)にまとめます。レコード[3] はその4つ目(おにぎり(鮭))です。json.dumps() で辞書をJSONの文字列にし、ensure_ascii=False で日本語をそのまま出しています(付けないと、日本語が \u304a のような記号の列になります)。このあと、回答の例はこのおにぎり(鮭)のものを使います。
Structured Outputs で呼び出す
ここでは、生成AIを実際に呼び出します。APIキーが必要です。APIキーがない場合は読み飛ばして、「形が保証されても、受け取れないことがある」から試してください。
APIキーとモデルIDを環境変数に入れる
APIの利用は有料です(使った量に応じた従量課金。単価は OpenAIの料金ページ で確認できます)。ChatGPTの有料プランを契約していても、APIの利用料はその中に含まれません。APIキーは、OpenAIの開発者向けサイト(API keys のページ)で作ります。
APIを呼ぶには、APIキーとモデルID(使うモデルの名前)が要ります。どちらもコードには直接書かず、環境変数(パソコン側に置いておく設定値)から読みます。
- APIキーをコードに書くと、ノートブックを人に渡したときに、キーも一緒に渡ってしまいます。 漏れたキーは他人に使われ、料金が発生するおそれがあります
- モデルIDは、新しいモデルが出ると変わります。 Structured Outputs は、対応しているモデルでしか使えません。使えるモデルIDは、OpenAIの公式ドキュメントのモデル一覧で確認してください
Windowsなら、PowerShell(Windowsに入っているコマンド入力の画面)で次のように設定し、同じ画面から JupyterLab を起動します。"…" の中は、自分のAPIキーとモデルIDに置き換えてください。
$env:OPENAI_API_KEY = "ここにAPIキーを貼る"
$env:OPENAI_MODEL = "使うモデルのID"
jupyter lab
Anaconda Prompt(Anacondaに付いてくる、コマンドプロンプト形式の画面)を使っている場合は、書き方が変わります。値をダブルクォートで囲まないのがポイントです。囲むと、ダブルクォートまで値の一部になってしまいます。
set OPENAI_API_KEY=ここにAPIキーを貼る
set OPENAI_MODEL=使うモデルのID
jupyter lab
macOS・Linuxのターミナルでは、次のとおりです。
export OPENAI_API_KEY="ここにAPIキーを貼る"
export OPENAI_MODEL="使うモデルのID"
jupyter lab
いずれも、設定したウィンドウの中だけで有効です。別のウィンドウから起動した JupyterLab では読めないので、設定したのと同じウィンドウで jupyter lab を実行してください。すでに JupyterLab を開いている場合は、いったん閉じてから起動し直します。
参考までに、Google Colab を使う場合は、画面左側の鍵のアイコン(シークレット)に OPENAI_API_KEY という名前でAPIキーを登録し、セルで次のように読み込みます。
import os
from google.colab import userdata

os.environ["OPENAI_API_KEY"] = userdata.get("OPENAI_API_KEY")
os.environ["OPENAI_MODEL"] = "使うモデルのID"
ルールとスキーマを書く
OpenAIのAPIでは、生成AIへの指示を2つの引数に分けて渡せます。instructions には毎回同じルールを、input にはその都度変わるデータ(ここでは1商品ぶんのJSON)を入れます。そして、返してほしいJSONの形をスキーマとして書き、text という引数で渡します。
ルール = """あなたは小売店の売上を説明する担当者です。
入力はJSONで、1商品ぶんの売上金額・販売数量・売上構成比(全体に占める割合、%)が入っています。
次の形のJSONだけを返してください。
- キーは「商品名」「評価」「見出し」「コメント」の4つ
- 商品名:入力の商品名を、1文字も変えずにそのまま書く
- 評価:売上構成比が20以上なら「好調」、10未満なら「低調」、それ以外は「ふつう」
- 見出し:20字以内
- コメント:2文以内。入力にある数値だけを使う"""

スキーマ = {
    "type": "object",
    "properties": {
        "商品名": {"type": "string"},
        "評価": {"type": "string", "enum": ["好調", "ふつう", "低調"]},
        "見出し": {"type": "string"},
        "コメント": {"type": "string"},
    },
    "required": ["商品名", "評価", "見出し", "コメント"],
    "additionalProperties": False,
}

形式 = {"type": "json_schema", "name": "product_comment", "schema": スキーマ, "strict": True}
ルールは、"""で囲んだ長い文字列です。キーの名前、評価の基準、見出しとコメントの長さを書いていますスキーマは、返してほしい形の定義です。"properties"にキーの一覧と値の種類("string"は文字列)、"enum"に評価の選択肢、"required"に必ずあるキー、"additionalProperties": Falseで決めたキー以外を禁止しています形式は、スキーマをtext引数に渡すための辞書です。"type": "json_schema"でスキーマを使う指定、"name"はこの形の名前(半角英数字だけ)、"strict": Trueでスキーマを厳密に守らせます
呼び出す
import os
from openai import OpenAI

client = OpenAI()                      # OPENAI_API_KEY を環境変数から読む
MODEL = os.environ["OPENAI_MODEL"]     # モデルIDも環境変数から読む

応答一覧 = []
for r in レコード:
    response = client.responses.create(
        model=MODEL,
        instructions=ルール,
        input=json.dumps(r, ensure_ascii=False),
        text={"format": 形式},
        max_output_tokens=400,             # 出力の上限(トークン数)
    )
    応答一覧.append(response)              # 文字列ではなく、応答そのものをためる

for response in 応答一覧:
    print(response.status, response.usage.output_tokens)
OpenAI()は、環境変数OPENAI_API_KEYからAPIキーを読んで、APIを呼ぶ準備をします。os.environ["OPENAI_MODEL"]は、環境変数からモデルIDを読みますclient.responses.create(…)がAPIの呼び出しです。text={"format": 形式}で Structured Outputs になりますmax_output_tokens=400は、出力の上限です。 1回の応答で生成してよいトークン数(文章を数える単位)を400までに制限しています。この値の決め方は、あとの章で説明します応答一覧.append(response)で、回答の文字列ではなく、応答そのものをためています。この記事では、文字列以外の情報(状態や使用量)も使うからです- 最後の
forで、5つの応答のstatus(状態)とusage.output_tokens(出力に使ったトークン数)を表示します。普段どおりなら、statusはすべてcompletedです
APIを5回呼ぶので、そのぶんの料金がかかります。
わざと上限を小さくして呼ぶ
途中で切れた回答を実際に見てみます。max_output_tokens を30にして、おにぎり(鮭)だけを頼みます。
response = client.responses.create(
    model=MODEL,
    instructions=ルール,
    input=json.dumps(レコード[3], ensure_ascii=False),
    text={"format": 形式},
    max_output_tokens=30,                  # わざと小さくする
)

print(response.status)
print(response.incomplete_details)
print(response.output_text)
実行すると、status が incomplete、incomplete_details に reason='max_output_tokens' と表示され、output_text は途中で終わったJSONになるはずです(どこで切れるかは、モデルと実行ごとに変わります)。次の章から、この「途中で切れた応答」と、もう1つの「断られた応答」を、回答の例で確かめていきます。
形が保証されても、受け取れないことがある
Structured Outputs が保証するのは、生成AIが最後まで回答を書いたときに、その回答がスキーマどおりであることです。最後まで書けなかったときと、書くこと自体を断ったときは、保証の外です。
| 終わり方 | status | output_text | json.loads() |
|---|---|---|---|
| 完了 | "completed" |
スキーマどおりのJSON | 読める |
| 途中で切れた | "incomplete"(incomplete_details.reason が "max_output_tokens") |
書きかけのJSON | JSONDecodeError |
| 拒否 | "completed"(output の中が refusal) |
空の文字列 "" |
JSONDecodeError |
2つの壊れ方は、どちらも json.loads() で JSONDecodeError になります。同じ種類のエラーなので、エラーだけを見ていると区別できません。 区別するには、応答の status と output を見ます。
回答の例を用意する
ここからは、APIキーがなくても試せます。3つの終わり方の応答を、1つずつ「回答の例」として作ります。
次の「回答の例」は、壊れ方を説明するために作ったもので、実際のモデルの応答ではありません。
output_tokensの値も説明のために置いたものです。実際の値は、モデルと実行ごとに変わります。
応答と同じ形の入れ物を作る
APIの応答は文字列ではなく、response.status のように「名前」で中身を取り出す形をしています。例も同じ形にしておくと、本物の応答と同じコードで扱えます。そのために、Pythonに最初から入っている SimpleNamespace を使います。
from types import SimpleNamespace

入れ物 = SimpleNamespace(status="completed", output_text="こんにちは")

print(入れ物.status)
print(入れ物.output_text)
completed
こんにちは
SimpleNamespace(名前=値, …) で入れ物を作ると、入れ物.名前 で値を取り出せます。これだけの道具です。
3つの例
完全なJSON = '{"商品名": "おにぎり(鮭)", "評価": "ふつう", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。売上金額は41,120円で、全体の14.6%です。"}'
切れたJSON = '{"商品名": "おにぎり(鮭)", "評価": "ふつう", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。売上金'

例_完了 = SimpleNamespace(
    status="completed",
    incomplete_details=None,
    output=[SimpleNamespace(type="message", content=[SimpleNamespace(type="output_text", text=完全なJSON)])],
    output_text=完全なJSON,
    usage=SimpleNamespace(output_tokens=61),
)

例_途中 = SimpleNamespace(
    status="incomplete",
    incomplete_details=SimpleNamespace(reason="max_output_tokens"),
    output=[SimpleNamespace(type="message", content=[SimpleNamespace(type="output_text", text=切れたJSON)])],
    output_text=切れたJSON,
    usage=SimpleNamespace(output_tokens=30),
)

例_拒否 = SimpleNamespace(
    status="completed",
    incomplete_details=None,
    output=[SimpleNamespace(type="message", content=[SimpleNamespace(type="refusal", refusal="申し訳ありませんが、その依頼にはお応えできません。")])],
    output_text="",
    usage=SimpleNamespace(output_tokens=14),
)
完全なJSONは、スキーマどおりの回答です。切れたJSONは、その先頭76文字で切ったものです(最後の"や}がありません)例_完了は、普通に終わった応答です。statusが"completed"、incomplete_detailsはNone(何もない)、output_textに完全なJSONが入っています例_途中は、出力上限で切れた応答です。statusが"incomplete"、incomplete_details.reasonが"max_output_tokens"、output_textに切れたJSONが入っています例_拒否は、断られた応答です。statusは"completed"ですが、outputの中の項目のtypeが"output_text"ではなく"refusal"で、output_textは空の文字列ですoutputは、応答の中身の一覧です。本物の応答では、typeが"message"の項目の中にcontent(内容の一覧)があり、その1つ1つが"output_text"(文字列の回答)か"refusal"(拒否)です。例もその形に合わせています
本物の応答の output_text は、output の中の "output_text" の項目をつなげたものです。OpenAI Python SDK の説明には「If no output_text content blocks exist, then an empty string is returned(output_text の項目が1つもなければ、空の文字列を返す)」とあります。拒否された応答で output_text が空になるのは、このためです。
途中で切れた回答
json.loads() のエラーだけでは分からない
json.loads(例_途中.output_text)
JSONDecodeError: Unterminated string starting at: line 1 column 61 (char 60)
JupyterLabでは、エラーが起きると、どこで起きたかをたどる表示(トレースバック)が何行も続き、最後の行にエラーの種類と内容が出ます。この記事では、その最後の行だけを載せています。
「Unterminated string(閉じられていない文字列)」と言われました。61文字目から始まる文字列(コメントの値)が、閉じる " のないまま終わっているからです。しかし、このエラーから分かるのは「JSONとして読めない」ことだけです。生成AIがそういう回答を書いたのか、途中で切られたのかは、エラーからは分かりません。
status と incomplete_details を見る
print(例_途中.status)
print(例_途中.incomplete_details.reason)
print(例_途中.usage.output_tokens)
incomplete
max_output_tokens
30
応答の status が incomplete(途中で終わった)で、incomplete_details.reason(理由)が max_output_tokens(出力上限)です。これで、回答の中身が悪いのではなく、長さの上限で切られたのだと分かります。 usage.output_tokens は30で、上限として指定した値と同じです。
OpenAI Python SDK の型定義では、status は completed・failed・in_progress・cancelled・queued・incomplete の6つのどれかです。incomplete_details.reason には max_output_tokens のほかに content_filter(内容による制限)などがあります。
なぜ切れるのか:トークンと出力上限
生成AIは、文章をトークンという単位で数えます。英語ではおおむね1単語が1トークン、日本語ではおおむね1〜2文字が1トークンです。料金はトークン数で決まり、max_output_tokens も「1回の応答で生成してよいトークン数の上限」です。
上限に達すると、生成AIはそこで書くのをやめます。JSONの途中であっても、スキーマの途中であっても、です。 Structured Outputs は「書くならスキーマどおりに書く」ことを保証しますが、「最後まで書く」ことは保証しません。
もう1つ注意があります。OpenAI Python SDK の説明では、max_output_tokens は「An upper bound for the number of tokens that can be generated for a response, including visible output tokens and reasoning tokens(応答のために生成できるトークン数の上限。目に見える出力のトークンと、推論のトークンを含む)」とされています。推論する(答える前に考える)モデルでは、画面に出てこない「考えるぶん」のトークンも上限に含まれます。つまり、回答のJSONが短くても、上限が小さいと切れることがあります。
拒否された回答
output_text が空になる
print(repr(例_拒否.output_text))
json.loads(例_拒否.output_text)
''
JSONDecodeError: Expecting value: line 1 column 1 (char 0)
repr() は、文字列を '…' で囲んで表示する関数で、空の文字列が '' と見えるようにしています。output_text は空なので、json.loads() は「Expecting value(値があるはずの場所に何もない)」というエラーになります。途中で切れたときとは別の文面ですが、どちらも JSONDecodeError です。 エラーの種類で分けようとすると、見分けを誤ります。
output の中の refusal を見る
print(例_拒否.status)
for item in 例_拒否.output:
    for c in item.content:
        print(c.type, "→", c.refusal)
completed
refusal → 申し訳ありませんが、その依頼にはお応えできません。
status は completed です。生成AIは「断る」という回答を最後まで書いたので、応答としては完了しています。 だから status だけでは拒否を見つけられません。output の中の項目を1つずつ見て、type が refusal の項目があれば拒否です。refusal には、断った理由の文が入っています。
2重の for は、output の中の項目(item)を1つずつ取り出し、さらにその content の中の内容(c)を1つずつ取り出す書き方です。この記事の例では項目は1つずつですが、本物の応答では複数になることがあるので、この形にしています。
OpenAIの公式ガイドは、Structured Outputs の利点の1つとして「Explicit refusals: Safety-based model refusals are now programmatically detectable(明示的な拒否:安全上の理由による拒否を、プログラムで検出できる)」を挙げています。refusal という項目が分かれているのは、そのためです。
解析の前に終了理由を見る
ここまでの確かめ方を、json.loads() の前に通す1つの関数にまとめます。
終了理由を調べる関数
def 終了理由(response):
    if response.status == "incomplete":
        return f"途中で終わった: {response.incomplete_details.reason}"
    for item in response.output:
        if item.type == "message":
            for c in item.content:
                if c.type == "refusal":
                    return f"拒否: {c.refusal}"
    if response.status != "completed":
        return f"完了していない: {response.status}"
    return "完了"
def 終了理由(response):は、この処理に名前を付けて関数にしています。引数は応答そのものです- 最初に
statusが"incomplete"かを見ます。そうなら、incomplete_details.reasonを添えて「途中で終わった」と返します。returnは、結果を返して関数を終える書き方です - 次に、
outputの中にtypeが"refusal"の内容があれば、その文を添えて「拒否」と返します statusが"completed"以外(failedなど)なら「完了していない」と返します- どれにも当てはまらなければ「完了」です。この順番が大事です。 途中で切れた応答を先に除き、次に拒否を除き、残ったものだけを完了とみなします
3つの例で確かめる
例一覧 = {"完了": 例_完了, "途中で切れた": 例_途中, "拒否": 例_拒否}

行 = []
for 名前, 応答 in 例一覧.items():
    行.append({"例": 名前, "status": 応答.status, "終了理由": 終了理由(応答)})

print(pd.DataFrame(行).to_string(index=False))
     例     status                          終了理由
    完了  completed                            完了
途中で切れた incomplete    途中で終わった: max_output_tokens
    拒否  completed 拒否: 申し訳ありませんが、その依頼にはお応えできません。
例一覧は、例の名前をキー、応答を値にした辞書です。.items()で、名前と応答を組にして順に取り出しますpd.DataFrame(行)は辞書のリストから表を作り、to_string(index=False)は行番号なしで表示します
途中で切れた応答と拒否された応答が、json.loads() を呼ぶ前に、理由付きで見分けられました。status の列を見ると、拒否は completed のままです。status だけでは足りないことが、ここでも分かります。
受け取る側の処理にまとめる
終了理由が「完了」のときだけ json.loads() を呼ぶ、受け取り側の関数です。
def 受け取る(response):
    理由 = 終了理由(response)
    if 理由 != "完了":
        return {"状態": 理由, "辞書": None}
    try:
        return {"状態": "OK", "辞書": json.loads(response.output_text)}
    except json.JSONDecodeError as e:
        return {"状態": f"読めない: {e}", "辞書": None}

for 名前, 応答 in 例一覧.items():
    結果 = 受け取る(応答)
    print(f"{名前}:{結果['状態']}")
    if 結果["辞書"] is not None:
        print("   見出し =", 結果["辞書"]["見出し"])
完了:OK
   見出し = 販売数量が多い主食
途中で切れた:途中で終わった: max_output_tokens
拒否:拒否: 申し訳ありませんが、その依頼にはお応えできません。
- 結果は
{"状態": …, "辞書": …}という辞書で返します。完了して読めたときは"状態"が"OK"で"辞書"に中身が入り、それ以外は"状態"に理由が入って"辞書"はNoneです try/exceptは、例外(実行中に起きた問題)が起きても止まらずに、決めておいた処理へ進ませる書き方です。終了理由が「完了」でも、万一json.loads()が失敗したときのために残しています。Structured Outputs を使っていれば、ここに来ることはまずありません- 最後の
forで、3つの例に当てています。結果["辞書"] is not Noneは「辞書が入っている」ことの確かめ方です
完了した応答だけが辞書になり、見出しを取り出せました。あとの2つは、なぜ受け取れなかったかが「状態」に残っています。 途中で切れたなら上限を上げて頼み直す、拒否なら人が確かめる、というように次の行動を分けられます。
出力上限の決め方
途中で切れるのを防ぐには、max_output_tokens を十分に大きくしておきます。では、いくつにすればよいのでしょうか。
普段の出力トークン数を測る
応答の usage.output_tokens に、出力に使ったトークン数が入っています。完了した例で見てみます。
print(例_完了.usage.output_tokens)
print(len(例_完了.output_text))
61
100
この例では、100文字のJSONが61トークンです(説明のために置いた値ですが、日本語のJSONではおおよそこの程度になります)。APIを呼んだ人は、「呼び出す」のセルで表示した5つの output_tokens が、実際の値です。
余裕を持たせて決める
普段の最大値をそのまま上限にすると、少し長い回答が来ただけで切れます。普段の最大値の2倍以上、最低でも200を目安にします。
普段の最大 = max(response.usage.output_tokens for response in 応答一覧)
上限 = max(普段の最大 * 2, 200)

print(普段の最大, "→ 上限", 上限)
max(… for response in 応答一覧)は、5つの応答のoutput_tokensのうち最大のものを求めますmax(普段の最大 * 2, 200)は、「2倍」と「200」の大きいほうです。この記事の回答のように短いJSONでも、200は確保します
この式は目安です。推論するモデルを使う場合は、前の章で見たとおり「考えるぶん」も上限に含まれるので、さらに大きくします。
上限を大きくしても、普段の料金は変わりません。料金は実際に使ったトークン数で決まるので、上限が余っていても、そのぶんの料金はかかりません。逆に、上限で切れた回答は使えないので、そこまでに使ったトークンの料金が無駄になります。上限は回答を切り詰めるための値ではなく、何かの事情で生成AIが止まらなくなったときに、料金が際限なく増えるのを防ぐ安全装置と考えてください。
切れたら、上限を上げて頼み直す
それでも切れたときのために、上限を2倍にして頼み直す関数を作ります。
def 上限を上げて頼み直す(r, 上限, 回数=2):
    for i in range(回数):
        response = client.responses.create(
            model=MODEL,
            instructions=ルール,
            input=json.dumps(r, ensure_ascii=False),
            text={"format": 形式},
            max_output_tokens=上限,
        )
        結果 = 受け取る(response)
        if not 結果["状態"].startswith("途中で終わった"):
            return 結果                        # 切れていなければ、そのまま返す
        print(f"{r['商品名']}:上限 {上限} で切れたので、{上限 * 2} で頼み直す")
        上限 = 上限 * 2
    return 結果

結果 = 上限を上げて頼み直す(レコード[3], 上限=30)
print(結果["状態"])
for i in range(回数):で、最大回数回まで試します。既定は2回です- 呼び出して
受け取る()に通し、"状態"が「途中で終わった」で始まっていなければ(startswith())、完了でも拒否でも、その結果をそのまま返します。頼み直すのは、途中で切れたときだけです - 途中で切れていたら、そのことを表示し、
上限 = 上限 * 2にして次の回へ進みます 回数回とも切れたら、最後の結果(途中で終わった、という状態)を返します
最後の2行は、わざと上限30から始めています。実行すると、1回目は切れて、上限60で頼み直す表示が出て、それで足りれば OK になります(60でも切れる場合は、「途中で終わった」のまま返ります)。実際に使うときは、「余裕を持たせて決める」で求めた 上限 から始めてください。頼み直しは、あくまで保険です。
Claude・Geminiではここが違う
「json.loads() の前に終了理由を見る」という考え方は、3社とも同じです。 変わるのは、終了理由が入っている場所と値の名前、出力上限の引数です。
| 項目 | OpenAI | Gemini | Claude |
|---|---|---|---|
| 入れるライブラリ | openai |
google-genai |
anthropic |
| APIキーの環境変数 | OPENAI_API_KEY |
GEMINI_API_KEY( GOOGLE_API_KEY もあると優先) |
ANTHROPIC_API_KEY |
| スキーマの指定 | text={"format": 形式} |
config= の response_json_schema=スキーマ( response_mime_type も必要) |
output_config={"format": {"type": "json_schema", "schema": スキーマ}} |
| 出力上限 | max_output_tokens= |
config= の max_output_tokens= |
max_tokens=(必須) |
| 終了理由の場所 | response.status, incomplete_details.reason, output.refusal |
response.candidates[0].finish_reason |
message.stop_reason |
| 完了 | "completed" |
FinishReason.STOP |
"end_turn" |
| 途中で切れた | "incomplete" + "max_output_tokens" |
FinishReason.MAX_TOKENS |
"max_tokens" |
| 拒否・制限 | output.refusal または reason="content_filter" |
FinishReason.SAFETY など |
"refusal" |
モデルIDは、それぞれ GEMINI_MODEL・CLAUDE_MODEL という名前の環境変数に入れておく前提で書いています。設定のしかたは、OpenAIのときと同じです。次のコードは、どちらもおにぎり(鮭)を1件だけ頼み、終了理由を見てから json.loads() する形です。
Gemini の場合
pip install google-genai で入れておきます。
import os
from google import genai
from google.genai import types

client = genai.Client()                # GEMINI_API_KEY を環境変数から読む

response = client.models.generate_content(
    model=os.environ["GEMINI_MODEL"],
    contents=json.dumps(レコード[3], ensure_ascii=False),
    config=types.GenerateContentConfig(
        system_instruction=ルール,
        response_mime_type="application/json",
        response_json_schema=スキーマ,
        max_output_tokens=400,             # 出力の上限
    ),
)

理由 = response.candidates[0].finish_reason   # 終了理由
if 理由 == types.FinishReason.MAX_TOKENS:
    print("途中で終わった")
elif 理由 == types.FinishReason.STOP:
    print(json.loads(response.text)["見出し"])
else:
    print("完了していない:", 理由)
Geminiでは、終了理由は response.candidates[0].finish_reason に入っています(candidates は回答の候補の一覧で、普通は1つです)。値は types.FinishReason の中の名前で、完了が STOP、出力上限が MAX_TOKENS、安全上の制限が SAFETY です。出力上限は GenerateContentConfig の max_output_tokens で指定します。
Claude の場合
pip install anthropic で入れておきます。
import os
from anthropic import Anthropic

client = Anthropic()                   # ANTHROPIC_API_KEY を環境変数から読む

message = client.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=400,                    # 出力の上限(Claudeでは必須)
    system=ルール,
    messages=[{"role": "user", "content": json.dumps(レコード[3], ensure_ascii=False)}],
    output_config={"format": {"type": "json_schema", "schema": スキーマ}},
)

if message.stop_reason == "max_tokens":        # 終了理由
    print("途中で終わった")
elif message.stop_reason == "refusal":
    print("拒否")
elif message.stop_reason == "end_turn":
    本文 = "".join(b.text for b in message.content if b.type == "text")
    print(json.loads(本文)["見出し"])
else:
    print("完了していない:", message.stop_reason)
Claudeでは、終了理由は message.stop_reason に入っています。完了が "end_turn"、出力上限が "max_tokens"、拒否が "refusal" です。出力上限 max_tokens は、Claudeでは必ず指定します。Claudeの公式ドキュメントも、max_tokens で切れた場合と拒否の場合は「出力がスキーマに合わないことがある」として、stop_reason を確かめるよう案内しています。
3社とも、スキーマで形が保証されるのは、最後まで書かれた回答だけです。
まとめ
今回のポイントです。
| 覚えておくこと | |
|---|---|
| 保証の範囲 | Structured Outputs が保証するのは、最後まで書かれた回答がスキーマどおりであること。途中で切れた回答と拒否は保証の外 |
| 途中で切れた | status が "incomplete"、incomplete_details.reason が "max_output_tokens"。output_text は書きかけのJSON |
| 拒否 | status は "completed" のまま。output の中に type が "refusal" の項目。output_text は空の文字列 |
| 確かめる順番 | json.loads() の前に、途中で終わった → 拒否 → 完了していない → 完了、の順に見る |
| 出力上限 | 普段の usage.output_tokens の最大値の2倍以上、最低でも200。推論するモデルではさらに大きく。切り詰めるための値ではなく、安全装置 |
| 切れたとき | 上限を2倍にして頼み直す。頼み直すのは「途中で終わった」ときだけ |