センサーの通信エラー、記録用紙の記入漏れ、レジの障害。実際の時系列データには、どうしても値の抜けた日(欠損値)が出てきます。
pandasなら ffill() や interpolate() の1行で埋められます。ところが、どの方法で埋めるかによって、できあがる値は大きく変わります。この記事では、ある店舗で集めた4種類の時系列データを使い、埋め方による違いをPythonで一歩ずつ確かめます。
結論を先に3行で書きます。
- 時系列データの欠損は、前後の時点の値が手がかりになります。なめらかに変化する気温では、前後を直線で結ぶ線形補間のずれが平均0.13℃で、直前の値で埋める前方補完(1.31℃)の10分の1でした。
interpolate()は、何も指定しないと「行」を等間隔とみなします。日付の間隔がばらばらなデータではmethod="time"を指定しないと、ずれが大きくなります(電力メーターの例で、平均236kWhのずれが4kWhに減りました)。- 正しい埋め方は、データの性質で決まります。価格のように変わった日だけ記録されるデータは前方補完、曜日の波があるデータは前週の同じ曜日で埋めます。予測に使うときは、未来の値で埋めていないかにも注意します。
この記事を読み終えると、次のことができるようになります。
- 前方補完・後方補完・線形補間の違いを、グラフで説明できる
- 日付の間隔がばらばらなデータを、
method="time"やresampleで正しく補間できる - データの性質(なめらか/階段状/曜日の波)に合わせて、埋め方を選べる
- 補完がデータリークになる場面を見抜き、補完した印(フラグ)を残せる
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。本文で出てきたときに、ここへ戻って確かめてください。
| 用語 | この記事での意味 |
|---|---|
| 時系列データ | 時間の順に並んだデータ。今回は日ごとの気温や来店客数など |
| 欠損値(NaN) | 値が抜けているところ。pandasでは NaN(Not a Number)と表示される |
| 補完 | 欠損値を、何らかの方法で推測した値で埋めること |
| 前方補完(ffill) | 欠損を、その直前の値で埋める方法。forward fill の略 |
| 後方補完(bfill) | 欠損を、その直後の値で埋める方法。backward fill の略 |
| 線形補間(interpolate) | 欠損の前後の値を直線で結び、その線の上の値で埋める方法 |
| 時間基準の補間 | 直線を引くときに、行の数ではなく日付の間隔を使う方法。interpolate(method="time") |
| 等間隔・不等間隔 | 記録の間隔がいつも同じ(毎日など)か、ばらばらか |
| 累積値 | 足し上げていった値。電力メーターの検針値のように、毎日少しずつ増えていく |
| リサンプリング(resample) | 時系列データを、毎日・毎週などの決まった間隔に並べ直すこと |
| 平均絶対誤差(MAE) | 「推測した値と正解の差」の絶対値(プラス・マイナスを取った大きさ)の平均。小さいほど正確 |
| データリーク | 本来は使えないはずの情報(未来の値など)が、分析やモデルに紛れ込むこと |
| 補完フラグ | 「この値は補完した」という印を、0 / 1 で記録した列 |
時系列データの欠損は「前後の時点」が手がかりになる
顧客名簿やアンケートのような表データでは、行の並び順に意味がありません。そのため欠損値は、その列の平均値や最頻値で埋めることがよくあります。
時系列データは違います。行は時間の順に並んでいて、隣り合う時点の値は似ていることが多いのです。昨日25℃だった気温が、今日いきなり5℃になることはまずありません。だから、欠損の直前と直後の値が、いちばん頼りになる手がかりになります。
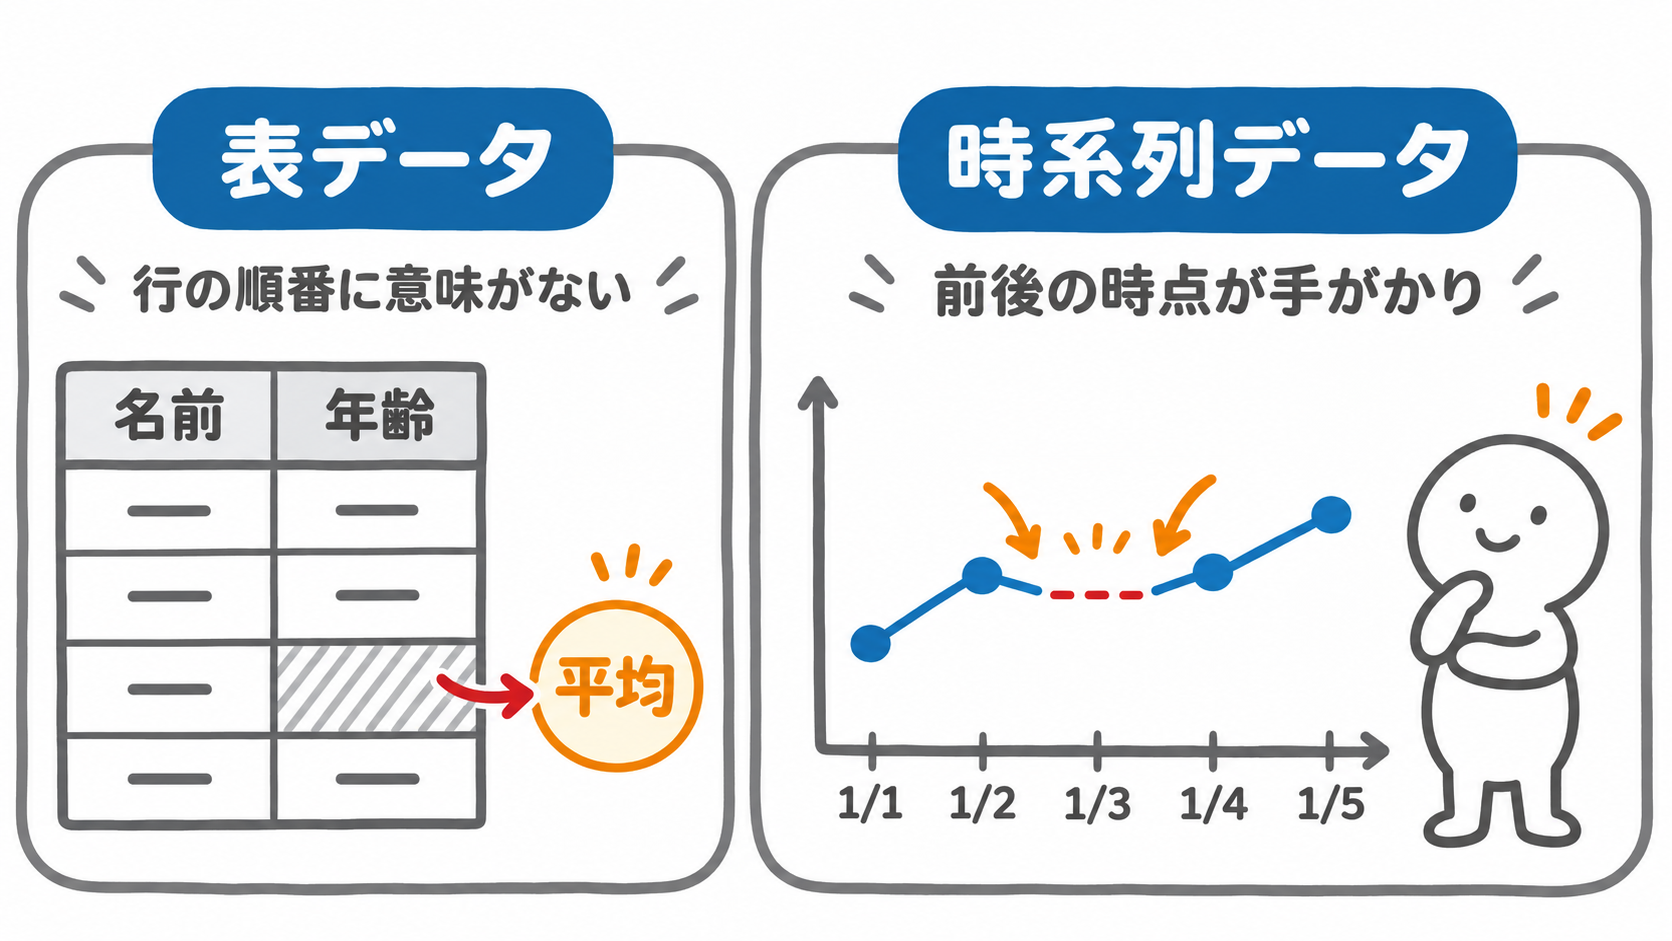
ただし、前後の値を「どう使うか」には、いくつかのやり方があります。そして、どのやり方が正しいかは、データの性質によって変わります。この記事では、それを正解の分かるデータで確かめていきます。
答えの分かる練習用データを作る
実際のデータでは、欠損した日の本当の値は誰にも分かりません。そこで、正解の値を残したまま、一部を欠損させたデータを作ります。埋めた値を正解と比べれば、どの方法がどれだけずれるかを数字で確かめられます。
場面は、ある店舗で集めている次の4つの時系列データです。
| データ | 記録のされ方 | 欠損の理由 | 値の性質 |
|---|---|---|---|
| 売場の気温 | 毎日(センサー) | 通信エラー | なめらかに変化する |
| 電力メーターの検針値 | 担当者が訪問した日だけ | 記入漏れ | 毎日少しずつ増える累積値 |
| 商品の価格 | 値段が変わった日だけ | (変わらない日は記録がない) | 階段状に変わる |
| 来店客数 | 毎日(レジ) | レジの障害 | 土日に多い7日周期の波 |
まず、売場の気温から作ります。残りの3つは、それぞれの節で作ります。
正解の気温を作る
以下、コードです。
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)  # 乱数のシードを42に固定する
dates = pd.date_range("2025-04-01", periods=60, freq="D")  # 4月1日から60日分
t = np.arange(60)                                          # 0, 1, 2, … の通し番号

# 正解の気温:ゆっくり上がる + 2週間周期の波 + 小さなゆらぎ
temp_true = pd.Series(12 + 0.15 * t + 1.5 * np.sin(2 * np.pi * t / 14)
                      + rng.normal(0, 0.3, 60), index=dates).round(1)
print(temp_true.head())
以下、実行結果です。
2025-04-01    12.1
2025-04-02    12.5
2025-04-03    13.7
2025-04-04    14.2
2025-04-05    13.5
Freq: D, dtype: float64
pd.date_range で2025年4月1日から60日分の日付を作り、それを行の名前(インデックス)にした気温の系列 temp_true を作っています。気温は「1日0.15℃ずつゆっくり上がる」「2週間周期で上下する」「小さなゆらぎ」の3つを足したものです。これが正解です。
欠損を作る
正解をコピーして、9日分を欠損値(np.nan)にします。1日だけの欠損、2日続く欠損、5日続く欠損が混ざっています。
以下、コードです。
temp = temp_true.copy()
temp.iloc[[8, 20, 26, 27, 40, 41, 42, 43, 44]] = np.nan  # 通信エラーで抜けた9日分

print("欠損の数:", temp.isna().sum())
print(temp["2025-05-09":"2025-05-17"])
以下、実行結果です。
欠損の数: 9
2025-05-09    16.0
2025-05-10    16.6
2025-05-11     NaN
2025-05-12     NaN
2025-05-13     NaN
2025-05-14     NaN
2025-05-15     NaN
2025-05-16    20.3
2025-05-17    20.6
Freq: D, dtype: float64
temp.iloc[[8, 20, …]] は「8番目、20番目、…の位置の値」を指す書き方です。出力を見ると、5月11日から15日までの5日間が NaN になっています。
グラフにします。最初の4行は、グラフに日本語を表示するための設定です(以降のグラフにも効きます)。
以下、コードです。
import matplotlib.pyplot as plt

# 日本語を表示するためのフォント(Windows・Mac・Linuxの順に探す)
plt.rcParams["font.sans-serif"] = [
    "Meiryo", "Hiragino Sans", "Noto Sans CJK JP", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False  # マイナス記号の文字化けを防ぐ

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(temp, color="#1f77b4", marker="o", markersize=3, label="記録できた気温")
ax.bar(temp.index[temp.isna()], 30, width=1, color="#d62728", alpha=0.2, label="欠損した日")
ax.set_ylim(9, 23)
ax.set_title("売場の気温(欠損した日は線が途切れる)", loc="left")
ax.set_ylabel("気温(℃)")
ax.legend(loc="upper left")
plt.show()
以下、実行結果です。
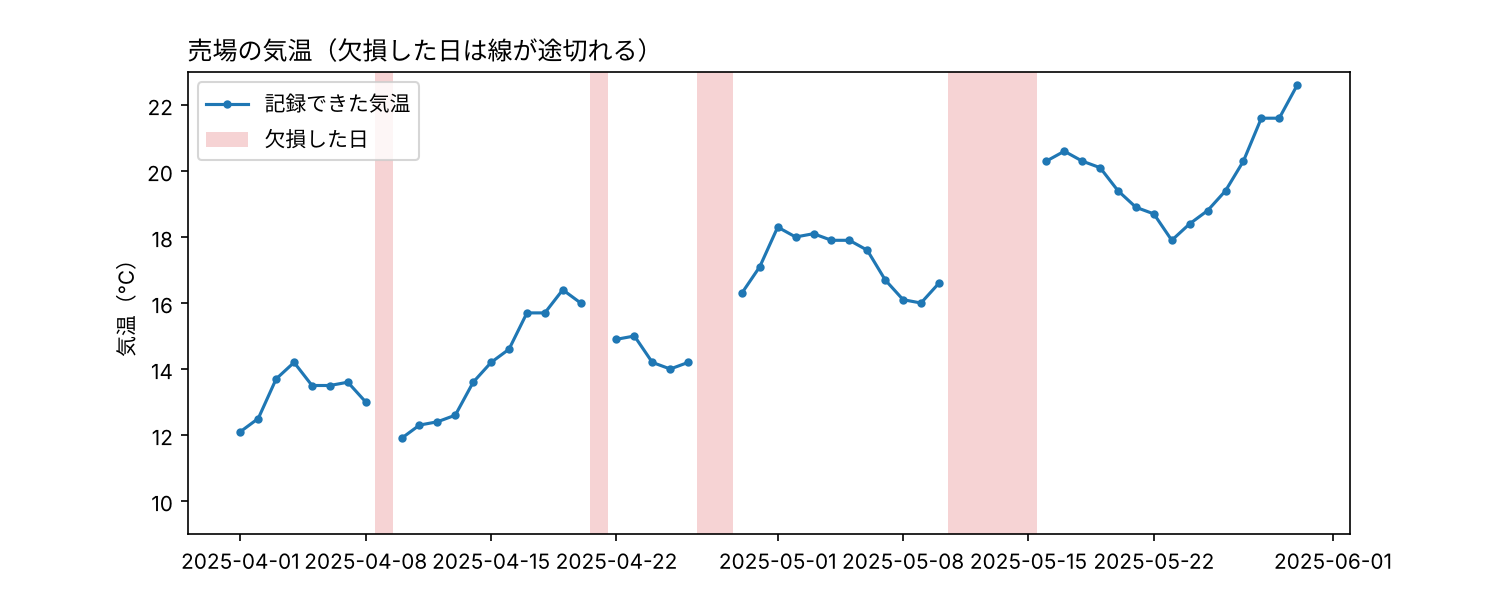
matplotlibは欠損値を描かないので、欠損した日のところで線が途切れます。この途切れを、どうつなぐかがこれからの課題です。
3つの基本の埋め方:前方補完・後方補完・線形補間
前後の値の使い方として、まず次の3つを試します。
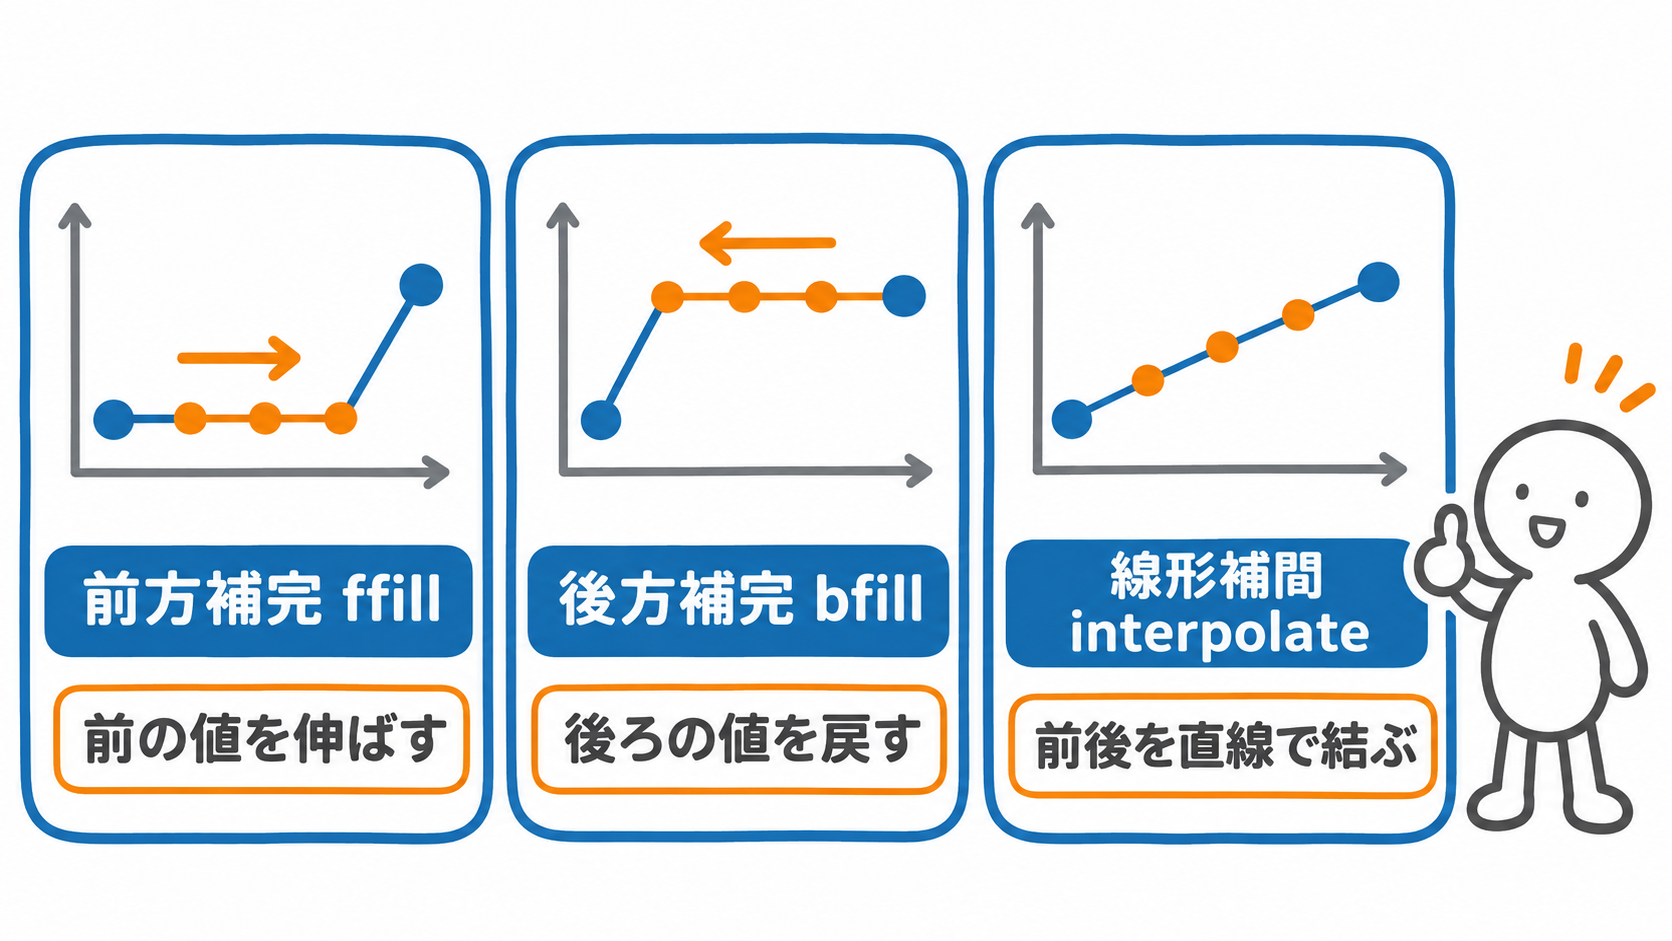
| 埋め方 | pandasの書き方 | やっていること |
|---|---|---|
| 前方補完 | ffill() |
直前の値を、そのまま後ろへ伸ばす |
| 後方補完 | bfill() |
直後の値を、そのまま前へ戻す |
| 線形補間 | interpolate() |
直前と直後の値を直線で結び、その線の上の値を使う |
3つの結果と正解を、1つの表に並べます。
以下、コードです。
filled = pd.DataFrame({
    "前方補完": temp.ffill(),        # 直前の値で埋める
    "後方補完": temp.bfill(),        # 直後の値で埋める
    "線形補間": temp.interpolate(),  # 前後の値を直線で結んで埋める
    "正解": temp_true,
})
print(filled["2025-05-10":"2025-05-16"].round(1))
以下、実行結果です。
            前方補完  後方補完  線形補間    正解
2025-05-10  16.6  16.6  16.6  16.6
2025-05-11  16.6  20.3  17.2  17.1
2025-05-12  16.6  20.3  17.8  17.7
2025-05-13  16.6  20.3  18.5  18.1
2025-05-14  16.6  20.3  19.1  19.2
2025-05-15  16.6  20.3  19.7  19.8
2025-05-16  20.3  20.3  20.3  20.3
5日続けて欠損した5月11日〜15日を見ます。前方補完は直前の10日の値16.6がずっと続き、後方補完は直後の16日の値20.3がずっと続きます。線形補間は16.6から20.3へ少しずつ上がっていき、正解(17.1、17.7、…)とほぼ重なっています。
この前後を拡大して、3つの埋め方を並べて描きます。黒い点が記録できた値、灰色の点線が正解です。
以下、コードです。
zoom = filled["2025-05-06":"2025-05-20"]  # 5日続けて欠損した前後を拡大
colors = ["#ff7f0e", "#9467bd", "#1f77b4"]

fig, axes = plt.subplots(1, 3, figsize=(12, 4), sharey=True)
for ax, col, c in zip(axes, zoom.columns[:3], colors):
    ax.plot(zoom["正解"], color="#7f7f7f", linestyle="--", label="正解")
    ax.plot(zoom[col], color=c, marker="o", markersize=4, label=col)
    ax.plot(temp["2025-05-06":"2025-05-20"], "o", color="black", markersize=4)
    ax.set_title(col, loc="left")
    ax.tick_params(axis="x", rotation=45)
axes[0].set_ylabel("気温(℃)")
axes[0].legend(loc="upper left")
plt.tight_layout()
plt.show()
以下、実行結果です。
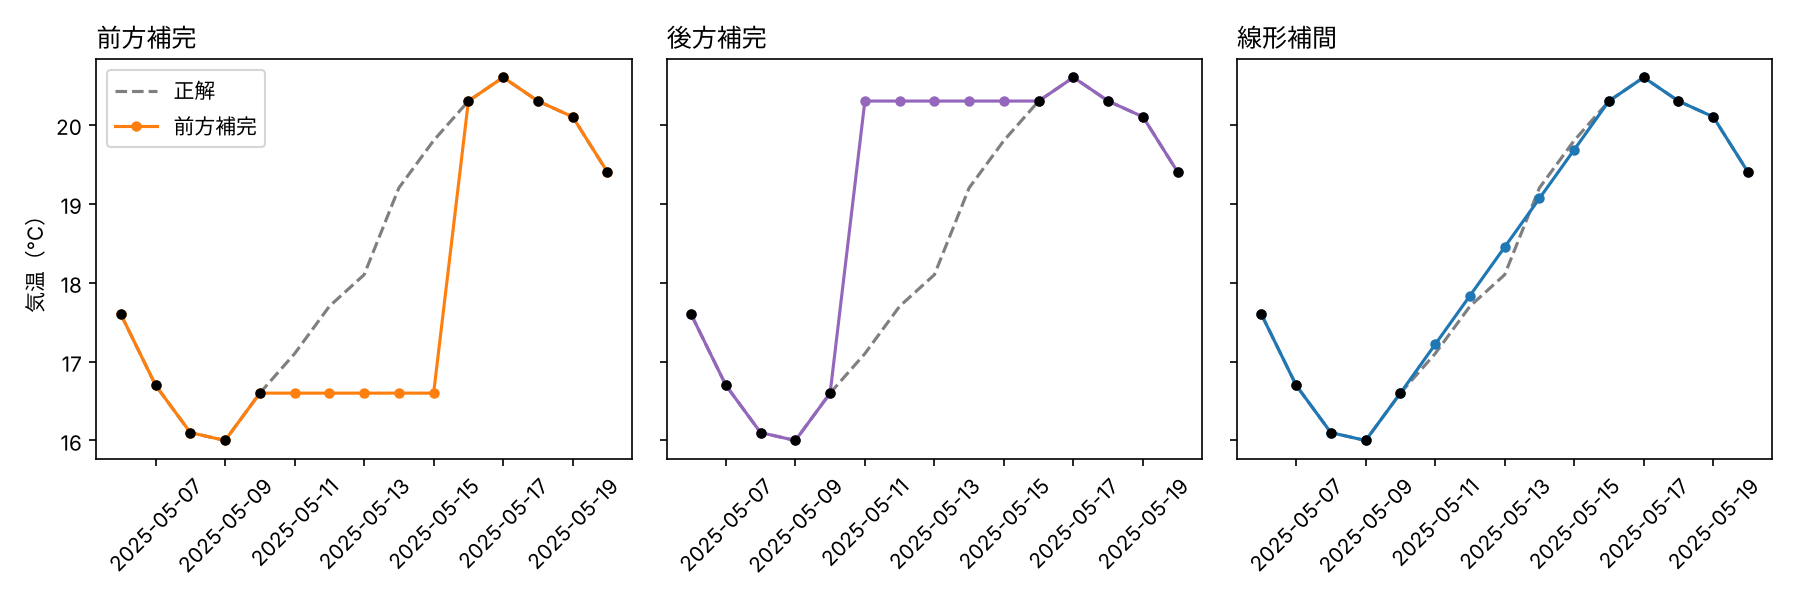
前方補完と後方補完は、欠損の間が平らな「段」になります。気温は少しずつ上がっていたので、段のままでは正解から離れてしまいます。線形補間は、前後の値を結ぶ直線が、上り坂の正解とよく合っています。
正解とのずれを数字で比べる
欠損した9日分について、埋めた値と正解の差を計算し、その大きさ(絶対値)を平均します。これが平均絶対誤差(MAE)です。
以下、コードです。
miss = temp.isna()  # 欠損だった日(True / False)

# 欠損だった日だけを取り出し、正解との差の絶対値を平均する(平均絶対誤差)
err = filled[miss].drop(columns="正解").sub(temp_true[miss], axis=0)
mae = err.abs().mean()
print(mae.round(2))
以下、実行結果です。
前方補完    1.31
後方補完    1.46
線形補間    0.13
dtype: float64
temp.isna() は、欠損なら True、そうでなければ False の系列を返します。これを使って欠損した日だけを取り出し、sub(引き算)で正解との差を求めています。
以下、コードです。
fig, ax = plt.subplots(figsize=(7, 4))
bars = ax.bar(mae.index, mae.values, color=["#ff7f0e", "#9467bd", "#1f77b4"])
ax.bar_label(bars, fmt="%.2f")
ax.set_title("欠損した9日分の、正解とのずれ(平均絶対誤差)", loc="left")
ax.set_ylabel("気温のずれ(℃)")
plt.show()
以下、実行結果です。
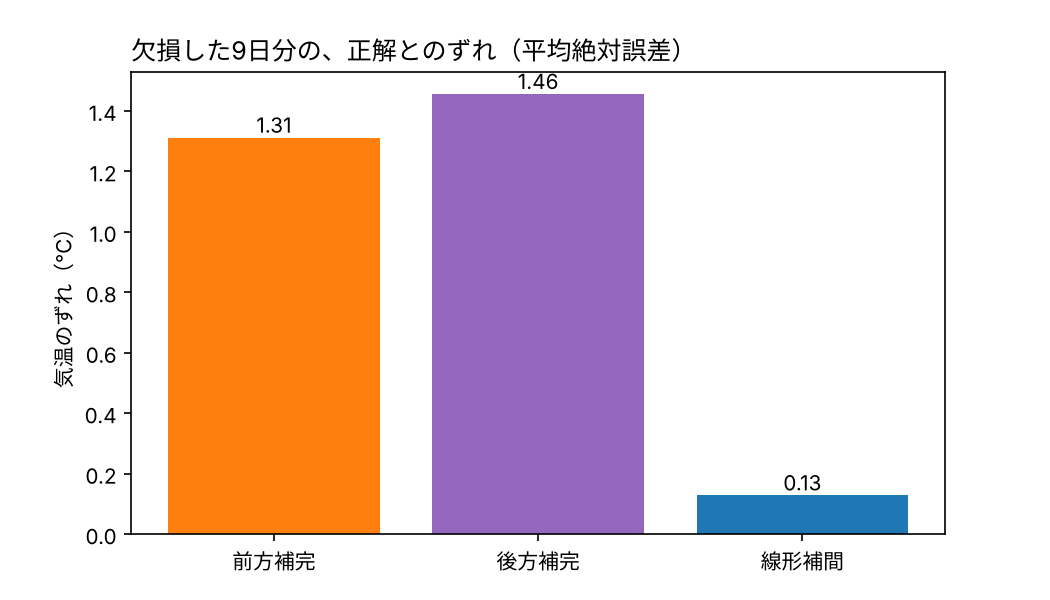
線形補間のずれは0.13℃で、前方補完(1.31℃)や後方補完(1.46℃)の約10分の1でした。気温のようになめらかに変化するデータでは、線形補間がよく当たります。
線形補間が、いつもいちばん良いわけではありません。気温が「なめらかに変化する」データだったから強かったのです。データの性質が違えば、答えも変わります。このあと、3つの違うデータで確かめます。
落とし穴:日付の間隔がばらばらだと interpolate() がずれる
次は、電力メーターの検針値です。担当者が店舗を訪問した日にだけ、メーターの数字を記録しています。訪問は毎日ではなく、続けて来る週もあれば、10日空く週もあります。そのうえ、何回か記入漏れがありました。
検針値のデータを作る
まず、毎日の正解の検針値と、担当者が訪問した日の一覧を作ります。
以下、コードです。
# 正解の検針値(累積 kWh):毎日だいたい100kWhずつ増えていく
meter_true = pd.Series(30000 + rng.normal(100, 8, 60).cumsum(), index=dates).round(0)

# 担当者が訪問した日(間隔がばらばら)
visit = pd.to_datetime([
    "2025-04-01", "2025-04-02", "2025-04-04", "2025-04-10", "2025-04-11", "2025-04-18",
    "2025-04-28", "2025-05-02", "2025-05-12", "2025-05-13", "2025-05-20", "2025-05-30"])
print("訪問した回数:", len(visit))
以下、実行結果です。
訪問した回数: 12
検針値は累積値です。1日の使用量(平均100kWh)を cumsum()(累積和)で足し上げているので、毎日少しずつ増えていきます。
次に、訪問した日だけを取り出し、記入漏れの4回を欠損にします。あわせて、前の行から何日空いているかを計算します。
以下、コードです。
meter = meter_true[visit].copy()  # 訪問した日だけの行になる
meter[pd.to_datetime(["2025-04-02", "2025-04-04", "2025-04-10", "2025-05-12"])] = np.nan  # 記入漏れ

days = meter.index.to_series().diff().dt.days  # 前の行から何日空いているか
print(pd.DataFrame({"検針値": meter, "前の行からの日数": days}))
以下、実行結果です。
                検針値  前の行からの日数
2025-04-01  30087.0       NaN
2025-04-02      NaN       1.0
2025-04-04      NaN       2.0
2025-04-10      NaN       6.0
2025-04-11  31091.0       1.0
2025-04-18  31783.0       7.0
2025-04-28  32768.0      10.0
2025-05-02  33180.0       4.0
2025-05-12      NaN      10.0
2025-05-13  34233.0       1.0
2025-05-20  34912.0       7.0
2025-05-30  35911.0      10.0
meter.index.to_series().diff() は、日付どうしの差(前の行との間隔)を計算します。.dt.days で日数に直しています。行と行の間隔は、1日、2日、6日、1日、7日、10日…と、ばらばらです。
以下、コードです。
fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(meter_true, color="#7f7f7f", linestyle="--", linewidth=1, label="正解(毎日の検針値)")
ax.plot(meter.dropna(), "o", color="#1f77b4", markersize=7, label="記録できた検針値")
ax.vlines(meter.index[meter.isna()], 29800, 36300, color="#d62728", linestyle=":",
          label="記入漏れの訪問日")
ax.set_title("電力メーターの検針値(訪問した日だけ、間隔はばらばら)", loc="left")
ax.set_ylabel("検針値(kWh)")
ax.legend(loc="upper left")
plt.show()
以下、実行結果です。
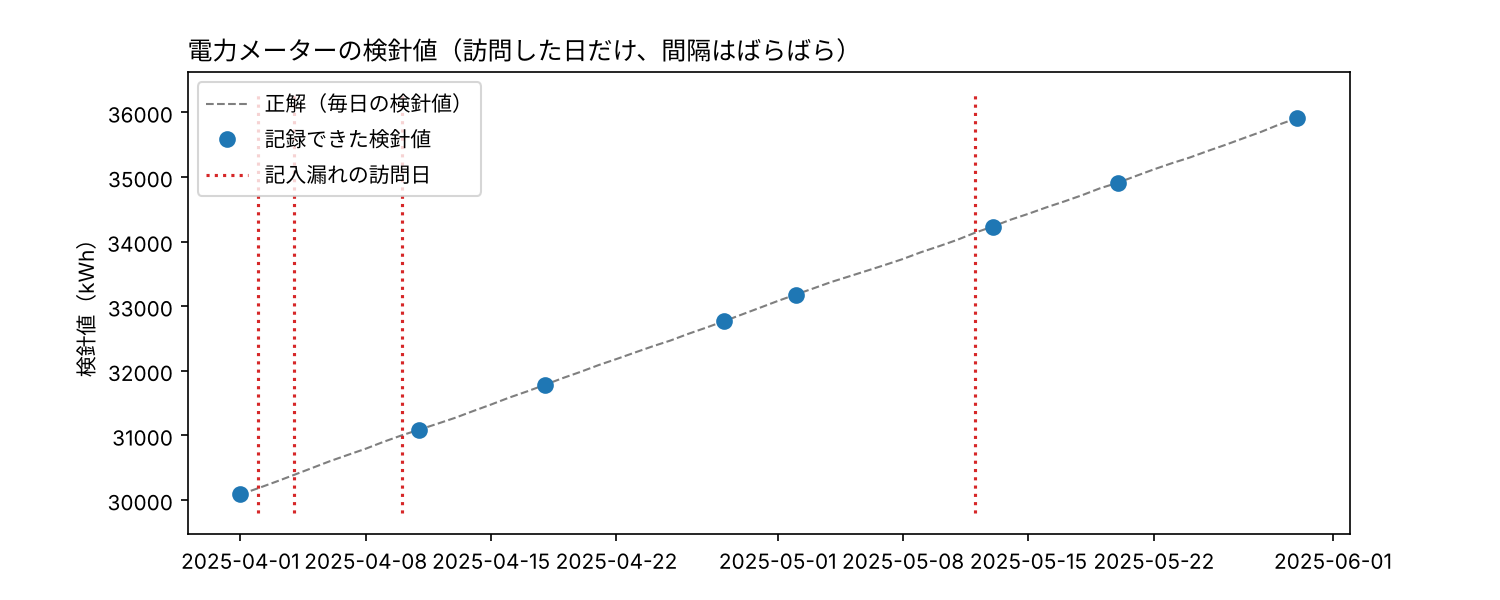
灰色の点線が毎日の正解で、ほぼ一定のペースで増えています。青い点が記録できた検針値、赤い点線が記入漏れの訪問日です。
interpolate() と method=”time” を比べる
記入漏れの4回を、2通りの線形補間で埋めます。ひとつは何も指定しない interpolate()、もうひとつは日付の間隔を使う interpolate(method="time") です。
以下、コードです。
meter_fill = pd.DataFrame({
    "interpolate()": meter.interpolate(),               # 行の間隔で直線を引く
    "method='time'": meter.interpolate(method="time"),  # 日付の間隔で直線を引く
    "正解": meter_true[visit],
})
m = meter.isna()
print(meter_fill[m].round(0))
print(meter_fill[m].iloc[:, :2].sub(meter_fill["正解"][m], axis=0).abs().mean().round(0))
以下、実行結果です。
            interpolate()  method='time'       正解
2025-04-02        30338.0        30187.0  30184.0
2025-04-04        30589.0        30388.0  30390.0
2025-04-10        30840.0        30991.0  31001.0
2025-05-12        33706.0        34137.0  34136.0
interpolate()    236.0
method='time'      4.0
dtype: float64
何も指定しない interpolate() のずれは平均236kWh、method="time" は4kWhでした。同じ「線形補間」なのに、60倍近い差です。
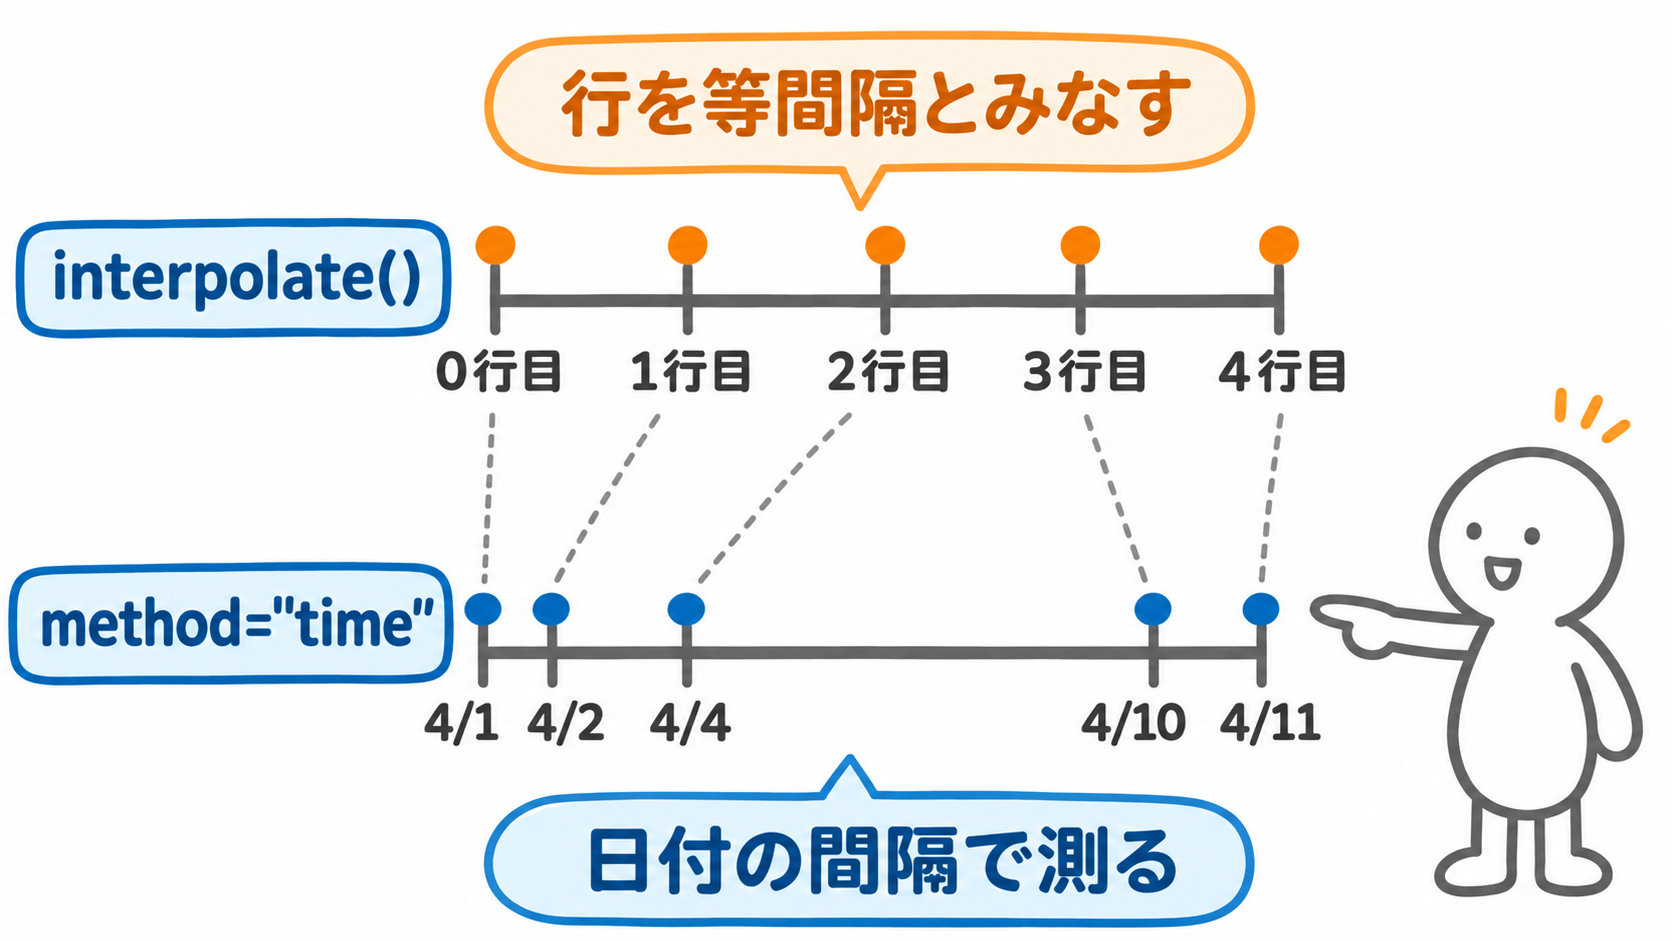
違いの原因は、直線を引くときの「横軸」です。最初の5行(4月1日〜11日)で確かめます。この間に、3つの記入漏れがあります。
interpolate() は、何も指定しないと行番号を横軸にして直線を引きます。行を等間隔とみなすので、4月1日から11日までの増加分(1004kWh)を、4つの行の間で同じ量ずつ(251kWh)に分けます。
以下、コードです。
first = meter_fill.iloc[:5]  # 4月1日〜4月11日の5行(間に3つの記入漏れ)

fig, ax = plt.subplots(figsize=(8, 4.5))
ax.plot(range(5), first["interpolate()"], color="#ff7f0e", marker="s", label="interpolate()")
ax.plot(range(5), meter.iloc[:5], "o", color="#1f77b4", markersize=9, label="記録できた値")
ax.set_xticks(range(5), [f"{i}行目" for i in range(5)])
ax.set_title("横軸=行番号:行を等間隔とみなすと一直線", loc="left")
ax.set_ylabel("検針値(kWh)")
ax.legend(loc="upper left")
plt.show()
以下、実行結果です。
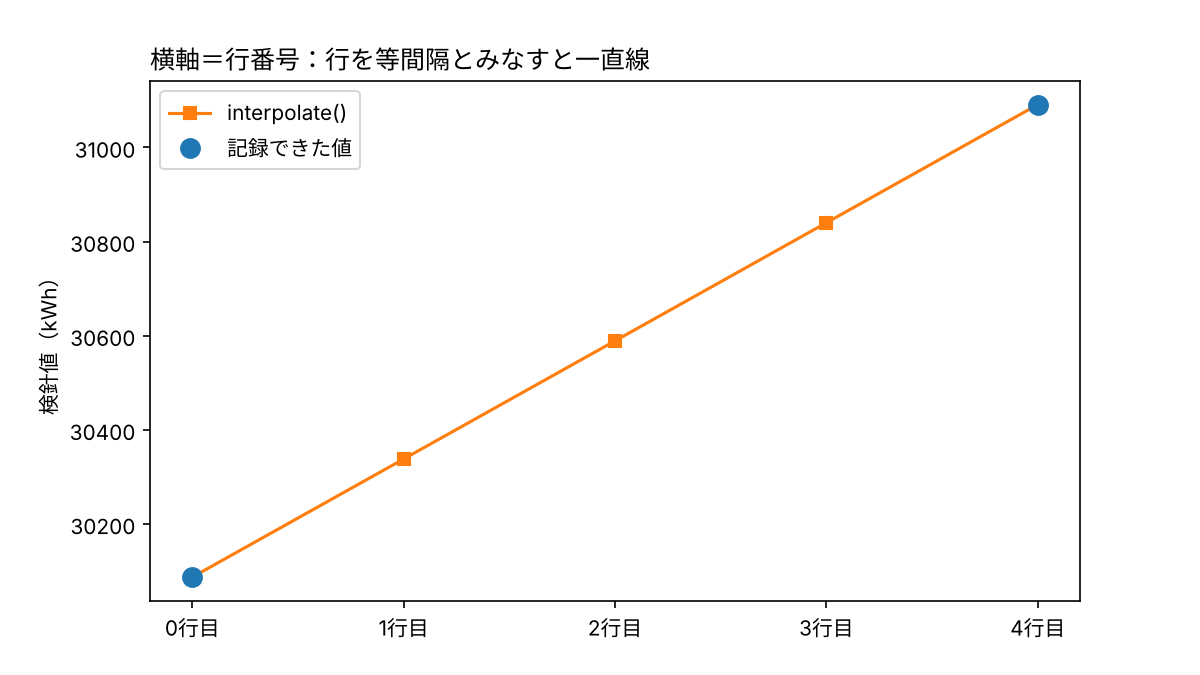
行番号を横軸にすると、きれいな一直線です。ところが実際の日付の間隔は、1日、2日、6日、1日です。同じ値を日付を横軸にして描き直します。
以下、コードです。
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.plot(meter_true[:"2025-04-11"], color="#7f7f7f", linestyle="--", label="正解")
ax.plot(first["interpolate()"], color="#ff7f0e", marker="s", label="interpolate()")
ax.plot(first["method='time'"], color="#1f77b4", marker="^", label="method='time'")
ax.set_title("横軸=日付:行基準の補間は折れ曲がる", loc="left")
ax.set_ylabel("検針値(kWh)")
ax.tick_params(axis="x", rotation=45)
ax.legend(loc="upper left")
plt.tight_layout()
plt.show()
以下、実行結果です。
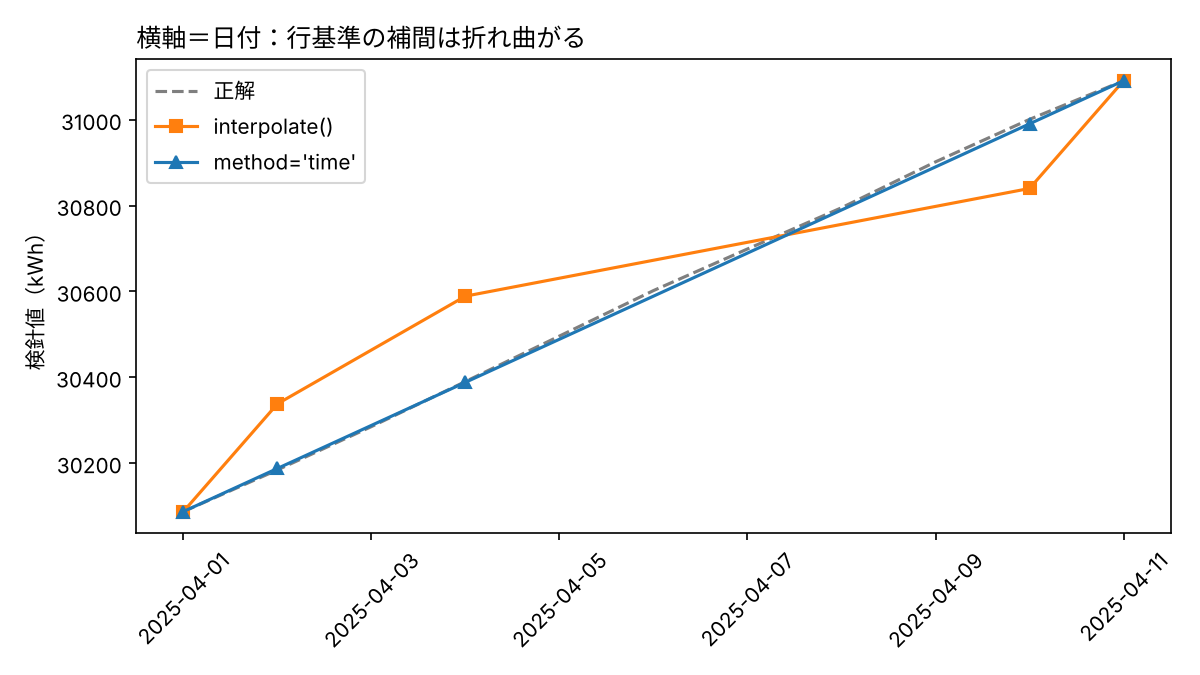
オレンジ(interpolate())は、日付で見ると折れ曲がっています。4月2日は1日しか経っていないのに251kWhも増え、4月4日から10日の6日間では251kWhしか増えていません。青(method="time")は「1日あたり100.4kWh」で日数に比例して増やすので、正解の点線とほぼ重なります。
method="time"は、インデックスが日付(DatetimeIndex)のときに使えます。method="index"と書いても、インデックスの値(ここでは日付)を横軸にするので、同じ結果になります。
毎日の行に揃えてから補間する(resample)
もうひとつの方法は、先に毎日1行ずつのデータに並べ直してから補間することです。並べ直せば行が等間隔になるので、何も指定しない interpolate() でも正しく補間できます。
以下、コードです。
daily = meter.resample("D").asfreq()  # 毎日の行を作る(訪問しなかった日も欠損になる)
daily_fill = daily.interpolate()      # 日次に揃えてから、ふつうの線形補間

print("日次にした行数:", len(daily))
print(daily_fill[m.index[m]].round(0))  # 記入漏れの4日の値
以下、実行結果です。
日次にした行数: 60
2025-04-02    30187.0
2025-04-04    30388.0
2025-04-10    30991.0
2025-05-12    34137.0
dtype: float64
resample("D") は「1日ごとに並べ直す」、asfreq() は「並べ直した日に元の値を置き、元の値がない日は欠損にする」という意味です。記入漏れの4日の値は method="time" の結果と一致しています。しかも、訪問しなかった日を含めて60日分すべての値が推定できるので、「毎日の電力使用量」の分析にもそのまま進めます。
埋め方は「データの性質」で選ぶ
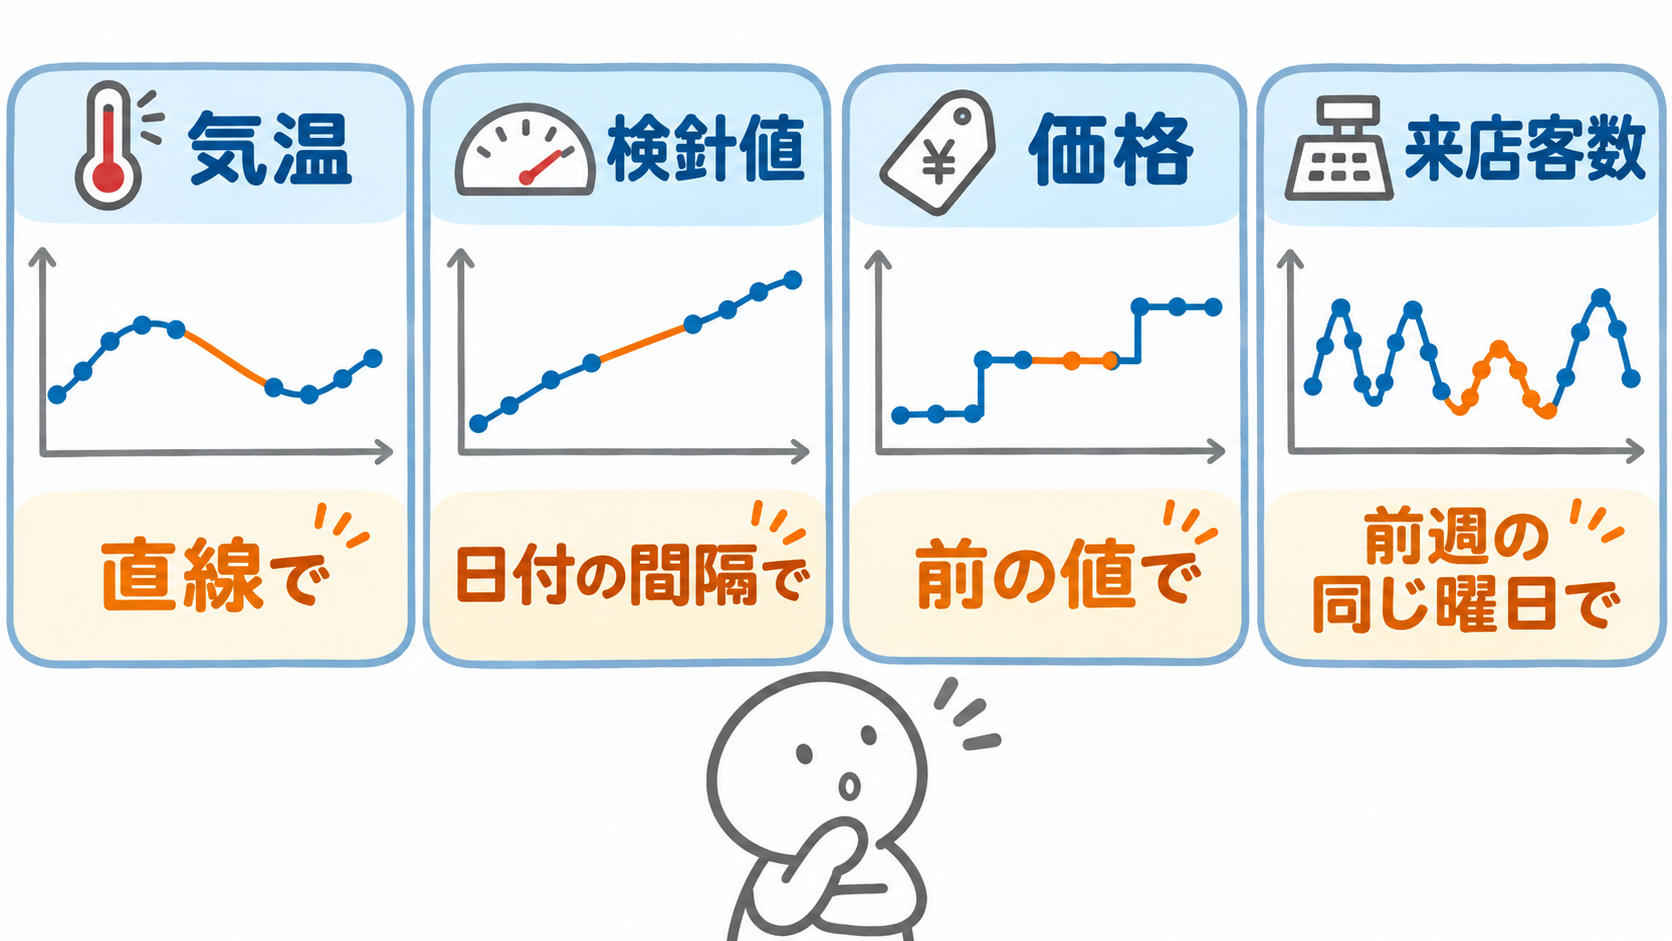
ここまでは「直線で結ぶ」線形補間が活躍しました。しかし、直線で結んではいけないデータもあります。残りの2つのデータで確かめます。
変わった日だけ記録されるデータ:価格は前方補完
商品の価格は、値上げや値下げをした日にだけ変更履歴として記録されています。4月1日に298円、4月21日に248円へ値下げ、5月12日に278円へ値上げ、という3行だけのデータです。
以下、コードです。
# 価格の変更履歴:値段が変わった日だけ記録されている
price_log = pd.Series([298, 248, 278],
                      index=pd.to_datetime(["2025-04-01", "2025-04-21", "2025-05-12"]))
price = price_log.reindex(dates)  # 60日分の行に広げる(記録のない日は欠損)

price_fill = pd.DataFrame({"前方補完": price.ffill(), "線形補間": price.interpolate()})
print(price_fill["2025-04-18":"2025-04-24"].round(1))
以下、実行結果です。
             前方補完   線形補間
2025-04-18  298.0  255.5
2025-04-19  298.0  253.0
2025-04-20  298.0  250.5
2025-04-21  248.0  248.0
2025-04-22  248.0  249.4
2025-04-23  248.0  250.9
2025-04-24  248.0  252.3
reindex(dates) は、60日分の日付の行に広げる命令です。変更履歴のない日は欠損になります。それを前方補完と線形補間で埋めて比べています。
以下、コードです。
fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(price_fill["線形補間"], color="#d62728", linestyle="--", label="線形補間(存在しない価格)")
ax.plot(price_fill["前方補完"], color="#1f77b4", drawstyle="steps-post", linewidth=2,
        label="前方補完(実際の価格)")
ax.plot(price_log, "o", color="black", markersize=8, label="変更履歴に記録された日")
ax.set_title("商品の価格:変わった日だけ記録されたデータ", loc="left")
ax.set_ylabel("価格(円)")
ax.legend(loc="upper right")
plt.show()
以下、実行結果です。
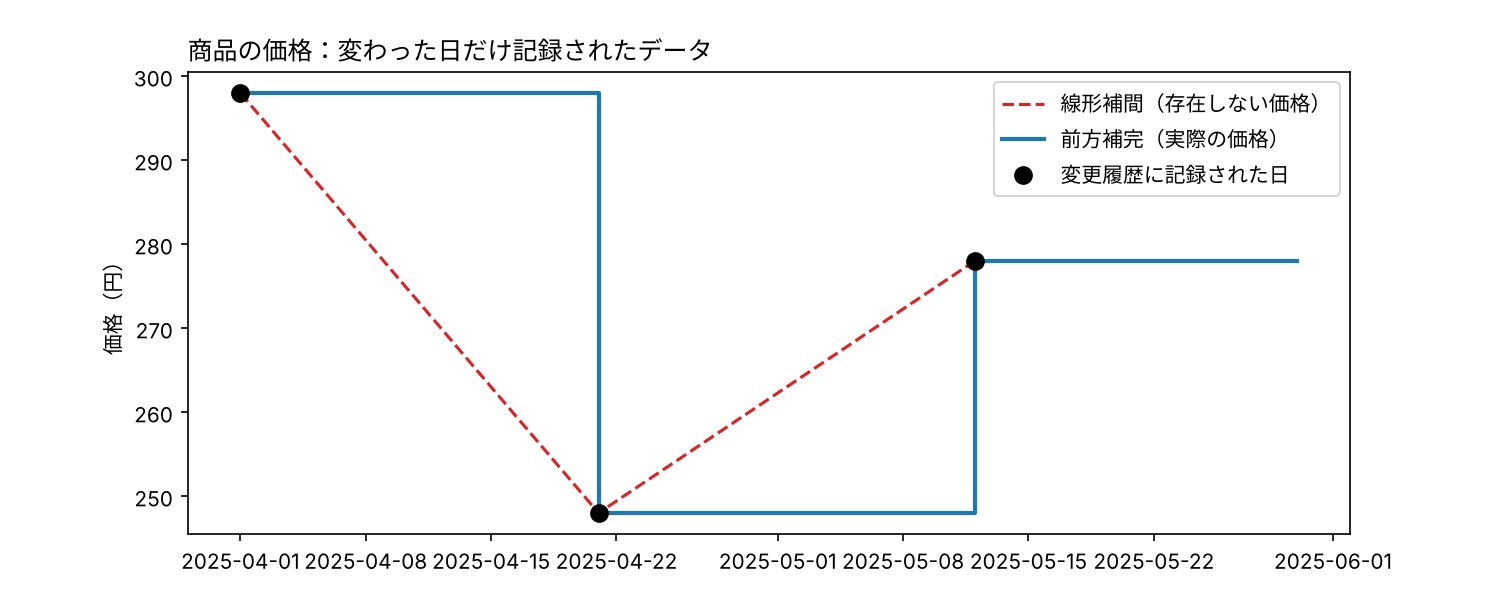
このデータの「正解」は、はっきりしています。価格は、次に変更するまで同じ値が続くからです。前方補完(青い階段)は、その性質どおりの値になっています。
線形補間(赤い点線)は、4月19日に253.0円、4月22日に249.4円のように、一度も付けたことのない価格を作ってしまいます。在庫残高や会員ランク、設定値のように「変わるまで同じ値が続く」データは、前方補完で埋めるのが基本です。
曜日の波があるデータ:前週の同じ曜日で埋める
最後は来店客数です。平日は少なく、土日に多い7日周期の波があります。レジの障害で、月曜日から日曜日までの1週間分が丸ごと消えてしまいました。
以下、コードです。
# 来店客数:平日は少なく、土日に多い(曜日の波)
weekday_effect = np.array([0, -5, -3, 0, 10, 45, 35])  # 月〜日の上乗せ
guests_true = pd.Series(150 + weekday_effect[dates.dayofweek]
                        + rng.normal(0, 6, 60), index=dates).round(0)

guests = guests_true.copy()
guests["2025-05-05":"2025-05-11"] = np.nan  # レジの障害で月曜〜日曜の1週間分が消えた
print("欠損の数:", guests.isna().sum())
以下、実行結果です。
欠損の数: 7
weekday_effect[dates.dayofweek] は、各日の曜日(月曜=0〜日曜=6)に応じた上乗せ分を取り出す書き方です。土曜は+45人、日曜は+35人です。
以下、コードです。
fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(guests, color="#1f77b4", marker="o", markersize=3, label="記録できた来店客数")
ax.axvspan(pd.Timestamp("2025-05-04 12:00"), pd.Timestamp("2025-05-11 12:00"),
           color="#d62728", alpha=0.15, label="欠損した1週間")
ax.set_title("来店客数:土日に山がくる7日周期の波", loc="left")
ax.set_ylabel("来店客数(人)")
ax.legend(loc="upper right")
plt.show()
以下、実行結果です。
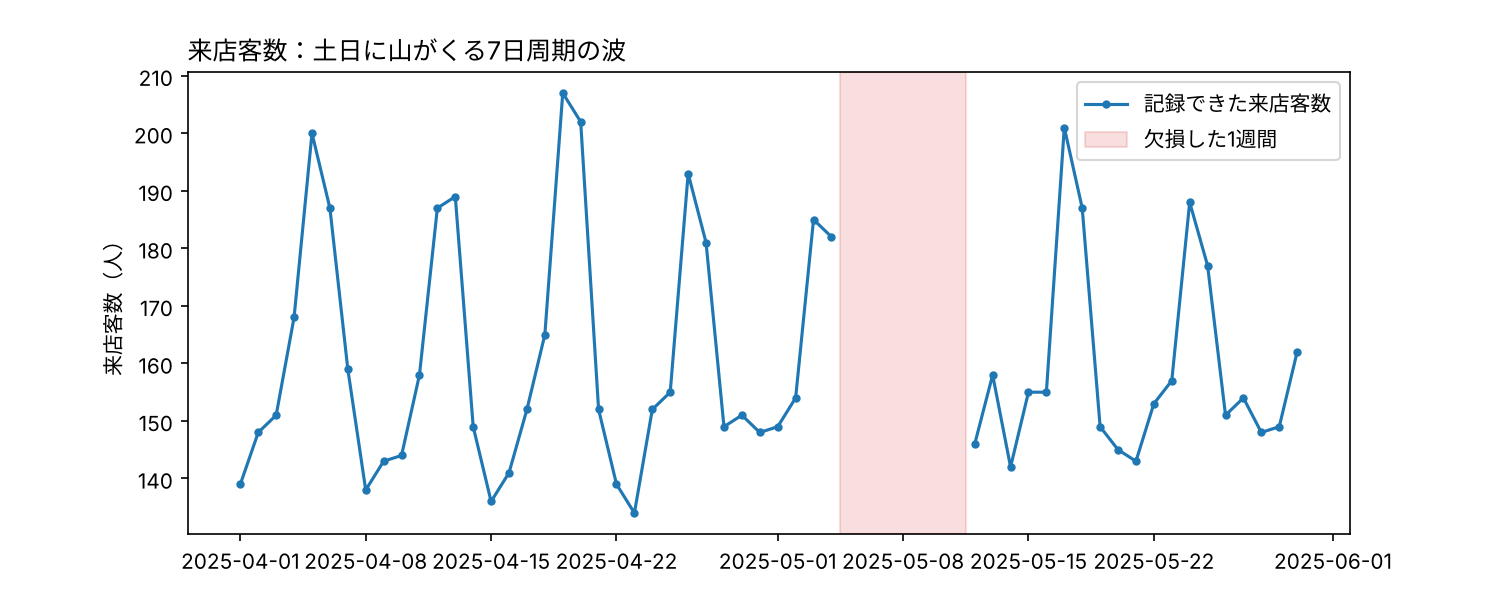
土日に山がくる波が、毎週繰り返されています。赤い帯の1週間が欠損です。
これを線形補間と、7日前(前週の同じ曜日)の値で埋める方法で比べます。
以下、コードです。
guests_fill = pd.DataFrame({
    "線形補間": guests.interpolate(),
    "前週の同じ曜日": guests.fillna(guests.shift(7)),  # 7日前の値で埋める
    "正解": guests_true,
})
g = guests.isna()
print(guests_fill[g])
print(guests_fill[g].iloc[:, :2].sub(guests_true[g], axis=0).abs().mean().round(1))
以下、実行結果です。
             線形補間  前週の同じ曜日     正解
2025-05-05  177.5    149.0  150.0
2025-05-06  173.0    151.0  156.0
2025-05-07  168.5    148.0  148.0
2025-05-08  164.0    149.0  156.0
2025-05-09  159.5    154.0  157.0
2025-05-10  155.0    185.0  188.0
2025-05-11  150.5    182.0  179.0
線形補間       19.6
前週の同じ曜日     3.1
dtype: float64
guests.shift(7) は、各行に7日前の値を持ってくる操作です。fillna(guests.shift(7)) で、欠損した日だけを7日前の値で埋めています。ずれは、線形補間が平均19.6人、前週の同じ曜日が3.1人でした。
以下、コードです。
zoom = guests_fill["2025-04-28":"2025-05-18"]

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(zoom["正解"], color="#7f7f7f", linestyle="--", label="正解")
ax.plot(zoom["線形補間"], color="#d62728", marker="s", markersize=4, label="線形補間")
ax.plot(zoom["前週の同じ曜日"], color="#1f77b4", marker="o", markersize=4, label="前週の同じ曜日")
ax.axvspan(pd.Timestamp("2025-05-04 12:00"), pd.Timestamp("2025-05-11 12:00"),
           color="#d62728", alpha=0.1)
ax.set_title("線形補間は曜日の波を消してしまう", loc="left")
ax.tick_params(axis="x", rotation=45)
ax.set_ylabel("来店客数(人)")
ax.legend(loc="upper left")
plt.tight_layout()
plt.show()
以下、実行結果です。
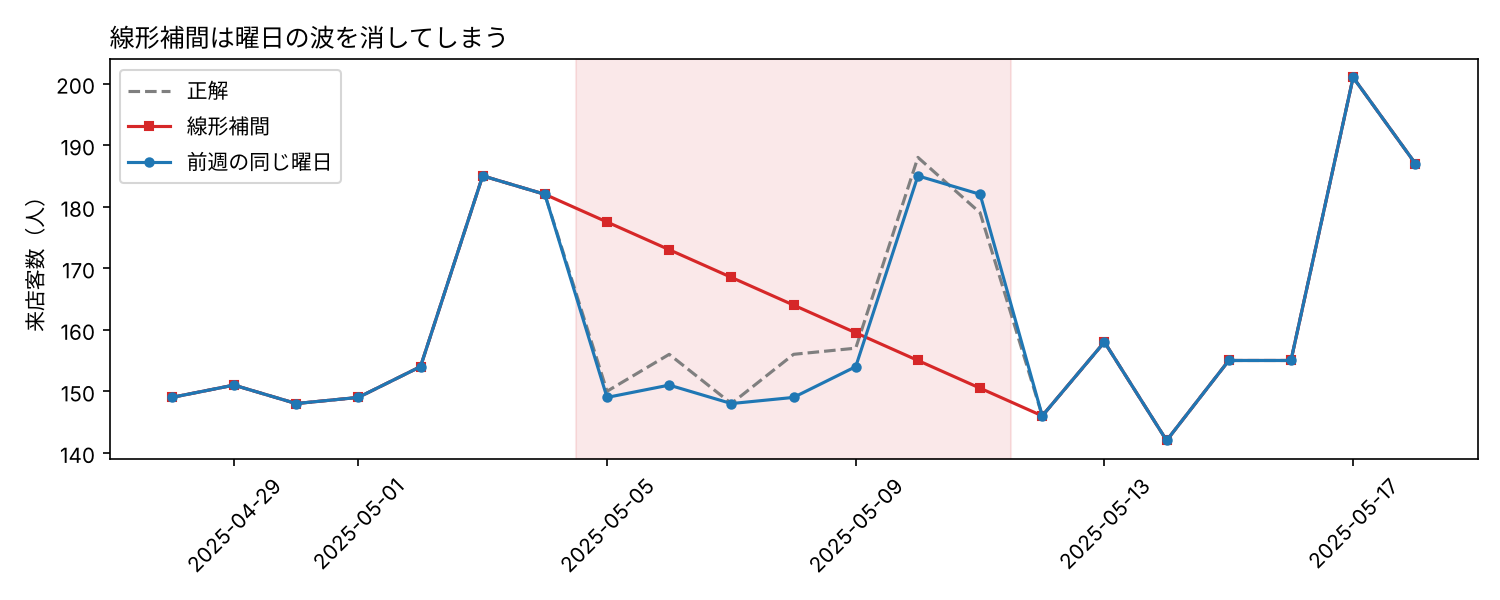
線形補間(赤)は、欠損前の日曜(182人)と欠損後の月曜(146人)を直線で結ぶだけなので、土日の山が消えてしまいます。前週の同じ曜日(青)は、土日の山まで再現できています。欠損が長いほど、線形補間は周期の波を見落とします。
埋める前に、その欠損が何を意味するかを確かめてください。たとえば販売数のデータで、売れなかった日は記録が残らない仕組みなら、欠損の正解は「0」です。そのときは
fillna(0)で埋めます。補間すると、売れていない日に売上を作ってしまいます。
データの性質と埋め方の対応
ここまでの結果をまとめます。
| データの性質 | 例 | 向いている埋め方 | pandasの書き方 |
|---|---|---|---|
| なめらかに変化する(等間隔) | 気温、センサーの値 | 線形補間 | interpolate() |
| なめらかに変化する(間隔がばらばら) | 検針値、不定期の測定 | 時間基準の補間 | interpolate(method="time") |
| 変わるまで同じ値が続く | 価格、在庫残高、設定値 | 前方補完 | ffill() |
| 曜日などの周期がある | 来店客数、日次の売上 | 前の周期の同じ時点 | fillna(s.shift(7)) |
| 記録がない=ゼロ | 売れなかった日の販売数 | 0で埋める | fillna(0) |
予測に使うときの注意:未来の値で埋めていないか
線形補間や後方補完には、気をつけたい性質があります。欠損よりあとの日(未来)の値を使って埋めていることです。
確かめてみます。気温のデータで、5日続いた欠損のあとの日(5月16日)の値だけを5℃上げ、補完した値が変わるかを見ます。
以下、コードです。
temp_future = temp.copy()
temp_future["2025-05-16"] += 5  # 欠損のあとの日(未来)の値だけを5℃上げてみる

leak = pd.DataFrame({
    "線形補間(元)": temp.interpolate(),
    "線形補間(16日を変更)": temp_future.interpolate(),
    "前方補完(元)": temp.ffill(),
    "前方補完(16日を変更)": temp_future.ffill(),
})
print(leak["2025-05-11":"2025-05-15"].round(1))
以下、実行結果です。
            線形補間(元)  線形補間(16日を変更)  前方補完(元)  前方補完(16日を変更)
2025-05-11     17.2          18.0     16.6          16.6
2025-05-12     17.8          19.5     16.6          16.6
2025-05-13     18.5          21.0     16.6          16.6
2025-05-14     19.1          22.4     16.6          16.6
2025-05-15     19.7          23.8     16.6          16.6
以下、コードです。
zoom = leak["2025-05-08":"2025-05-17"]

fig, axes = plt.subplots(1, 2, figsize=(12, 4), sharey=True)
for ax, name in zip(axes, ["線形補間", "前方補完"]):
    ax.plot(zoom[f"{name}(元)"], color="#1f77b4", marker="o", label="元のデータ")
    ax.plot(zoom[f"{name}(16日を変更)"], color="#d62728", marker="s", linestyle="--",
            label="5月16日だけ +5℃")
    ax.set_title(f"{name}:未来の値を変えると?", loc="left")
    ax.tick_params(axis="x", rotation=45)
    ax.legend(loc="upper left")
axes[0].set_ylabel("気温(℃)")
plt.tight_layout()
plt.show()
以下、実行結果です。
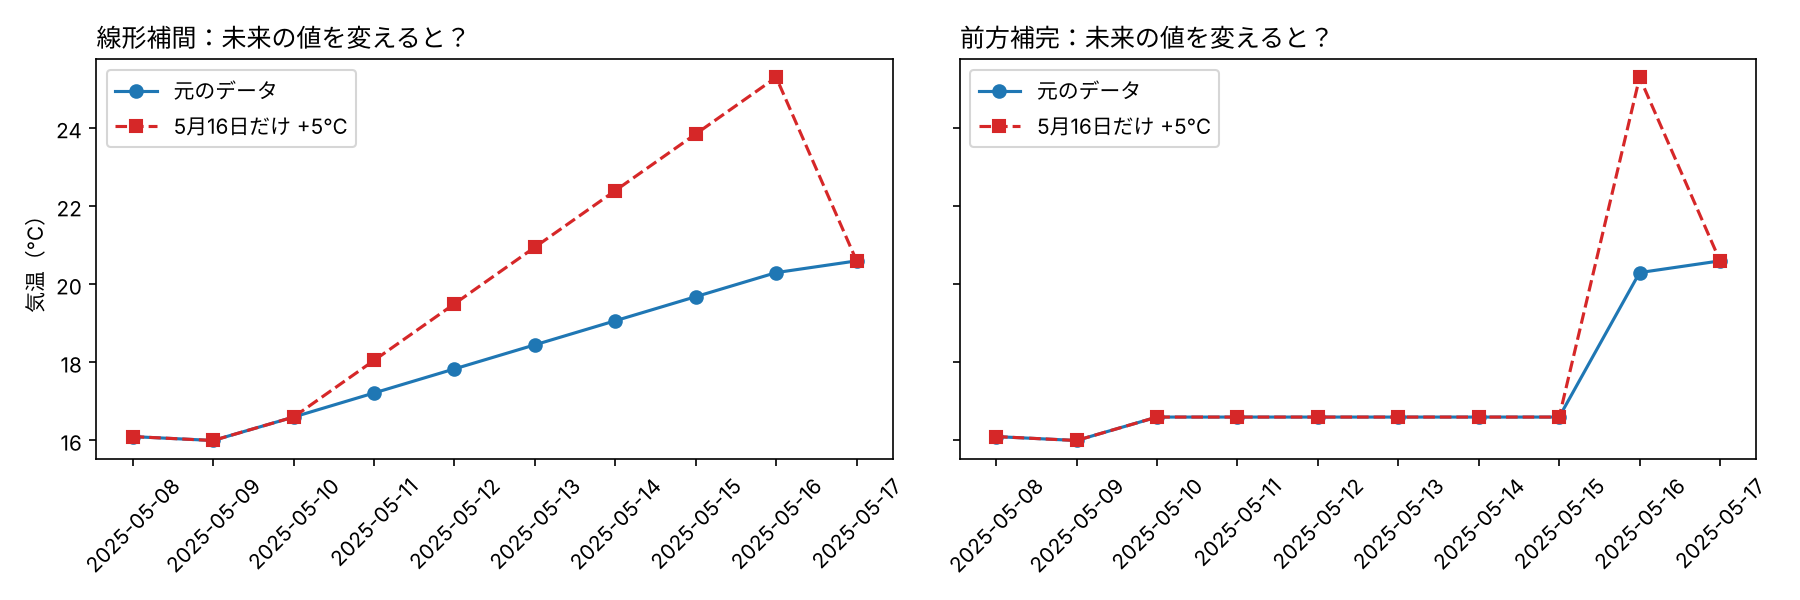
線形補間では、5月16日の値を変えただけで、5月11日〜15日の補完値がすべて変わりました(15日は19.7℃から23.8℃へ)。前方補完は、16日の値を変えても補完値は16.6℃のままです。
過去のデータを振り返って分析するだけなら、これは問題になりません。しかし予測モデルを作るときは別です。5月12日の時点で予測をする場合、5月16日の気温はまだ分かりません。それなのに、全期間を線形補間したデータで学習・検証すると、モデルは知り得ないはずの未来の値を見てしまいます。これがデータリークで、検証の精度が実際より良く見える原因になります。
予測に使うときは、次のように対応します。
- 予測に使う特徴量の補完には、過去の値だけを使う前方補完を使う
- 学習データと検証データに分けてから、それぞれの中だけで補完する
- 予測ではなく過去の振り返り分析なら、線形補間を使ってよい
補完した日には印(フラグ)を残す
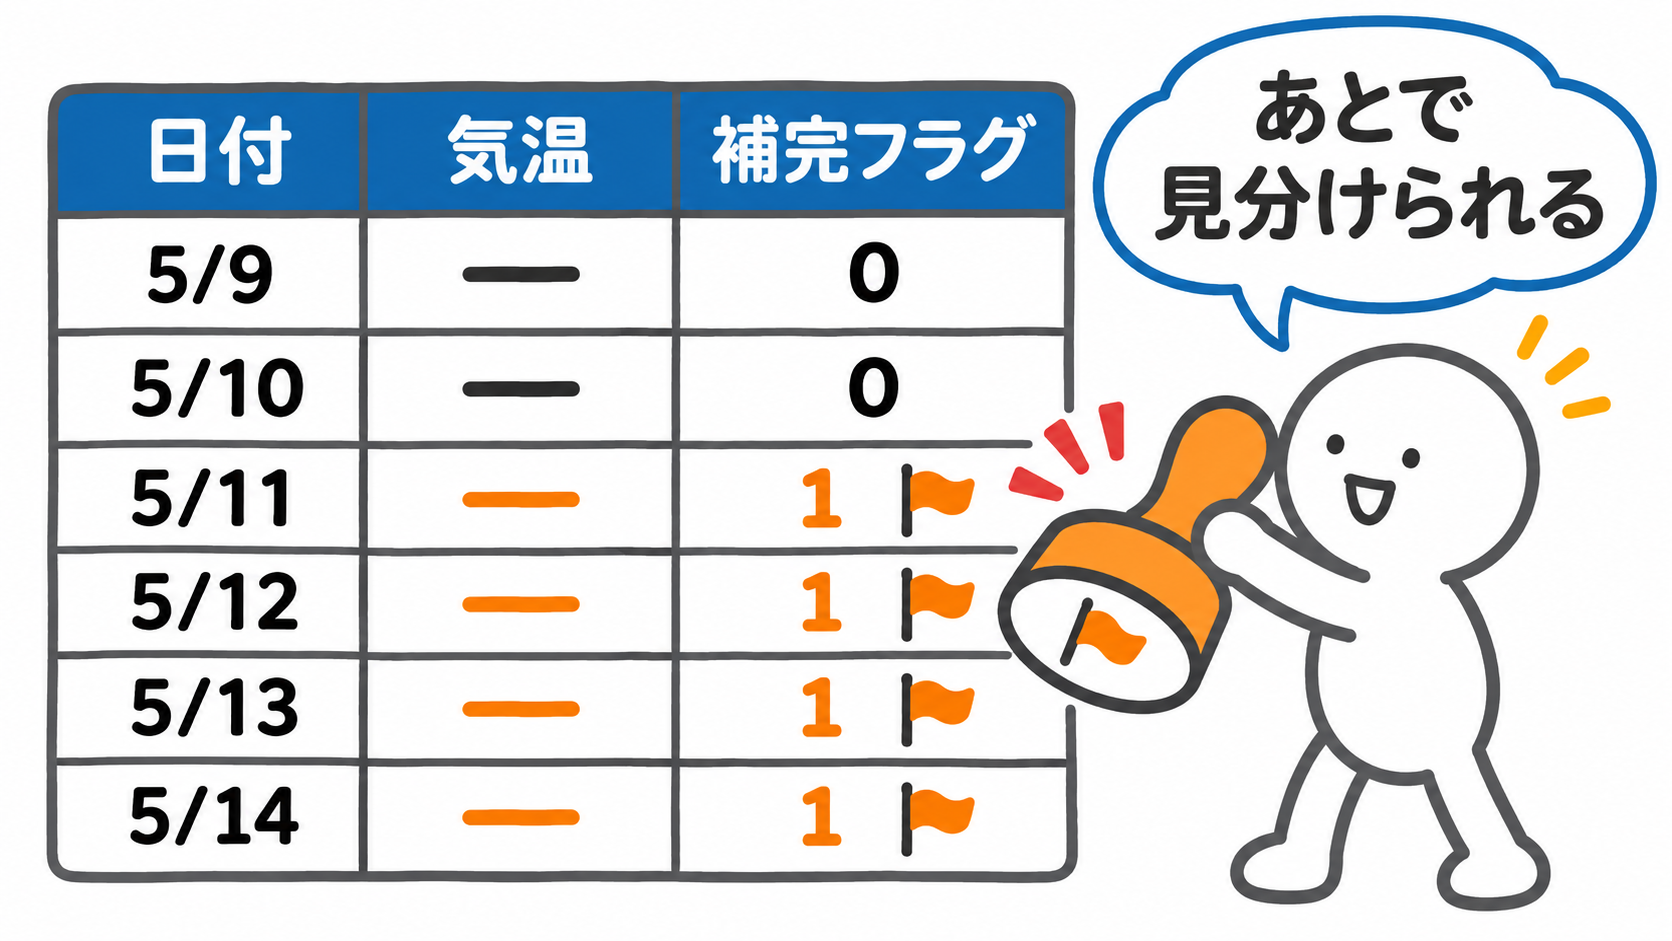
補完した値は、どんなにうまく埋めても「推測した値」です。あとから見分けられるように、埋める前に「この日は欠損だった」という印を列として残しておきます。
以下、コードです。
result = pd.DataFrame({"気温": temp})
result["補完フラグ"] = result["気温"].isna().astype(int)  # 埋める前に印を付けておく
result["気温_補完後"] = result["気温"].interpolate()

print(result["2025-05-09":"2025-05-17"].round(1))
print("補完した日数:", result["補完フラグ"].sum())
以下、実行結果です。
              気温  補完フラグ  気温_補完後
2025-05-09  16.0      0    16.0
2025-05-10  16.6      0    16.6
2025-05-11   NaN      1    17.2
2025-05-12   NaN      1    17.8
2025-05-13   NaN      1    18.5
2025-05-14   NaN      1    19.1
2025-05-15   NaN      1    19.7
2025-05-16  20.3      0    20.3
2025-05-17  20.6      0    20.6
補完した日数: 9
isna().astype(int) で、欠損なら1、そうでなければ0の列を作っています。補完したあとの値は別の列に入れるので、元の値も残ります。
以下、コードです。
f = result["補完フラグ"] == 1

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(result["気温_補完後"], color="#1f77b4", linewidth=1)
ax.plot(result["気温_補完後"][~f], "o", color="#1f77b4", markersize=4, label="記録された値")
ax.plot(result["気温_補完後"][f], "o", markerfacecolor="white", markeredgecolor="#ff7f0e",
        markeredgewidth=2, markersize=7, label="補完した値(フラグ=1)")
ax.set_title("補完フラグを使えば、埋めた値をいつでも見分けられる", loc="left")
ax.set_ylabel("気温(℃)")
ax.legend(loc="upper left")
plt.show()
以下、実行結果です。
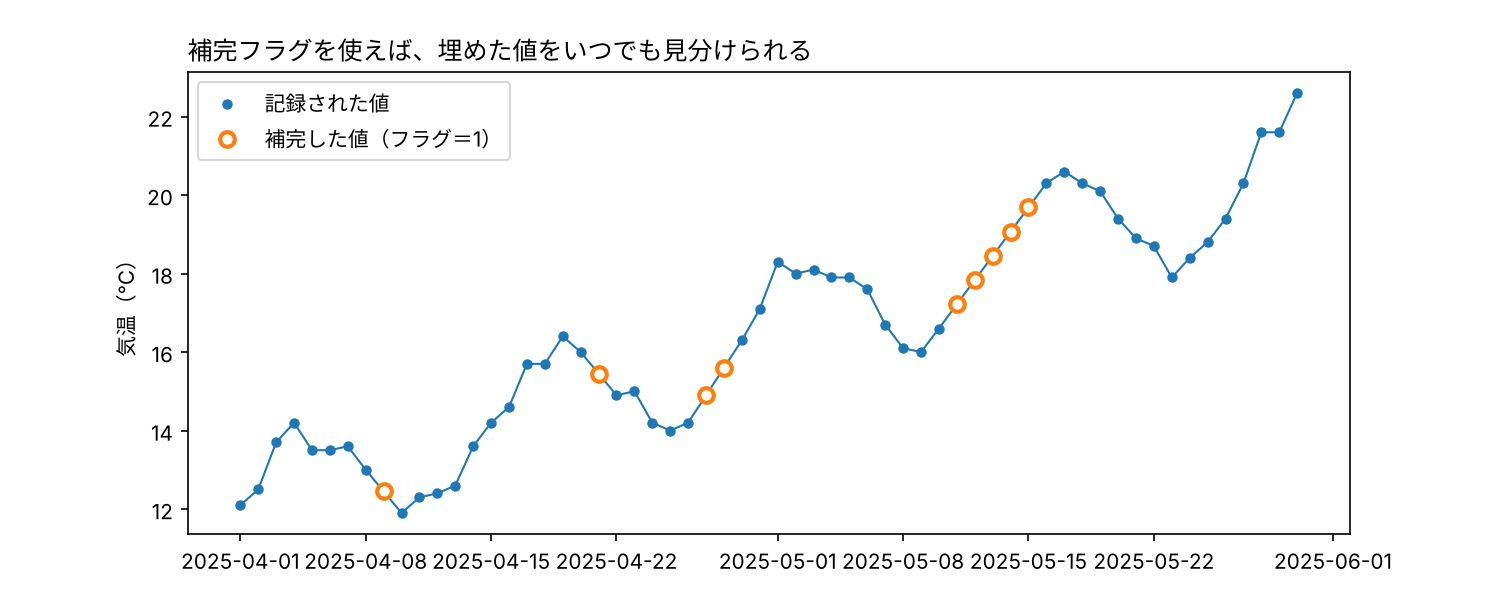
オレンジの白抜きの点が、補完した9日分です。補完フラグがあれば、「補完した日を除いて集計し直す」「補完した日をモデルの特徴量として使う」「欠損が多い時期を調べる」といったことが、いつでもできます。
実務で使うときの注意点
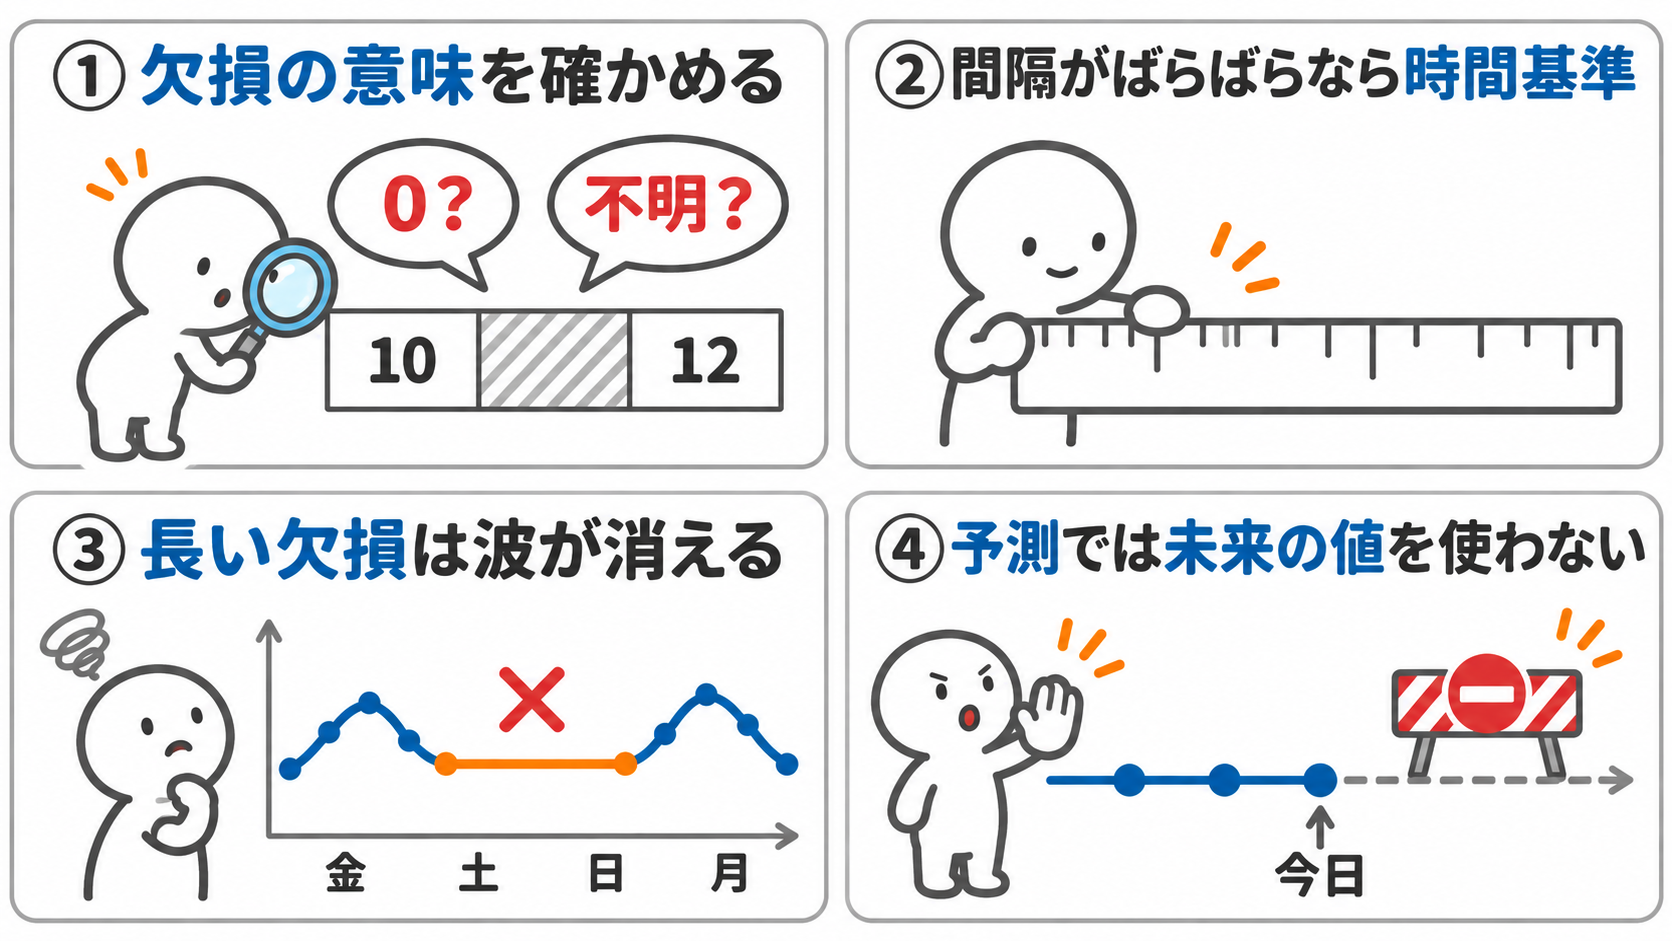
① 欠損の意味を確かめる
記録が失われた欠損なのか、「何もなかった(0)」ことを表す欠損なのかで、正しい埋め方はまったく違います。データを作った仕組みを確かめてから埋めましょう。
② 間隔がばらばらなら時間基準で
interpolate() は何も指定しないと行を等間隔とみなします。記録の間隔が不揃いなデータでは、method="time" を使うか、resample で等間隔に並べ直してから補間します。
③ 長い欠損は、周期の波が消える
直線や同じ値で長い区間を埋めると、曜日の波や季節の山が消えてしまいます。周期のあるデータは、前の周期の同じ時点で埋めることを検討します。
④ 予測では未来の値を使わない
線形補間と後方補完は、欠損よりあとの値を使います。予測モデルの学習・検証では、前方補完を使うか、データを分けてから補完します。
よくある質問
Q. データの先頭や末尾にある欠損は、どう埋まりますか?
interpolate() は、先頭の欠損は埋めずに残し、末尾の欠損は最後の値で埋めます(直前の値が続く形になります)。
前後を値に挟まれた欠損だけを埋めたいときは、interpolate(limit_area="inside") と書きます。
Q. 長い欠損は、埋めないほうがよいのでは?
そういう場面もあります。
interpolate(limit=3) のように書くと埋める個数に上限を付けられますが、これは「4日以上続く欠損は埋めない」ではなく、「続いている欠損の先頭から3個までを埋める」という意味です。
5日続く欠損なら、最初の3日だけが埋まり、残りの2日は欠損のまま残ります。
Q. 曲線でなめらかにつなぐ、スプライン補間は使わないのですか?
interpolate(method="spline", order=3) のように書けば使えます(SciPyが必要です)。
なめらかに変化するデータでは候補になりますが、前後の観測値が少ないと計算できず、曲線が行き過ぎて実際にはありえない値になることもあります。
まずは線形補間から試し、正解の分かるデータで比べてから選ぶのが安全です。
まとめ
今回のポイントです。
- 時系列データの欠損は、前後の時点の値が手がかりになる。基本の埋め方は前方補完(
ffill)、後方補完(bfill)、線形補間(interpolate)の3つ - なめらかに変化する気温では、線形補間のずれが0.13℃で、前方補完(1.31℃)の約10分の1だった
interpolate()は何も指定しないと行を等間隔とみなす。日付の間隔がばらばらな検針値では、ずれが236kWh。method="time"やresampleで4kWhに減った- 価格のように変わった日だけ記録されるデータは前方補完。線形補間は、付けたことのない価格を作る
- 曜日の波がある来店客数を1週間分埋めるなら、前週の同じ曜日(ずれ3.1人)。線形補間(19.6人)は土日の山を消す
- 線形補間は未来の値を使う。予測モデルでは前方補完を使うか、データを分けてから補完する。補完した日にはフラグを残す
発展:もっと賢く埋める方法
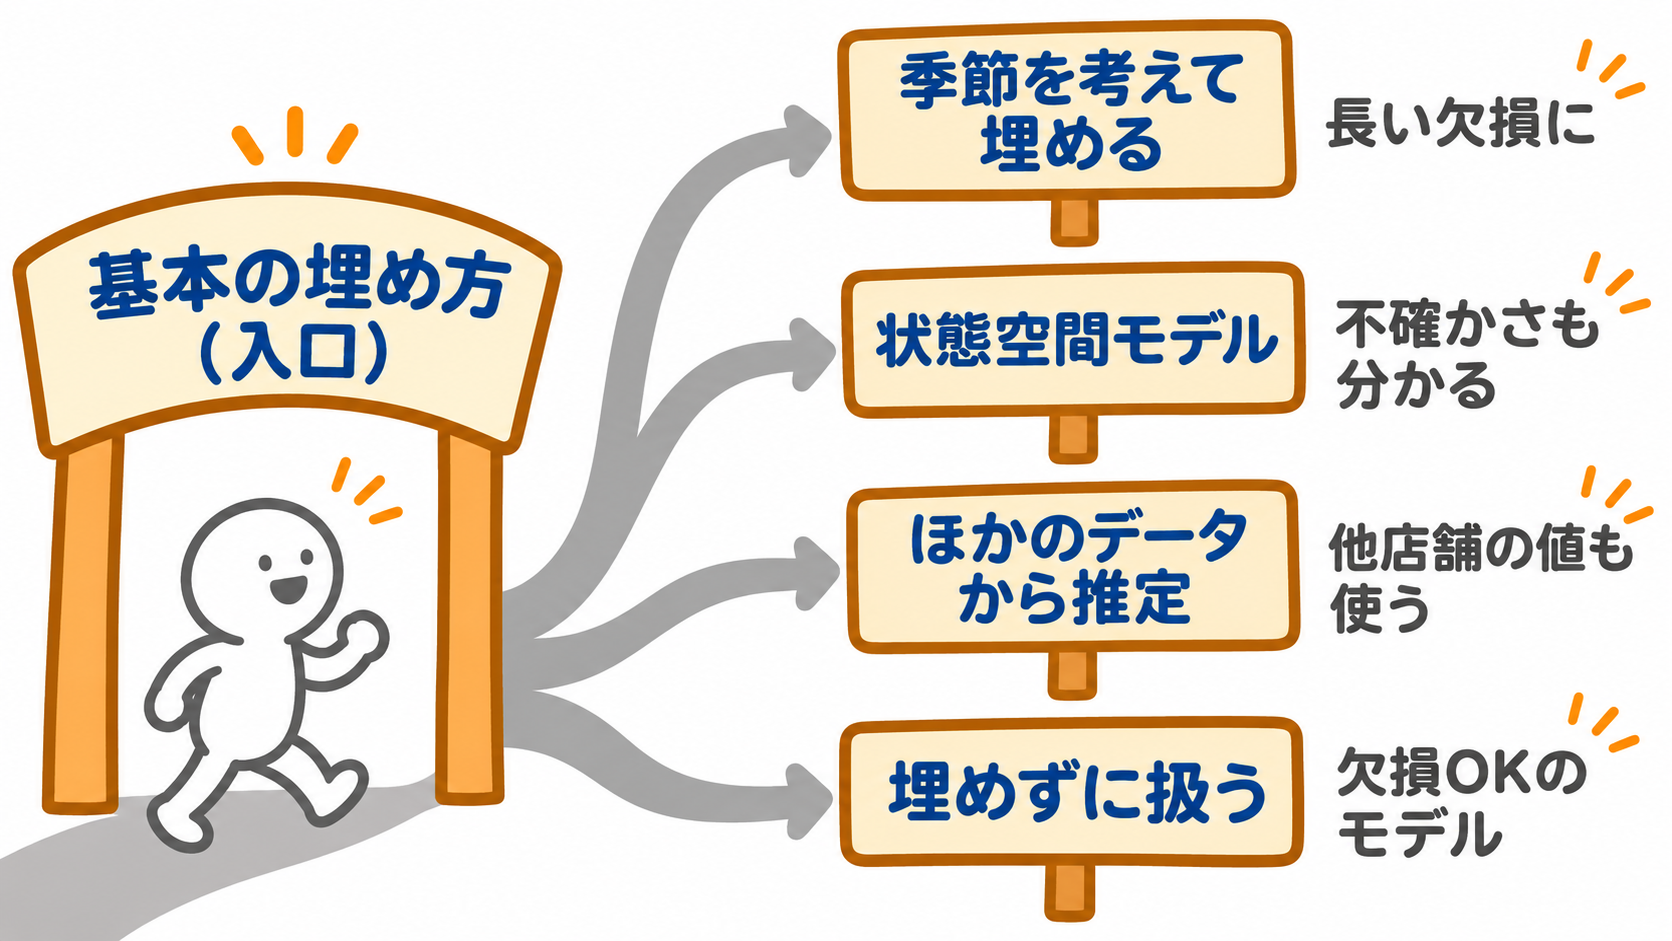
この記事の方法は、どれも1つの系列の前後の値だけを使う、シンプルなものです。欠損が長い、周期が複雑、ほかのデータも手がかりにしたい、といった場面では、次のような方法もあります。
| 方法 | 考え方 | 向いている場面 |
|---|---|---|
| 季節成分を考えて埋める(STL分解など) | トレンド・季節の波・残りに分けてから、残りの部分を補間して戻す | 長い欠損があり、季節や曜日の波が強いとき |
| 状態空間モデル(カルマンスムーザー) | 時系列のモデルを当てはめて、欠損した時点の値を推定する | 欠損が多く、補完した値の不確かさも知りたいとき |
| ほかのデータから推定する(KNNImputer など) | 同じ日のほかの変数(他店舗の値など)との関係から推定する | 同じ時点の別のデータが手がかりになるとき |
| 埋めずに扱う | 欠損をそのまま扱えるモデル(LightGBMなど)に渡す | 予測が目的で、無理に埋めたくないとき |
関連記事です。
Python 時系列分析 1,000本ノック – ノック105: 欠損値の補完 –(
interpolate()とmethod="index"の違いを問うクイズ)
