Pythonで集計した売上を生成AIに渡して、商品ごとに「見出し」と「コメント」を書いてもらう。書いてもらった結果は、Pythonの表(DataFrame)に並べて、Excelに書き出したり、レポートに差し込んだりしたい。そんな場面を考えます。
生成AIの回答が普通の文章だと、困ったことが起きます。
幕の内弁当は売上の3分の1を占める主力商品です。売上金額は93,000円で、全体の33.1%を占めます。
人が読めば分かりますが、Pythonにはどこまでが見出しで、どこからがコメントなのかが分かりません。表の列に分けて入れられないのです。
そこで、回答をJSON(データを文字で表すための書き方の決まり)で返してもらいます。
{"商品名": "幕の内弁当", "見出し": "売上の3分の1を占める主力商品", "コメント": "売上金額は93,000円で、全体の33.1%を占めます。"}
JSONなら、Pythonの json.loads() で辞書に変換し、["見出し"] のようにキー(項目名)で取り出せます。表にするのも簡単です。
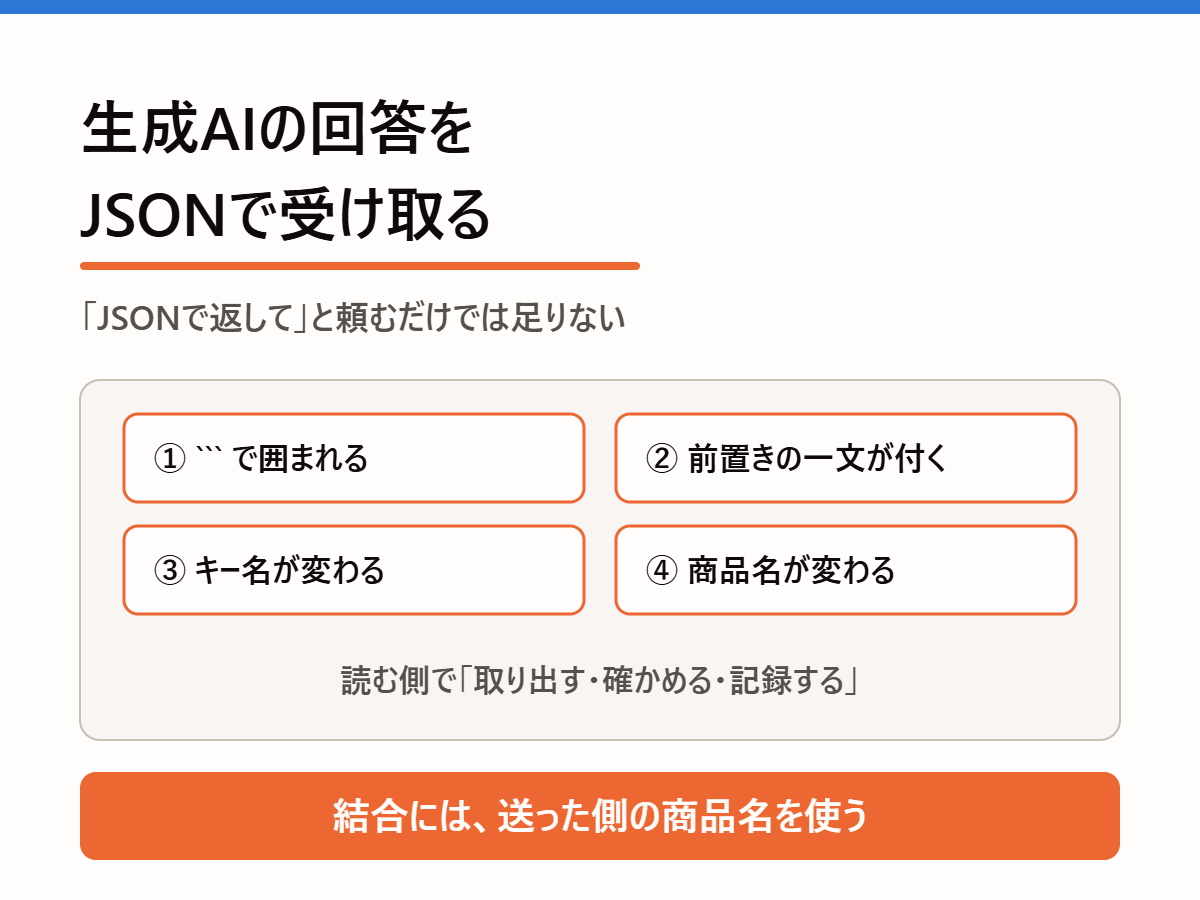
ところが、生成AIに「JSONで返して」と頼むだけでは、どんな形で返ってくるかを、こちらで決められません。この記事では、頼むだけのときに起こりやすい崩れ方を、Pythonで1つずつ確かめます。そのうえで、読む側(Python側)でできる対策を作ります。
先に、この記事の結論を3つ書いておきます。
- 頼むだけだと、回答がコードブロックで囲まれたり、前置きの文が付いたりして、
json.loads()が失敗することがあります。 キー名や商品名が書き換わることもあります - 囲みや前置きは、
{から}までを取り出せば読めます。 キー名や商品名の書き換えは、読む側で直さず、確かめて記録します - 1件ずつ送っているなら、表の結合には、生成AIが返した商品名ではなく、送った側の商品名を使います
この記事を読み終えると、次のことができるようになります。
- 生成AIの回答をJSONで受け取ると、何がうれしいのか説明できる
- 返してほしいJSONの形を、ルールとして生成AIに伝えられる
json.loads()で、回答の文字列をPythonの辞書にできる- 頼むだけのときに起こる4つの崩れ方と、どこで失敗するかが分かる
try/exceptで、読めなかった回答を記録しながら処理を続けられる- 回答を、元の表に正しく結合できる

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| JSON | データを文字で表すための書き方の決まり。{"商品名": "幕の内弁当"} のように書く |
| 辞書(dict) | 「キーと値」の組を集めた、Pythonのデータの形。JSONを読み込むと辞書になる |
| キー | 辞書やJSONの項目名。"商品名" や "見出し" など |
| json.dumps() | Pythonの辞書を、JSONの文字列に変換する関数 |
| json.loads() | JSONの文字列を読んで、Pythonの辞書に戻す関数 |
| DataFrame | pandas(表を扱うPythonのライブラリ)で扱う表 |
| 例外(エラー) | プログラムの実行中に起きた問題。何もしなければ、そこで処理が止まる |
| try / except | 例外が起きても止まらずに、決めておいた処理へ進ませる書き方 |
| JSONDecodeError | json.loads() が、JSONとして読めない文字列を受け取ったときの例外 |
| KeyError | 辞書に無いキーで値を取り出そうとしたときの例外 |
| コードブロック | 文章の中でコードを示すための囲み。```(バッククォート3つ)で前後を囲む |
| 結合(merge) | 2つの表を、共通の列(ここでは商品名)で横につなぐこと |
| API | プログラムから別のサービスを呼び出すための窓口。ここでは、Pythonから生成AIを呼び出す窓口 |
| instructions / input | OpenAIのAPIに渡す引数。instructions は毎回同じルール、input はその都度変わるデータ |
| 環境変数 | パソコン側に置いておく設定値。APIキーをコードに直接書かないために使う |
使うものと準備
この記事のコードは、JupyterLab(ブラウザの中でPythonを少しずつ実行できる開発環境)で動かす前提で書いています。
JupyterLabでは、ノートブック(拡張子が .ipynb のファイル)を開き、コードをセル(コードを入力して実行する枠)に貼って、Shift + Enter で1つずつ実行します。この記事のコードも、上から順にセルへ貼って実行してください。
APIキーが必要なのは、生成AIを実際に呼び出す部分だけです。 回答を読む部分は、この記事で用意した「回答の例」を使うので、APIキーがなくても試せます。
ライブラリを入れる
次のコマンドで、pandas(表の集計に使う)と openai(OpenAIのAPIを呼ぶのに使う)を入れます。pip は、Pythonのライブラリを入れるためのコマンドです。
pip install pandas openai
このコマンドは、ターミナル(WindowsならPowerShell)で実行します。JupyterLabのセルで実行するときは、先頭に % を付けて %pip install pandas openai とします。
JupyterLab自体がまだ入っていない場合は、ターミナルで pip install jupyterlab を実行して入れ、jupyter lab で起動します。ブラウザが開き、JupyterLabの画面が表示されます。
売上CSVを読む
使うのは、コンビニの売上を想定した学習用のCSVファイル sample_sales_202607.csv です。CSVは、値をカンマで区切って並べた表のファイルで、Excelでも開けます。2026年7月6日(月)〜12日(日)の7日間について、5商品の売上が1日1行ずつ、計35行入っています。この記事からダウンロードして、ノートブック(.ipynb ファイル)と同じフォルダに置いてください。
以下からダウンロードできます。
import json
import pandas as pd

df = pd.read_csv("sample_sales_202607.csv")
print(df.head())
           日付 曜日       商品名 カテゴリ  単価(円)  数量  売上金額(円)
0  2026-07-06  月   おにぎり(鮭)  主食     160     29     4640
1  2026-07-06  月   アイスコーヒー  飲料     180     28     5040
2  2026-07-06  月   サンドイッチ   軽食      380    26      9880
3  2026-07-06  月   幕の内弁当     弁当      620    19     11780
4  2026-07-06  月   緑茶 500ml    飲料      150    36     5400
import jsonは、JSONを扱うための道具を読み込みます。Pythonに最初から入っているので、インストールは要りませんimport pandas as pdは、pandasをpdという短い名前で使えるようにしますpd.read_csv()はCSVファイルを読み込み、表(DataFrame)にします。df.head()は先頭の5行だけを表示します
生成AIに渡すデータを作る
計算はPythonで済ませ、生成AIには文章を書く役だけを頼みます。生成AIは文章を作るのは得意ですが、たくさんの数字から合計を正確に計算するのは得意ではないからです。
商品別に集計する
商品別 = (
    df.groupby(["商品名", "カテゴリ"], as_index=False)
      .agg(売上金額=("売上金額(円)", "sum"), 販売数量=("数量", "sum"))
      .sort_values("売上金額", ascending=False)
      .reset_index(drop=True)
)
商品別["売上構成比"] = (商品別["売上金額"] / 商品別["売上金額"].sum() * 100).round(1)

print(商品別)
        商品名 カテゴリ   売上金額  販売数量  売上構成比
0     幕の内弁当       弁当   93000   150   33.1
1     サンドイッチ     軽食   64220   169   22.9
2     アイスコーヒー   飲料   41580   231   14.8
3     おにぎり(鮭)   主食   41120   257   14.6
4    緑茶 500ml       飲料   41100   274   14.6
groupby(["商品名", "カテゴリ"], as_index=False)は、商品名(とカテゴリ)が同じ行を1つのグループにまとめますagg(売上金額=("売上金額(円)", "sum"), …)は、グループごとに合計(sum)し、売上金額という名前の列にしますsort_values("売上金額", ascending=False)は売上金額の大きい順に並べ、reset_index(drop=True)は行番号を0から振り直します- 最後の行で、売上金額を合計で割って100を掛け、
round(1)で小数第1位までに丸めた 売上構成比(全体の売上に占める割合、%)の列を足しています
1商品ずつJSONにする
生成AIには、1商品ずつ、5回に分けて頼みます。そのために、表の1行を1つの辞書にし、それをJSONの文字列にします。
レコード = 商品別.to_dict("records")

print(json.dumps(レコード[0], ensure_ascii=False))
{"商品名": "幕の内弁当", "カテゴリ": "弁当", "売上金額": 93000, "販売数量": 150, "売上構成比": 33.1}
to_dict("records") は、表の1行を1つの辞書にして、リスト(順番に並べたもの)にまとめます。レコード[0] はその1つ目(幕の内弁当)です。json.dumps() で辞書をJSONの文字列にし、ensure_ascii=False で日本語をそのまま出しています(付けないと、日本語が \u5e55 のような記号の列になります)。
「JSONで返して」と頼む
ここからは、生成AIを実際に呼び出します。APIキーが必要です。
APIキーとモデルIDを環境変数に入れる
APIの利用は有料です(使った量に応じた従量課金。単価は OpenAIの料金ページ で確認できます)。ChatGPTの有料プランを契約していても、APIの利用料はその中に含まれません。APIキーは、OpenAIの開発者向けサイト(API keys のページ)で作ります。
APIを呼ぶには、APIキーとモデルID(使うモデルの名前)が要ります。どちらもコードには直接書かず、環境変数(パソコン側に置いておく設定値)から読みます。
- APIキーをコードに書くと、ノートブックを人に渡したときに、キーも一緒に渡ってしまいます。 漏れたキーは他人に使われ、料金が発生するおそれがあります
- モデルIDは、新しいモデルが出ると変わります。 コードに書かず設定に置いておけば、設定だけ差し替えれば済みます。使えるモデルIDは、OpenAIの公式ドキュメントのモデル一覧で確認してください
Windowsなら、PowerShell(Windowsに入っているコマンド入力の画面)で次のように設定し、同じ画面から JupyterLab を起動します。"…" の中は、自分のAPIキーとモデルIDに置き換えてください。
$env:OPENAI_API_KEY = "ここにAPIキーを貼る"
$env:OPENAI_MODEL = "使うモデルのID"
jupyter lab
Anaconda Prompt(Anacondaに付いてくる、コマンドプロンプト形式の画面)を使っている場合は、書き方が変わります。値をダブルクォートで囲まないのがポイントです。囲むと、ダブルクォートまで値の一部になってしまいます。
set OPENAI_API_KEY=ここにAPIキーを貼る
set OPENAI_MODEL=使うモデルのID
jupyter lab
macOS・Linuxのターミナルでは、次のとおりです。
export OPENAI_API_KEY="ここにAPIキーを貼る"
export OPENAI_MODEL="使うモデルのID"
jupyter lab
いずれも、設定したウィンドウの中だけで有効です。別のウィンドウから起動した JupyterLab では読めないので、設定したのと同じウィンドウで jupyter lab を実行してください。すでに JupyterLab を開いている場合は、いったん閉じてから起動し直します。
参考までに、Google Colab を使う場合は、画面左側の鍵のアイコン(シークレット)に OPENAI_API_KEY という名前でAPIキーを登録し、セルで次のように読み込みます。
import os
from google.colab import userdata

os.environ["OPENAI_API_KEY"] = userdata.get("OPENAI_API_KEY")
os.environ["OPENAI_MODEL"] = "使うモデルのID"
ルールに、返してほしい形を書く
OpenAIのAPIでは、生成AIへの指示を2つの引数に分けて渡せます。instructions には毎回同じルールを、input にはその都度変わるデータ(ここでは1商品ぶんのJSON)を入れます。ルールには、返してほしいJSONの形を、できるだけ細かく書いておきます。
ルール = """あなたは小売店の売上を説明する担当者です。
入力はJSONで、1商品ぶんの売上金額・販売数量・売上構成比(全体に占める割合、%)が入っています。
次の形のJSONだけを返してください。
- キーは「商品名」「見出し」「コメント」の3つ
- 商品名:入力の商品名を、1文字も変えずにそのまま書く
- 見出し:20字以内
- コメント:2文以内。入力にある数値だけを使う
- JSONの前後に説明を書かない。コードブロック(```)で囲まない"""
""" で囲むと、改行を含む長い文字列を書けます。ルールの中身は次のとおりです。
- キーの名前を3つとも書いています。 書かなければ、キー名は生成AIが決めます
- 商品名は「1文字も変えずに」と書いています。 あとで元の表と結合するときに使うからです
- 見出しとコメントの長さを決めています。 コメントには「入力にある数値だけを使う」とも書き、数字を作らせないようにしています
- 「前後に説明を書かない」「コードブロックで囲まない」と書いています。 理由は、このあとすぐ分かります
5商品ぶん、1件ずつ呼び出す
import os
from openai import OpenAI

client = OpenAI()                      # OPENAI_API_KEY を環境変数から読む
MODEL = os.environ["OPENAI_MODEL"]     # モデルIDも環境変数から読む

回答一覧 = []
for r in レコード:
    response = client.responses.create(
        model=MODEL,
        instructions=ルール,
        input=json.dumps(r, ensure_ascii=False),
    )
    回答一覧.append(response.output_text)   # 回答の文字列をためる

print(len(回答一覧))
OpenAI()は、環境変数OPENAI_API_KEYからAPIキーを読んで、APIを呼ぶ準備をします。os.environ["OPENAI_MODEL"]は、環境変数からモデルIDを読みます回答一覧 = []で空のリストを作り、for r in レコード:で5商品を1つずつ処理しますclient.responses.create(…)がAPIの呼び出しです。inputには、1商品ぶんの辞書をjson.dumps()でJSONにした文字列を渡していますresponse.output_textが、生成AIが返した回答の文字列です。append()でリストの最後に足していき、最後にlen()で件数(5)を表示します
APIを5回呼ぶので、そのぶんの料金がかかります。
返ってきた文字列をPythonで読む
ここからは、APIキーがなくても試せます。頼むだけのときに起こりやすい崩れ方を1つずつ確かめるため、5件のうち4件に崩れを入れた「回答の例」を使います。APIを呼んだ人は、次のセルを実行せずに、自分の 回答一覧 で試してもかまいません。
次の「回答の例」は、崩れ方を説明するために作ったもので、実際のモデルの回答ではありません。実際には、きれいなJSONだけが返ってくることも多くあります。問題は、それを保証できないことです。
回答の例を用意する
回答一覧 = [
    '{"商品名": "幕の内弁当", "見出し": "売上の3分の1を占める主力商品", "コメント": "売上金額は93,000円で、全体の33.1%を占めます。販売数量は150点です。"}',
    '```json\n{"商品名": "サンドイッチ", "見出し": "全体の2割強を占める軽食", "コメント": "売上金額は64,220円で、全体の22.9%です。販売数量は169点です。"}\n```',
    '以下がJSONです。\n{"商品名": "アイスコーヒー", "見出し": "飲料で売上が多い商品", "コメント": "売上金額は41,580円で、全体の14.8%です。販売数量は231点です。"}',
    '{"商品名": "おにぎり(鮭)", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。売上金額は41,120円で、全体の14.6%です。"}',
    '{"商品": "緑茶 500ml", "見出し": "販売数量が最も多い商品", "コメント": "販売数量は274点です。売上金額は41,100円で、全体の14.6%です。"}',
]

for 回答 in 回答一覧:
    print(回答)
    print("-----")
{"商品名": "幕の内弁当", "見出し": "売上の3分の1を占める主力商品", "コメント": "売上金額は93,000円で、全体の33.1%を占めます。販売数量は150点です。"}
-----
```json
{"商品名": "サンドイッチ", "見出し": "全体の2割強を占める軽食", "コメント": "売上金額は64,220円で、全体の22.9%です。販売数量は169点です。"}
```
-----
以下がJSONです。
{"商品名": "アイスコーヒー", "見出し": "飲料で売上が多い商品", "コメント": "売上金額は41,580円で、全体の14.8%です。販売数量は231点です。"}
-----
{"商品名": "おにぎり(鮭)", "見出し": "販売数量が多い主食", "コメント": "販売数量は257点です。売上金額は41,120円で、全体の14.6%です。"}
-----
{"商品": "緑茶 500ml", "見出し": "販売数量が最も多い商品", "コメント": "販売数量は274点です。売上金額は41,100円で、全体の14.6%です。"}
-----
リストの中の \n は改行を表す記号です。5件の回答は、次のようになっています。
| 何件目 | 商品 | 回答の形 |
|---|---|---|
| 1 | 幕の内弁当 | 頼んだとおりのJSON |
| 2 | サンドイッチ | JSONが ```json と ``` で囲まれている |
| 3 | アイスコーヒー | JSONの前に「以下がJSONです。」という前置きの文が付いている |
| 4 | おにぎり(鮭) | 商品名の括弧が半角の (鮭) になっている |
| 5 | 緑茶 500ml | キー名が「商品名」ではなく「商品」になっている |
json.loads() で辞書にする
まず、頼んだとおりの1件目を読みます。
辞書 = json.loads(回答一覧[0])

print(type(辞書))
print(辞書["見出し"])
<class 'dict'>
売上の3分の1を占める主力商品
json.loads() は、JSONの文字列を読んで、Pythonの辞書に変換します。type() で型を調べると dict(辞書)になっていて、辞書["見出し"] で見出しだけを取り出せました。回答がJSONで返ってくれば、項目ごとに取り出せるということです。
頼むだけのときに起こる4つの崩れ方
残りの4件で、何が起きるかを確かめます。崩れ方によって、失敗する場所が違います。
コードブロックで囲まれると、json.loads() が失敗する
json.loads(回答一覧[1])
JSONDecodeError: Expecting value: line 1 column 1 (char 0)
JupyterLabでは、エラーが起きると、どこで起きたかをたどる表示(トレースバック)が何行も続き、最後の行にエラーの種類と内容が出ます。この記事では、その最後の行だけを載せています。
2件目(サンドイッチ)を読もうとして、JSONDecodeError(JSONとして読めない、という例外)が出ました。line 1 column 1 (char 0) は「1行目の1文字目」という意味です。最初の文字 ` の時点で、JSONではないと判断されています。
``` は、文章の中でコードを示すときに使う囲みの記号です。生成AIは、チャット画面で読みやすく見せるために、JSONをこの記号で囲んで返すことがあります。人には読みやすくても、json.loads() にとってはJSONの前後に余計な文字が付いた文字列です。
前置きの一文が付いても、同じく失敗する
5件をまとめて読んでみます。途中で失敗しても止まらないように、try / except を使います。
for 回答 in 回答一覧:
    try:
        辞書 = json.loads(回答)
        print("読めた:", 辞書.get("商品名"))
    except json.JSONDecodeError as e:
        print("読めない:", e)
読めた: 幕の内弁当
読めない: Expecting value: line 1 column 1 (char 0)
読めない: Expecting value: line 1 column 1 (char 0)
読めた: おにぎり(鮭)
読めた: None
try:の中で例外が起きると、止まらずにexcept json.JSONDecodeError as e:の中へ進みます。eには、例外の内容(エラーメッセージ)が入ります辞書.get("商品名")は、キー「商品名」の値を取り出します。辞書["商品名"]と違い、キーが無くてもエラーにならず、None(値が無いこと)を返します
3件目(アイスコーヒー)も読めませんでした。「以下がJSONです。」という前置きの文が付いているので、やはり最初の文字でJSONではないと判断されています。
4件目と5件目は、JSONとしては読めました。しかし、4件目の商品名は おにぎり(鮭)、5件目の商品名は None です。読めたからといって、使えるとは限りません。
キー名が変わると、取り出すときに止まる
辞書 = json.loads(回答一覧[4])

print(list(辞書.keys()))
print(辞書["商品名"])
['商品', '見出し', 'コメント']
KeyError: '商品名'
辞書.keys() は、辞書のキーの一覧です。5件目は、キーが「商品名」ではなく「商品」になっていました。そのため、辞書["商品名"] で取り出そうとして KeyError(そのキーは無い、という例外)で止まりました。
商品名が書き換わると、表と結合できない
回答を表にして、元の商品別の表と結合(商品名が同じ行を横につなぐこと)してみます。ここでは、読めた1件目と4件目だけを使います。
回答表 = pd.DataFrame([json.loads(回答一覧[0]), json.loads(回答一覧[3])])
対象 = 商品別[商品別["商品名"].isin(["幕の内弁当", "おにぎり(鮭)"])]

print(対象[["商品名", "売上金額"]].merge(回答表, on="商品名", how="left")[["商品名", "売上金額", "見出し"]])
       商品名   売上金額              見出し
0    幕の内弁当      93000       売上の3分の1を占める主力商品
1    おにぎり(鮭)  41120              NaN
pd.DataFrame([…])は、辞書のリストから表を作りますisin([…])は「リストの中のどれかに当たる行」を選ぶ書き方で、ここでは2商品の行だけを取り出していますmerge(回答表, on="商品名", how="left")は、商品名が同じ行どうしを横につなぎます。how="left"は、左の表(元のデータ)の行をすべて残す指定です
幕の内弁当には見出しが入りましたが、おにぎり(鮭)は NaN(値が無いこと)になりました。つながらなかったのです。理由は、次の1行で分かります。
print("おにぎり(鮭)" == "おにぎり(鮭)")
False
元のデータの おにぎり(鮭) は全角の括弧、回答の おにぎり(鮭) は半角の括弧です。人の目にはほとんど同じでも、Pythonにとっては別の文字なので、==(等しいか)は False になります。
ルールに書いても、防げるとは限らない
ルールには「コードブロックで囲まない」「前後に説明を書かない」「商品名は1文字も変えない」と書いていました。それでも、こうした崩れは起こりえます。
生成AIは、指示を読んで、それらしい文章を作る仕組みです。「この形で返す」という約束を、必ず守る仕組みではありません。 同じルール・同じデータでも、実行するたびに回答は少しずつ変わります。100回中99回守られても、残りの1回で処理が止まれば困ります。
読む側でできる対策
崩れ方には、読む側(Python側)で直せるものと、直すべきでないものがあります。
{ から } までを取り出す
囲みや前置きは、JSONの外側に余計な文字が付いているだけです。最初の { から最後の } までを切り出せば、読めるようになります。
def JSON部分を取り出す(文字列):
    始め = 文字列.find("{")
    終わり = 文字列.rfind("}")
    if 始め == -1 or 終わり == -1:
        raise ValueError("JSONが見つからない")
    return json.loads(文字列[始め:終わり + 1])

for 回答 in 回答一覧[:3]:
    print(JSON部分を取り出す(回答)["商品名"])
幕の内弁当
サンドイッチ
アイスコーヒー
def JSON部分を取り出す(文字列):は、この処理に名前を付けて関数にしています文字列.find("{")は、最初の{が何文字目にあるかを返します。rfind("}")は、最後の}の位置を返します。見つからないときは-1ですraise ValueError(…)は、自分で例外を起こす書き方です。{や}が無ければ、JSONが見つからないとして止めます文字列[始め:終わり + 1]は、始めから終わりまでの文字を切り出す書き方です。+ 1は、}自身も含めるためです回答一覧[:3]は、リストの先頭から3件を取り出す書き方です
2件目と3件目も、商品名まで読めるようになりました。ただし、この方法は万能ではありません。 前置きの文の中に { が含まれていたり、JSONが2つ返ってきたりすると、うまく切り出せません。その場合は json.loads() が失敗するので、次の手順で「読めない」として記録します。
キーと商品名を確かめる
キー名や商品名の書き換えは、JSONの中身の問題です。読む側で直すのではなく、確かめて記録します。
必須キー = {"商品名", "見出し", "コメント"}
商品名一覧 = set(商品別["商品名"])

def 確かめる(辞書):
    足りない = 必須キー - set(辞書)
    if 足りない:
        return f"キーが足りない: {sorted(足りない)}"
    if 辞書["商品名"] not in 商品名一覧:
        return f"データにない商品名: {辞書['商品名']}"
    return "OK"
{…}で囲んだ必須キーは、集合(重複しない値の集まり)です。set(商品別["商品名"])で、データにある商品名の集合も作っています必須キー - set(辞書)は、「必須キーのうち、回答の辞書に無いもの」を求める引き算です。1つでもあれば、足りないキーを返します辞書["商品名"] not in 商品名一覧は、「回答の商品名が、データにある商品名のどれでもない」ことを調べます- どちらも問題が無ければ
"OK"を返します
5件をまとめて処理し、読めなかった回答を記録する
ここまでの2つの関数を使って、5件をまとめて処理します。失敗しても止めずに、何が起きたかを記録します。
行 = []
for r, 回答 in zip(レコード, 回答一覧):
    try:
        辞書 = JSON部分を取り出す(回答)
    except ValueError as e:
        行.append({"送った商品名": r["商品名"], "状態": f"読めない: {e}"})
        continue
    行.append({"送った商品名": r["商品名"], "状態": 確かめる(辞書),
               "見出し": 辞書.get("見出し"), "コメント": 辞書.get("コメント")})

結果表 = pd.DataFrame(行)
print(結果表[["送った商品名", "状態"]])
     送った商品名                  状態
0     幕の内弁当                  OK
1    サンドイッチ                  OK
2   アイスコーヒー                  OK
3   おにぎり(鮭)  データにない商品名: おにぎり(鮭)
4  緑茶 500ml    キーが足りない: ['商品名']
zip(レコード, 回答一覧)は、2つのリストを先頭から1つずつ組にして取り出します。rは送った1商品ぶんの辞書、回答はその回答の文字列ですexcept ValueErrorで、JSON部分を取り出す()の中で起きた例外をまとめて受け止めます。JSONDecodeErrorもValueErrorの一種なので、ここに含まれます。読めなかったら「読めない」と記録し、continueで次の商品へ進みます- 読めたら
確かめる()の結果を「状態」として記録します - 「送った商品名」には、生成AIが返した商品名ではなく、こちらが送った
r["商品名"]を入れています。 この理由は次で説明します
5件のうち3件がOKになり、残りの2件は、何が起きたかが「状態」に残りました。処理は最後まで止まっていません。
結合には、送った側の商品名を使う
使える = 結果表[結果表["状態"] == "OK"]
成果物 = 商品別.merge(使える, left_on="商品名", right_on="送った商品名", how="left")

print(成果物[["商品名", "売上金額", "見出し"]])
        商品名   売上金額              見出し
0     幕の内弁当  93000  売上の3分の1を占める主力商品
1    サンドイッチ  64220     全体の2割強を占める軽食
2   アイスコーヒー  41580       飲料で売上が多い商品
3   おにぎり(鮭)  41120              NaN
4  緑茶 500ml  41100              NaN
結果表[結果表["状態"] == "OK"]は、状態がOKの行だけを取り出しますleft_on="商品名", right_on="送った商品名"は、左の表の「商品名」と、右の表の「送った商品名」が同じ行をつなぐ指定です
1件ずつ送っているので、どの回答がどの商品のものかは、Python側が最初から知っています。生成AIが返した商品名で結合すると、先ほどのように全角・半角の違いだけでつながらなくなります。送った側の商品名で結合すれば、その心配はありません。
おにぎり(鮭)と緑茶 500ml は、OKではないので NaN のままです。空いているので、確かめるべき行だとすぐ分かります。
中身の崩れは、推測で直さない
キー「商品」を「商品名」に読み替える、半角の括弧を全角に直す。今回の例なら、人が見れば正しい直し方が分かります。しかし、読む側のコードで直し始めると、それは推測です。どんな書き換えが来るかは事前に分からないので、直すコードは際限なく増えていきます。
中身が崩れた回答は、「状態」に記録したうえで、もう一度頼み直すか、人が確かめます。そして根本的には、生成AIの側に、決めた形を守らせる仕組みが必要です。
Claude・Geminiではここが違う
回答を読む部分(json.loads() から結合まで)は、3社とも同じです。 変わるのは、生成AIを呼び出して 回答一覧 を作る部分だけです。ルール と レコード も、そのまま使えます。
| OpenAI | Gemini | Claude | |
|---|---|---|---|
| 入れるライブラリ | openai |
google-genai |
anthropic |
| APIキーの環境変数 | OPENAIAPIKEY |
GEMINIAPIKEY(GOOGLEAPIKEY もあると、そちらが優先) |
ANTHROPICAPIKEY |
| データを渡す場所 | input= |
contents= |
messages= の user の content |
| ルールを渡す場所 | instructions= |
config= の systeminstruction |
system= |
| 回答の文字列 | response.outputtext |
response.text |
content のテキスト部分をつなげる |
モデルIDは、それぞれ GEMINI_MODEL・CLAUDE_MODEL という名前の環境変数に入れておく前提で書いています。設定のしかたは、OpenAIのときと同じです。
Gemini の場合
pip install google-genai で入れておきます。
import os
from google import genai
from google.genai import types

client = genai.Client()                # GEMINI_API_KEY を環境変数から読む

回答一覧 = []
for r in レコード:
    response = client.models.generate_content(
        model=os.environ["GEMINI_MODEL"],
        contents=json.dumps(r, ensure_ascii=False),
        config=types.GenerateContentConfig(system_instruction=ルール),
    )
    回答一覧.append(response.text)
Claude の場合
pip install anthropic で入れておきます。
import os
from anthropic import Anthropic

client = Anthropic()                   # ANTHROPIC_API_KEY を環境変数から読む

回答一覧 = []
for r in レコード:
    message = client.messages.create(
        model=os.environ["CLAUDE_MODEL"],
        max_tokens=1024,               # Claudeでは必須
        system=ルール,
        messages=[{"role": "user", "content": json.dumps(r, ensure_ascii=False)}],
    )
    回答一覧.append("".join(b.text for b in message.content if b.type == "text"))
Claudeでは、出力の上限 max_tokens を必ず指定します。回答は content にブロックのリストとして入っているので、テキストのブロックだけをつなげて取り出します。
どの社でも、「JSONで返して」と頼むだけでは形を保証できない点は同じです。
まとめ
今回のポイントです。
| 覚えておくこと | |
|---|---|
| なぜJSONで受け取るか | json.loads() で辞書にでき、項目ごとに取り出して表にできる |
| 頼み方 | キー名・長さ・「前後に説明を書かない」「コードブロックで囲まない」までルールに書く。それでも保証にはならない |
| 囲み・前置き | json.loads() で失敗する。{ から } までを取り出せば読める |
| キー名の変化 | 取り出すときに KeyError。必須キーがそろっているかを確かめる |
| 商品名の変化 | 結合できない。データにある商品名かを確かめる |
| 結合 | 送った側の商品名で結合する |
| 直せないもの | 読む側で推測して直さない。記録して、頼み直すか人が確かめる |
