前回の記事では、生成AIにCSVを渡して「分析して」と頼むと数字が毎回変わる理由を、期間・対象・指標・出力形式の4条件から整理しました。そして、4条件を関数の引数に固定すれば、誰が何回計算しても同じ数字になることを確かめました。
ただ、ひとつ宿題が残っています。「先週から売上が落ちた商品は?」という日本語から、cur_start="2026-08-24" のような引数を、毎回人が書くのでしょうか。
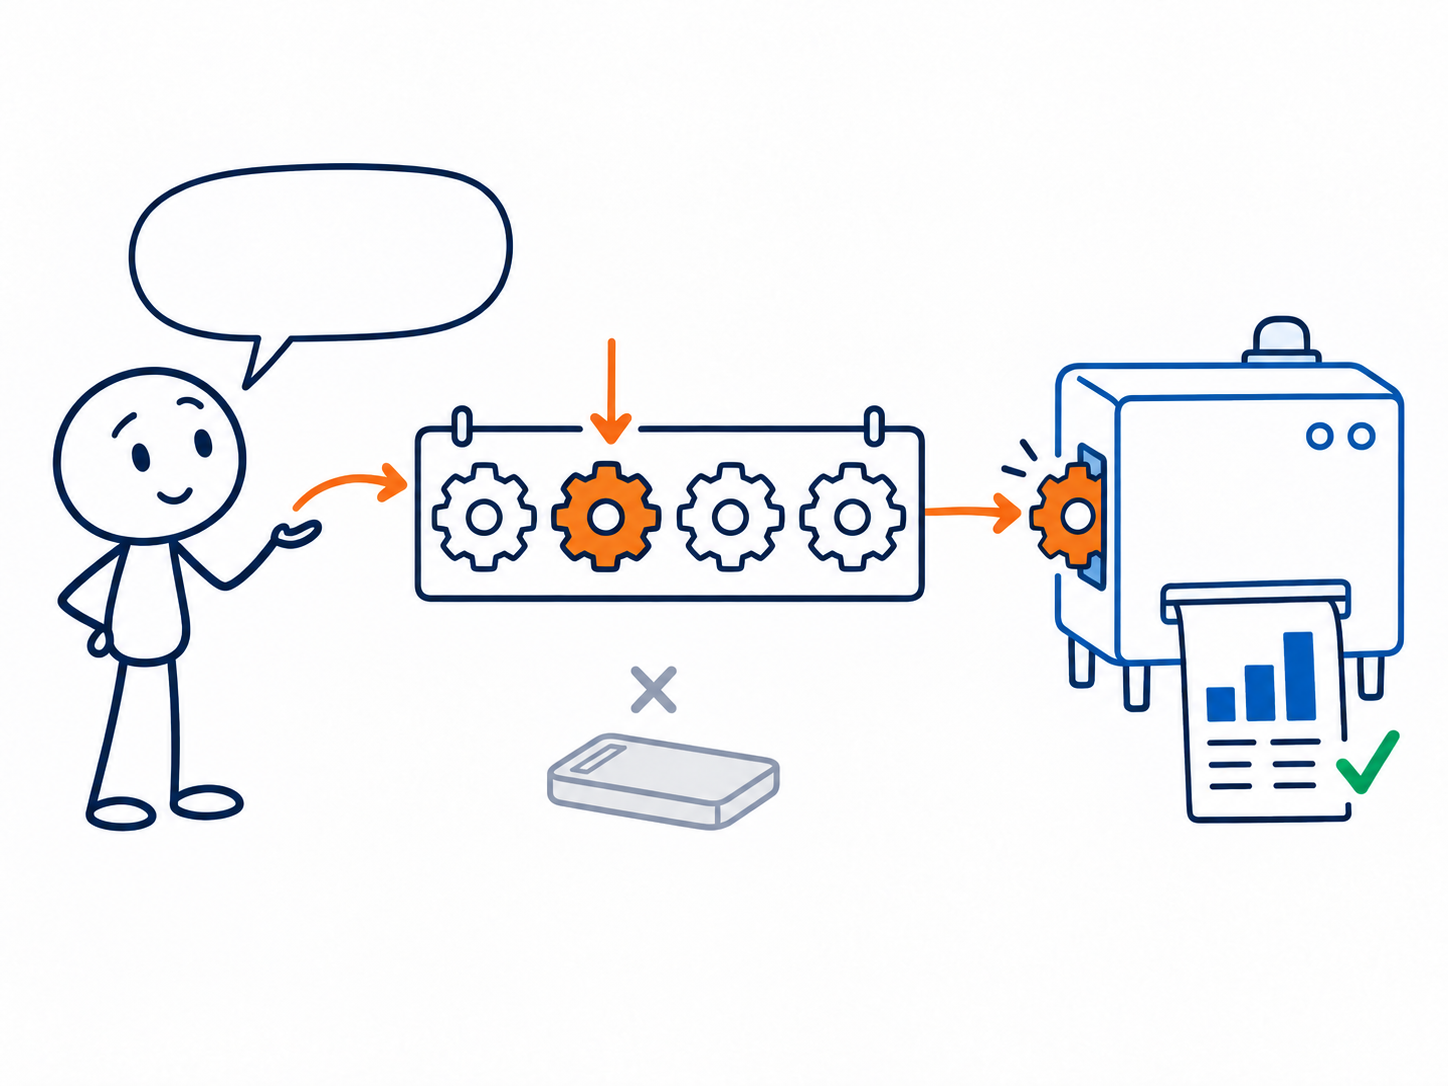
ここを生成AIに任せる仕組みが Tool Calling です。生成AIに計算をさせるのではなく、どの関数をどんな引数で呼ぶかを決めさせる。この記事では、その仕組みを最小のコードで動かしながら説明します。
この記事を読み終えると、次のことができるようになります。
- Tool Calling とは何か——生成AIは計算しない、関数を選ぶだけ
- 自分の関数を生成AIに「見せる」ための、ツール定義の書き方
- 質問 → ツール要求 → 検証 → 実行 → 説明、という5つのステップを実際のコードで
- 生成AIの要求をそのまま実行しないための「検証層」
- 生成AIに送っているものは何か(CSV本体は送りません)

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
Tool Calling とは何か
Tool Calling とは、生成AIに「あらかじめ定義した関数の一覧」を渡しておき、質問に対して「どの関数を、どんな引数で呼ぶべきか」をJSON形式で答えさせる仕組みです。関数を実行するのは生成AIではなく、こちら側のプログラムです。
大事なのは後半です。生成AIがやるのは「この質問なら compare_periods を、当期 8/24〜30・前期 8/17〜23 で呼ぶべきだ」と決めるところまで。実際に計算するのはこちらのPython、結果の数字を受け取って説明を書くのはまた生成AI、という分担になります。
CSVをチャットに丸投げする方式と比べると、3つが変わります。
| CSVをチャットに渡す | Tool Calling | |
|---|---|---|
| 計算するのは | 生成AI(毎回その場で) | Pythonの関数(仕様が固定) |
| 生成AIに送るもの | CSV本体(1,240行すべて) | データの概要と、集計結果の要点だけ |
| あとから確認できるもの | 回答の文章だけ | どの関数を・どの引数で呼び・何が返ったか |
「同じ質問に同じ数字が返る」のは1行目の効果です。2行目はデータを外に出す量の話、3行目は「その数字はどこから来たのか」を追える話で、業務で使うならこの2つも同じくらい効きます。
準備:前回の関数とサンプルCSV
前回と同じサンプルCSVを使います。まだお持ちでない方はこちらからどうぞ。
pos_sales_sample.csv をダウンロード
POS売上サンプルデータ(20商品×62日=1,240行・BOM付きUTF-8・約64KB)
コードを動かすには pandas と openai が必要です。pip install pandas openai で入ります。
APIキーはコードに書かず、実行時に入力します。getpass を使うと画面に表示されずに入力できます。
以下、コードです。
import json
import re
from getpass import getpass

import pandas as pd
from openai import OpenAI

pd.set_option("display.unicode.east_asian_width", True)
df = pd.read_csv("pos_sales_sample.csv", encoding="utf-8-sig")

# APIキーはコードに書かない。実行するたびに入力する
client = OpenAI(api_key=getpass("OPENAI_API_KEY: "))
OpenAI(api_key=...)が、OpenAIのAPIを呼ぶための窓口(クライアント)です。以降はこのclientを通して質問を送りますgetpass(...)は、入力した文字を画面に出さずに受け取る関数です。キーがNotebookやファイルに残りません
前回作った compare_periods も、そのまま使います(中身は前回の記事のとおりです)。
以下、コードです。
def compare_periods(df, cur_start, cur_end, prev_start, prev_end, category=None):
    """当期と前期の売上金額を商品別に比較する。期間は両端を含む"""
    cur  = df[(df["日付"] >= cur_start)  & (df["日付"] <= cur_end)]
    prev = df[(df["日付"] >= prev_start) & (df["日付"] <= prev_end)]
    if category:
        cur, prev = cur[cur["カテゴリ"] == category], prev[prev["カテゴリ"] == category]
    a = cur.groupby("商品名")["売上金額"].sum()
    b = prev.groupby("商品名")["売上金額"].sum()
    table = (a.to_frame("当期売上").join(b.to_frame("前期売上"), how="outer")
              .fillna(0).astype(int))
    table["増減額"] = table["当期売上"] - table["前期売上"]
    assert table["増減額"].sum() == a.sum() - b.sum()
    return table.sort_values("増減額")
APIキーをお持ちでない方へ:記事末尾の付録に、生成AIの応答を模擬する
FakeClientを載せています。client = FakeClient()に置き換えると、この記事のコードは最後まで動きます。
ステップ1:関数を生成AIに「見せる」——ツール定義
生成AIは、こちらのPythonコードを読めません。「こういう関数があって、こういう引数を取る」ということを、JSON形式の説明書にして渡す必要があります。これがツール定義です。
まず、category に指定できる値をデータから作っておきます。
以下、コードです。
CATEGORIES = sorted(df["カテゴリ"].unique().tolist())
print(CATEGORIES)
以下、実行結果です。
['おにぎり', 'デザート', '弁当', '飲料']
この一覧をツール定義に埋め込むと、生成AIは「スイーツ」のような存在しないカテゴリを指定できなくなります。
以下、コードです。
TOOLS = [{
    "type": "function",
    "function": {
        "name": "compare_periods",
        "description": "当期と前期の売上金額を商品別に比較し、増減額を返す。「先週から落ちた商品は」のような質問に使う。",
        "strict": True,
        "parameters": {
            "type": "object",
            "additionalProperties": False,
            "properties": {
                "cur_start":  {"type": "string", "description": "当期の開始日(YYYY-MM-DD)"},
                "cur_end":    {"type": "string", "description": "当期の終了日(YYYY-MM-DD)"},
                "prev_start": {"type": "string", "description": "前期の開始日(YYYY-MM-DD)"},
                "prev_end":   {"type": "string", "description": "前期の終了日(YYYY-MM-DD)"},
                "category":   {"anyOf": [{"type": "string", "enum": CATEGORIES},
                                         {"type": "null"}],
                               "description": "カテゴリで絞るときに指定。全商品なら null"},
            },
            "required": ["cur_start", "cur_end", "prev_start", "prev_end", "category"],
        },
    },
}]
長く見えますが、Pythonの関数の各部分と1対1で対応しています。
name:関数名。生成AIはこの名前で「呼びたい関数」を指定してきますdescription:生成AIが「いつこの関数を使うか」を判断する材料です。何をする関数かだけでなく、どんな質問に向くかを書くと選ばれやすくなりますparameters:引数の説明書。JSON Schema という書式で、引数の名前・型・説明を並べますenum:取りうる値を列挙します。categoryは「この4つのどれか、または null」に制限しましたrequired:必須の引数。strict: Trueのときは全部の引数を必須にし、additionalProperties: Falseを付ける決まりです。こうすると生成AIは定義にない引数を勝手に足せなくなります
ステップ2:質問を送り、ツール要求を受け取る
ツール定義ができたら、質問と一緒に送ります。ここで、生成AIに「基準日」と「先週の定義」をこちらから教えておくのがポイントです。前回の記事で見たとおり、これを教えないと「先週」の解釈が毎回変わります。
以下、コードです。
SYSTEM = """あなたはD店の売上分析を手伝います。
数値は必ずツールの結果だけを使い、自分で計算しないでください。
基準日は 2026-08-31 です。「先週」は基準日の直前の月曜〜日曜、「前週」はその1週間前です。
データの期間は 2026-07-01〜2026-08-31、カテゴリは おにぎり/デザート/弁当/飲料 です。"""

question = "先週から売上が落ちた商品は?"

first = client.chat.completions.create(
    model="gpt-5.6-luna",
    messages=[{"role": "system", "content": SYSTEM},
              {"role": "user", "content": question}],
    tools=TOOLS,
    tool_choice="auto",
    reasoning_effort="none",   # gpt-5系で tools を使うときに必要
)
msg = first.choices[0].message
call = msg.tool_calls[0]
print("関数名:", call.function.name)
print("引数  :", call.function.arguments)
print("本文  :", msg.content)
messagesは会話の履歴です。systemはこちらからの前提条件、userが質問tools=TOOLSで、ステップ1のツール定義を渡しますtool_choice="auto"は「関数を使うかどうかは生成AIが判断する」という指定です。"required"にすると必ず関数を選ばせますreasoning_effort="none":gpt-5系のモデルでtoolsを使うとき、これを付けないとFunction tools with reasoning_effort are not supported ...というエラーで止まります。付け忘れやすいので注意してください- 応答は
first.choices[0].messageに入っています。関数を呼びたいときはtool_callsにその要求が、そうでないときはcontentに文章が入ります
以下、実行結果です。
関数名: compare_periods
引数  : {"cur_start":"2026-08-24","cur_end":"2026-08-30","prev_start":"2026-08-17","prev_end":"2026-08-23","category":null}
本文  : None
生成AIは「先週から売上が落ちた商品は?」という日本語を、関数名と引数のJSONに翻訳して返してきました。基準日 8/31 から「先週=8/24〜30、前週=8/17〜23」を正しく解決しています。content が None なのは、まだ文章を書く段階ではないからです。
ここで気づいてほしいのは、まだ何も計算されていないということです。返ってきたのは「こう呼んでほしい」という要求だけで、compare_periods は1回も動いていません。
この記事の実行結果のうち、生成AIの応答(このステップと、ステップ5)は付録の
FakeClientで得たものです。実際のAPIでも、返ってくるものの形(tool_callsの中のnameとarguments)は同じです。
ステップ3:ツール要求を検証する
生成AIの要求を、そのまま実行してはいけません。存在しない関数を呼ぼうとしたり、データにない期間を指定したりすることがあるからです。実行の前に検証層を挟みます。
以下、コードです。
ALLOWED = {"compare_periods"}
DATE = re.compile(r"^\d{4}-\d{2}-\d{2}$")
DATA_MIN, DATA_MAX = df["日付"].min(), df["日付"].max()

def validate(name, arguments):
    """ツール要求を検証する。問題があれば理由を、なければ None を返す"""
    if name not in ALLOWED:
        return f"許可されていない関数: {name}"
    args = json.loads(arguments)
    for k in ["cur_start", "cur_end", "prev_start", "prev_end"]:
        v = args.get(k)
        if not isinstance(v, str) or not DATE.match(v):
            return f"{k} が日付の形式ではありません: {v!r}"
        if not (DATA_MIN <= v <= DATA_MAX):
            return f"{k} がデータの期間外です: {v}(データは {DATA_MIN}〜{DATA_MAX})"
    if args.get("category") is not None and args["category"] not in CATEGORIES:
        return f"存在しないカテゴリ: {args['category']}(候補: {CATEGORIES})"
    return None

print("検証:", validate(call.function.name, call.function.arguments) or "OK")
ALLOWED:呼んでよい関数の許可リスト。定義した関数以外は、名前が合っていても実行しませんDATE:日付がYYYY-MM-DDの形かどうかを確かめる正規表現ですjson.loads(arguments):argumentsは文字列で届くので、辞書に戻します- 期間がデータの範囲内か、カテゴリが一覧にあるかを順に確かめ、最初に見つかった問題を返します
以下、実行結果です。
検証: OK
わざと壊れた要求を渡すと、どうなるか見てみます。
以下、コードです。
print(validate("compare_periods",
               '{"cur_start":"2026-09-01","cur_end":"2026-09-07","prev_start":"2026-08-25","prev_end":"2026-08-31","category":null}'))
print(validate("compare_periods",
               '{"cur_start":"2026-08-24","cur_end":"2026-08-30","prev_start":"2026-08-17","prev_end":"2026-08-23","category":"スイーツ"}'))
print(validate("run_sql", '{"query":"SELECT * FROM sales"}'))
以下、実行結果です。
cur_start がデータの期間外です: 2026-09-01(データは 2026-07-01〜2026-08-31)
存在しないカテゴリ: スイーツ(候補: ['おにぎり', 'デザート', '弁当', '飲料'])
許可されていない関数: run_sql
3つ目が重要です。run_sql という関数はこちらに存在しませんが、もし「生成AIが指定した名前の関数を探して実行する」ような書き方をしていたら、意図しないものが動く可能性があります。許可リストにある関数しか動かないようにしておくのが、Tool Calling を安全に使う前提です。
検証に失敗したときは、その理由を生成AIに返して、条件を直してもらうか、利用者に聞き直してもらいます。数字を作って埋めることはしません。
ステップ4:関数を実行し、生成AIに返す結果を作る
検証を通ったので、こちらのPythonで計算します。ここで、結果の表をそのまま返さないのがコツです。生成AIに渡すのは、説明を書くのに必要な要点だけにします。
以下、コードです。
args = json.loads(call.function.arguments)
table = compare_periods(df, **args)

def pct(cur, prev):
    return round((cur - prev) / prev * 100, 1) if prev > 0 else None

result_for_ai = {
    "result_id": "R1",
    "期間": {"当期": f"{args['cur_start']}〜{args['cur_end']}",
           "前期": f"{args['prev_start']}〜{args['prev_end']}"},
    "全体": {"当期売上": int(table["当期売上"].sum()),
           "前期売上": int(table["前期売上"].sum()),
           "増減額":  int(table["増減額"].sum()),
           "増減率":  pct(int(table["当期売上"].sum()), int(table["前期売上"].sum()))},
    "減少上位": table.head(3)["増減額"].reset_index().to_dict(orient="records"),
    "増加上位": table.tail(3)["増減額"].sort_values(ascending=False)
                    .reset_index().to_dict(orient="records"),
}
print(json.dumps(result_for_ai, ensure_ascii=False, indent=2))
print("文字数:", len(json.dumps(result_for_ai, ensure_ascii=False)))
compare_periods(df, **args):**argsは「辞書の中身を、引数の名前つきで展開して渡す」書き方です。cur_start="2026-08-24", ...と書いたのと同じになりますresult_id:この結果に付ける通し番号です。あとで説明文の中の数字が「どの結果から来たか」を追うために使いますtable.head(3)["増減額"]:減少額の大きい3商品の「増減額」列だけを取り出します。説明に必要なのはここまでなので、当期・前期の売上は送りませんto_dict(orient="records"):表を「1行=1つの辞書」のリストに変えます。JSONにしやすい形です
以下、実行結果です。
{
  "result_id": "R1",
  "期間": {
    "当期": "2026-08-24〜2026-08-30",
    "前期": "2026-08-17〜2026-08-23"
  },
  "全体": {
    "当期売上": 635010,
    "前期売上": 647940,
    "増減額": -12930,
    "増減率": -2.0
  },
  "減少上位": [
    {
      "商品名": "ハンバーグ弁当",
      "増減額": -31900
    },
    {
      "商品名": "明太子おにぎり",
      "増減額": -30600
    },
    {
      "商品名": "麦茶",
      "増減額": -8540
    }
  ],
  "増加上位": [
    {
      "商品名": "幕の内弁当",
      "増減額": 19140
    },
    {
      "商品名": "鮭おにぎり",
      "増減額": 12960
    },
    {
      "商品名": "アイスバー",
      "増減額": 12360
    }
  ]
}
文字数: 372
生成AIに送るのは、この 372文字 だけです。元のCSVは約43,000文字(1,240行)ありますが、それは一度も外に出ていません。
ステップ5:結果を渡して、説明を書かせる
最後に、この結果を生成AIに返して、日本語の説明を書いてもらいます。
以下、コードです。
second = client.chat.completions.create(
    model="gpt-5.6-luna",
    messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": question},
        msg,                                          # 生成AIのツール要求をそのまま履歴に入れる
        {"role": "tool", "tool_call_id": call.id,
         "content": json.dumps(result_for_ai, ensure_ascii=False)},
    ],
    reasoning_effort="none",
)
print(second.choices[0].message.content)
messagesには、最初の質問からの会話の履歴をすべて入れます。生成AIは前回の呼び出しを覚えていないので、毎回こちらから渡します- 3つ目の
msgは、ステップ2で生成AIが返してきたツール要求です。そのまま履歴に入れます - 4つ目がツールの結果です。
roleを"tool"にし、tool_call_idでステップ2の要求と対応づけ、contentに結果のJSONを文字列で入れます - 今回は
toolsを渡していないので、生成AIは関数を呼ばず、文章を返します
以下、実行結果です。
先週(2026-08-24〜2026-08-30)の売上は635,010円で、前週(2026-08-17〜2026-08-23)の647,940円から12,930円(-2.0%)減少しました。
減少額が大きい商品は、ハンバーグ弁当(-31,900円)、明太子おにぎり(-30,600円)、麦茶(-8,540円)です。
一方で幕の内弁当(+19,140円)など増えた商品もあり、全体の減少幅は減った商品の合計より小さくなっています。
(根拠:結果ID R1)
この文章に出てくる数字は、すべてステップ4の result_for_ai に入っていたものです。生成AIは計算していません。数字はPython、説明は生成AIという分担が、コードのうえで実現できました。
引数を制限する——設計のコツ
ステップ1のツール定義とステップ3の検証は、生成AIに任せる範囲を決めるところです。ここを緩くすると、せっかくの再現性が崩れます。いくつかの原則を挙げます。
| 引数の種類 | こうする | 理由 |
|---|---|---|
| 日付 | YYYY-MM-DD の文字列に固定し、データの範囲内かを検証する |
「先週」のような相対表現を引数に入れると、解釈が生成AI任せになる |
| カテゴリ・商品名 | データから作った一覧を enum にする |
存在しない名前や、似た名前への勝手な置き換えを防ぐ |
| 件数(上位N件など) | 整数にして上限を検証する(1〜10 など) | 「上位10000件」で結果が巨大になるのを防ぐ |
| ファイルパス・SQL・Pythonコード | 引数にしない | 生成AIが自由な文字列を渡せる箇所を作らない。読むファイルも実行する処理も、こちらで決める |
最後の行は「生成AIにコードを書かせて実行する」方式との違いでもあります。その方式は柔軟ですが、何が実行されるかを事前に決められません。Tool Calling は、実行できることをあらかじめ関数の一覧に限定することで、再現性と安全性を確保しています。
用語ミニ辞典
Pythonを書いている方でも、この分野で初めて見るかもしれない用語だけを挙げます。
Tool Calling(ツール呼び出し、Function Calling とも)
生成AIに、あらかじめ定義した関数の中から「呼ぶべきもの」と「その引数」をJSON形式で答えさせる仕組み。実行するのはアプリケーション側で、生成AIは計算しない。
ツール定義
関数の名前・説明・引数の仕様を、生成AIに渡すためにJSON形式で書いたもの。この記事の TOOLS。
JSON Schema
「このJSONはこういう形であるべき」を記述する書式。ツール定義の parameters はこれで書く。type・enum・required などの語彙を持つ。
strict モード
ツール定義に "strict": true を付けると、生成AIの返す引数がスキーマに厳密に従うようになる。引数はすべて required に入れ、additionalProperties: false を付けるのが決まり。
tool_calls
生成AIの応答に含まれる「関数を呼んでほしい」という要求のリスト。各要素に id・関数名・引数(JSON文字列)が入る。
tool ロール
会話の履歴で、関数の実行結果を生成AIに返すときのメッセージ種別。tool_call_id で「どの要求への結果か」を対応づける。
検証層
生成AIのツール要求を実行する前に、許可リスト・引数の形式・値の範囲を確かめる処理。この記事の validate。講座では ToolGuard と呼んでいる。
結果ID
関数の実行結果に付ける通し番号(R1 など)。説明文の数字がどの結果に基づくかを追跡するために使う。
まとめ
Tool Calling では、生成AIは計算しません。ツール定義を見て「どの関数を、どんな引数で呼ぶか」を決め、こちらのPythonが計算し、返ってきた要点だけを使って説明を書きます。
同じ質問に同じ数字が返るのは、計算しているのが仕様の固定された関数だからです。CSV本体を外に送らずに済むのは、送るのが372文字の集計結果だけだからです。あとから「その数字はどこから来たのか」を追えるのは、関数名・引数・結果IDが残るからです。
ただし、生成AIの要求をそのまま実行してはいけません。許可リスト・引数の形式・値の範囲を確かめる検証層を必ず挟み、ファイルパスやコードのような自由な文字列を引数にしない。生成AIに任せる範囲を、関数の一覧と引数の仕様で決める——それが Tool Calling の設計です。
次の記事では、ステップ5で返ってくる「説明」の側を扱います。文章の中の数字が本当に結果と一致しているかを、どう確かめるか。構造化出力と数値の検証がテーマです。
よくある質問
Q. Claude や Gemini でも同じことができますか?
できます。ツール定義の書き方と応答の取り出し方(接続層)だけが各社で少し違い、検証層・関数・結果の作り方はそのまま使えます。当社の講座では OpenAI 版をリファレンスにし、Claude 版・Gemini 版のNotebookも配布しています。
Q. API の料金はどれくらいかかりますか?
この記事の例では、1つの質問で生成AIを2回呼びます。送る文字数は合計でも2,000文字程度、返ってくる文章も数百文字なので、gpt-5.6-luna の公開料金(入力 100万トークンあたり 0.10ドル、出力 0.60ドル。2026年9月16日に公式ページで確認)に照らすと、1質問あたり1円に届きません。料金は変わることがあるので、実施前に公式ページでご確認ください。
Q. CSVのデータは外部に送られないのですか?
この記事の設計では、生成AIに送るのは「基準日やカテゴリ一覧などの前提条件」「質問文」「集計結果の要点(372文字)」の3つだけです。CSV本体は pd.read_csv で手元に読み込まれたきり、外に出ていません。ただし、result_for_ai に何を入れるかはこちらの設計次第なので、商品名や金額を外部サービスに送ってよいかは、社内のルールに照らして判断してください。
Q. 生成AIが間違った関数や引数を選んだらどうなりますか?<
検証層で止まります。検証に失敗した理由を生成AIに返して条件を直させるか、利用者に聞き直してもらいます。数字を作って埋めることはしません。関数が1つしかないこの記事の例では選び間違いは起きませんが、関数が増えると description の書き方が選択の精度を左右します。
Q. 関数を複数定義したら、生成AIは使い分けてくれますか?
TOOLS のリストに複数の関数を入れれば、質問に応じて選びます。「日別の推移を見たい」なら集計関数、「先週と比べたい」なら比較関数、というように、description に「どんな質問に向くか」を書き分けておくのがコツです。
付録:APIキーがないときの模擬クライアント
この記事のコードを、APIキーなしで最後まで動かすためのものです。本物と同じ形で応答を返すだけで、生成AIは使っていません。準備のところで client = OpenAI(...) の代わりに client = FakeClient() としてください。
以下、コードです。
from types import SimpleNamespace as NS

class FakeClient:
    """本物の client と同じ形(choices[0].message.tool_calls / .content)で応答を返す"""
    def __init__(self):
        self.chat = NS(completions=NS(create=self._create))

    def _create(self, model, messages, tools=None, tool_choice=None, **kw):
        if tools:   # 1回目:ツール要求を返す
            args = {"cur_start": "2026-08-24", "cur_end": "2026-08-30",
                    "prev_start": "2026-08-17", "prev_end": "2026-08-23", "category": None}
            call = NS(id="call_demo001", type="function",
                      function=NS(name="compare_periods",
                                  arguments=json.dumps(args, separators=(",", ":"))))
            msg = NS(role="assistant", content=None, tool_calls=[call])
        else:       # 2回目:ツール結果から説明文を組み立てる
            r = json.loads(messages[-1]["content"])
            z, d, u = r["全体"], r["減少上位"], r["増加上位"]
            msg = NS(role="assistant", tool_calls=None, content=(
                f"先週({r['期間']['当期']})の売上は{z['当期売上']:,}円で、"
                f"前週({r['期間']['前期']})の{z['前期売上']:,}円から"
                f"{abs(z['増減額']):,}円({z['増減率']}%)減少しました。\n"
                f"減少額が大きい商品は、{d[0]['商品名']}({d[0]['増減額']:,}円)、"
                f"{d[1]['商品名']}({d[1]['増減額']:,}円)、{d[2]['商品名']}({d[2]['増減額']:,}円)です。\n"
                f"一方で{u[0]['商品名']}(+{u[0]['増減額']:,}円)など増えた商品もあり、"
                f"全体の減少幅は減った商品の合計より小さくなっています。\n"
                f"(根拠:結果ID {r['result_id']})"))
        return NS(choices=[NS(message=msg)])
当社の講座では、これをもう少し本格的にした「模擬モード」(質問文を解釈して、本物と同じ形のツール要求を組み立てるルールベースの代替)を教材に同梱しています。APIキーがなくても全演習を最後まで進められるようにするためです。