- 問題
- 答え
- 解説
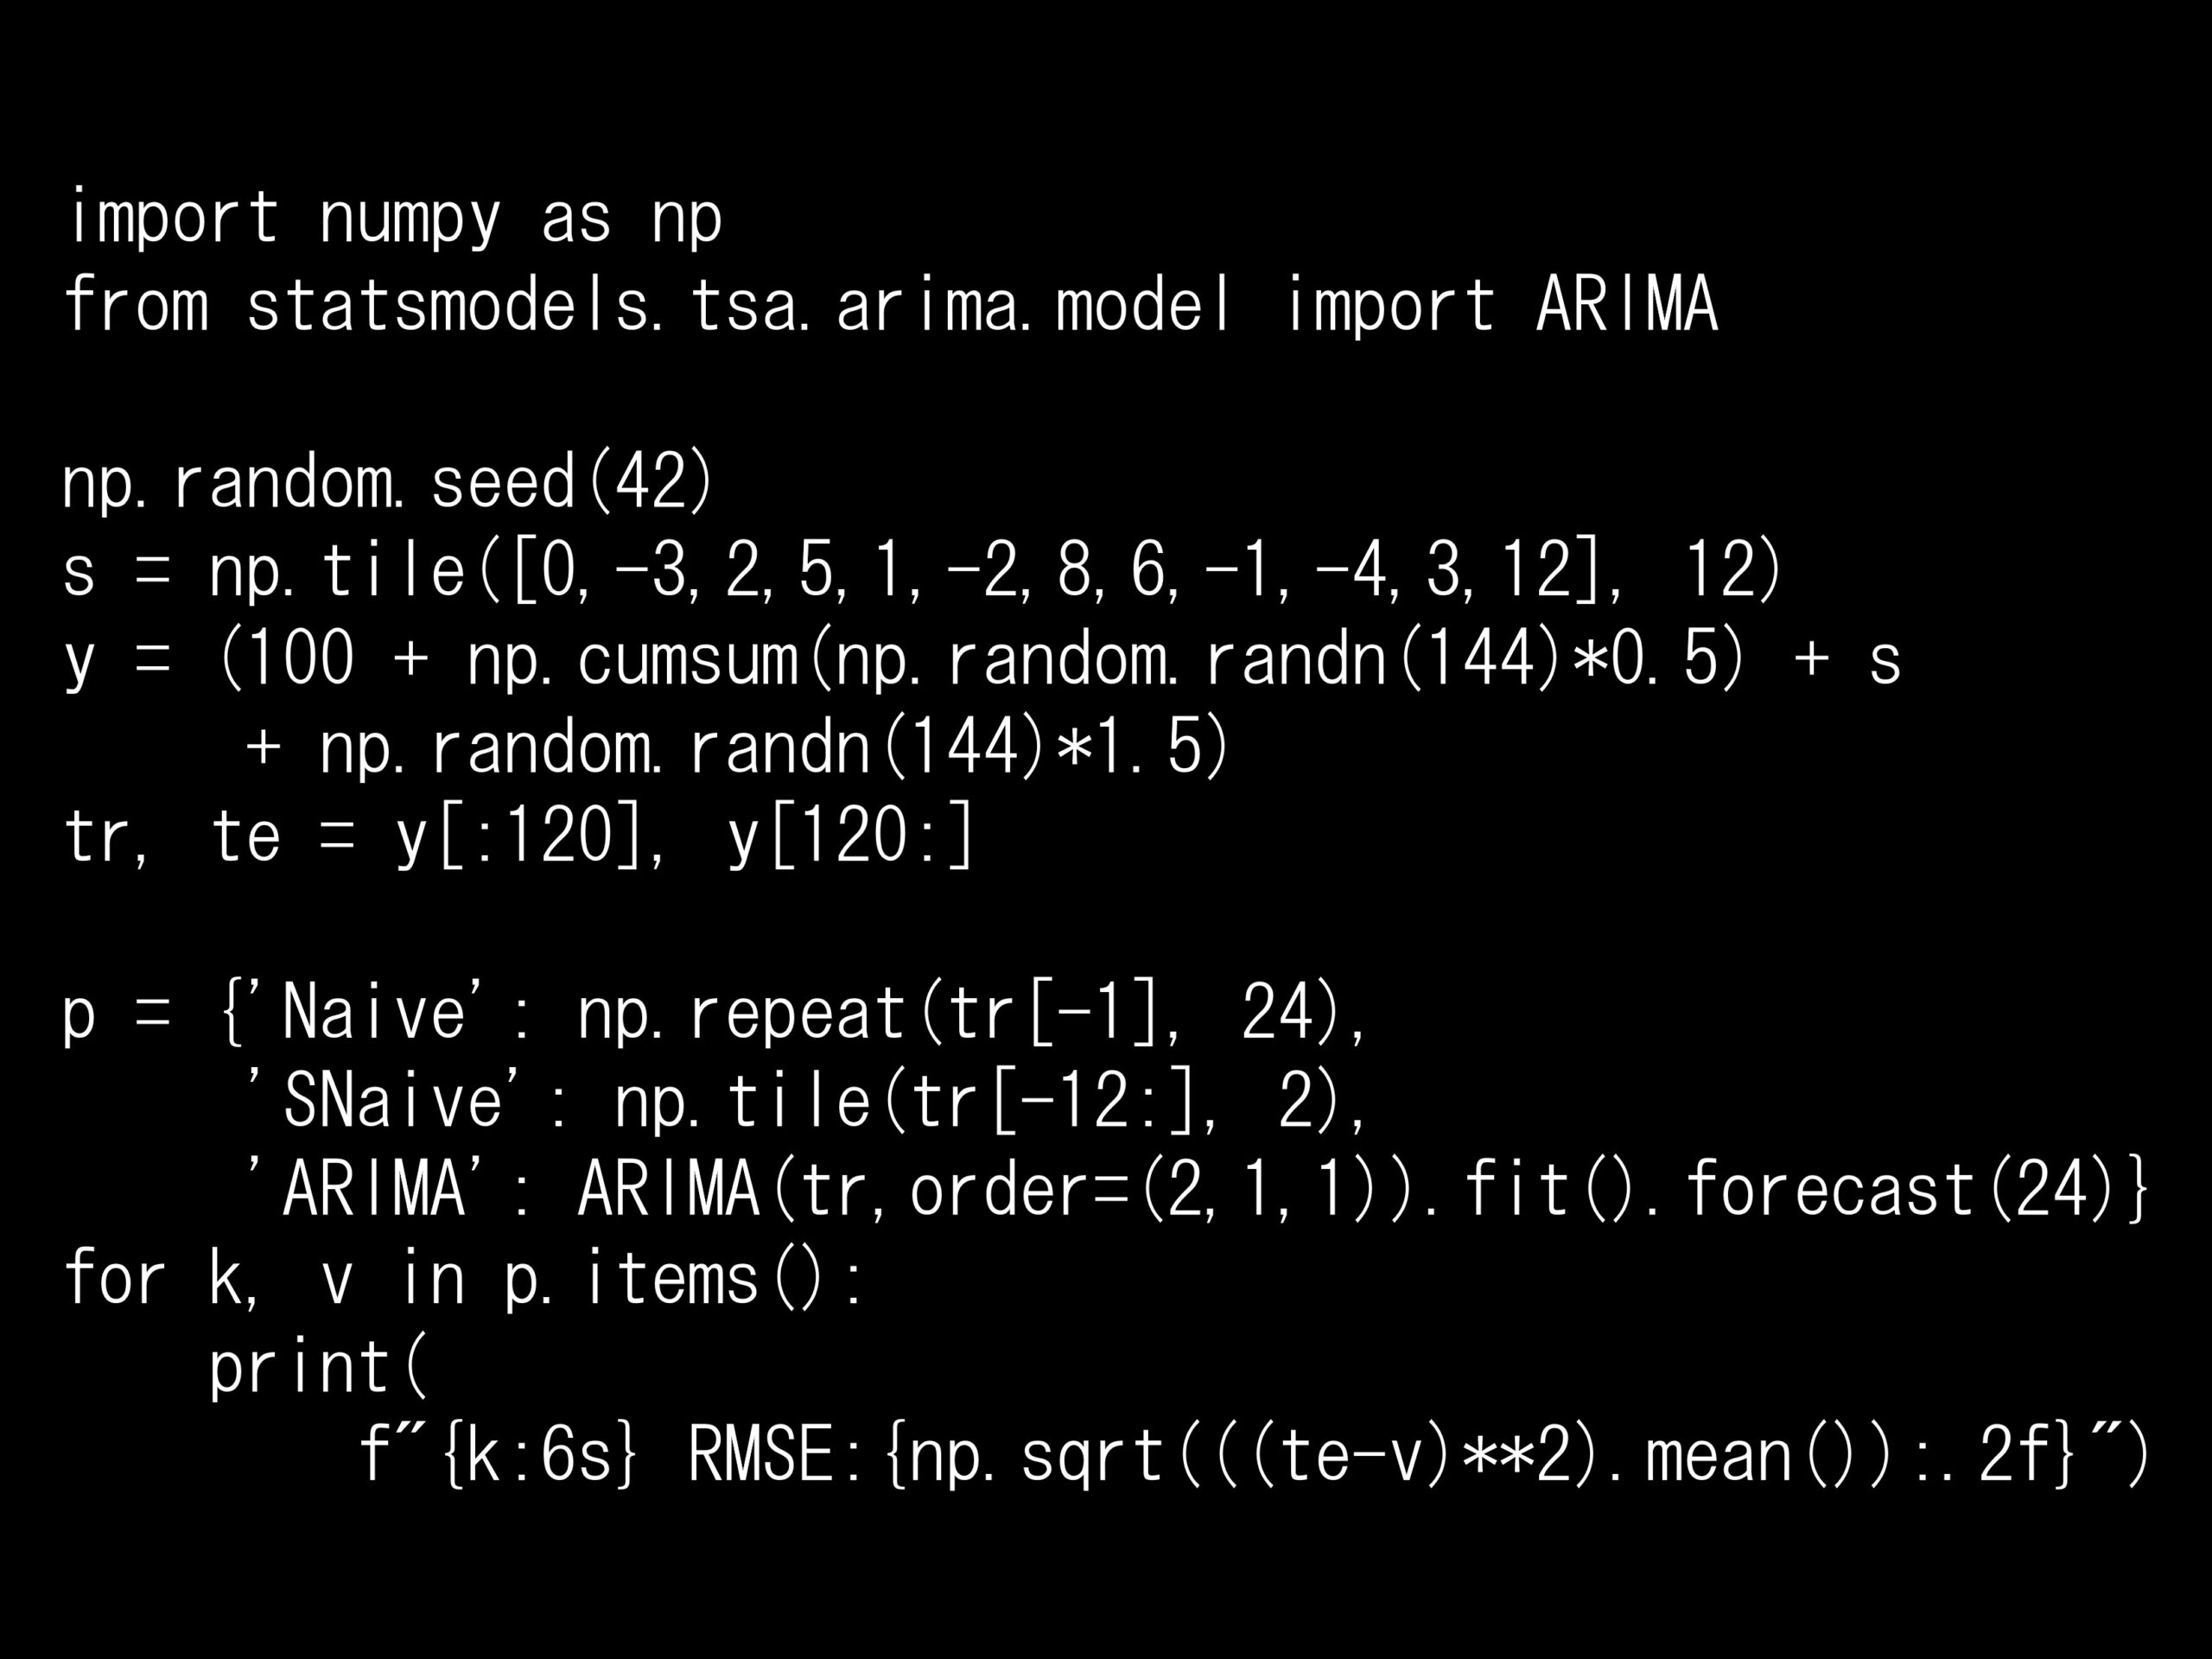
Naive と SNaive という2つの単純な予測も計算しています。これらを計算している目的として最も適切なものはどれですか?
Python コード:
import numpy as np
from statsmodels.tsa.arima.model import ARIMA

np.random.seed(42)
s = np.tile([0, -3, 2, 5, 1, -2, 8, 6, -1, -4, 3, 12], 12)
y = (100 + np.cumsum(np.random.randn(144)*0.5) + s
     + np.random.randn(144)*1.5)
tr, te = y[:120], y[120:]

p = {'Naive': np.repeat(tr[-1], 24),
     'SNaive': np.tile(tr[-12:], 2),
     'ARIMA': ARIMA(tr, order=(2,1,1)).fit().forecast(24)}
for k, v in p.items():
    print(f"{k:6s}  RMSE:{np.sqrt(((te - v)**2).mean()):.2f}")
回答の選択肢:
(A) ARIMAの予測値を補正するための入力として使うため
(B) 複雑なモデルの予測精度を相対的に評価するための基準とするため
(C) 予測区間の幅を計算するための材料とするため
(D) ARIMAの次数を決めるための参考値とするため
Naive   RMSE:9.86
SNaive  RMSE:2.91
ARIMA   RMSE:5.12
正解: (B)
Naive(直近の値をそのまま将来の予測とする)とSNaive(1周期前の同じ時期の値を予測とする)は、学習らしい学習をほとんど行わない最も単純な予測手法で、ベンチマーク(ベースライン)と呼ばれます。ARIMAのRMSE 5.12という数字だけを見ても、それが良いのか悪いのかは判断できません。Naiveと比べれば約半分に改善しており優秀に見えますが、SNaiveと比べると逆に大きく劣っています。つまりこのデータでは、「前年同月の値を使う」だけの手法にARIMAが負けており、複雑なモデルを使う意味がまだ示されていないことがわかります。単純な手法と比較して初めて、モデルの真の実力が見えてきます。
回答の選択肢:
(A) ARIMAの予測値を補正するための入力として使うため
(B) 複雑なモデルの予測精度を相対的に評価するための基準とするため
(C) 予測区間の幅を計算するための材料とするため
(D) ARIMAの次数を決めるための参考値とするため
- コードの解説
-
このコードは、季節性を持つデータに対して、2つの単純な予測手法とARIMAモデルの予測精度を比較しています。
import numpy as np
from statsmodels.tsa.arima.model import ARIMA

np.random.seed(42)
s = np.tile([0, -3, 2, 5, 1, -2, 8, 6, -1, -4, 3, 12], 12)
y = (100 + np.cumsum(np.random.randn(144)*0.5) + s
     + np.random.randn(144)*1.5)
tr, te = y[:120], y[120:]

p = {'Naive': np.repeat(tr[-1], 24),
     'SNaive': np.tile(tr[-12:], 2),
     'ARIMA': ARIMA(tr, order=(2,1,1)).fit().forecast(24)}
for k, v in p.items():
    print(f"{k:6s}  RMSE:{np.sqrt(((te - v)**2).mean()):.2f}")
詳しく説明します。
ライブラリのインポート
numpy:数値計算を行うためのライブラリ。データ生成、単純予測の作成、RMSEの計算に使用しています。statsmodels.tsa.arima.model.ARIMA:ARIMAモデルを構築するクラスです。
データの生成
s = np.tile([...], 12):12ヶ月分の季節パターンを12年分繰り返しています。12月(最後の要素)に大きなピークがあるなど、サイン波のような滑らかな形ではない不規則な季節性です。np.cumsum(np.random.randn(144)*0.5):小さなランダムウォークで、水準がゆっくり漂う動きを表しています。tr, te = y[:120], y[120:]:前半10年分(120ヶ月)で学習し、後半2年分(24ヶ月)を予測対象にしています。
3つの予測
Naive:np.repeat(tr[-1], 24)。学習データの最後の値を、24ヶ月間ずっと予測値とします。SNaive:np.tile(tr[-12:], 2)。直近12ヶ月の値をそのまま繰り返します。「来年の1月は今年の1月と同じ」という予測です。ARIMA:ARIMA(2,1,1)モデルで24ヶ月先まで予測します。季節項を持たないため、不規則な季節パターンを十分に捉えられません。
- 選択肢の解説
-
(A) ARIMAの予測値を補正するための入力として使うため → ×
コードでは、NaiveとSNaiveの予測値はARIMAの学習にも予測にも一切使われていません。それぞれ独立にRMSEを計算しているだけです。予測を組み合わせる手法(アンサンブル)は存在しますが、このコードはそれを行っていません。(B) 複雑なモデルの予測精度を相対的に評価するための基準とするため → ○
正解です。RMSEなどの誤差指標は、単独では「良い」「悪い」を判断できません。単純な手法との比較によって初めて、複雑なモデルが手間に見合う価値を持つかどうかがわかります。(C) 予測区間の幅を計算するための材料とするため → ×
予測区間はモデル自身の誤差分散から計算するもので、ARIMAであればget_forecast().conf_int()で得られます。単純予測の値は予測区間の計算には使いません。(D) ARIMAの次数を決めるための参考値とするため → ×
ARIMAの次数は、ACF・PACFや情報量基準(AIC・BIC)で決めます。単純予測の精度は次数の決定には使われません。ただし、ベンチマークに負けたことをきっかけにモデルの見直し(季節項の追加など)を検討することはあります。 - 「RMSE 5.12」は良いのか悪いのか
-
予測モデルを作ったとき、「テストデータでのRMSEが5.12でした」と報告されたとします。これは良い結果でしょうか。
答えは「それだけではわからない」です。RMSEの大きさはデータのスケールやノイズの量に依存するため、絶対的な基準がありません。判断するには比較対象が必要です。
今回の出力で、比較対象を変えるとARIMAの評価がどう変わるかを見てみます。
比較対象 比較対象のRMSE ARIMA(5.12)の評価 比較なし - 判断不能 Naive 9.86 誤差を約半分に削減。優秀に見える SNaive 2.91 誤差が約1.8倍。単純な手法に負けている Naiveとだけ比較して「ARIMAで精度が大幅に改善した」と結論づけるのは危険です。季節性のあるデータでは、Naiveは季節変動を完全に無視するため、比較対象としては弱すぎます。データの性質に合った単純手法をベンチマークに選ぶことが重要です。
- 代表的なベンチマーク手法
-
時系列予測でよく使われる単純な手法は次の4つです。いずれも推定するパラメータがほとんどなく、数行で実装できます。
ナイーブ法(Naive)
最後の観測値をそのまま将来の予測とします。$$
\hat{y}_{T+h} = y_T
$$ランダムウォークに近いデータ(株価、為替など)では非常に強力で、多くの複雑なモデルがこれに勝てません。
季節ナイーブ法(Seasonal Naive)
1周期前の同じ時期の値を予測とします。$$
mは季節周期です。月次データなら「前年同月の値」を使うことになります。季節性の強いデータでは最有力のベンチマークです。
\hat{y}_{T+h} = y_{T+h-m}
$$平均法(Mean)
学習データ全体の平均値を予測とします。定常で水準が安定したデータのベンチマークになります。ドリフト法(Drift)
最初と最後の観測値を結んだ直線を延長します。$$
\hat{y}_{T+h} = y_T + h \cdot \frac{y_T – y_1}{T – 1}
$$トレンドのあるデータのベンチマークになります。
データの特徴(トレンドの有無、季節性の有無)に応じて、該当するベンチマークを複数並べて比較するのが一般的です。
- なぜ複雑なモデルが負けるのか
-
今回ARIMAがSNaiveに負けた理由は、主に次の2点です。
モデルの仮定がデータと合っていない
ARIMA(2,1,1)には季節項がありません。AR項である程度の周期性は表現できますが、12月に大きなピークがあるような不規則な季節パターンを捉えるのは困難です。一方SNaiveは、季節パターンの形を一切仮定せず、前年の値をそのまま使うため、どんな形の季節性でも再現できます。学習データへの当てはまりと予測精度は別物
ARIMAはパラメータを推定してデータに合わせにいくため、一見するとより「賢い」手法に見えます。しかし、推定したパラメータが将来も通用する保証はありません。パラメータが多いほど推定誤差や過学習のリスクも増えます。単純な手法は仮定が少ない分、大きく外れにくいという強みがあります。国際的な予測コンペティション(M3・M4コンペティションなど)でも、複雑な手法が単純な手法に勝てないケースが繰り返し報告されてきました。「高度なモデルほど精度が高い」とは限らないことは、予測分野ではよく知られた事実です。
今回のケースであれば、季節項を加えたSARIMAや、季節性を扱えるHolt-Winters法を試し、それがSNaiveを上回るかを確認するのが次のステップになります。
- ベンチマークを使った評価指標
-
ベンチマークとの比較を1つの数値で表す評価指標もあります。代表的なのがMASE(Mean Absolute Scaled Error: 平均絶対スケール誤差)です。
$$
\text{MASE} = \frac{\text{予測のMAE}}{\text{学習データにおける季節ナイーブ法のMAE}}
$$分母は、学習データ上で季節ナイーブ法(季節性がなければナイーブ法)を使った場合の平均絶対誤差です。
- MASE < 1:ベンチマーク(学習データ上の単純手法)より良い
- MASE > 1:ベンチマークより悪い
今回のデータで計算すると、ARIMAのMASEは1.67、SNaiveは1.14、Naiveは3.92でした。ARIMAは1を大きく上回っており、単純手法の水準に届いていないことが1つの数字で読み取れます。MASEはスケールに依存しないため、単位や規模の異なる複数の系列で予測精度を比較・平均できます。また、MAPEと異なり実測値が0でも計算できるという利点があります。
- 実務での注意点
-
最初にベンチマークを作る
モデル構築に取りかかる前に、まず単純な手法での精度を出しておくのが良い習慣です。これが「最低限超えるべきライン」になります。数時間かけて作ったモデルが前年同月の値に負けていた、という事態を早い段階で防げます。複数のベンチマークを並べる
NaiveとSNaiveのように、性質の異なる単純手法を複数用意し、その中で最も良いものを基準にします。弱いベンチマークだけと比較すると、モデルの実力を過大評価してしまいます。勝てなければ単純手法を採用する
複雑なモデルがベンチマークに勝てないなら、単純手法をそのまま採用するのも立派な判断です。単純手法は計算が速く、説明が容易で、保守の手間もかかりません。関係者に説明する際も「前年同月の実績をもとにしています」の方が伝わりやすいことが多いです。勝ったとしても差を確認する
ベンチマークをわずかに上回った程度であれば、その差が偶然の範囲かもしれません。複数の期間や系列で評価し、安定して上回るかを確認します。改善幅が小さい場合は、複雑さに見合う価値があるかも検討します。
