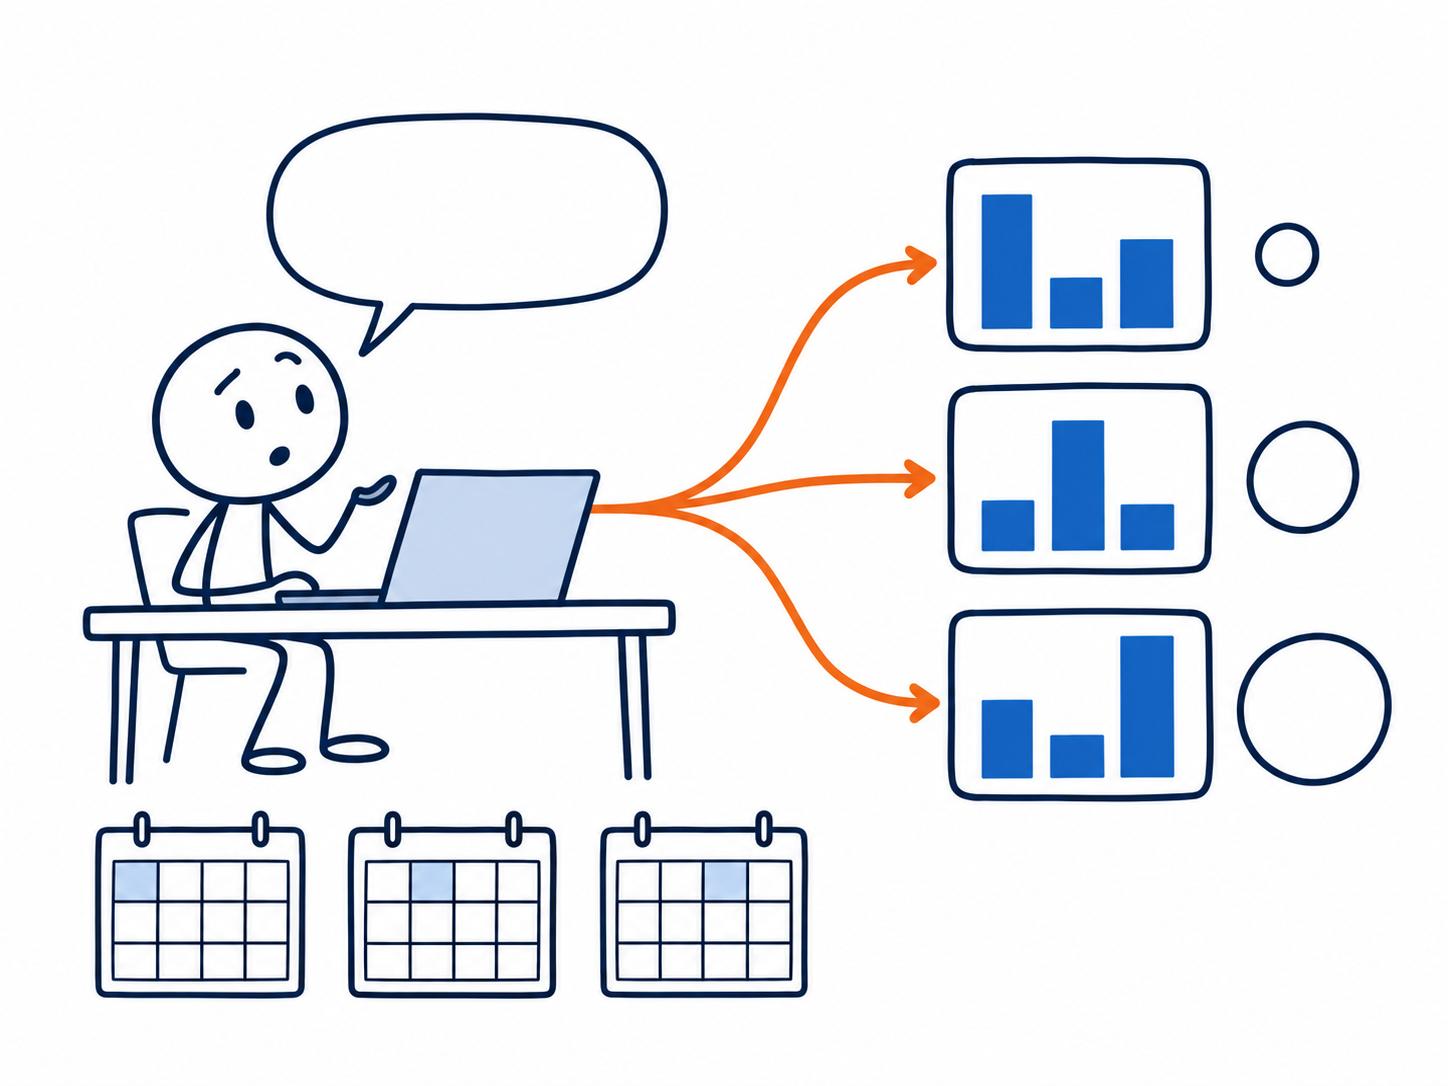
生成AIのチャット画面にCSVを添付して、「先週から売上が落ちた商品を教えて」と頼む。数秒で、それらしい表と説明が返ってくる。便利です。
ところが、同じ質問を翌日もう一度すると、違う商品名と違う金額が返ってくる。3回目はまた違う。報告に使おうとした矢先に、どの数字を信じればいいのか分からなくなる——そんな経験をした方は少なくないはずです。
結論を先に書きます。数字が変わるのは生成AIの性能の問題ではありません。質問に書かれていない条件を、生成AIが毎回その場で決めているからです。そして、その条件は4つに整理できます。
この記事を読み終えると、次のことができるようになります。
- 同じデータ・同じ質問で、答えが3通りになる様子(実際の数字で確認します)
- CSV分析で必ず指定すべき4つの条件——期間・対象・指標・出力形式
- その4条件を、毎回書く代わりに関数の引数として固定する方法(Pythonのコードを段階ごとに分け、実行結果まで載せています)
- では生成AIには何をさせるのか、という役割分担

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
同じ質問を3回して、3つの答えが返ってきた
田中さんの週次報告
小売店A社の営業企画を担当する田中さんは、毎週月曜に店長向けの週次報告を作っています。売上はどう変わったか、どの商品を確認すべきか、次に何を調べるか。
手元のデータは、日別・商品別のPOS集計です。20商品が62日分で1,240行。列は「日付・曜日・商品名・カテゴリ・単価・数量・売上金額」の7つ。データの最終日は2026年8月31日(月曜)です。
この記事で使うCSVをダウンロードできます
記事に出てくる数字とコードは、すべて次のサンプルCSVで再現できます。手元で実行しながら読み進めてください。
pos_sales_sample.csv をダウンロード
POS売上サンプルデータ(20商品×62日=1,240行・BOM付きUTF-8・約64KB)
BOM付きUTF-8で保存してあるので、Excelでダブルクリックしても文字化けしません。Pythonから読むときは encoding="utf-8-sig" を指定してください。
3回聞いて、3つの答え
田中さんは生成AIのチャットにこのCSVを渡し、こう聞きました。
先週から売上が落ちた商品は?
1回目の答えは「ハンバーグ弁当が約3万2千円減少しています」。
翌日、同じ質問をすると「明太子おにぎりが最も減少しています(−30,600円)」。
3回目は「先週は全体的に売上が減少傾向で、特に弁当カテゴリが……」。
どれも嘘ではありません。ただ、報告に載せられる数字ではありません。
「先週」の取り方を変えるだけで、答えは3通りになる
何が起きているのか。いちばん効いているのは「先週」という言葉です。
データの最終日は8月31日・月曜。この状況で「先週」と言われたとき、少なくとも3つの取り方があります。
- 月曜〜日曜:8月24日〜30日(最終日の直前の月〜日)
- 直近7日間:8月25日〜31日(最終日を含む7日間)
- 日曜〜土曜:8月23日〜29日(週の始まりを日曜とする流儀)
どれも「先週」として自然な解釈です。そして、それぞれで前の週と比べると、こうなります。
| 「先週」の取り方 | 当期 | 前期 | 全体の増減額 | 増減率 | 減少額1位 |
|---|---|---|---|---|---|
| 月曜〜日曜 | 8/24〜8/30 | 8/17〜8/23 | −12,930円 | −2.0% | ハンバーグ弁当 −31,900円 |
| 直近7日間 | 8/25〜8/31 | 8/18〜8/24 | −8,200円 | −1.3% | ハンバーグ弁当 −24,200円 |
| 日曜〜土曜 | 8/23〜8/29 | 8/16〜8/22 | −24,490円 | −3.8% | ハンバーグ弁当 −31,350円 |
同じデータ、同じ「先週から売上が落ちた商品は?」という質問です。それでも全体の減少額は −8,200円から−24,490円まで、約3倍の幅で変わります。1日ずらすだけで比較する期間の曜日構成が変わり、売れ方の違う曜日が入れ替わるからです。
減少額1位はたまたま3通りとも同じ商品でしたが、金額は −24,200円から −31,900円まで動きます。店長に「先週は2万4千円のマイナスでした」と報告するか「3万2千円です」と報告するかは、期間の取り方だけで決まってしまいます。
なぜこうなるのか
生成AIは、質問に書かれていない条件を空欄のまま計算することができません。何かに決めなければ計算できないので、その場でもっともらしい値を選びます。選び方は毎回同じとは限りません。
つまり、答えが変わったのではなく、毎回違う質問に答えていたのです。
これは性能が上がれば解決する種類の問題ではありません。「先週」がいつからいつまでかは、データの中にも生成AIの中にもなく、業務のルールとして決まっているものだからです。
CSV分析で指定すべき4つの条件
CSVの集計を再現可能にするには、質問を「期間」「対象」「指標」「出力形式」の4つの条件に分解して指定します。 この4つが決まれば、誰が計算しても、何回計算しても、同じ数字になります。
順に、何を決めるのかと、決めなかった場合にどれくらい答えがぶれるのかを見ていきます。
① 期間 ― いつからいつまでか
開始日と終了日を決めます。両端を含むかどうかも決めます。比較なら、当期と前期の両方です。
「先週」「今月」「直近」のような相対表現を使う場合は、どの日を基準にして解決するかを必ず書きます。ここで実行日(今日)を基準にしてしまうと、同じNotebookを翌日開いただけで結果が変わります。データの最終日など、動かない日を基準日にするのが安全です。
- 指定しないと:さきほどの表のとおり −8,200円 〜 −24,490円 の幅でぶれます
② 対象 ― どの商品・カテゴリを含めるか
全商品なのか、特定のカテゴリだけなのか。絞り込みが複数あるとき、それはANDなのかORなのか。
同じ期間(8/24〜30 vs 8/17〜23)でも、対象を変えるとこうなります。
| 対象 | 当期売上 | 前期売上 | 増減額 | 増減率 |
|---|---|---|---|---|
| 全20商品 | 635,010円 | 647,940円 | −12,930円 | −2.0% |
| 弁当カテゴリのみ | 279,290円 | 289,290円 | −10,000円 | −3.5% |
| おにぎりカテゴリのみ | 130,330円 | 147,250円 | −16,920円 | −11.5% |
| デザートカテゴリのみ | 74,720円 | 61,720円 | +13,000円 | +21.1% |
「先週は落ちました」も「先週は伸びました」も、対象の取り方次第で両方言えてしまいます。
- 指定しないと:マイナス2.0%とプラス21.1%が同じデータから出ます
③ 指標 ― 何で測り、何で並べるか
売上金額で見るのか、数量で見るのか。減少額で並べるのか、減少率で並べるのか。小数はどこで丸めるのか。前期の売上が0だったとき、増減率はどう扱うのか(0で割れないので「算出不能」とするのが素直です)。
同じ期間・同じ対象でも、並べ方を変えると1位が入れ替わります。
| 順位 | 増減額の小さい順 | 増減率の小さい順 |
|---|---|---|
| 1位 | ハンバーグ弁当 −31,900円(−42.6%) | 明太子おにぎり −77.7%(−30,600円) |
| 2位 | 明太子おにぎり −30,600円(−77.7%) | ハンバーグ弁当 −42.6%(−31,900円) |
| 3位 | 麦茶 −8,540円(−27.5%) | 麦茶 −27.5%(−8,540円) |
| 4位 | から揚げ弁当 −6,240円(−8.7%) | 杏仁豆腐 −25.4%(−3,000円) |
「いちばん落ちた商品」は、額で見ればハンバーグ弁当、率で見れば明太子おにぎりです。どちらが正しいということはなく、何を知りたいかで選ぶものです。金額インパクトを見たいなら額、売れ方の異常を見つけたいなら率。決めずに聞けば、そのときどちらかが返ってきます。
- 指定しないと:1位の商品が入れ替わります
④ 出力形式 ― 何を返すか
商品を1つ挙げるのか、上位3件か、表全体か。全体の数値も一緒に出すのか。
ここが抜けると、数字そのものは正しいのに読み違いが起きます。
減少した上位3商品の増減額を足してみます。ハンバーグ弁当 −31,900円、明太子おにぎり −30,600円、麦茶 −8,540円で、合計 −71,040円。ところが全体の増減額は −12,930円 です。5倍以上ちがいます。
理由は、増えた商品が相殺しているからです。この週は幕の内弁当が +19,140円、鮭おにぎりが +12,960円、アイスバーが +12,360円、コーヒーが +11,960円と伸びていました。減った商品の合計は −84,960円、増えた商品の合計は +72,030円。差し引きで −12,930円になります。
出力形式に「全体の増減額も付ける」と指定していなければ、報告書には減った商品だけが並びます。それを見た店長が「先週は7万円落ちたのか」と受け取っても、無理はありません。
- 指定しないと:−71,040円と−12,930円を取り違えます
4条件を入れて、質問を書き直す
4つを全部入れると、質問はこうなります。
基準日は2026-08-31。当期を8月24日〜30日、前期を8月17日〜23日として(両端を含む)、全カテゴリの商品別売上金額を比較してください。増減額(当期−前期)の小さい順に表で示し、全体の増減額と増減率も付けてください。
長い。しかし、この質問の答えは一つに決まります。
当期 635,010円、前期 647,940円、全体で −12,930円(−2.0%)。減少額の大きい順に、ハンバーグ弁当 −31,900円、明太子おにぎり −30,600円、麦茶 −8,540円。
誰が何回聞いても、この数字です。
条件を「毎回書く」代わりに、関数の引数にする
とはいえ、毎週この長い質問文を書くのは続きません。書き写すうちに1文字変わって、また数字がずれます。
田中さんが実際にやったのは、4条件を関数の引数にすることでした。一度決めてしまえば、次からは日付を渡すだけで済みます。
ここからPythonのコードが出てきます。いきなり完成形を見せると長いので、5段階に分けます。使うのは pandas というライブラリで、df という名前で「表そのもの」を扱います。Excelのシート1枚が変数に入っているとイメージしてください。
先ほどダウンロードしたCSVと同じフォルダで、順に実行していけば同じ結果になります。
ステップ0:CSVを読み込む
以下、コードです。
import pandas as pd

# 日本語を含む表を表示したときの桁ずれを防ぐ(計算結果には影響しません)
pd.set_option("display.unicode.east_asian_width", True)

df = pd.read_csv("pos_sales_sample.csv", encoding="utf-8-sig")
print(df.shape)
print(df.head())
encoding="utf-8-sig"は、Excel向けにBOM付きで保存されたCSVを読むときの指定です。これを付けないと、1列目の名前が「日付」ではなく、先頭に見えない文字が付いた別の名前として読み込まれ、df["日付"]がエラーになりますdf.shapeは(行数, 列数)を返しますdf.head()は先頭5行です
以下、実行結果です。
(1240, 7)
         日付 曜日            商品名  カテゴリ  単価  数量  売上金額
0  2026-07-01   水        鮭おにぎり  おにぎり   180    30      5400
1  2026-07-01   水        梅おにぎり  おにぎり   150    18      2700
2  2026-07-01   水  ツナマヨおにぎり  おにぎり   180    29      5220
3  2026-07-01   水      昆布おにぎり  おにぎり   150    19      2850
4  2026-07-01   水    明太子おにぎり  おにぎり   200    30      6000
日付は 2026-07-01 のような文字列として読み込まれます。この形式は「文字の並び順=日付の順」になるので、日付に変換しなくてもそのまま大小比較ができます。次のステップでこれを使います。
ステップ1:期間で絞る
以下、コードです。
cur  = df[(df["日付"] >= "2026-08-24") & (df["日付"] <= "2026-08-30")]
prev = df[(df["日付"] >= "2026-08-17") & (df["日付"] <= "2026-08-23")]

print(len(df), "行 →", len(cur), "行")
print(cur["日付"].min(), "〜", cur["日付"].max())
df["日付"]は「日付」列だけを取り出したもの。これを>= "2026-08-24"と比べると、行数と同じ長さの True / False の並びが返ってきます&は「かつ」。Pythonのandではなく&を使い、条件それぞれを丸カッコで囲むのが pandas の書き方です- その True / False の並びを
df[ ... ]の角カッコに入れると、True の行だけが残った表が返ってきます
以下、実行結果です。
1240 行 → 140 行
2026-08-24 〜 2026-08-30
20商品 × 7日 = 140行。狙ったとおりに絞れています。
ステップ2:商品別に合計する
以下、コードです。
a = cur.groupby("商品名")["売上金額"].sum()
b = prev.groupby("商品名")["売上金額"].sum()

print(a.head())
groupby("商品名")は Excel のピボットテーブルに当たります。商品名ごとに行をグループ分けします["売上金額"]で合計したい列を選び、.sum()で足し上げます- 結果は「商品名 → 合計額」という1列だけの表です(pandas では Series と呼びます)
以下、実行結果です。
商品名
から揚げ弁当        65520
のり弁当            63450
アイスバー          24840
オレンジジュース    21920
コーヒー            42250
Name: 売上金額, dtype: int64
ステップ3:当期と前期を突き合わせて引き算する
以下、コードです。
table = (a.to_frame("当期売上")
          .join(b.to_frame("前期売上"), how="outer")
          .fillna(0).astype(int))
table["増減額"] = table["当期売上"] - table["前期売上"]

print(table.sort_values("増減額").head())
to_frame("当期売上")は、1列だけの表に「当期売上」という列名を付けて、普通の表にしますjoin(...)は商品名をキーにして横に並べます。how="outer"は「どちらか片方にしかない商品も残す」という意味です。当期に新発売された商品や、先週で販売終了した商品を落とさないために必要ですfillna(0)は、片方にしかない商品の空欄を0に。astype(int)で整数にしますtable["増減額"] = ...の行は、列どうしをそのまま引き算しています。forループを書かなくても、pandasが行ごとに計算してくれます
以下、実行結果です。
                当期売上  前期売上  増減額
商品名
ハンバーグ弁当     42900     74800  -31900
明太子おにぎり      8800     39400  -30600
麦茶               22540     31080   -8540
から揚げ弁当       65520     71760   -6240
杏仁豆腐            8800     11800   -3000
記事の前半で見た数字が、そのまま出てきました。
ステップ4:4条件を引数にした関数にまとめる
以下、コードです。
def compare_periods(df, cur_start, cur_end, prev_start, prev_end, category=None):
    """当期と前期の売上金額を商品別に比較する。期間は両端を含む。
    増減率は前期売上が正のときだけ計算する(前期0なら算出不能)"""
    cur  = df[(df["日付"] >= cur_start)  & (df["日付"] <= cur_end)]
    prev = df[(df["日付"] >= prev_start) & (df["日付"] <= prev_end)]
    if category:
        cur, prev = cur[cur["カテゴリ"] == category], prev[prev["カテゴリ"] == category]

    a = cur.groupby("商品名")["売上金額"].sum()
    b = prev.groupby("商品名")["売上金額"].sum()
    table = (a.to_frame("当期売上").join(b.to_frame("前期売上"), how="outer")
              .fillna(0).astype(int))
    table["増減額"] = table["当期売上"] - table["前期売上"]

    assert table["増減額"].sum() == a.sum() - b.sum()   # 内訳の合計=全体の増減額
    return table.sort_values("増減額")


result = compare_periods(df, "2026-08-24", "2026-08-30", "2026-08-17", "2026-08-23")
print(result.head())
print("当期合計:", result["当期売上"].sum())
print("前期合計:", result["前期売上"].sum())
print("全体の増減額:", result["増減額"].sum())
以下、実行結果です。
                当期売上  前期売上  増減額
商品名
ハンバーグ弁当     42900     74800  -31900
明太子おにぎり      8800     39400  -30600
麦茶               22540     31080   -8540
から揚げ弁当       65520     71760   -6240
杏仁豆腐            8800     11800   -3000
当期合計: 635010
前期合計: 647940
全体の増減額: -12930
対象を絞りたいときは category を渡すだけです。
以下、コードです。
dessert = compare_periods(df, "2026-08-24", "2026-08-30",
                          "2026-08-17", "2026-08-23", category="デザート")
print("デザートのみ 全体の増減額:", dessert["増減額"].sum())
以下、実行結果です。
デザートのみ 全体の増減額: 13000
全体ではマイナスでも、デザートだけ見ればプラスです。記事の前半で表にした「対象を変えると答えが変わる」が、引数ひとつで再現できました。
4条件が、どこに入ったかを確認します。
| 条件 | コードのどこにあるか |
|---|---|
| 期間 | 引数 cur_start, cur_end, prev_start, prev_end |
| 対象 | 引数 category(省略時は全商品) |
| 指標 | 「売上金額」を集計し、「増減額」列を作る部分 |
| 出力形式 | 商品別の表を増減額の小さい順に並べて返す部分 |
条件が関数の仕様として固定されたので、誰が呼んでも同じ結果になります。
最後から2行目の assert は、「商品別の増減額を全部足したものが、全体の増減額と一致するか」を確認しています。一致しなければ、その場でプログラムが止まります。さきほどの「−71,040円と−12,930円」の取り違えを、コードの側で見張っている行です。
assert 条件式は、条件が成り立たないときにエラーを出して止める文です。「ここは必ずこうなっているはず」という前提を、コメントではなくコードとして書き残せます。
「先週」を日付に直す部分も関数にする
期間の解決も、頭の中でやらずに関数にします。
以下、コードです。
from datetime import date, timedelta

def resolve_last_week(base_date: str):
    """基準日の直前の月曜〜日曜を返す。実行日には置き換えない"""
    b = date.fromisoformat(base_date)
    monday = b - timedelta(days=b.weekday())   # 基準日を含む週の月曜
    s = monday - timedelta(days=7)             # その1週間前の月曜
    return s.isoformat(), (s + timedelta(days=6)).isoformat()

print(resolve_last_week("2026-08-31"))
以下、実行結果です。
('2026-08-24', '2026-08-30')
大事なのは base_date を引数で受け取ることです。関数の中で date.today() を呼んでしまうと、同じNotebookを翌日開いただけで結果が変わります。基準日は画面に表示して、そこから解決する。こうしておけば、3か月後に同じコードを実行しても同じ答えが出ます。
では、生成AIの役割は何か
ここまで読むと、「結局Pythonで書くなら、生成AIは要らないのでは」と思われるかもしれません。
要らなくなったのではなく、役割が変わります。
生成AIに計算をさせるのをやめて、質問を4条件に分解し、どの関数をどんな引数で呼ぶかを決める役割を任せます。
「先週から売上が落ちた商品は?」という日本語を、
以下、コードです。
compare_periods(
    df,
    cur_start="2026-08-24", cur_end="2026-08-30",
    prev_start="2026-08-17", prev_end="2026-08-23",
    category=None,
)
という呼び出しに翻訳する仕事です。計算はPythonの関数が行い、返ってきた数字の説明を生成AIが書く。
この分担にすると、こうなります。
- 数字は毎回同じ(計算しているのは関数なので)
- 根拠の表が手元に残る(あとから確認できる)
- 「先週」の解釈は基準日から一意に決まる
- 生成AIに渡すのはデータ本体ではなく、データの概要と集計結果だけで済む
この「日本語の質問から、呼ぶべき関数と引数を決めさせる」仕組みは Tool Calling と呼ばれます。次の記事で、実際のコードとともに扱います。
用語ミニ辞典
Pythonを書いている方でも、この分野では初めて見るかもしれない用語だけを挙げます。
基準日(きじゅんび)
「先週」「今月」のような相対表現を、具体的な日付に直すときの起点となる日。実行日(今日)ではなく、データの最終日など動かない日を使うと、いつ実行しても同じ結果になります。
相対表現の解決
「先週」という言葉を「2026-08-24〜2026-08-30」という日付の範囲に変換すること。基準日と、週の始まりを何曜日とするかのルールが必要です。
Tool Calling(ツール呼び出し)
生成AIに、あらかじめ定義しておいた関数の中から「呼ぶべきもの」と「その引数」をJSON形式で答えさせる仕組み。実際に関数を実行するのは生成AIではなくアプリケーション側です。「計算させる」のではなく「関数を選ばせる」ための仕掛けです。
構造化出力
生成AIの回答を自由な文章ではなく、決めた形のJSONで受け取ること。「結論」「事実」「仮説」のように項目を分けておくと、中の数字をプログラムで照合できるようになります。
根拠表(こんきょひょう)
回答の元になった集計結果の表そのもの。説明文とセットで残しておくと、数字が合わないときにどこで食い違ったかを追えます。
まとめ
生成AIにCSVを渡して「分析して」と頼むと数字が変わるのは、質問に含まれていない条件——期間・対象・指標・出力形式——を生成AIが毎回その場で決めているからです。
同じデータ・同じ質問でも、「先週」の取り方だけで全体の増減額は −8,200円から−24,490円まで動きます。対象を変えれば −2.0%にも +21.1%にもなり、並べ方を変えれば1位の商品が入れ替わり、全体を出さなければ −71,040円と −12,930円を取り違えます。
4条件を指定すれば、答えは一つに決まります。ただし毎回人が書くのは続かないので、4条件を関数の引数として固定し、生成AIには「どの関数をどんな引数で呼ぶか」の判断を任せる。これが「数字はPython、説明は生成AI」という分担です。
よくある質問
Q. 生成AIの性能が上がれば、条件を指定しなくても安定しますか?
「先週」の定義のように、そもそもデータの中に答えがない条件は、性能が上がっても揺れます。業務のルールとして外から与えるしかありません。
Q. 4条件を毎回プロンプトに書けばよいのでは?
単発の分析ならそれで十分です。毎週の定型報告のように繰り返すなら、関数の引数として固定するほうが、再現性でも確認のしやすさでも勝ります。引数なら「今回は何を指定したか」が記録として残ります。
Q. Excelの集計でも同じことが言えますか?
言えます。SUMIFSの条件範囲が「期間」と「対象」、合計する列が「指標」、ピボットテーブルの配置が「出力形式」に当たります。資料ごとに「先週」の範囲が違っていて会議で数字が合わない、というのは同じ構図です。4条件をシートの先頭にセルとして置き、数式からそのセルを参照するのが最初の一歩です。
Q. 生成AIにデータを渡すのが不安です
Tool Callingの設計では、生成AIに渡すのはデータ本体ではなく、データの概要(期間・商品一覧など)と、集計結果の一部だけです。元のCSVを丸ごと送る必要はありません。次の記事で具体的に扱います。
Q. assert を入れると、本番で止まってしまいませんか?
止まるべきところで止めるための行です。商品別の合計と全体が合わないのは、期間の絞り込みか結合の仕方が壊れているということなので、そのまま報告に進むほうが危険です。運用では、止める代わりに警告として記録する形に変えることもあります。