Pythonで売上を集計し、その結果を生成AIに渡して、コメント(説明の文章)を書いてもらう。データ分析で生成AIを使うときの、よくある流れです。
このとき、計算はPythonで行い、生成AIには文章を書く役だけを頼むのが基本です。生成AIは文章を作るのは得意ですが、たくさんの数字から合計を正確に計算するのは得意ではありません。合計や割合はPythonで確定させ、その結果だけを渡します。
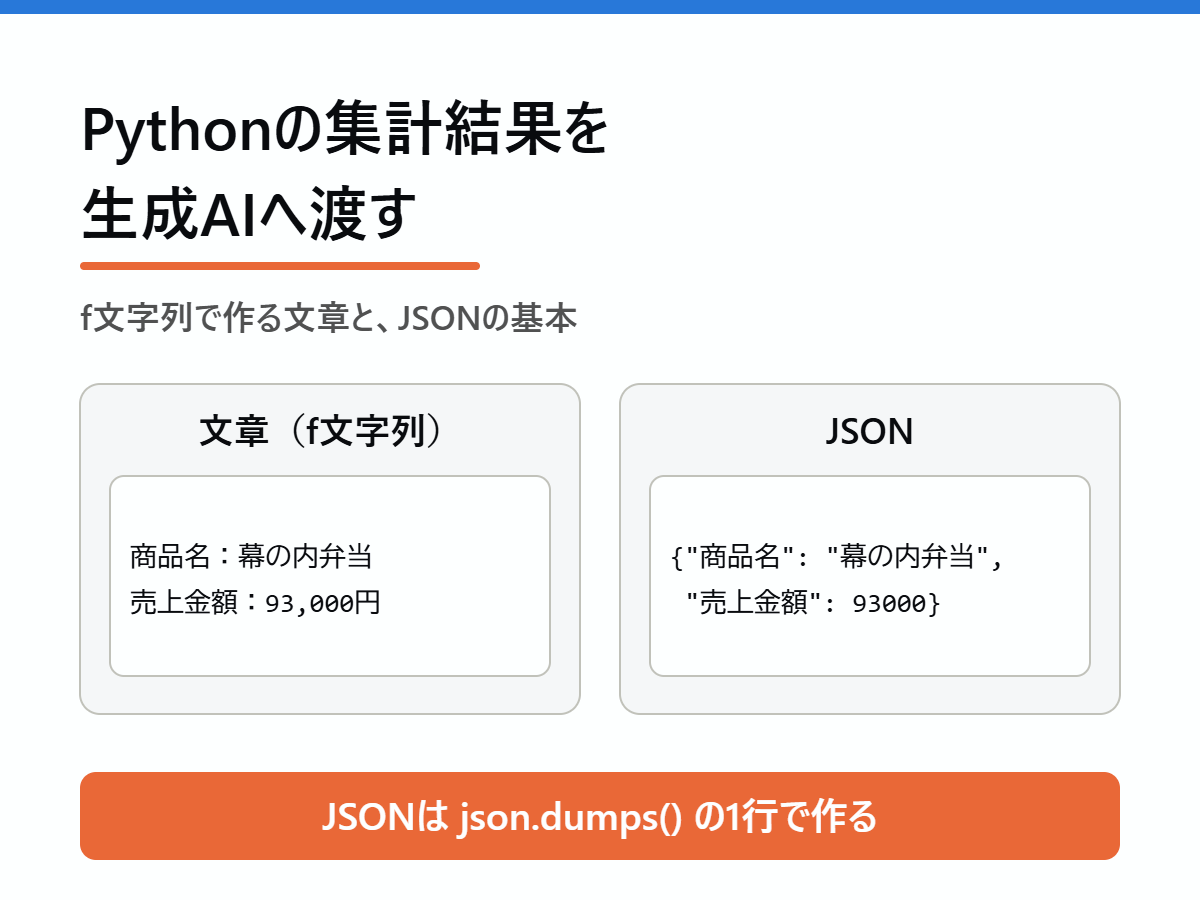
では、Pythonで計算した結果を、どんな形で生成AIへ渡せばよいのでしょうか。よく使われるのは次の2つです。
方法1:文章にして渡す
商品名:幕の内弁当
カテゴリ:弁当
売上金額:93,000円
販売数量:150点
方法2:JSONにして渡す
{"商品名": "幕の内弁当", "カテゴリ": "弁当", "売上金額": 93000, "販売数量": 150}
方法1は、Pythonのf文字列という書き方で作ります。方法2のJSON(ジェイソン)は、データを文字で表すための書き方の決まりで、json.dumps() という関数で作ります。どちらも、この記事の中でコードを1つずつ説明します。
この記事では、同じ売上データからこの2つを実際に作り、違いを確かめます。そのうえで、作ったJSONをOpenAIのAPIへ渡すところまで進みます。
先に、この記事の結論を3つ書いておきます。
- f文字列は手軽ですが、表に列を足しても、文章には自動で入りません。 組み立てるコードを毎回書き換えます
- JSONは、表の形のまま渡せます。
json.dumps()の1行で作れ、列を足せば自動で入ります。日本語を含むときはensure_ascii=Falseを付けます - Pythonの辞書を
str()で文字列にしても、JSONにはなりません。 JSONは必ずjson.dumps()で作ります
この記事を読み終えると、次のことができるようになります。
- 生成AIのAPIへデータを「渡す」とは何をすることか、説明できる
- pandasで集計した表を、1行ずつPythonの辞書にできる
- f文字列で、集計結果から文章を組み立てられる
- JSONの書き方の決まりが分かり、
json.dumps()でJSONを作れる - 日本語を読める形のままJSONにできる(
ensure_ascii=False) - Pythonの辞書とJSONの違いを説明できる
- 作ったJSONを、OpenAI(あわせてGemini・Claude)のAPIへ渡せる

【月1 特定テーマ講座(11月)】
POS売上分析Copilotを作る
(POSデータ×PYTHON×生成AI)
【受講形式】 当日Zoom( or 復習用に後日動画視聴)
【参加費用】 2万2千円(税込み)/人
先に、この記事で出てくる用語を整理します
いま全部覚える必要はありません。 本文中でも初出のたびに説明しますので、分からなくなったらここへ戻ってきてください。
| 用語 | この記事での意味 |
|---|---|
| 生成AI | 文章などを作り出すAI。ChatGPT・Gemini・Claude などのサービスの中で動いている |
| API | プログラムから別のサービスを呼び出すための窓口。ここでは、Pythonから生成AIを呼び出す窓口 |
| APIキー | APIを使う人を確かめるための文字列。パスワードと同じように、人に見せない |
| pandas | 表形式のデータを読み込んだり集計したりする、Pythonのライブラリ(追加の道具) |
| DataFrame | pandasで扱う表。行と列でできている |
| 辞書(dict) | 「キー(名前)と値」の組を集めた、Pythonのデータの形。{"商品名": "幕の内弁当"} のように書く |
| f文字列 | 文字列の前に f を付け、{変数} の部分に値を埋め込むPythonの書き方 |
| JSON | データを文字で表すための書き方の決まり。プログラム同士のやりとりや、生成AIのAPIでもよく使われる |
| オブジェクト | JSONで { } に囲まれた部分。「キーと値の組」の集まりで、Pythonの辞書に当たる |
| 配列 | JSONで [ ] に囲まれた部分。値を順に並べたもので、Pythonのリストに当たる |
| json.dumps() | Pythonの辞書やリストを、JSONの文字列に変換する関数 |
| json.loads() | JSONの文字列を読んで、Pythonの辞書やリストに戻す関数 |
| エスケープ | 文字を別の書き方に置き換えること。ここでは、日本語が \u5e55 のような形になること |
| instructions / input | OpenAIのAPIに渡す引数。instructions は毎回同じルール、input はその都度変わるデータ |
| 環境変数 | パソコン側に置いておく設定値。APIキーをコードに直接書かないために使う |
使うものと準備
この記事のコードは、JupyterLab(ブラウザの中でPythonを少しずつ実行できる開発環境)で動かす前提で書いています。
JupyterLabでは、ノートブック(拡張子が .ipynb のファイル)を開き、コードをセル(コードを入力して実行する枠)に貼って、Shift + Enter で1つずつ実行します。
この記事のコードも、上から順にセルへ貼って実行してください。最後の「OpenAIのAPIへ渡す」の章以外は、APIキーがなくても動きます。
ライブラリを入れる
次のコマンドで、pandas(表の集計に使う)と openai(OpenAIのAPIを呼ぶのに使う)を入れます。pip は、Pythonのライブラリを入れるためのコマンドです。
pip install pandas openai
このコマンドは、ターミナル(WindowsならPowerShell)で実行します。JupyterLabのセルで実行するときは、先頭に % を付けて %pip install pandas openai とします。
JupyterLab自体がまだ入っていない場合は、ターミナルで pip install jupyterlab を実行して入れ、jupyter lab で起動します。ブラウザが開き、JupyterLabの画面が表示されます。
売上CSVを読む
使うのは、以下の売上CSVです。7日 × 5商品で35行あります。
ファイル名:sample_sales_202607.csv
この記事からダウンロードして、ノートブック(.ipynb ファイル)と同じフォルダに置いてください。
import json
import pandas as pd

df = pd.read_csv("sample_sales_202607.csv")
print(df.head())
           日付 曜日       商品名 カテゴリ  単価(円)  数量  売上金額(円)
0  2026-07-06  月   おにぎり(鮭)   主食    160  29     4640
1  2026-07-06  月   アイスコーヒー   飲料    180  28     5040
2  2026-07-06  月    サンドイッチ   軽食    380  26     9880
3  2026-07-06  月     幕の内弁当   弁当    620  19    11780
4  2026-07-06  月  緑茶 500ml   飲料    150  36     5400
1行ずつ見ていきます。
import jsonは、JSONを扱うための道具を読み込みます。Pythonに最初から入っているので、インストールは要りませんimport pandas as pdは、pandasをpdという短い名前で使えるようにしますpd.read_csv()はCSVファイルを読み込み、表(DataFrame)にしますdf.head()は、表の先頭5行だけを表示します
列は、日付・曜日・商品名・カテゴリ・単価(円)・数量・売上金額(円) の7つです。売上金額は、単価 × 数量です。左端の 0〜4 は、pandasが行に付ける番号です。
生成AIへ「渡す」とはどういうことか
ChatGPTのようなチャット画面なら、集計結果を入力欄に貼り付けて「この数字をもとにコメントを書いて」と頼めば済みます。
Pythonから同じことをするときは、APIという窓口を使います。APIを呼び出すコードの中に、チャット画面の入力欄に当たる input という引数があり、そこに渡すのは文字列(テキスト)です。表やグラフをそのまま渡すのではありません。
つまり、Pythonで集計した表を、いったん文字列にする必要があります。その作り方が、この記事の冒頭で見た2つの方法(文章にする/JSONにする)です。
商品別に集計する
まず、35行の売上データを、商品ごとの合計にまとめます。ここまでは生成AIを使いません。
商品ごとの売上金額と販売数量を出す
商品別 = (
    df.groupby(["商品名", "カテゴリ"], as_index=False)
      .agg(売上金額=("売上金額(円)", "sum"), 販売数量=("数量", "sum"))
      .sort_values("売上金額", ascending=False)
      .reset_index(drop=True)
)
print(商品別)
        商品名 カテゴリ   売上金額  販売数量
0     幕の内弁当   弁当  93000   150
1    サンドイッチ   軽食  64220   169
2   アイスコーヒー   飲料  41580   231
3   おにぎり(鮭)   主食  41120   257
4  緑茶 500ml   飲料  41100   274
少し長いので、上から順に説明します。
| コード | やっていること |
|---|---|
groupby(["商品名", "カテゴリ"], as_index=False) |
商品名(とカテゴリ)が同じ行を1つのグループにまとめる。as_index=False は、商品名を普通の列として残す指定 |
agg(売上金額=("売上金額(円)", "sum"), …) |
グループごとに集計する。売上金額=("売上金額(円)", "sum") は「売上金額(円) の列を合計(sum)して、売上金額 という名前の列にする」という意味 |
sort_values("売上金額", ascending=False) |
売上金額の大きい順に並べる。ascending=False は「大きい順」の指定 |
reset_index(drop=True) |
並べ替えで乱れた行番号を、0から振り直す |
7日分・35行が、5商品・5行になりました。合計はPythonが計算しているので、正確です。
1行ずつ辞書にする
このあと文章やJSONを作りやすいように、表の1行を1つの辞書にします。辞書は、{キー: 値} の組を集めたPythonのデータの形です。
レコード = 商品別.to_dict("records")

print(len(レコード))
print(レコード[0])
5
{'商品名': '幕の内弁当', 'カテゴリ': '弁当', '売上金額': 93000, '販売数量': 150}
to_dict("records") は、表の1行を1つの辞書にして、それをリスト(順番に並べたもの)にまとめます。5行の表なので、辞書が5つ入ったリストになりました。len() は個数を数える関数、レコード[0] はリストの1つ目(Pythonでは0から数えます)です。
1つ目の辞書は、'商品名' というキーに '幕の内弁当' という値、'売上金額' というキーに 93000 という値、という組でできています。レコード[0]["商品名"] と書けば、'幕の内弁当' を取り出せます。
方法1:f文字列で文章にする
f文字列の基本
f文字列は、文字列の中に変数の値を埋め込む書き方です。まず、いちばん小さな例を見ます。
商品名 = "幕の内弁当"
売上金額 = 93000

print(f"商品名:{商品名}、売上金額:{売上金額:,}円")
商品名:幕の内弁当、売上金額:93,000円
- 文字列の前の
fが、「この文字列の中に値を埋め込む」という合図です {商品名}の部分が、変数商品名の値(幕の内弁当)に置き換わります{売上金額:,}の:,は、「3桁ごとにカンマを入れる」という書式の指定です。93000 が 93,000 になります
1商品ぶんを文章にする
同じ書き方で、辞書1つから文章を組み立てる関数を作ります。
def データ文(r):
    return (f"商品名:{r['商品名']}\n"
            f"カテゴリ:{r['カテゴリ']}\n"
            f"売上金額:{r['売上金額']:,}円\n"
            f"販売数量:{r['販売数量']:,}点")

print(データ文(レコード[0]))
商品名:幕の内弁当
カテゴリ:弁当
売上金額:93,000円
販売数量:150点
def データ文(r):は、データ文という名前の関数を作る書き方です。rに辞書を1つ受け取りますr['商品名']は、辞書rから「商品名」の値を取り出します\nは改行を表す記号です。4行の文章になっているのは、これのおかげですreturnは、関数が作った文字列を返す命令です
この文字列を、APIの input に渡す。これが、方法1(文章にして渡す)です。
全商品を1つの文章にする
5商品をまとめて渡したいときは、1商品を1行にして、5行の文章を作ります。
def 一覧文(表):
    行 = []
    for r in 表.to_dict("records"):
        行.append(f"{r['商品名']}:カテゴリ {r['カテゴリ']}、"
                  f"売上 {r['売上金額']:,}円、{r['販売数量']:,}点")
    return "\n".join(行)

print(一覧文(商品別))
幕の内弁当:カテゴリ 弁当、売上 93,000円、150点
サンドイッチ:カテゴリ 軽食、売上 64,220円、169点
アイスコーヒー:カテゴリ 飲料、売上 41,580円、231点
おにぎり(鮭):カテゴリ 主食、売上 41,120円、257点
緑茶 500ml:カテゴリ 飲料、売上 41,100円、274点
for r in 表.to_dict("records"):は、表の1行ずつ(辞書1つずつ)について、同じ処理をくり返す書き方です行.append(…)は、リスト行の最後に、作った1行を足します"\n".join(行)は、リストに集めた5行を、改行でつないで1つの文字列にします
ここで、「1商品を1行に、項目は読点で区切る」という書式は、自分で決めたことに注意してください。書式に決まりはないので、書く人によって変わります。
列を足しても、文章には出てこない
ここで、売上構成比(全体の売上に占める割合)の列を足してみます。構成比があると、「幕の内弁当が全体の3分の1を占める」のような説明が書けるからです。
商品別["売上構成比"] = (
    商品別["売上金額"] / 商品別["売上金額"].sum() * 100
).round(1)

print(商品別)
print()
print(一覧文(商品別))
        商品名 カテゴリ   売上金額  販売数量  売上構成比
0     幕の内弁当   弁当  93000   150   33.1
1    サンドイッチ   軽食  64220   169   22.9
2   アイスコーヒー   飲料  41580   231   14.8
3   おにぎり(鮭)   主食  41120   257   14.6
4  緑茶 500ml   飲料  41100   274   14.6

幕の内弁当:カテゴリ 弁当、売上 93,000円、150点
サンドイッチ:カテゴリ 軽食、売上 64,220円、169点
アイスコーヒー:カテゴリ 飲料、売上 41,580円、231点
おにぎり(鮭):カテゴリ 主食、売上 41,120円、257点
緑茶 500ml:カテゴリ 飲料、売上 41,100円、274点
1行目から3行目は、売上金額を合計で割って100を掛け、round(1) で小数第1位までに丸めて、新しい列 売上構成比 として足しています。print() は、間に空の行を1行入れるためのものです。
表には 売上構成比 の列が増えました(上の表)。しかし、同じ関数で作った文章(下の5行)には、構成比が出てきません。 f文字列には、自分で書いた項目しか入らないからです。
構成比も渡したいなら、一覧文() の中のf文字列を書き換える必要があります。列を足すたびに、文章を組み立てるコードも直すことになります。
方法2:JSONにする
JSONの書き方
JSONは、データを文字で表すための書き方の決まりです。たとえば、次のように書きます。
{
  "商品名": "幕の内弁当",
  "売上金額": 93000,
  "在庫あり": true,
  "備考": null,
  "販売した曜日": ["月", "火", "水"]
}
見た目はPythonの辞書に似ていますが、決まりがあります。
| 書き方 | 例 | 意味 |
|---|---|---|
{ } |
全体 | オブジェクト。「キーと値の組」を、カンマで区切って並べる |
"キー": 値 |
"商品名": "幕の内弁当" |
キーは必ずダブルクォート " で囲む |
| 文字列 | "幕の内弁当" |
ダブルクォートで囲む。シングルクォート ' は使えない |
| 数値 | 93000 |
囲まずにそのまま書く。93,000 のようなカンマは付けない |
| 真偽値 | true / false |
「はい/いいえ」。小文字で書く |
| 値が無い | null |
値が無いことを表す |
[ ] |
["月", "火", "水"] |
配列。値を順に並べる |
決まりがあるので、読む側(プログラムや生成AI)は、どこからどこまでが1件で、どの値が何を表すのかを迷わずに読み取れます。
json.dumps() でJSONの文字列にする
JSONを手で書く必要はありません。Pythonの辞書を json.dumps() に渡せば、JSONの文字列に変換してくれます。先ほど作った辞書 レコード[0] で試します。
print(json.dumps(レコード[0]))
{"\u5546\u54c1\u540d": "\u5e55\u306e\u5185\u5f01\u5f53", "\u30ab\u30c6\u30b4\u30ea": "\u5f01\u5f53", "\u58f2\u4e0a\u91d1\u984d": 93000, "\u8ca9\u58f2\u6570\u91cf": 150}
エラーは出ていません。ただ、日本語が読めない形になっています。
日本語をそのまま出す:ensure_ascii=False
\u5e55\u306e\u5185\u5f01\u5f53 は「幕の内弁当」です。json.dumps() は、何も指定しないと、ASCII(半角の英数字と記号)以外の文字を \uXXXX という形に置き換えます(エスケープ)。Pythonの公式ドキュメントにも、ensure_ascii が True(既定値)のときは、ASCII以外の文字がすべてエスケープされると書かれています。
ensure_ascii=False を付けると、日本語がそのまま出ます。
print(json.dumps(レコード[0], ensure_ascii=False))
{"商品名": "幕の内弁当", "カテゴリ": "弁当", "売上金額": 93000, "販売数量": 150}
見た目だけの問題ではありません。5商品ぶんをJSONにすると、エスケープありは868文字、なしは308文字でした。約2.8倍です。文字数が増えれば、生成AIに送るデータの量(トークン数)も増え、料金にも響きます。確かめ方は、最後の「OpenAIのAPIへ渡す」の章で紹介します。
日本語を含むデータをJSONにするときは、
ensure_ascii=Falseを付ける。 まずはこれだけ覚えておけば十分です。
複数件をまとめてJSONにする
辞書が入ったリストを渡すと、JSONの配列になります。ここでは、見やすいように先頭の2件だけを、字下げを付けて表示します。
print(json.dumps(レコード[:2], ensure_ascii=False, indent=2))
[
  {
    "商品名": "幕の内弁当",
    "カテゴリ": "弁当",
    "売上金額": 93000,
    "販売数量": 150
  },
  {
    "商品名": "サンドイッチ",
    "カテゴリ": "軽食",
    "売上金額": 64220,
    "販売数量": 169
  }
]
レコード[:2]は、リストの先頭から2つを取り出す書き方ですindent=2は、2文字ずつ字下げして、人が読みやすい形にする指定です。生成AIへ送るときは付けなくても構いません
いちばん外側が [ ](配列)で、その中に { }(オブジェクト)が1商品ずつ並んでいます。どこからどこまでが1件かが、記号で決まっています。 f文字列のときのように、区切り方を自分で決める必要はありません。
列を足すと、JSONには自動で入る
方法1で、表に売上構成比の列を足しました。その表から辞書を作り直して、JSONにします。
レコード = 商品別.to_dict("records")

print(json.dumps(レコード[0], ensure_ascii=False))
{"商品名": "幕の内弁当", "カテゴリ": "弁当", "売上金額": 93000, "販売数量": 150, "売上構成比": 33.1}
コードは1行も書き換えていないのに、"売上構成比": 33.1 が入りました。 JSONは表の列をそのままキーにするので、列を足せば自動で入ります。f文字列との、いちばん大きな違いです。
2つの方法を比べる
| 方法1:f文字列で文章にする | 方法2:JSONにする | |
|---|---|---|
| 作り方 | 項目ごとにf文字列を書く | json.dumps() の1行 |
| 列を足したとき | コードを書き換えるまで入らない | 自動で入る |
| 複数件の区切り方 | 自分で決める(改行、読点など) | [ ] と { } で決まっている |
| 値が無いとき | 「なし」「-」など、書き方がぶれる | null と決まっている |
| 人が読んだとき | 読みやすい | 記号が多いが、慣れれば読める |
| 向いている場面 | 項目が少なく、形が変わらないとき | 項目が多いとき、表の形が変わるとき |
項目が2〜3個で、今後も変わらないなら、f文字列でも困りません。表が大きくなる、列が増えることがあるなら、JSONにしておくほうが手間が少なく済みます。
PythonのdictとJSONは同じではない
JSONとPythonの辞書は見た目が似ているので、同じものだと思いがちです。しかし、細かいところが違います。
| Pythonの辞書(dict) | JSON | |
|---|---|---|
| 文字列の囲み | ' でも " でもよい |
" だけ |
| 真偽値 | True / False(先頭が大文字) |
true / false(小文字) |
| 値が無い | None |
null |
| キー | 文字列のほか、数値なども使える | 文字列だけ |
| 正体 | Pythonの中のデータ | ただの文字列(書き方の決まりに沿った文字の並び) |
最後の行が大事です。json.dumps() は、Pythonの中のデータを、決まりに沿った文字列に変換する関数です。だからAPIの input(文字列を渡す場所)に、そのまま渡せます。
str() で文字列にしても、JSONにはならない
よくある間違いが、辞書を str()(何でも文字列にする関数)やf文字列で文字列にして、JSONのつもりで渡すことです。
例 = {"在庫あり": True, "備考": None}

print(str(例))
print(json.dumps(例, ensure_ascii=False))
json.loads(str(例))
{'在庫あり': True, '備考': None}
{"在庫あり": true, "備考": null}
json.decoder.JSONDecodeError: Expecting property name enclosed in double quotes: line 1 column 2 (char 1)
- 1行目が
str()の結果です。シングルクォート、True、Noneと、Pythonの書き方のままです - 2行目が
json.dumps()の結果です。ダブルクォート、true、nullと、JSONの決まりどおりになっています - 3行目は、1行目の文字列をJSONとして読もうとして、エラーになったところです。「キーはダブルクォートで囲まれていなければならない」と言われています
生成AIはそれでも意味を読み取るかもしれません。しかし、JSONを渡したつもりなら、json.dumps() で作ります。
JSONからPythonに戻す:json.loads()
反対に、JSONの文字列をPythonの辞書に戻すのが json.loads() です。生成AIからの回答をJSONで受け取ったときなどに使います。
戻した = json.loads('{"在庫あり": true, "備考": null}')
print(戻した)

行って戻る = json.loads(json.dumps({1: "月", 2: "火"}, ensure_ascii=False))
print(行って戻る)
{'在庫あり': True, '備考': None}
{'1': '月', '2': '火'}
- 1行目:JSONの
trueとnullが、PythonのTrueとNoneに戻りました - 2行目:数値のキー
1・2を持つ辞書をJSONにして戻すと、キーが文字列の'1'・'2'になりました。JSONのキーは文字列だけだからです
JSONにして戻すと、元の辞書と完全には同じにならないことがある。これも覚えておくと、あとで迷いません。
OpenAIのAPIへ渡す
ここからは、作ったJSONを実際に生成AIへ渡します。この章だけ、APIキーが必要です。
APIを使う前に知っておくこと
- APIの利用は有料です(使った量に応じた従量課金)。 料金は、送った文字と返ってきた文字の量(トークン数)で決まります。単価は OpenAIの料金ページ で確認できます
- ChatGPTの有料プランを契約していても、APIの利用料はその中に含まれません。 APIは別に利用設定をして、別に支払います
- APIキーは、OpenAIの開発者向けサイト(API keys のページ)で作ります。 パスワードと同じ扱いで、人に見せたり、コードに直接書いたりしません
APIキーとモデルIDを環境変数に入れる
APIを呼ぶには、APIキーとモデルID(使うモデルの名前)が要ります。どちらもコードには直接書かず、環境変数(パソコン側に置いておく設定値)から読みます。
- APIキーをコードに書くと、ノートブックを人に渡したときに、キーも一緒に渡ってしまいます。 漏れたキーは他人に使われ、料金が発生するおそれがあります
- モデルIDは、新しいモデルが出ると変わります。 コードに書かず設定に置いておけば、設定だけ差し替えれば済みます。使えるモデルIDは、OpenAIの公式ドキュメントのモデル一覧で確認してください
Windowsなら、PowerShell(Windowsに入っているコマンド入力の画面)で次のように設定し、同じ画面から JupyterLab を起動します。"…" の中は、自分のAPIキーとモデルIDに置き換えてください。
$env:OPENAI_API_KEY = "ここにAPIキーを貼る"
$env:OPENAI_MODEL = "使うモデルのID"
jupyter lab
Anaconda Prompt(Anacondaに付いてくる、コマンドプロンプト形式の画面)を使っている場合は、書き方が変わります。値をダブルクォートで囲まないのがポイントです。囲むと、ダブルクォートまで値の一部になってしまいます。
set OPENAI_API_KEY=ここにAPIキーを貼る
set OPENAI_MODEL=使うモデルのID
jupyter lab
macOS・Linuxのターミナルでは、次のとおりです。
export OPENAI_API_KEY="ここにAPIキーを貼る"
export OPENAI_MODEL="使うモデルのID"
jupyter lab
いずれも、設定したウィンドウの中だけで有効です。別のウィンドウから起動した JupyterLab では読めないので、設定したのと同じウィンドウで jupyter lab を実行してください。すでに JupyterLab を開いている場合は、いったん閉じてから起動し直します。
参考までに、Google Colab を使う場合は、画面左側の鍵のアイコン(シークレット)に OPENAI_API_KEY という名前でAPIキーを登録し、セルで次のように読み込みます。
import os
from google.colab import userdata

os.environ["OPENAI_API_KEY"] = userdata.get("OPENAI_API_KEY")
os.environ["OPENAI_MODEL"] = "使うモデルのID"
ルールとデータを分けて渡す
OpenAIのAPI(Responses API)では、生成AIへの指示を2つの引数に分けて渡せます。
| 引数 | 入れるもの | この記事では |
|---|---|---|
instructions |
毎回同じルール(役割、守ってほしいこと) | 下で作る ルール |
input |
その都度変わるデータ | 5商品ぶんのJSON |
ルールを分けておくと、データだけを差し替えて何度でも呼べます。方法1(文章)で渡す場合も、方法2(JSON)で渡す場合も、この分け方は同じです。変わるのは input の中身だけです。
ルールを書く
ルール = """あなたは小売店の売上を説明する担当者です。
- 入力はJSONで、商品ごとの売上金額・販売数量・売上構成比が入っている
- 売上構成比は、全体の売上に占める割合(%)
- 書かれている数値だけを使い、書き換えない
- 3文以内で書く"""
""" で囲むと、改行を含む長い文字列を書けます。
2行目と3行目で、JSONに何が入っているか、売上構成比が何を表すかを説明しています。JSONは値を渡せますが、その値の意味(単位や計算のしかた)までは渡せません。意味はルールに書いておきます。
呼び出す
import os
from openai import OpenAI

client = OpenAI()                      # OPENAI_API_KEY を環境変数から読む
MODEL = os.environ["OPENAI_MODEL"]     # モデルIDも環境変数から読む

送るJSON = json.dumps(レコード, ensure_ascii=False)

response = client.responses.create(
    model=MODEL,
    instructions=ルール,
    input=送るJSON,
)
print(response.output_text)          # 回答の文章
print(response.usage.input_tokens)   # 送った入力のトークン数
OpenAI()は、環境変数OPENAI_API_KEYからAPIキーを読んで、APIを呼ぶ準備をしますos.environ["OPENAI_MODEL"]は、環境変数OPENAI_MODELの値(モデルID)を読みますjson.dumps(レコード, ensure_ascii=False)で、5商品ぶん(売上構成比入り)をJSONの文字列にしていますclient.responses.create(…)がAPIの呼び出しです。instructionsにルール、inputにJSONを渡していますresponse.output_textは、生成AIが書いた回答の文章ですresponse.usage.input_tokensは、送った入力のトークン数です。トークンは生成AIが文章を区切って数える単位で、料金はこの数で決まります
方法1の文章で渡したいときは、input=送るJSON を input=一覧文(商品別) に変えるだけです。
エスケープでトークンが増えるかを確かめるには、
送るJSONを作る行のensure_ascii=Falseを消して、もう一度実行してみてください。input_tokensの差が、エスケープで増えたぶんです。
回答の文面はモデルや実行のたびに変わるので、ここには載せていません。
Claude・Geminiではここが違う
JSONを作る部分と、ルール は3社とも同じです。 変わるのは、最後の呼び出しだけです。
| 項目 | OpenAI | Gemini | Claude |
|---|---|---|---|
| 入れるライブラリ | openai |
google-genai |
anthropic |
| APIキーの環境変数 | OPENAI_API_KEY |
GEMINI_API_KEY(GOOGLE_API_KEY もあると、そちらが優先) |
ANTHROPIC_API_KEY |
| データを渡す場所 | input= |
contents= |
messages= の user の content |
| ルールを渡す場所 | instructions= |
config= の system_instruction |
system= |
| 回答の取り出し | response.output_text |
response.text |
content のテキスト部分をつなげる |
モデルIDは、それぞれ GEMINI_MODEL・CLAUDE_MODEL という名前の環境変数に入れておく前提で書いています。設定のしかたは、OpenAIのときと同じです。
Gemini の場合
pip install google-genai で入れておきます。
import os
from google import genai
from google.genai import types

client = genai.Client()                # GEMINI_API_KEY を環境変数から読む
response = client.models.generate_content(
    model=os.environ["GEMINI_MODEL"],
    contents=送るJSON,
    config=types.GenerateContentConfig(system_instruction=ルール),
)
print(response.text)
Claude の場合
pip install anthropic で入れておきます。
import os
from anthropic import Anthropic

client = Anthropic()                   # ANTHROPIC_API_KEY を環境変数から読む
message = client.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,                   # Claudeでは必須
    system=ルール,
    messages=[{"role": "user", "content": 送るJSON}],
)
print("".join(b.text for b in message.content if b.type == "text"))
Claudeでは、出力の上限 max_tokens を必ず指定します。回答は content にブロックのリストとして入っているので、テキストのブロックだけをつなげて取り出します。
まとめ
今回、覚えておいた方がいいことです。
| 役割分担 | 計算はPython、文章は生成AI。生成AIには集計済みの結果だけを渡す |
| 渡すもの | APIの input に渡すのは文字列。表を文字列にする方法を決める |
| 方法1:f文字列 | 手軽で読みやすい。列を足したら、コードも書き換える |
| 方法2:JSON | json.dumps() の1行。列を足せば自動で入る |
| 日本語 | ensure_ascii=False を付ける |
| dictとの違い | JSONは決まりに沿った文字列。str() ではJSONにならない |
| 意味の伝え方 | 値の意味(単位、計算のしかた)は instructions のルールに書く |
